
Гугл-таки выпустил бесплатное приложение для голосового ввода (пока только MacOS, iOS, английский ). https://developers.google.com/edge/eloquent

Гугл-таки выпустил бесплатное приложение для голосового ввода (пока только MacOS, iOS, английский ). https://developers.google.com/edge/eloquent
Build 2026 (3/3): агенты, тулинг, безопасность и наука 6) Рантайм и изоляция – MXC (Microsoft Execution Containers) – слой изоляции, вшитый в ОС: от process-level для лёгких действий до полной изоляции через Windows 365 for Agents. Политику применяет сама ОС, кто бы агента ни написал. Это для всяких агентов типа OpenClaw и Hermes. – OpenClaw теперь нативно на Windows через MXC. На сцену вывели самого Питера Штайнбергера: он запустил OpenClaw Foundation (нонпрофит, любая модель/ОС), сам харнесс стал плагином (приноси свой Copilot/Codex), доступ теперь гранулярный – по папкам read/write/hidden, observability, auto-mode. В демо Claw пытался удалить файлы с рабочего стола – и не смог, MXC удержал. Перевод: claws можно тащить в энтерпрайз – Autopilots – «энтерпрайз-grade claws»: автономные long-running агенты со своей личностью, памятью и коннекторами. Первый – Scout, уже на Copilot Frontier (выглядит честно говоря просто как кривой чат-бот...). К лету Copilot станет супер-аппом: Chat + Cowork + код в одном 7) Контроль и тулинг – Agent 365 – control plane: у агента своя identity (Entra), защита (Defender), комплаенс (Purview), хостинг хоть на AWS/GCP. В демо: удаление персональных данных одним применением на все агенты, микро-VM на сессию, серверные трейсы, оценщик качества и agent optimizer (тюнит модель, инструкции, описания тулзов, скиллы и выкатывает лучший кандидат) – Новый GitHub Copilot app – агент-нативный десктоп: параллельные сессии через Git worktrees, agent merge (Copilot сам нянчит PR через CI, ревью и конфликты), сессии без clone/pull, встроенный браузер + терминал, canvas (агент строит себе UI) и мульти-модельность с «rubber duck review» – в демо GPT-5.5 запросил ревью у Claude Opus 4.8 (то что нужно) – Rayfin – agent-first SDK: бэкенд-as-a-service (identity, storage, схемы БД). Партнёрство с Replit – собираешь в Replit, деплоится в управляемый enterprise-тенант на Fabric. Хороче бекенд для ваших агентов на майкрософтовском облаке. – MDASH – агентная безопасность: 100+ агентов сообща ищут и доказывают эксплойты, топ бенчмарка CyberGym (то есть даже круче Mythos). 8) Форм-факторы и наука – Project Solara – платформа под agent-first устройства (AOSP-based, just-in-time UI, приноси своего агента). Два класса: стационарный девайс типа планшета (MediaTek, вход по Hello for Business) и носимый бейдж (Qualcomm, разблокировка по отпечатку). Сами делать не будут :) – Microsoft Discovery в GA – агентный цикл научного открытия (модели + HPC + граф знаний + автоматизированная лаба, на базе VS Code). В демо за часы прогнали поиск белков для разложения PET-пластика, сгенерили 80 кандидатов и отправили в реальную лабу Cambridge Consultants – Majorana 2 – квантовый чип: время жизни кубита 20 секунд–минута (1000x против Majorana 1), операции за 1 микросекунду, миллион кубитов влезает в чип меньше кредитки. Пока слабо в это верю, но почему бы нет. – Mayo Clinic + Microsoft строят фронтир-модель для здравоохранения Короче, дофига всего для разработчиков и любителей (или тех, кому необходима) инфраструктуры Microsoft. Стоит посмотреть внимательнее то, что интересно звучит. Модельки их например для речи и редактирования картинок на аренах и тестах действительно довольно высоко. Источник: https://news.microsoft.com/build-2026/
Build 2026 (2/3): Собственные модельки. Затраты на обучение фронтир-моделей вырос в триллион раз за 15 лет (12 порядков), впереди ещё +3 порядка. Думают, что будет проще делать персонализированный AI. 3) Семь новых моделей представили: – MAI Thinking 1 – первый ризонер: 35B активных параметров (MoE), контекст 256k. 97% на AIME 2025, 53% на SWE-Bench Pro – вровень с Opus 4.6. Независимые оценщики на Surge предпочитают его Sonnet 4.6 по общему качеству. Главное – обучен с нуля, без дистилляции, на чистой коммерчески-лицензированной data lineage (можно тащить в прод без юридических сюрпризов) – MAI Code 1 Flash – 5B параметров, 51% на SWE-Bench Pro. Размер уровня Haiku, дешевле в инференсе, уже в VS Code – MAI Transcribe 1.5 – заявка на лучшую транскрипцию в мире: 43 языка (русский есть), в 5 раз быстрее, обходит флагманы Gemini и OpenAI – MAI Voice 2 (+ Flash) – синтез речи, 15 языков (русский есть), защита от несанкционированного клонирования + водяные знаки из коробки – MAI Image 2.5 (+ Flash) – №2 на лидерборде, на редактировании обходят Nano Banana 2, уже в PowerPoint – Co-design с кремнием: на своём Maia 200 модели MAI дают +1.4x perf/watt поверх тех самых +30% tokens/dollar. Доступны не только в Foundry, но и на OpenRouter, Fireworks, Base10 – веса можно тюнить самому https://microsoft.ai/news/building-a-hillclimbing-machine-launching-seven-new-mai-models/ 4) Frontier tuning Идея: каждая компания строит свою персональную фронтирную модель – RL-среду, которая непрерывно доучивает агента под ваши цели, данные и рубрики. – Excel: дообученный MAI встал вровень с GPT-5.4 при 10x экономии на стоимости – McKinsey: на их задачах MAI выше GPT-5.5, снова 10x по cost-efficiency – Как собирается: в Foundry добавляешь датасет + грейдер → модель генерит ответы, скорит, растет по метрикам. Есть и low-level API для дата-сайнтистов. Короче, ваши данные + ваша модель = ваши преимущества. 5) Интеллект-слой и данные – Microsoft IQ = Web IQ (свежий веб-поиск, MCP-нативный, model-agnostic) + Fabric IQ (онтологии поверх Power BI моделей, с живой телеметрией) + Work IQ (процессы из SharePoint/M365, всегда из живого источника, без перезаливки) – HorizonDB – управляемый PostgreSQL: zone-redundant, 128 ТБ на кластер, 15 read-реплик, 3x throughput против self-managed – Fabric Data Warehouse с GPU-ускорением – 7x – Foundry: 11 000+ моделей; на прошлой неделе завезли Claude Opus 4.8 и realtime-голос OpenAI, плюс партнёрство с Fireworks AI на open-weight Финал – агенты, тулинг, безопасность и наука ⬇️
Build 2026 - куча анонсов от Microsoft. Часть 1 из 3. Снова как с Google I/O слишком много анонсов от Microsoft и скорее всего встретите то, что может помочь вашей компании или вам лично. Будет в 3 частях. 1) Локальные модели: безлимитный интеллект прямо на устройстве Идея – «unmetered intelligence»: задействовать весь NPU/GPU/CPU, что уже стоит на столах, чтобы агенты молотили локально. – Две модели прям внутри Windows: Aion Instruct (компактный ризонер) и Aion Plan (локальный планировщик). Полный ИИ цикл локально. – Windows ML раскатали на весь парк GPU – под локальный ИИ можно делать поддержку софта независимо от видеокарты. – Surface RTX Spark Dev Box – клон Mac Mini: 20 CPU-ядер, 128 ГБ unified memory, на NVIDIA SOC (CPU+GPU+AI в одном чипе). Но как уже писал, урезанный чип и память как-то не доставляют. Осенью. – Windows приходит на GB300/DGX – по сути дата-центр на столе, триллион параметров локально. Стоить будет что-то типа 80000 долларов, но в целом того стоит, там полноценные видюхи. – Для девелоперов: Intelligent Terminal со встроенным Copilot, WSL Containers с доступом к GPU, 75+ Linux-утилит нативно (grep, curl, tar, sudo, head/tail/touch), Starship/ZSH/Homebrew нативно, Windows 365 dev-дистрибутив в облаке и – наконец – вертикальный таскбар в Windows 11 (вау :) ) 2) Облако: супер-фабрики и своё кремний – Azure уже 500+ дата-центров в 80 регионах. За последние 18 месяцев добавили больше мощности, чем за первое десятилетие Azure – Три доминирующих ворклоада теперь: обучение, инференс, агентный рантайм. Под них Fairwater – первая «AI super factory»: два региона (Джорджия + Висконсин), все супер оптимизировано под AI – Вода: контур заливается один раз, дальше ~ноль потребления. Годовой расход – как у одного ресторана. Всякие там ужасы про ужасное потребление воды больше не будет работать. – Maia 200 (своё проц) – уже в Айове и Аризоне, +30% tokens/dollar против топового GPU сегодня, валидирован на GPT-5.5, на нём поедет M365 Copilot. Привет Nvidia. – Cobalt 200 VMs (свой ARM-CPU) – +50% к Cobalt 100 на cloud-native. Тоже привет nvidia, intel, amd. – NVIDIA: Microsoft первым поднял кластер новехоньких Vera Rubin. Стоимость генерации упала в 30 раз по сравнению с текущими A100 картами. Уже доступны в паре регионов. Дальше – собственные модели Microsoft MAI и frontier tuning ⬇️ https://news.microsoft.com/build-2026/

Codex теперь умеет выкладывать внутренние приложения OpenAI зашёл на территорию Lovable и Replit, но пока только для внутренних сайтов. Вчера на стриме «Intelligence at Work» OpenAI выкатил сразу три апдейта для Codex: шесть ролевых плагинов под бизнес-задачи, аннотации и – самое интересное – Sites. Это плагин + managed-хостинг прямо внутри Codex. Просишь собрать приложение – Codex его строит, прогоняет, деплоит и возвращает ссылку, которую можно расшарить по воркспейсу. Весь цикл в одном треде, без ручной возни с инстансами и регионами (привет всем, кто пытался захостить локально собранное приложение в GCP или AWS). Целятся во внутренние инструменты: онбординг-дашборды, базы знаний, борды для идей, репортинг-вью, лёгкие воркфлоу-приложения. То есть не «лендинг запилить», а «превратить рутину команды в живое приложение». Добавили 2 фичи для хранения: – D1 – SQLite-совместимая база под структурку: состояние чеклистов, закладки, фильтры, конфиги, метаданные файлов – R2 – объектное хранилище под сами файлы: документы, картинки, ассеты Любопытная деталь: D1 и R2 – это вообще-то названия продуктов Cloudflare. То есть «хостинг от OpenAI» под капотом едет на Cloudflare – OpenAI не строит инфру сам, а заворачивает чужую под свой бренд и свою авторизацию. По дефолту приложение видят только владелец и админы воркспейса. Дальше открываешь либо на весь воркспейс (workspace_all), либо точечно на людей и группы (custom). Авторизация – через Sign in with ChatGPT. Пока превью для Business и Enterprise. В общем, всем ChatGPT, пожираем всех ближайших конкурентов и GPT-врапперы. https://developers.openai.com/codex/sites
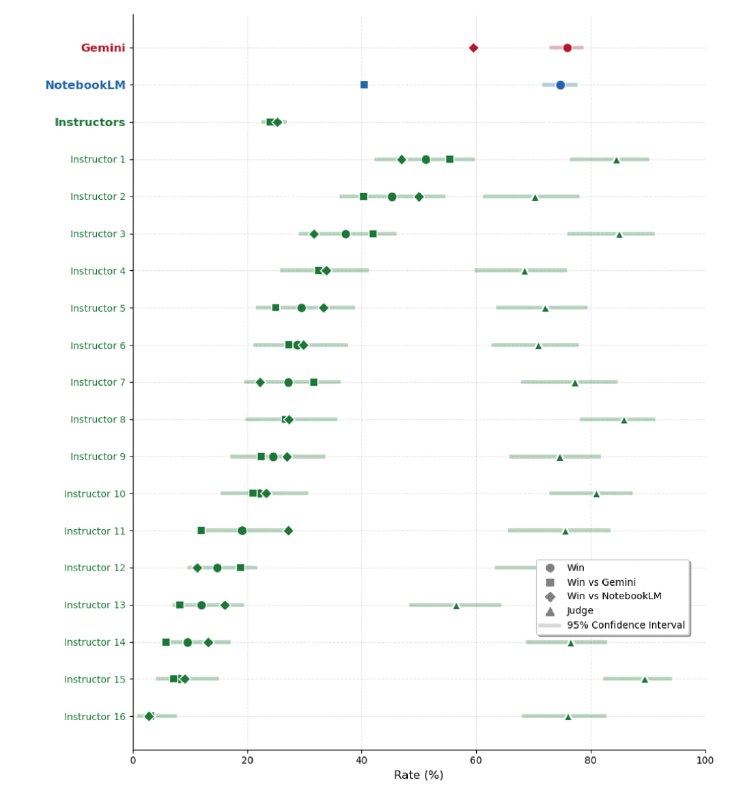

ИИ обошёл профессоров права – исследование Стэнфорда Попалось на HackerNews, полез детально разбираться. Выводы и правда интересные. Стэнфордская юршкола (профессор Джулиан Ниарко, liftlab) проверила, могут ли LLM работать тьюторами по контрактному праву. В слепом тесте профессора предпочли ответы ИИ ответам своих коллег. Как ставили эксперимент – 16 профессоров из 14 юршкол США, все преподают по одному учебнику – сами составили 40 типовых вопросов, которые студенты задают после лекций – сами написали ответы – коротко, ~90 слов, как в реальных office hours – потом вслепую сравнивали ответы, не зная, где ИИ – почти 3000 анонимных сравнений Результаты – ИИ выиграл 75% прямых дуэлей против профессоров (в слепом тесте участвовали Gemini 2.5 Pro и NotebookLM – фронтир на тот момент, август 2025) – «вредными для обучения» ответы ИИ помечали в 3.5% случаев – против 12% у людей (а у худшего профессора – почти 40%) – лучшие ИИ держались на уровне сильнейшего преподавателя выборки Но самое интересное – в полном тексте исследования. Авторы прогнали ещё десяток моделей через ИИ-судью (Llama-4 Maverick, которого сначала сверили с людьми). Итоговый лидерборд: – Claude Opus 4.7 – первое место, за ним ChatGPT 5.4 и Gemini 2.5 Pro – все(!) без исключения модели обошли преподавателей-людей – и разрыв со временем только растёт – новые поколения сильнее Два неожиданных вывода для тех, кто строит продукты: – RAG проиграл голой модели. Стоковый Gemini 2.5 Pro обошёл и NotebookLM, и коммерческого AI-тьютора – хотя оба были заземлены на учебник через RAG. Гипотезы авторов: база и так знает доктрину, а длинный контекст разбавляет нужное («lost in the middle») и тащит шум. Плюс кастомные системные промпты могли перебить полезные обучающие настройки модели. – Ризонинг решает. Версия Gemini Flash с «думающим» бюджетом заметно сильнее той же модели без него. А вот свежесть не гарантия: Gemini 3.1 Pro оказался ниже 2.5 Pro – похоже, после 2.5 Google перестал отдельно дотюнивать модели под обучение студентов. И ещё: преимущество ИИ не сводится к стилю. Модели попали в неявный профессиональный стандарт качества ответа, который эксперты разделяют между собой. То есть отвечает именно так, как надо. В общем, юристов тоже скоро заменят. И да, не всегда надо тащить RAG, лучше сначала протестировать голые модели: https://law.stanford.edu/press/ai-outperforms-law-professors-in-stanford-law-study/
MoneyPrinterTurbo - автоматическое создание роликов Хах, а вот и защита - "принтер для денег" и бесплатный "контент-завод" :) Опенсорсный проект, который собрал больше 77 тысяч звёзд на GitHub. Вводишь тему или короткий промпт – на выходе готовый ролик со сценарием, стоковым видео, озвучкой, субтитрами и музыкой. – LLM пишет сценарий по твоей теме, либо можно подставить свой текст – система сама подтягивает HD-сток без копирайта из Pexels и подобных источников – TTS озвучивает текст, субтитры собираются автоматически – сверху ложится фоновая музыка – и всё это рендерится в 1080p Что под капотом – локальные модели через Ollama (Llama, Mistral, Qwen) и облачные – OpenAI, DeepSeek, плюс Grok – форматы 9:16, 16:9 и 1:1 – под Shorts, YouTube и Instagram сразу – пакетная генерация: делаешь несколько вариантов и выбираешь лучший – тонкая настройка субтитров: шрифт, размер, цвет, обводка, позиция – есть и Web-интерфейс, и REST API, разворачивается через Docker – внутри Python, MoviePy и FFmpeg, чистая MVC-архитектура Прикольно, что проекту уже почти 2 года, а он все растет и растет. Качество упирается в стоковые видео плюс синтезированный голос, так что зрителю видно, что это конвейер – для брендового контента пока не годится. Зато как учебный кейс «склей AI-сервисы в продукт» и как фабрика для тестов каналов. https://github.com/harry0703/MoneyPrinterTurbo/blob/main/README-en.md
Что ждет рынок труда с развитием ИИ. Интересная статья, жалко под пейволом (но подписка на РБК у меня есть) МВФ впервые смоделировал мир, где ИИ умеет почти всё. В итоге получилось, что экономика растёт – а большинство людей беднеет. Собрали около 50 человек – своих экономистов плюс внешних ИИ-экспертов – и в режиме закрытого сценарного воркшопа прогнали два варианта будущего до начала 2030-х. Общая вводная в обоих: ИИ дорастает до уровня эксперта-человека и умеет выполнять и когнитивные, и физические задачи. Различаются сценарии только одним – скоростью распространения и тем, успевают ли за ней институты: – Быстрое распространение – массовое вытеснение рабочих мест. Автоматизация и роботы выбивают рутинный труд и в производстве, и в услугах. Выигрывают капитал и узкая прослойка специалистов, кто ИИ дополняет, а не конкурирует с ним. – Базовый (медленный) – внедрение идёт неравномерно, его тормозят лицензии, профсоюзы, привычки и недоверие. Удар по занятости мягче и растянут во времени, но направление ровно то же. Короче, ВВП идет вверх, а доходы вниз: – Производительность и автоматизация дают экономике импульс – совокупный выпуск растёт. – Но доля дохода, достающаяся работникам, падает: основную часть созданной стоимости забирают владельцы капитала и платформ. – Срабатывает логика winner-take-most: экономия на масштабе в вычислениях и данных стягивает выгоды к узкому кругу компаний и стран. – Итог: пирог больше, а кусок медианного работника – меньше. Ну в целом это понятно было и до ИИ по многим странам: рост ВВП никогда и не был обещанием, что станет лучше лично вам, нужно обладать навыками и капиталом, чтобы новой волной пользоваться. Что в реальности пока тормозит рост – Физические узкие места: энергия, сети, дата-центры, плюс задачи, где всё ещё нужно присутствие человека. – Социальная устойчивость и доверие к институтам Рецепт МВФ предсказуем: налоги на ИИ, перераспределение богатств (типа как профсоюзы Samsung добились), перестройка образования и соцзащиты. Я бы сказал, что все идет пока по очень консервативному плану: каждый день вижу разрыв между «возможностями на фронтире» и реальным внедрением: бутылочное горлышко в моделях, а в распространении знаний и изменений – энергии, процессах, доверии, готовности людей. Ну и конечно нужно быть на стороне тех, кто ИИ дополняет, а не конкурирует с ним. Премию забирают те, кто умеет ставить машине задачу и достраивать то, что она пока не тянет. https://pro.rbc.ru/demo/6a196dac9a794747c52590df

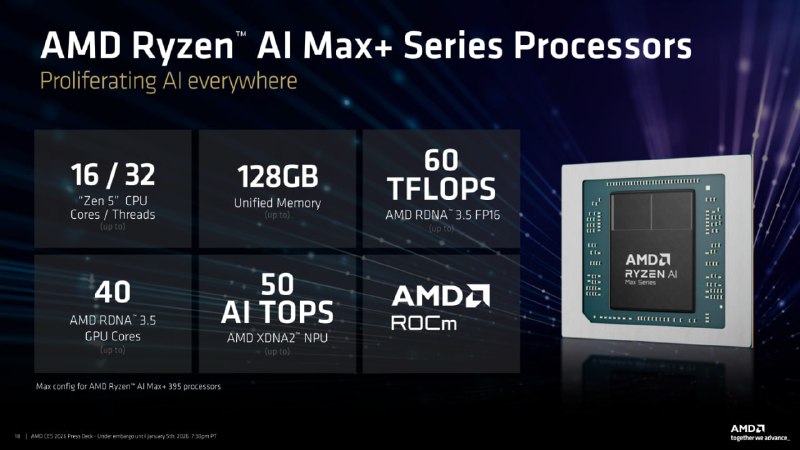
Новый RTX Spark от Nvidia – как-то скорее хайп, чем реальный наезд на Macbook. Microsoft и NVIDIA показали Surface Laptop Ultra на новом суперчипе RTX Spark. Это первый Surface с GPU NVIDIA Blackwell и заходом ровно в нишу, где Apple несколько лет была безальтернативна: много объединённой памяти + локальный AI + тонкий корпус. Думал, что это будет топовая машинка под винду, как раз надо было руководителям компании клиента подбирать, но пока как-то супер-конкурента не получилось. – чип GB10: 20-ядерный CPU Grace (разработан вместе с MediaTek, сами не справились), GPU Blackwell на 6144 ядра CUDA, ~1 петафлопс FP4 – это уровень мобильной RTX 5070. – до 128 ГБ объединённой памяти LPDDR5X, нативная CUDA, но сколько будет стоить такой объем пока хз. – заявлен запуск моделей до 120B параметров локально с контекстом до 1M токенов – Surface Laptop Ultra: 15" mini-LED, до 2000 нит, полный набор портов (HDMI, USB-A, USB-C, SD), упор на ремонтопригодность, две расцветки, выход позже в этом году – партнёры на старте: Dell, HP, Lenovo, ASUS, MSI и Microsoft TechPowerUp. Но! Подвох №1: 600 ГБ/с – это НЕ скорость памяти. Это интерконнект NVLink-C2C между CPU и GPU. Реальная полоса памяти LPDDR5X – 300 ГБ/с. Итого: – RTX Spark: ~273–300 ГБ/с – MacBook Pro M4/M5 Max: 546 ГБ/с (у M5 Max по слухам ~614 ГБ/с) – Mac Studio M3 Ultra: 819 ГБ/с То есть на генерации Mac быстрее в ~2 раза, а Mac Studio – почти втрое. Подвох №2: это переупаковка DGX Spark Тот же GB10, что в DGX Spark. У DGX Spark на этом чипе ~273 ГБ/с. Убрали ConnectX-7, добавили PCIe-слоты, урезали энергопакет под ноутбук, поставили Windows on Arm. Ну, такое... DGX Spark и так-то не блистал производительностью, скорее просто как эксперимент был от Nvidia. AMD Ryzen AI Max как-то выглядит даже поинтереснее... Плюсы, конечно, тоже есть: – CUDA из коробки: прототип локально, потом прод в дата-центре на том же стеке, без костылей – 128 ГБ объединённой памяти в корпусе толщиной 14 мм – инженерно реально круто – силён на compute-bound задачах: prefill длинного контекста, тренировка, файнтюн – а Mac как раз славится медленным prefill – игры, RTX, DLSS – у Mac этого нет вообще – полный набор портов, акцент на ремонтопригодность. Короче, подойдет, если вам нужна именно инфраструктура нвидиа и игры, но никак не агенты локальные. https://www.nvidia.com/en-us/products/rtx-spark/

Наконец-то бенмарк на работу голосовых распознавалок в реальном времени от Artificial Analysis! Смотрят на три вещи, которые реально решают в продакшене: качество / задержка / цена В итоге меряют два продуктово разных режима. First Final – надежный финальный transcript после конца речи. First Partial – почти мгновенная реакция: yes/no, быстрый routing. То есть промежуточный результат распознавания. И всё это близко к реальному проду и с теми же датасетами. Итого на текущий момент на английском такие лидеры: Точность – Final Cartesia Ink-2 (semantic endpoints) – 3.59% WER / 0.21s / ≈$4 за 1k мин ElevenLabs Scribe v2 Realtime – 3.64% WER / 0.14s / $6.50 за 1k мин Cartesia Ink-2 (external endpoints) – 3.66% WER / 0.09s / ≈$4 за 1k мин Точность – First Partial ElevenLabs Scribe v2 Realtime – 3.65% WER / 0.13s / $6.50 за 1k мин Cartesia Ink-2 (external) – 4.33% WER / 0.07s / ≈$4 за 1k мин AssemblyAI U3 Realtime Pro – 4.46% WER / 0.47s / ≈$7.50 за 1k мин Скорость Deepgram Flux – самый быстрый и на Final, и на First Partial: 0.020s / 0.019s / 7.36% WER / ≈$6.5–7.7 за 1k мин. Но это как раз пример, почему нельзя смотреть только на latency: 20 мс выглядят нереально, а WER почти вдвое выше лидеров. Для simple routing – ок. Для комплексных задач – такое себе. Дальше по скорости: Final – Soniox Realtime (0.06s / ≈$2) и Deepgram Nova-3 (0.06s). Partial – NVIDIA Nemotron 3 ASR 80ms (0.04s) и Soniox (0.05s / ≈$2). Whisper очень далеко от лидеров. В общем, для разных сценариев можно теперь выбирать там из 25 разных моделей под то, что вам нужно: – support / payments / healthcare → качество важнее скорости – simple routing / yes-no → задержка может быть важнее – high-volume → цена важна https://artificialanalysis.ai/speech-to-text/streaming
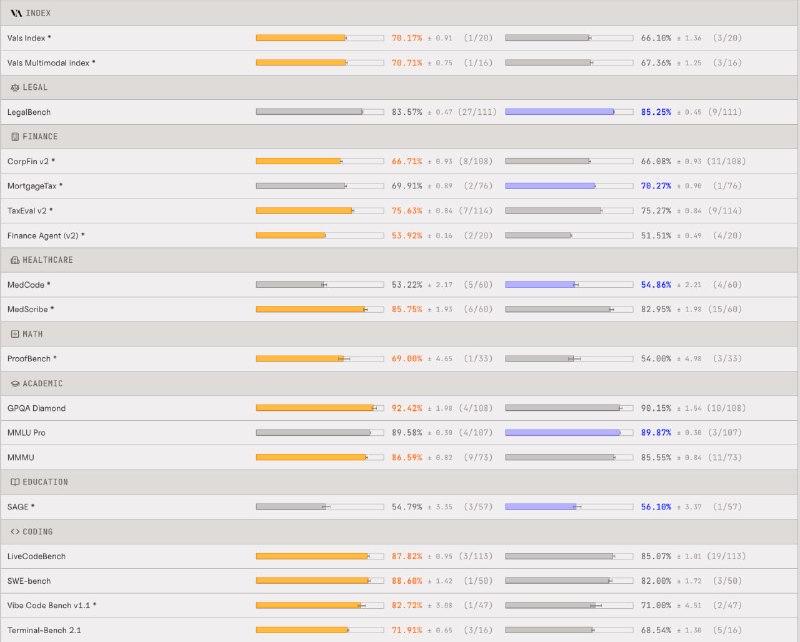
Смотрю первые результаты бенчмарков Opus 4.8 - супер-модель для кодинга получилось. Математика чуть выросла. Остальное либо так же, либо подупало. https://www.vals.ai/comparison?modelA=anthropic%2Fclaude-opus-4-8&modelB=anthropic%2Fclaude-opus-4-7
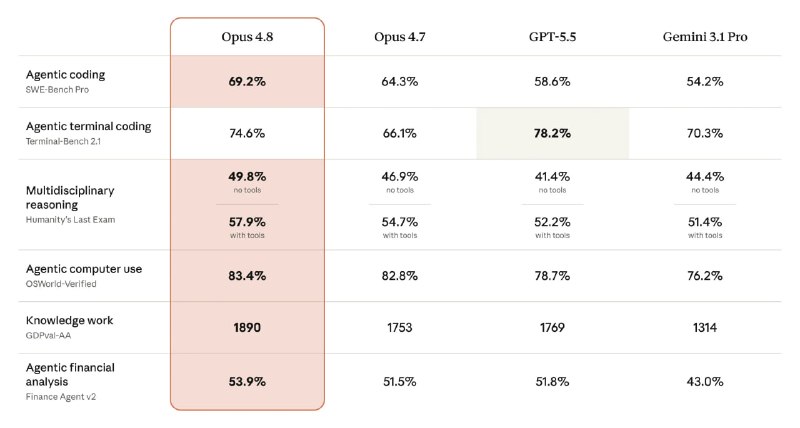
Новый Opus 4.8! Переключаемся! Сильно прям революции нет, но несколько обидных вещей пофиксили: - В 4 раза реже пропускает баги в собственном коде «не заметив». Раньше любили бодро рапортовать об успехе на тонких доказательствах - Алайнмент. Команда Anthropic пишет, что 4.8 «достигает новых максимумов» по просоциальным чертам (поддержка автономии пользователя, действие в его интересах). - Бенчмарки. 84% на Online-Mind2Web (computer-use / браузерные агенты) – ощутимый скачок над 4.7 и GPT-5.5. На Legal Agent Benchmark – первая модель, перешагнувшая 10% по строгому all-pass стандарту. Ну и остальное чуть поднялось. Еще по мелочи отгрузили фич - Effort control в claude.ai и Cowork. Рядом с выбором модели теперь ползунок «усилия»: на высоких – думает чаще и глубже, на низких – отвечает быстрее и экономит лимиты. По дефолту – high. Есть extra (xhigh в Claude Code) и max для тяжёлых задач. - Dynamic workflows в Claude Code (research preview). Claude планирует работу, запускает сотни параллельных сабагентов в одной сессии, верифицирует результат и только потом отчитывается. Заявленный кейс – миграции масштаба кодовой базы на сотни тысяч строк, от kickoff до merge, с тестовым набором в роли планки. Доступно на Enterprise / Team / Max. - Fast mode. 2.5× скорость, но в 2 раза дороже теперь, а не в 6. - Messages API. Теперь принимает system-записи внутри массива messages – можно обновлять инструкции агенту по ходу задачи, не ломая prompt cache. Цены те же https://www.anthropic.com/news/claude-opus-4-8

Самоулучшающийся агент для заполнения деклараций Очень понравился кейс OpenAI и Thrive. Их forward-deployed инженеры вместе с Thrive Holdings за полгода собрали Tax AI – систему подготовки налоговых деклараций для сети бухгалтерских фирм. Шесть месяцев инженеры и исследователи OpenAI работали в связке с Thrive Holdings над Tax AI для бухгалтерских фирм Crete. Обработали 7000 деклараций с 97% точностью, сэкономили треть времени, пропускная способность выросла на 50%. Но тут самое прикольное именно петля самоулучшения (как раз к посту выше): – система пишет полный трейс: исходный файл, извлечённое поле, цитата-источник, маппинг в налоговый движок, правка бухгалтера и финальное поданное значение – повторяющиеся правки одного и того же поля становятся eval-целями – Codex получает узкую задачу с трейсом, evals, репозиторием и skills плюс набором: данные из прода, ожидаемый вывод налогового движка, примеры кода, команды для evals – Паттерны правок превращаются в эвалы и кандидатные изменения продукта, а неоднозначные случаи уходят на ревью инженерам – каждое внедрённое улучшение создаёт новые данные для следующего цикла и так далее. Почему это сложнее, чем кажется Прочитать W-2 или 1099 – не проблема. Проблема – грязные K-1, графики аренды, заметки, таблицы, файлы за прошлые годы и значения, которые должны сходиться между документами. Неверное поле может прийти из пяти разных мест: плохое извлечение, слабый маппинг, неподдерживаемый workflow, перенос с прошлого года или человеческое суждение. И в итоге спустя 6 недель удалось из этой грязи поднять качество с 25% до 86% openai.com/index/building-self-improving-tax-agents-with-codex

Как создавать AI Native компании Понравилось небольшое видео от YСombinator, как строить компании под AI. Лучше посмотреть самостоятельно, но в целом тезисы такие: Большинство компаний устроены как римский легион – вложенные иерархии, где люди работают «проводами» для передачи информации вверх и вниз. Это было ограничение возможностей мозга человека, типа 5-10 человек в управлении. Для ИИ управлять хоть 1000 процессов - фигня. Год назад пользу AI мерили продуктивностью: ассистент делает инженера на 20% быстрее. Это как «навесить мощный двигатель на старый способ работать». Вот тут тоже писал об этом же https://t.me/ai_product/2045 Основная ценность новой методологии - циклы обратной связи. Компания – набор циклов, которые улучшают себя сами, даже пока ты спишь: – Sensor – сигналы извне: письма, тикеты, отмены подписок, телеметрия – Policy – что можно, что требует разрешения человека, что логировать – Tools – детерминированные API к базе и сервисам – Quality gate – evals, фильтры, ревью для рискованного – Learning – где не сработало, заворачивается обратно в начало петли Соответственно задача компании - наделать вот таких вот циклов, чтобы работало вообще без людей. Рассказали свою историю: поверх агента к базе YC посадили мониторящего агента. Он смотрит каждый запрос сотрудников, ловит, где не сработало, сам пишет код, открывает merge request – другой агент ревьюит и мёрджит за ночь. Утром тот же запрос уже проходит. Самоулучшающаяся система. В общем, говорят, что все изменилось и вот что надо теперь делать: – Тратить токены, а не нанимать сотрудников. – Увольнять или переводить в контрибьюторы средний менеджмент – координацию делает AI (буквально вчера вот Clickup об увольнениях 20% персонала заявил) – Записывать и фиксировать все, что только можно, от звонков до мыслей вслух. Не зафиксировано - не произошло. – Бережно хранить данные и скиллы, а к софту привязываться и покупать годовые подписки вообще не нужно, Codex напишет вам что угодно за ночь. – Оставлять людей на "корнер-кейсы" - где высокие ставки принятых решений, этика, продажи, новые ситуации. Ну и не надо пытаться "все сломать и сделать всю компанию по-новому сразу". Лучше взять один процесс и создать петлю с обратной связи, довести до конца, потом другой взять. Это лучше, чем десяток поломанных процессов. https://youtu.be/X_JsIHUfUjc

Text-to-speech арена обновилась. Теперь первые места вместе с inworld занимают Gemini 3.1-Flash-TTS (может они чуть прокачали его) и свежая Sonic 3.5 от Cartesia. Все это на английском тестируется, так что под свои языки подбирайте. На русском Cartesia была не очень эмоциональная и с проблемами с ударениями. Ну и интересно, что xai теперь самый дешевый качественный text-to-speech. ElevenLabs v3 лишь чуть лучше, хотя стоит в 7 раз дороже. https://artificialanalysis.ai/text-to-speech/leaderboard
OpenAI собрал юзкейсы, как внутри разработчики используют Codex. Ничего необычного, но интересно: - понимание кода (типа Summarize how requests flow through this service from entrypoint to response) - рефакторинг (Split this file into separate modules by concern and generate tests for each one) - оптимизация (Optimize this loop for memory efficiency and explain why your version is faster) - написание тестов (Write unit tests for this function, including edge cases and failure paths) - написание базового слоя кода (Generate a telemetry hook for tracking success/failure of the new onboarding flow, using this template) - создание подзадач (Generate a plan to refactor this service and split it into smaller modules) - тест всяких новых идей (How would this work if the system were event-driven instead of request/response?) Ну и дают советы, как лучше всего использовать: - Начинать с Ask Mode. Чем лучше спека, тем быстрее, проще и качественнее работает - Улучшай среду (если какую-то ошибку можно закрыть настройками, инструментами, примерами - сделай) - Пиши промпты будто описание проблем на github (очень подробненько, для тупых) - Используй очередь задач Codex как беклог (лучше мелкими задачами идти, чем 1 большое протаскивать) - Используй agents.md (добавь контекст о проекте, который трудно понять из 1-3 файлов) - Используй "лучшее из N попыток" (сразу делает 3-4 попытки решить и выбираешь или даешь выбрать ИИ лучшую) https://cdn.openai.com/pdf/6a2631dc-783e-479b-b1a4-af0cfbd38630/how-openai-uses-codex.pdf
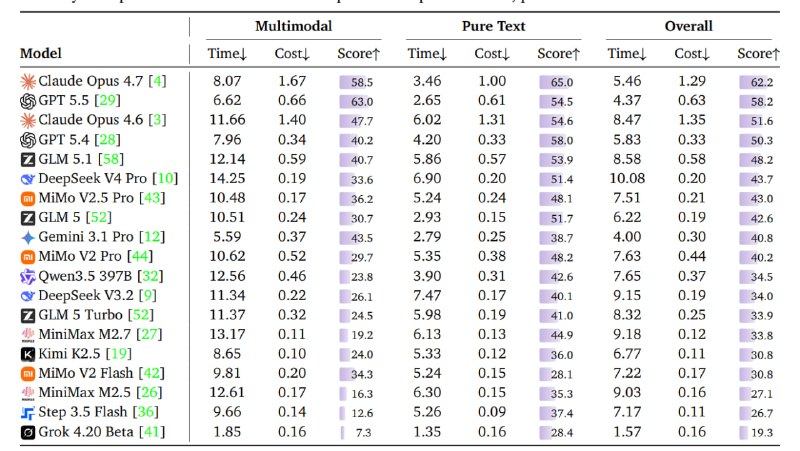

И про агентов всяких и моделей в них. Вот свежий бенчмарк работы разных моделей с типичными задачами в обвязках агентов - WildClawBench. Больше всего задач решил Opus 4.7, но это все равно всего 62%. При это каждая стоила в среднем $1.3 и занимала 5,5 минут. GPT-5.5 лучше в мультимодальности, решила 58% задач и каждая на минуту быстрее и в 2 раза дешевле. Ну и оболочка тоже влияет. Прикольно, что GPT-5.4 лучше всего работал в своей, а китайские модели - в Hermes. https://arxiv.org/abs/2605.10912
Создатель OpenClaw выпустил утилиту для работы со всеми приложения из Google Workspace Чтоб не забивать контекст ИИ-ки, но при этом все функции работали. Поддержал Gmail, Calendar, Drive, Docs, Sheets, Sites, Slides, Forms, Meet, Apps Script, Analytics, Search Console, Contacts, Tasks, People, Classroom, Chat, YouTube, Workspace admin, в том числе несколько аккаунтов. То есть можно просить ллм-ку например создать форму из найденного документа в google docs или все аттачи из писем в gmail сохранить в Drive (хотя именно это и стандартными коннекторами работает) https://github.com/openclaw/gogcli

Antigravity в 3 увеличил лимиты всем. Видимо за то, что выпустили сырое обновление ) https://x.com/_mohansolo/status/2057331857755422922

Codex тут фичей добавил: – Appshots (можно нажать два command на клавиатуре и Codex сделает скриншот окна и скопирует весь текст через accessibility, чтобы передать в чат - удобненько - Goals наконец-то раскатили и в CLI, и в приложение. Может работать сутками, пока цели не достигнет. Я так хотел за 1 промпт на Новый год перевести библиотеку с Java на Rust, за один промпт не получилось, теперь видимо получится. – шаринг плагинов для команд – аннотации для встроенного браузера, можно отмечать, что изменить - Computer Use теперь может и с залоченным компом работать – экстеншен для хрома тебе увереннее картинки скачивает и структуры извлекает. Короче, что-то Claude подотстает. У Codex еще и супер-удобный режим коннекта к телефону, можно все статусы видеть и задачи подкидывать. https://developers.openai.com/codex/changelog#codex-2026-05-21