
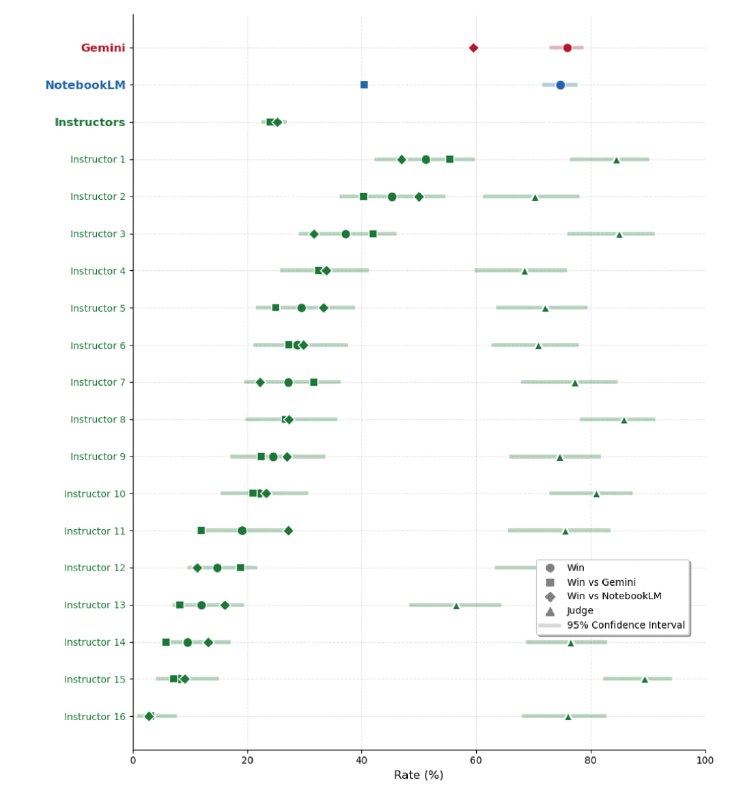
ИИ обошёл профессоров права – исследование Стэнфорда Попалось на HackerNews, полез детально разбираться. Выводы и правда интересные. Стэнфордская юршкола (профессор Джулиан Ниарко, liftlab) проверила, могут ли LLM работать тьюторами по контрактному праву. В слепом тесте профессора предпочли ответы ИИ ответам своих коллег. Как ставили эксперимент – 16 профессоров из 14 юршкол США, все преподают по одному учебнику – сами составили 40 типовых вопросов, которые студенты задают после лекций – сами написали ответы – коротко, ~90 слов, как в реальных office hours – потом вслепую сравнивали ответы, не зная, где ИИ – почти 3000 анонимных сравнений Результаты – ИИ выиграл 75% прямых дуэлей против профессоров (в слепом тесте участвовали Gemini 2.5 Pro и NotebookLM – фронтир на тот момент, август 2025) – «вредными для обучения» ответы ИИ помечали в 3.5% случаев – против 12% у людей (а у худшего профессора – почти 40%) – лучшие ИИ держались на уровне сильнейшего преподавателя выборки Но самое интересное – в полном тексте исследования. Авторы прогнали ещё десяток моделей через ИИ-судью (Llama-4 Maverick, которого сначала сверили с людьми). Итоговый лидерборд: – Claude Opus 4.7 – первое место, за ним ChatGPT 5.4 и Gemini 2.5 Pro – все(!) без исключения модели обошли преподавателей-людей – и разрыв со временем только растёт – новые поколения сильнее Два неожиданных вывода для тех, кто строит продукты: – RAG проиграл голой модели. Стоковый Gemini 2.5 Pro обошёл и NotebookLM, и коммерческого AI-тьютора – хотя оба были заземлены на учебник через RAG. Гипотезы авторов: база и так знает доктрину, а длинный контекст разбавляет нужное («lost in the middle») и тащит шум. Плюс кастомные системные промпты могли перебить полезные обучающие настройки модели. – Ризонинг решает. Версия Gemini Flash с «думающим» бюджетом заметно сильнее той же модели без него. А вот свежесть не гарантия: Gemini 3.1 Pro оказался ниже 2.5 Pro – похоже, после 2.5 Google перестал отдельно дотюнивать модели под обучение студентов. И ещё: преимущество ИИ не сводится к стилю. Модели попали в неявный профессиональный стандарт качества ответа, который эксперты разделяют между собой. То есть отвечает именно так, как надо. В общем, юристов тоже скоро заменят. И да, не всегда надо тащить RAG, лучше сначала протестировать голые модели: https://law.stanford.edu/press/ai-outperforms-law-professors-in-stanford-law-study/