OpenAI выкатили GPT-6.1 Terra Давно ее не обновляли, теперь полноценное место между сол и луна. Цены за 1M токенов (вход / выход): – GPT-6 Luna – $0.10 / $0.50 – GPT-6.1 Terra – $1 / $5 – GPT-5.6 Terra – $2 / $12 – GPT-6.1 Sol и Sonnet 5.5 – $2 / $10 – Opus 5.5 – $4 / $20 По качеству: – против прошлой Terra – в кодинге 50.3% против 21.5%, ошибок на провокационных запросах в 3 раза меньше – против Sol – на max reasoning обходит, и в 3 раза быстрее – против Opus 5.5 – отстаёт меньше чем на 5 пунктов при цене в 5+ раз ниже – Luna всё ещё в 10 раз дешевле – для классификации и простого извлечения остаётся она. Заточена на Computer use, так что для агентов, которые заполняют формы и бегают по интерфейсам, будет норм. А Sonnet за $2/$10 теперь выглядит дороговато – ждём ответа Anthropic) https://openai.com/index/introducing-gpt-6-1-terra/

AI Product | Igor Akimov
-
-
А вот от OpenAI – про агенты, которые не пишут новое, а чистят старое Пишет команда Core Experimentation, которая отвечает за систему экспериментов во всей компании. Раньше мертвый код искали статическим анализом плюс рантайм-логи, и все равно бывали инциденты из-за ошибочных удалений. Что сделали: – GPT-6 Astra дали один расплывчатый промпт (прямо с опечатками): найди мертвый код, проверь в Slack, Statsig и где угодно, что он не используется. Вот чего писали :) Can you help identify and clean up dead code in the repo please, feel free to check slack, statsig [a feature flag and experimentation platform we use], or any other source you need to confirm that things are indeed no longer being used and can be cleaned up or simplified – модель сама смотрела старые PR, треды в Slack, трекеры и прод-профилирование, и объясняла каждое удаление – 5 инженеров между делом за две недели смержили 1 400+ PR и удалили 800k+ строк – образ одного сервиса похудел с 3.31 до 1.72 GB, из тестов ушло около 400 вариантов визуальных снапшотов Дальше – устаревшие эксперименты и фичефлаги. Это сложнее, потому что такой код может еще выполняться в проде. Промпт для полного аудита они попросили написать саму модель, и она же посчитала стоимость каждого флага по CPU. Нашелся флаг, который годами незаметно размножал проверки на все фичи сразу. Модель его не удалила сама, а подняла на ревью человеку, потому что он был помечен как "Permanent". После удаления – около 0.42% экономии CPU на сервисе. Самое практичное – сравнение моделей на одном аудите (6 000 файлов, 1 млн строк на Python, TS, Go и Rust): – GPT-6 Astra Ultra: $109.06, 142 находки, $0.77 за находку – GPT-6.1 Sol Ultra: $15.12, 131 находка, $0.12 за находку – GPT-6.1 Sol Medium: $5.27, 86 находок, $0.06 за находку То есть 92% находок за 14% цены. Разницу разобрали – Sol пропускал флаги, от которых зависят другие флаги, и это компенсировали промптом. То есть можно добить среднюю модель до лучшей просто нормальным промптом. Плюс CI: модель предложила оптимизации по истории прогонов, смержили около 30 PR, медиана CI упала с ~10 до 4.5 минут, p90 – с 12.5 до 6. Один набор из 63 тестов ускорился с 592.6 до 29.8 секунд. Вот таким вот базовым промптом: What ideas do you have to relieve CI load in this repository? List your ideas in a table and rank all of them by estimated CI minutes saved per day based on this repo's CI run history :) Прикол, что они честно пишут: часть предложений добавляла больше сложности, чем пользы. Модель находит столько оптимизаций, что без приоритизации и метрик в них тонешь. Короче, берите одну мелкую задачу (мертвый код, флаг, флаки-тест), сравните модели и уровни effort, а комментарии из ревью скармливайте в следующий промпт. Когда все ок - можно масштабировать на более крупные вещи. Для любой компании с легаси это самый быстрый ROI от агентов. https://developers.openai.com/blog/maintaining-software-with-the-gpt-6-family
-

Команда Claude Code рассказала, как ревьюит код, который на 90% пишет сам Claude. Очень люблю читать именно статьи OpenAI/Anthropic/Google, потому что они сейчас в фарватере изменений, а не блогеры и инфлюенсеры. Рекомендую больше, чем всякие курсы. Как раз хотел на этой неделе разобрать несколько. В общем, цель они сформулировали так: минимум человеческого времени на ревью при том же уровне откатов и инцидентов. Меряют число апрувов на PR, комментарии и время ожидания человека, а откаты и инциденты – как ограничитель. Что внутри: – До PR. Claude сам гоняет тесты, билд и линтер, потом сабагент со свежим контекстом смотрит дифф. Плюс внутренние скиллы: поиск багов, упрощение диффа, e2e-проверка. – AI-ревью на каждый PR. Несколько агентов параллельно ищут баги, отдельная группа голосует за каждую находку, чисто стилистика выкидывается. Находки размечены: Important, Nit, Pre-existing – чтобы старый баг не повесили на автора. На каждую находку обязательно надо ответить. Когда запускали превью, доля PR с содержательными комментариями выросла с 16% до 54%. – Security-ревью, которое блокирует мерж. – Обычный CI: линт, типы, тесты на всех платформах. – Апрув по риску. Классификатор решает, сколько людей нужно: доки, тексты, фичи за флагом – ноль, обычные изменения – один, самое критичное – двое. Биллинг, автоапдейтер и CI-воркфлоу всегда требуют человека. – Merge queue, флаги, сначала внутренние пользователи, потом канал latest, потом stable. – Быстрый откат. Важные правила: уровень риска определяется изменением, а не автором. Облегченный путь – только для доверенных авторов. Апрув агента никогда не засчитывается за человеческий. А тот, кто дал агенту задачу, отвечает за код так, будто написал его сам(!) Прикол, что агент-автор и агент-ревьюер могут бесконечно гонять друг друга. Один PR за ночь прошел 50+ раундов ревью, пока автор его не остановил. Посмотрели – около 59% замечаний касались старого кода, то есть ревьюер каждый раунд находил еще пару старых багов, а не новых. Ввели лимит в 3 раунда и повторное ревью только по новому диффу. С июня по сентябрь мержей стало в 2+ раза больше, а доля откатов упала больше чем на 40%. Каждый прошлый инцидент превратили в eval, ревьюера гоняют по нему каждый день, и любое изменение промпта или модели, ухудшающее скор, откатывают. Короче, это лучший публичный разбор того, как ревьюить агентский код, который я видел. Это можно внедрять хоть завтра, Code Review для Claude Code как раз вышел в GA на Team и Enterprise. Можно просто натравить ваших агентов на эту статью и попросить применить лучшие практики. Я еще когда токены не закончились недельные гоняю код-ревью по всем продуктам, тоже находится много чего среднего уровня. В общем, не верьте всему, что делает даже самая умная ИИ-ка - создавайте системы, в которых ее действия тщательно проверяются. https://claude.dev/blog/solving-code-review-at-anthropic/
-
Кстати, OpenAI модели появятся в Google Cloud, а скоро и в Antigravity и Gemini https://openai.com/ru-RU/index/openai-models-google-cloud/ Кажется, выручка увеличится в несколько раз, потому что кто сидел чисто на облаке гугла мог использовать только gemini, anthropic и опенсорс https://openai.com/ru-RU/index/openai-models-google-cloud/
-
А Антропик тоже решил своего персонального бота выпустить - Claude Duet. Отдельное приложение (iOS, Android и в claude.ai), где Claude не ждёт промпта, а сам следит за твоими сервисами и пишет, когда что-то требует внимания. Целятся в профессионалов и малый бизнес, у которых дел больше, чем рук. Все в принципе стандартно: – под капотом Opus 5.5, память, скиллы и коннекторы подтягиваются из твоего аккаунта Claude – утром присылает короткий брифинг по всем подключённым приложениям, днём пишет, только если реально надо – своя виртуалка с браузером, так что работает, даже когда ноут и телефон выключены – один тред на всё: голосом или текстом, от «перенеси встречу» до «собери финмодель» – 6000+ коннекторов и плагинов: Gmail, Slack, QuickBooks, Stripe, Gusto (зарплата), HubSpot, Docusign, Shopify, Canva – покупки через Stripe Link виртуальной картой, чекаут через Shop Pay, скоро – логин через 1Password Безопасность: – перед отправкой сообщения, платежом, подписью или удалением показывает, что именно собирается сделать, и ждёт апрува – торговать бумагами и переводить деньги между счетами нельзя даже с апрувом – отдельный классификатор не даёт слить номера карт и документов, медицину и личные финансы отправляет только по явной команде – пароли агент вообще не видит, всё по схеме Managed Agents Прикол, что сервисы он проверяет раз в несколько часов, а не постоянно – иначе лимиты подписки сгорят слишком быстро. Фоновые проверки и тяжёлые задачи едят те же лимиты Pro/Max, что и обычный чат. Подозреваю, на Pro будет сложновато :) Из кейсов понравился владелец сети кебабных на 110 сотрудников – разбирал инвойсы по точкам без «сотни вкладок». Доступ – research preview по вейтлисту, только Pro и Max в США. Скорее всего все очень сыро пока. Но тренд конечно прикольный. Короче, это уже не чат-бот, а секретарь с правом голоса. Типа такой помощник для малого бизнеса – большинству владельцев не нужен агент, который пишет код, им нужен тот, кто напомнит про неоплаченный счёт и подготовит зарплату. Хороший продукт, но кажется сильно "приземленнее" пока, чем у того же GrokBot или Dots. https://claude.com/resources/articles/claude-duet
-
edited Кажется завтра интернет будет как минное поле... ИИ нашёл дыру в PHP – языке, на котором работает ~70% сайтов мира. В России таких 90%~ Прочитал об этом во многих местах и скорее всего видели уже, но честно говоря это пипец даже для тех, кто никто не писал на PHP и не знает, что это за фигня такая. Потому что это WordPress, Drupal, Joomla и прочее. Сегодня разработчики PHP выпустили экстренное обновление. Проблема в самом языке – уязвим любой сайт на нём, даже если его код написан идеально. Оценка опасности - выше 9 из 10... То есть полная жесть. Как работает: – хакер может без логина и пароля захватить сервер: украсть данные, подменить сайт, атаковать посетителей – можно вытащить из памяти сервера чужие пароли и ключи доступа – под удар попадает всё за последние 10+ лет – WordPress, Drupal, Joomla, интернет-магазины. То есть огромная туча сайтов... – атаки начались ещё до выхода патча, а Финляндия и Нидерланды на время отключили госсайты Нашли это ИИ-модели: GPT-5.6 Sol от OpenAI и Gemini 4 Argon от Google – их использовали две компании по кибербезопасности, Calif и Wiz. Прикол, что ошибки сидели в коде больше десяти лет. Люди о них в целом догадывались, но превратить их в рабочий взлом было настолько сложно, что никто не довёл до конца. С ИИ один исследователь сделал за неделю то, на что у сильной команды ушли бы месяцы. Короче, если у вас сайт на ведущих бесплатных CMS-ках – срочно обновляйтесь. К сожалению, для старых версий патчей нет, лучше сразу отключиться. И куча давно не обслуживаемых сайтов будет 100% взломана в ближайшее время... И пострадают не только владельцы, но и посетители. Будьте крайне осторожны! И смените пароли, если были на каком-нибудь из вордпресных сайтов. Вот подобное описание: https://www.wiz.io/blog/php2shell-php-rce И вот хорошая статья на русском https://www.rbc.ru/technology_and_media/21/10/2026/6ad8faa567d49206c6d15fc0?from=main_lines_1
-


 +5
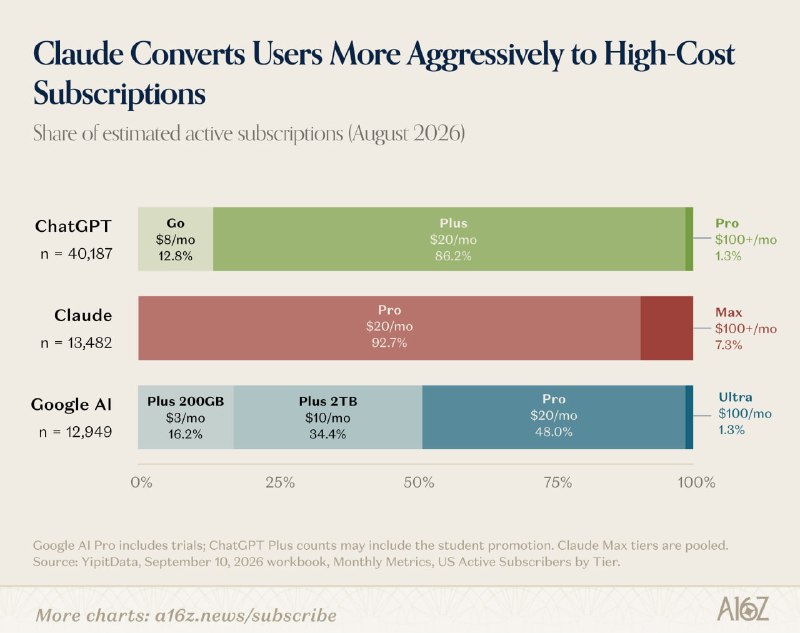
Top-100 Consumer AI Apps – очень интересная статистика и анализ. Много классных графиков. Главное: – ChatGPT по-прежнему лидер: в 2 раза больше трафика, чем у Gemini, и в 6 раз больше, чем у Claude. На мобилке разрыв ещё сильнее – 2.5x и 14x – Claude теперь уверенный №3: обогнал DeepSeek и Perplexity, а по платным подписчикам в США в начале года обошёл Gemini – Пересечение подписчиков ChatGPT и Claude – всего 8%. Это уже не взаимозаменяемые чатики, а разные аудитории – Платят за ИИ только 4.5% американцев (год назад было 2.1%). Каждый день пользуются – 25% – Топ-1% платящих тратит в среднем $903 в месяц и даёт 19.5% всех денег. Это больше, чем нижние 50% вместе взятые. У медианного пользователя – $25, и эта цифра почти не растёт – 29 из топ-50 по выручке вообще нет в рейтингах по трафику – Новичков в списке всего 11 – минимум за все семь выпусков. Рынок застывает Прикол, что на тарифе Max за $100+ сидят 7.3% платящих пользователей Claude – против 1.3% у Gemini и 1.1% у ChatGPT. Anthropic отказался от рекламы и монетизирует power users по полной :) Правда, летом у Claude вырос отток, а ChatGPT снова разогнался на GPT-5.6 и ChatGPT Work. Ещё один тренд – персональные агенты. Instinct в iMessage набрал 100K юзеров за 3 недели, причём только по инвайтам. 40% пользователей привязывают карту, тратят через него в среднем ~$1,300 в месяц, а годовой оборот уже больше $1 млрд. Meta Muse – 5M загрузок за месяц (Threads в своё время сделал 15M за 22 дня). Где стартапы ещё выигрывают у гигантов: своя модель (Suno, ElevenLabs, Midjourney), мультимодельность (Cursor, OpenRouter), узкая аудитория (OpenEvidence для врачей), железо (Plaud). И забавная деталь – NSFW-продукты из рейтинга исключили, иначе они заняли бы 20%+ веб-списка. Короче, массовый ИИ пока широкий, но неглубокий. Деньги делают те, кто с его помощью что-то строит и создаёт. Вывод для бизнеса простой: ваш клиент – не «все», а тот самый 1%, готовый платить $900 в месяц. Остальных, похоже, будут монетизировать по-старому – рекламой (у ChatGPT она уже даёт $1 млрд run rate) и комиссиями агентов. https://www.a16z.news/p/top-100-consumer-ai-apps-seventh
-
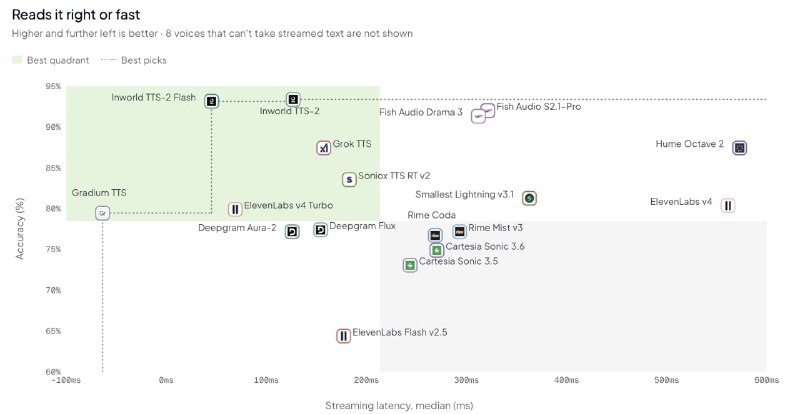

Cekura выложили большой бенчмарк TTS для голосовых агентов – 26 моделей Раз уж мы про голос немного говорим. Кажется, что там уже близок момент, когда человек не сможет определить, что с ним говорит агент. Итак, прогнали 104 фразы, которые реально говорит телефонный агент (от приветствия до ответов на 500 символов), каждую по 3 раза из одного региона US East – всего 30 564 запроса. Мерили задержку до первого звука, как модель замолкает, когда её перебили, цену и насколько правильно она читает номера, коды, адреса и названия лекарств. Все к сожалению на английском, но вы можете хотя бы топ-5 взять в свой анализ и протестировать на нужных языках. Что получилось: – Самый быстрый – Gradium TTS: −64 ms в стриминге, т.е. начинает говорить раньше, чем пришло последнее слово :) Но точность чтения 79.5% и $36 за 1M символов – Лучший баланс – Inworld TTS-2 Flash: 45 ms, точность 93.2%, $15 за 1M. Старший TTS-2 – лидер по точности, 93.4%, за $25. Снова поздравляю команду Inworld. Видимо уже просто отдам клоду монтировать с ними интервью, дизайнер-монтажер бесит :) – ElevenLabs v4 Turbo – 69 ms, но 79.9% точности и $40. v4 – уже 561 ms и $80, а старый Flash v2.5 правильно читает коды и телефоны только в 55% случаев. А ведь раньше казалась топ-моделька. – Cartesia Sonic 3.6 – 270 ms и после перебивания продолжает говорить ещё ~0.8 сек. Для агента, которого постоянно перебивают, ну такое – Самые дешёвые – Soniox TTS RT v2 ($14.81) и Grok TTS ($15), оба замолкают мгновенно – Самый естественный голос – Fish Audio Drama 3 (4.54 по UTMOS), точность 91.3%. Удивительно... – Gemini, GPT-4o mini TTS, Qwen3-TTS и MAI-Voice не принимают текст по словам, поэтому в рейтинг по стримингу не попали Точность TTS тут оценивает… STT (я тоже так делаю :) ): записи прогоняют через Deepgram Nova-3 и Whisper. Кстати «St. Mary’s on Main St.» оказалась сложнее, чем «levothyroxine» – медтермины почти все читают на 97–100%, а Saint vs Street Cartesia, например, угадывает в 54–58%. Короче, если собираете голосового агента – смотрите не на общий скор, а на то, что критично именно вам: задержку, перебивания или чтение номеров заказов. Inworld сейчас выглядит как дефолтный выбор, а ElevenLabs за свои деньги заметно отстаёт. Харнесс и фразы открыты на GitHub – можно прогнать на своих сценариях. Очень советую, кстати, брать, чтобы не пилить самостоятельно коннекторы ко всем провайдерам. https://benchmarks.cekura.ai/text-to-speech
-
Mistral внезапно зашли во временные ряды Выпустили Timestral – первое семейство foundation-моделей для временных рядов. Это не LLM, а чисто числовая модель: на вход история датчиков, метрик, продаж, на выход – прогноз. Что внутри: – 4 размера: 5M, 28M, 123M и 209M параметров, супер-компактная. Можно запускать без GPU-шек – контекст 32K шагов, на выходе вероятностный прогноз на несколько шагов вперед. – мультивариантность: например, вибрация, температура и давление насоса прогнозируются вместе, а не каждый датчик сам по себе – ковариаты: прошлые, известные заранее (график производства, праздники, прогноз погоды) и категориальные (день недели, состояние станка) – zero-shot на данных, которые модель никогда не видела Прикол, что обучали практически только на синтетике. Бенчмарки: – 209M – 1-е место на всех трех основных бенчах (GIFT-Eval, TIME, fev-bench) по всем пяти метрикам, с 2/3 параметров прошлого лидера, один чекпоинт без ансамблей – 28M обходит Chronos-2, который примерно в 4 раза больше – 209M обходит TimesFM-3 и Falcon-2.0 Я бы сильно не верил, потому что как уже писал с OCR, мистраль очень любит свои бенчмарки использовать или хакать их. Но присмотреться можно. Лицензия – modified MIT, веса на Hugging Face, код на GitHub. Короче, для всякого спроса, нагрузки, телеметрии, денежных потоков, где только всякая АРИМА/Профет, может быть полезно. Но я бы не сильно верил, что это best-of-the-best. Зато Европейский суверенный AI! https://mistral.ai/news/timestral/
-
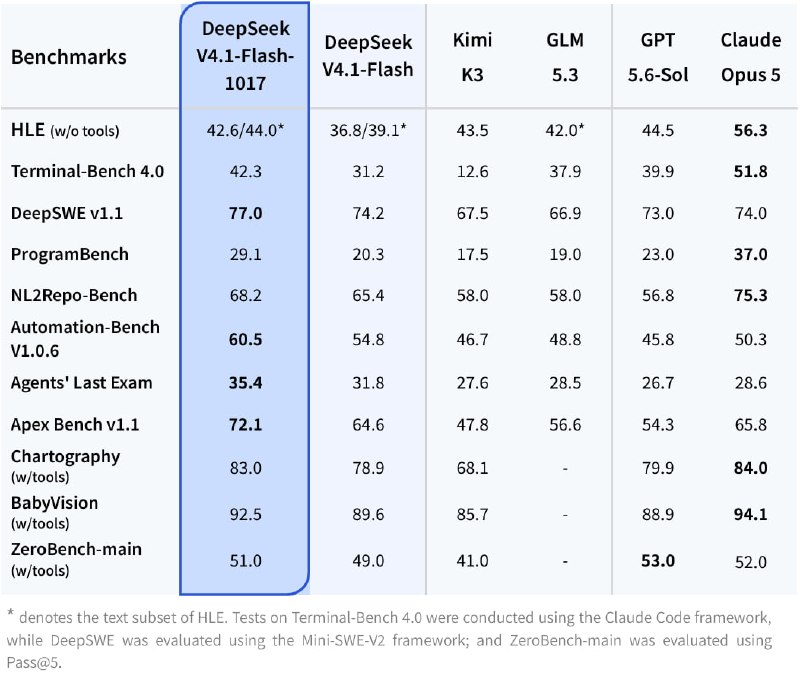

DeepSeek кажется фигачит мажорные версии, скрывая их за минорными названиями. Новая V4.1-Flash-1017 сильно лучше. – Дообучили на сборку проектов целиком, от игр и гигантских баз до 3D-моделирования. – Быстрее выполнение задач и короче выдача, отдельно затачивали под DeepSeek Harness – 1M контекста, до 384K на выход, зрение, Anthropic- и Responses-совместимый API – в Claude Code и Codex втыкается очень легко, просто подменив base_url – цена как всегда копейки: $0.30 / $1.20 за 1M вход/выход в пик и вдвое дешевле в остальное время. Пик – по китайскому времени. Для Европы это утро. После обеда и вечером всё в полцены. Бенчмарки (от самих DeepSeek, 1017 vs Opus 5): – DeepSWE v1.1: 77.0 vs 74.0 – Terminal-Bench 4.0: 42.3 vs 51.8 (у прошлой версии было 31.2) – ProgramBench: 29.1 vs 37.0 – Automation-Bench: 60.5 vs 50.3 – Apex Bench: 72.1 vs 65.8 – HLE без инструментов: 42.6 vs 56.3 То есть в агентных и автоматизационных задачах впереди, а в чистом reasoning и сложном кодинге Opus 5 еще сильнее. Задача на DeepSWE стоит чуть меньше $0.20 против ~$0.50 у прошлой версии, а GPT-6 Astra, Gemini 3.8 Flash и Opus 5 на том же графике – от $2 до $10+. Независимые цифры уже подъехали: – Artificial Analysis: 45 в Intelligence Index (было 39), #2 из 121, $0.26 за задачу против $0.49. Но болтливость никуда не делась – 210M токенов на прогон при медиане 140M – Bito прогнали ее внутри Claude Code на своих реальных задачах: в длинных агентных сессиях 77% – как Sonnet 5.5 и Haiku 5.5, у Opus 5.5 – 87%. Сессия стоит $0.14 против $1.28 у Sonnet и $5.42 у Opus. На коротких вопросах – 90%, вровень с Opus, примерно в 25 раз дешевле – минусы там же: сессия идет 15.4 мин против 6.8 у Sonnet, а на написании и аудите изменений проседает до 68% и 70% против 85% и 82% у Opus. Цена за токен не изменилась, а стоимость задачи в AA упала примерно на 47% – чисто за счет того, что модель меньше болтает. Заодно открыли свой поиск: Search и Fetch API по $0.75 за 1000 вызовов, через Claude Code и Codex бесплатно до 31 октября! То есть можно теперь использовать супер-дешевый поиск и парсинг! Как уже раньше было - сожрали сотню стартапов :) Короче, отличная рабочая лошадка и с открытыми весами! Опять же дали сотне стран возможность создавать "свой AI" https://api-docs.deepseek.com/news/news261017/
-

Через 17 минут встреча с Anthropic как раз в рамках программы Claude Startups. Надо чего узнать?
-
edited Попалась в ленте реклама новой версии бесплатного OnlyOffice (10.0), и кажется, что с офисами вопрос уже решен Написали, что полностью пересобрали приложение, ИИ (всякие там саммари, редактирования, вопросы по документу) вынесли в аддон, добавили поиск, MCP сервера, поддержку как облачных, так и локальных моделей, ну и еще большую поддержку форматирования, редактирования, печати и всяких старых форматов. Бесплатно и доступно для всех операционок. То есть теперь у нас есть LibreOffice (но он без ИИ-ек и кажется устаревает уже), OpenOffice (но давно не обновляется), WordCraft, GridCraft, DeckCraft, написанный ИИ-кой с нуля, GenOffice от GenSpark, тоже с нуля с ИИ, но командой, и всякие маргинальные Euro-Office, WPS и Collabora. Кажется, вопрос с открытием/редактированием документов как людьми на всех операционках, так и ИИ-ками уже полностью закрыт и бесплатен. https://www.omgubuntu.co.uk/2026/10/onlyoffice-10-expands-ai-tools
-

 +1
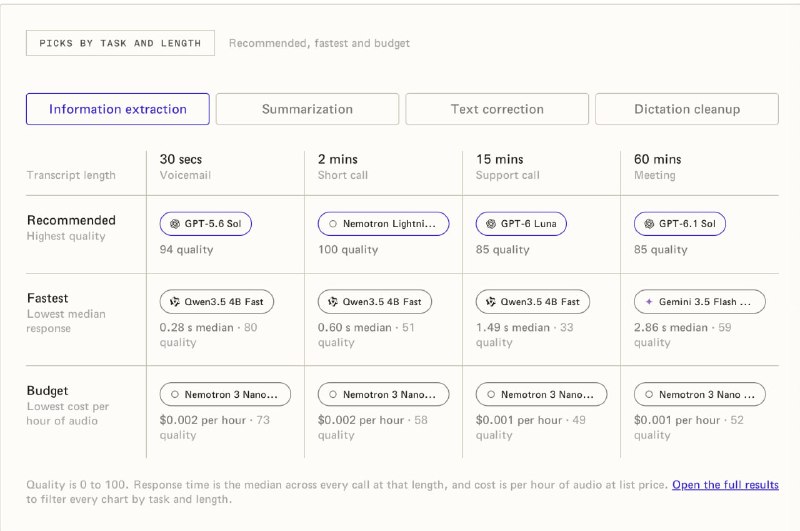
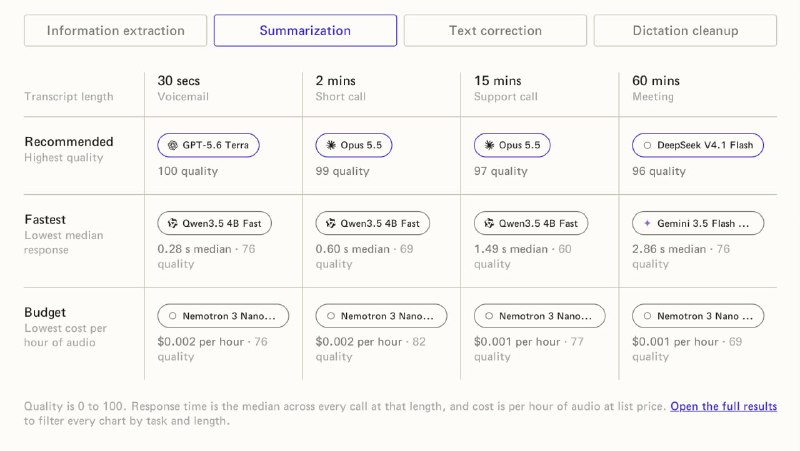
Еще бенчмарк по голосовым ассистентам, но уже со стороны качества работы LLM AssemblyAI выкатили Voice Standard Bench – 50+ LLM на реальных голосовых задачах В общем, после транскрибации почти всегда идёт LLM-вызов – почистить диктовку, сделать саммари звонка, вытащить имена и номера заказов. На объёмах этот шаг съедает заметную часть бюджета, потому что туда по привычке ставят фронтир-модель. В итоге что в бенче: – 4 задачи: саммаризация, извлечение данных, коррекция текста, чистка диктовки – 4 длины: 30 сек (голосовое), 2 мин, 15 мин (звонок в поддержку), 60 мин (митинг) – на входе реальный выход STT – с «эээ», оговорками и ошибками распознавания – качество, скорость и цена за час аудио рядом – судьи – Claude Opus 5.5 и GPT-5.6 Sol, диктовка проверяется механически по эталону Лучшие: – Overall: GPT-6 Astra – 92, GPT-6 Luna – 90 (самая дешёвая в пределах 8 пунктов от топа), GPT-4.1 – 84 (самая быстрая) – Саммари: Opus 5.5 – 98, GLM-5.3 Flash – 91 за копейки – Диктовка: Gemini 4 Argon – 100, GLM-5.3 Flash – 96 – лидер по качеству стоит в 15–77 раз дороже модели, отстающей всего на 2 пункта. Только на часовых записях разрыв сжимается до ~4× – GPT-6 Luna – около полцента за час аудио, но платишь задержкой – gemma-4-31b на 30 секундах отвечает быстрее секунды с качеством 93 (у Luna – 1.7 сек) – Qwen3.5 4B Fast – самая быстрая, но на 15-минутных звонках качество падает Прикол, что опенсорс почти не выигрывает по цене – Luna и так стоит копейки, а экономия на открытых моделях – доли цента ценой 10+ пунктов качества на всём, что длиннее 2 минут. Зато по скорости на коротких входах открытые модели на их железе рвут всех: те же модели у других хостеров отвечают 10–20 сек. Бенчмарк открыт на GitHub, и его можно прогнать на своих транскриптах и записях. Выбрать уже под себя. Короче, фронтир в голосовых сценариях нужен в основном на длинных митингах. Для голосовых сообщений, коротких звонков и диктовки хватает маленькой быстрой модели, а сэкономленное лучше потратить на нормальный подбор модели для своих данных. https://www.assemblyai.com/blog/voice-standard-bench
-
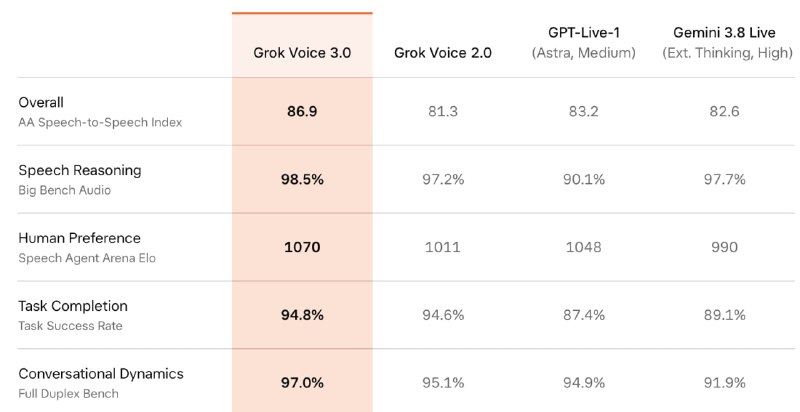

Грок все продолжает прокачивать голос, выпустили Grok Voice 3.0 Speech-to-speech модель, вышла в API по той же цене, что и вторая версия. Скорее всего у них огромнейшие датасеты речи из машин. В итоге обошли практически всех. Бенчмарки (Artificial Analysis): – Speech-to-Speech Index – 86.9 и 1-е место (GPT-Live-1 – 83.2, Gemini 3.8 Live – 82.6) – Big Bench Audio – 98.5% – Task Success Rate – 94.8% против 87.4% у GPT-Live-1 – Full Duplex Bench (паузы, перебивания, очередность реплик) – 97% – EVA-Bench от ServiceNow (200+ корпоративных сценариев поддержки) – 74%, лучший результат Деньги: – $0.08/мин, то есть $4.80 в час (!) Это прям супер-дешево! – стоимость задачи на Big Bench Audio – $0.025, у GPT-Live-1 – $0.030, у GPT-Realtime-2.1 – $0.055 – задержка до первого звука меньше секунды Прикол, что на τ-Voice (звонки в поддержку с акцентами, шумом и перебиваниями) Grok набирает 71.6%, а GPT-Live-1 – 74.5%. xAI называет это «сопоставимо», зато на 40% быстрее. В колл-центрах Starlink Grok отвечает на 20 тыс. звонков в день на нескольких языках, около 70% закрываются без человека, а каждый четвертый продажный звонок заканчивается покупкой до того, как клиент положил трубку. Плюс миллионы разговоров в день в машинах Tesla. Короче, голосовые агенты для поддержки уже могут просто сожрать все, что только можно... https://x.ai/news/grok-voice-3
-
О, И Argon 4 вышла в API и Gemini https://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-4-argon/
-
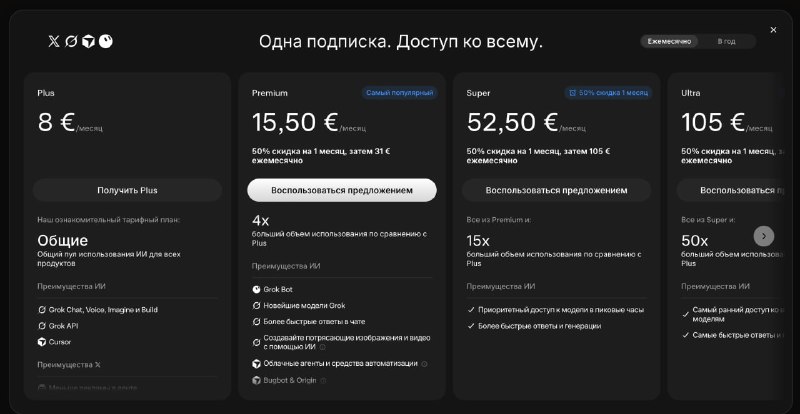
SpaceXSI какой-то аттракцион неслыханной щедрости представил Появилась подписка за 8 евро, вместе с галочкой в Twitter и Cursor. Подписка за 30 (а на месяц за 15) евро теперь включает в себя все возможности генерации аудио, фото, видео, Grok Bot, Cursor и Twitter Premium (это все раньше стоило 90 или больше). Короче, надо брать https://grok.com/plans
-
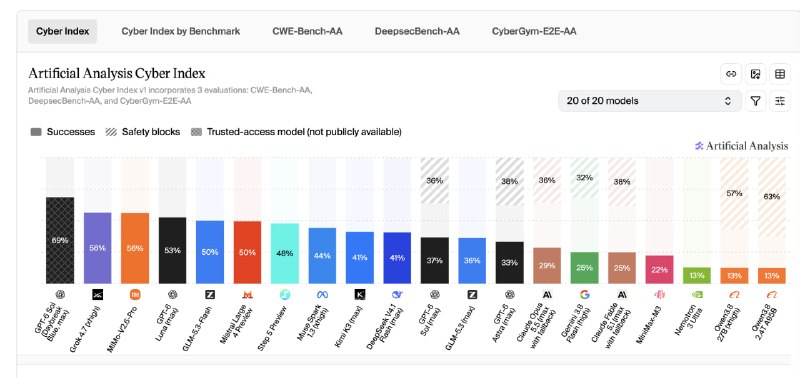

Ну и еще из "пропущенного интересного" новости одной строкой. 1. Если надо что-то по безопасности разведать, но у вас нет доступа к GPT-6 Daybreak, то вам на помощь придет Grok-4.7, он все сделает и не откажет. Первое место в кибербез-индексе https://artificialanalysis.ai/evaluations/artificial-analysis-cyber-index 2. А вот по созданию 3д-моделей лучше всего Sonnet, Opus и Astra и Sol https://artificialanalysis.ai/articles/aa-3d 3. Кажется эпоха "клонирования" и доработки софта началась. Вот например супер-популярная библиотека - Reverse Engineer Anything. 180000 звезд на гитхабе Может разбирать работу десктопных и мобильных приложений, сайтов, баз данных, прошивок, логов, процессов, файлов и ресурсов. Достаточно просто попросить... https://rea.tools/ 4. И на закуску опенсорсные переписанные версии популярных приложений. Выложили: – PhotoCraft → Photoshop – VectorCraft → Illustrator – FilmCraft → Premiere Pro / DaVinci – LightCraft → Lightroom – EffectCraft → After Effects – DesignCraft → InDesign – SoundCraft → Pro Tools / Audition – CADCraft → AutoCAD – WordCraft → Word – GridCraft → Excel – DeckCraft → PowerPoint – PdfCraft → Acrobat – Все кроме FilmCraft могут в браузере работать. Windows, Mac, Linux. – всё локально, файлы никуда не уходят – каждым приложением можно рулить через CLI, JSON-канал или MCP-сервер – то есть они изначально сделаны под ИИ-агентов – ставится одним лаунчером, который всё обновляет Понятно, что пока Альфа-версия, но все-таки. Кажется, от проприетарного софта скоро не останется ничегошеньки... https://getartcraft.com/apps
-

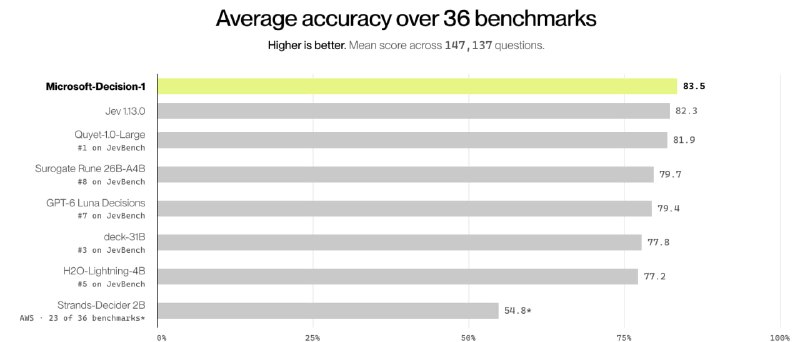
Ну и да, OpenAI и Microsoft скопировали Decision-модели за несколько недель Как уже писал, идея классная, но это все очень легко скопировать. Даёшь вопрос и фиксированный список вариантов, модель возвращает вероятность для каждого: да/нет, выбор из списка, оценка по шкале. Теперь за дело взялись крупные игроки. OpenAI Decisions API (уже можно пользоваться): – под капотом GPT-6 Luna, отдельный эндпоинт – на вход текст и картинки (!) - то есть можно прям закидывать картинки документов, например, или кадры с камер, чтоб отмечать, есть там дефект на товаре или там человек без шлема. – $0.10 за 1M входных токенов, выход бесплатно – ~150 мс на решение против ~1.6 с у той же Luna через обычный API (цифры OpenAI) – бенчмарков по качеству нет Microsoft-Decision-1 (с 9 октября, Foundry и OpenRouter): – Qwen3.5-9B от Alibaba, дообученный под скоринг – только текст, контекст 32K, весов нет – $0.042 за 1M входных, выход бесплатно – по замерам Microsoft: лучшая точность на 36 бенчмарках – при перефразировании запроса решение меняется в 1.3% случаев Ну и пишут, что уже работает на новых модельках. У Microsoft – внутренний прод: Xbox разметил 10+ тыс. отзывов с качеством GPT-6 Sol, но в 14 раз быстрее и в 200 раз дешевле, Copilot оценивает им ответы в 100 раз быстрее Luna. У OpenAI – картинки: модель по кадрам игры решает, перестраиваться ли в другой ряд, и ведёт робота Microduck от Hugging Face за яблоком. Прикол, кстати, что Microsoft взяли китайцев в качестве базы. Короче, супер-полезный движок для быстрого принятия решений: роутинг между моделями, разметка, LLM-as-judge, «продолжать / остановиться / отдать человеку» – всё это сейчас гоняют через большие модели с секундными задержками. Миллион отзывов по 500 токенов – ~$21 у Microsoft и ~$50 у OpenAI. Для текста я бы брал дешёвые или открытые модели, OpenAI – если нужны картинки: computer use, модерация изображений. И калибровку проверять на своих данных. https://commandline.microsoft.com/microsoft-decision-1-model-foundry/ https://developers.openai.com/api/docs/guides/decisions
-
edited 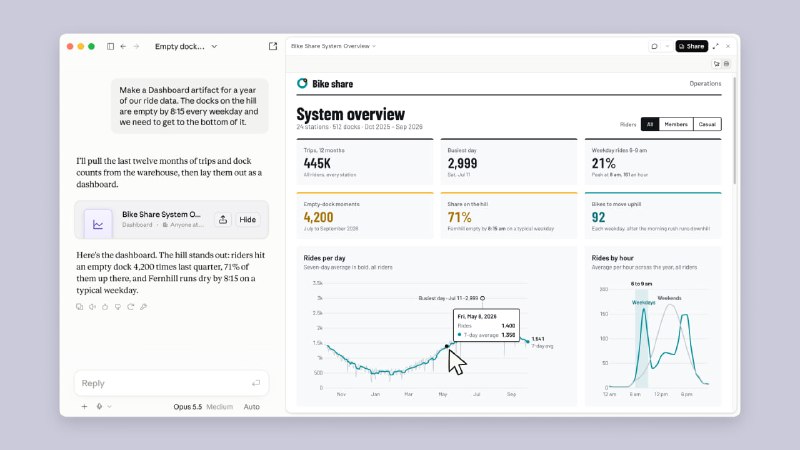
Claude теперь сам делает живые дашборды и анимированные ролики Не могу не поделиться. Снова про пожирание аналитических AI стартапов. 8 октября Anthropic выкатили две беты – Claude Dashboards и Claude Motion. И заодно сняли бету с Docs, Slides и Design: они теперь на всех тарифах, включая бесплатный. Dashboards: – подключаете Snowflake, BigQuery, Databricks, Redshift, ClickHouse или Salesforce и спрашиваете обычным языком. Странно, что нет PowerBI и Excel, это движок "баз" для миллионов компаний. – Claude сам пишет SQL, строит дашборд и обновляет его, когда меняются данные – кликаете на любую цифру – видите запрос, который ее посчитал, и когда данные последний раз обновлялись – если нужно копать глубже – отправляете в Hex, Mixpanel, PostHog, Grafana, Amplitude, скоро Tableau и Looker – доступно на всех платных планах. Не знаю, что думают теперь все создатели стартапов про "я спрошу свои данные". Сначала OpenAI сделали свою штуку, теперь Claude. Кажется, скоро останется только "Core AI" и коннекторы... Motion: – пишете /motion, и квартальный отчет превращается в 30-секундный ролик для all-hands, а график в борд-деке начинает двигаться – экспорт в MP4, дальше можно доработать в Runway, Higgsfield, HeyGen, Adobe, Descript – только Team и Enterprise, лимиты общие с остальной работой Прикол, что Motion – это вообще не видеогенерация. Claude пишет код анимации, поэтому можно попросить «поменяй Q3 на 18%» или «замедли вторую сцену», и остальной ролик не перегенерируется. И никаких ИИ-людей в кадре – только ваши тексты, графики и картинки. Для корпоративных презентаций ровно то, что надо: 18% должны остаться 18%, а не превратиться в 81% на третьей секунде :) Еще из важного: отдельный claude.ai/design закрывается 14 декабря, дизайн-системы надо мигрировать заранее. Через Docs/Slides/Design уже сделали 45+ млн документов, презентаций и дизайнов. Короче, раньше была проблема с работой с данными, что ИИ-ка галлюцинировала и недетерминированно отвечала. Поэтому и стартапчики пытались вокруг это родиться, где все на базе хорошей работы с SQL, инструментов анализа, профессиональных знаний. Теперь у вас под каждой цифрой запрос и модели стали умнее большинства аналитиков... Потом ИИ-ка будет и за вас проверять и выводы делать. https://claude.com/resources/articles/dashboards-and-motion
-
Мне тут дали промокод на скидку 50% на AI-митап для бизнеса в Никосии Panis.News (это один из крутых обозревателей ИТ-бизнеса на Кипре) собирает «AI in Practice: Changing the Future of Business». Для CEO, C-level и владельцев МСБ, которые хотят понять, что ИИ реально даёт бизнесу. Практически всех участников знаю и они довольно много делают реальных сервисов, а не просто презентаций и сгенерированных ИИ статей в Linkedin про космические корабли. – Monica Odysseos (Head of AI & Data Lab, Grant Thornton) – зачем вообще это всё и какие удобные мифы пора выкинуть – George Malekkos (CEO Powersoft, президент CITEA, местной ассоциации IT бизнеса) – как начинать с болей бизнеса, а не с технологий – Paris Thomas – «Будет ли ваш бизнес жив в 2030?» с живыми демо. Он преподаёт Strategy with AI в London Business School и IMD и консультировал Nestlé и Saudi Telecom – приветственное слово от Chief Scientist Кипра Демитриса Скуридиса – Q&A, потом нетворкинг с напитками до 22:30 European University Cyprus, Энгоми, 19 октября (понедельник). Сбор с 18:00. Короче, со скидкой 50% будет стоить всего 25 евро. Промокод - 50 (просто цифры) https://luma.com/ai-in-practice-cyprus
- Older posts