
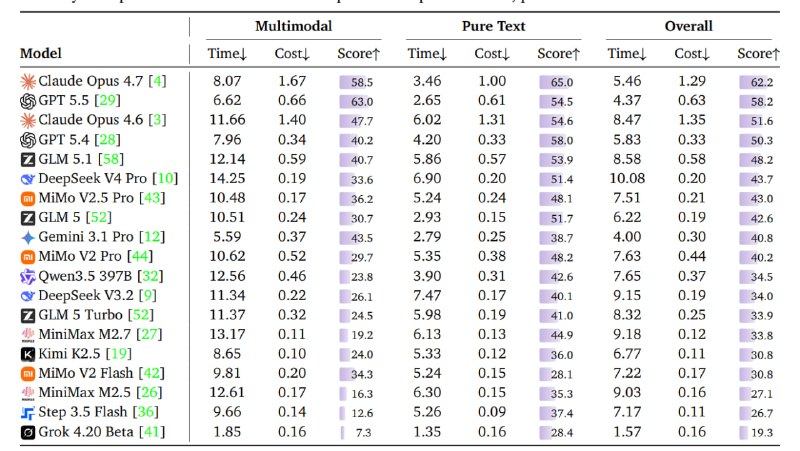
И про агентов всяких и моделей в них. Вот свежий бенчмарк работы разных моделей с типичными задачами в обвязках агентов - WildClawBench. Больше всего задач решил Opus 4.7, но это все равно всего 62%. При это каждая стоила в среднем $1.3 и занимала 5,5 минут. GPT-5.5 лучше в мультимодальности, решила 58% задач и каждая на минуту быстрее и в 2 раза дешевле. Ну и оболочка тоже влияет. Прикольно, что GPT-5.4 лучше всего работал в своей, а китайские модели - в Hermes. https://arxiv.org/abs/2605.10912