Короче для Haiku чуда не случилось, слишком сильная конкуренция
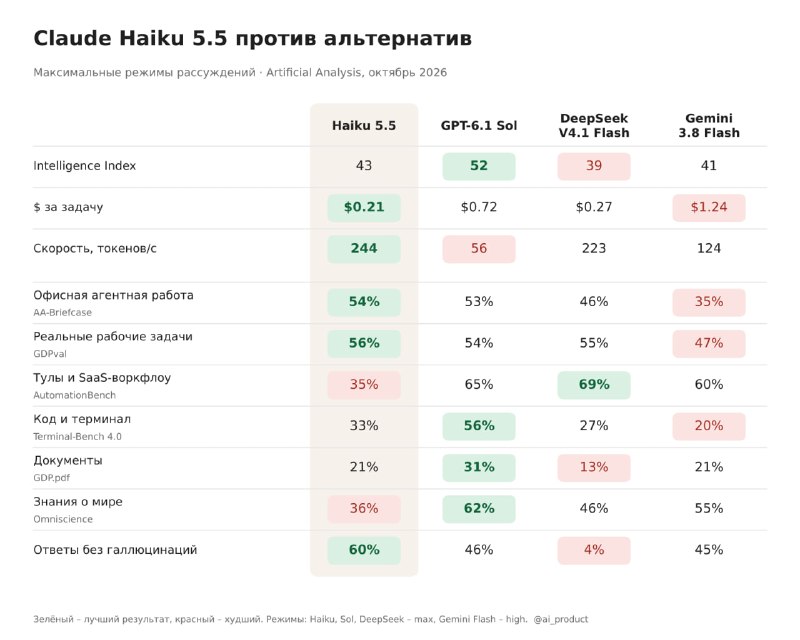
Если брать сравнение с аналогичными по цене моделями:
Haiku 5.5
– В офисной агентной работе на уровне Sol, который в 3.5 раза дороже
– Галлюцинирует меньше всех из четырёх
– Но с тулами и SaaS почти не справляется: 35% против 60–69% у остальных
Короче, для всяких документов/экселек, извлечения данных, саммаризации, но с инструментами все плохо.
GPT-6.1 Sol
– Самая умная. При той же цене за задачу, что у Haiku, даёт 48 баллов индекса против 43
– Лучшая в коде, документах и знаниях о мире
– Отвечает за 16 секунд, а Haiku на max – почти за 6 минут(!)
Удивительно, но sol по цене-качеству оказывается лучше, чем хайку, которой выкрутили болтливость на максимум...
DeepSeek V4.1 Flash
– Лучше всех работает с тулами: 69%
– Но выдумывает почти всегда, когда не знает ответа: без галлюцинаций только 4% ответов
Gemini 3.8 Flash
– Хорошо знает мир и понимает картинки
– Но дорогая: $1.24 за задачу, в 10 раз дороже Haiku при том же индексе
Прикол, что max-режим у Haiku почти бесполезен: по сравнению с xhigh он даёт +2 балла индекса и стоит почти вдвое дороже.
Короче, кого брать:
– По умолчанию – Sol
– Агенты с кучей тулов – DeepSeek, но проверять каждый ответ
– Извлечение и сопоставление данных из контекста – Haiku на high
– Мультимодалка, разные языки – Gemini Flash
https://artificialanalysis.ai/models/claude-haiku-5-5
edited
Опа, Anthropic выкатили Haiku 5.5
Не обновляли год, у конкурентов даже уже крутые маленькие модели, для обычных агентских задач: суммаризация, классификация, сабагенты, работа в браузере. Заодно самая быстрая модель Anthropic на сегодня.
Цены за 1M токенов (промпт до 100k / больше 100k):
– вход $0.10 / $0.50 (у Haiku 4.5 было $1.00)
– выход $0.50 / $2.50 (было $5.00)
– чтение кэша $0.01 / $0.05
Короче, если до 100000 токенов работа - все ок, если больше - начинаете тратить в 5 раз большею.
В среднем выходит примерно на 75% дешевле 4.5. Это уже с учётом нового токенизатора, который расходует чуть больше токенов на задачу.
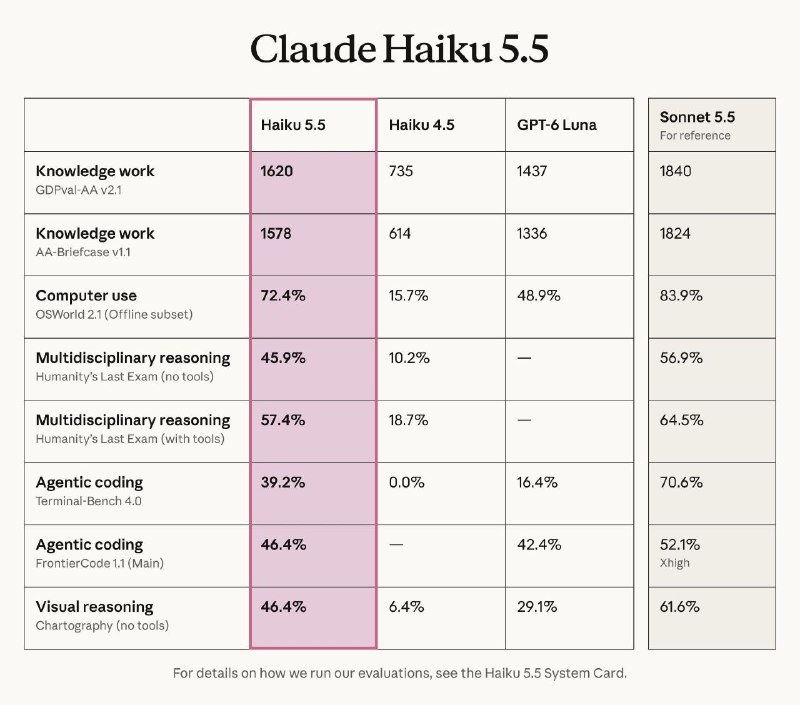
Бенчмарки (Haiku 5.5 / Haiku 4.5 / GPT-6 Luna):
– OSWorld 2.1, computer use: 72.4% / 15.7% / 48.9%
– Terminal-Bench 4.0: 39.2% / 0.0% / 16.4%
– GDPval-AA: 1620 / 735 / 1437
– HLE без инструментов: 45.9% / 10.2% / –
Для сравнения, Sonnet 5.5 набирает 83.9% на OSWorld и 70.6% на Terminal-Bench.
Прикол, что у Haiku впервые появился регулятор effort. Теперь можно выбирать между ценой и мозгами, как у старших моделей.
Что ещё завезли:
– чтение кэша у Sonnet 5.5 подешевело вдвое, до $0.10, поэтому агентские задачи выходят примерно на 20% дешевле
– подписчики Max и Team получат ежемесячные API-кредиты: $100 на Max 5x, $200 на Max 20x и до $500 на команду, ура, этого сильно не хватало.
– в Python и TS SDK появились computer use и browser use в бете
Короче, для сложного кодинга это не замена Sonnet – Anthropic сами честно пишут, что для такого лучше брать старшие модели. Но для document intelligence, классификации, разбора заявок и сабагентов $0.10 за миллион входных токенов меняет экономику. То, что раньше не сходилось по юнит-экономике, теперь сходится. Должно быть даже дешевле Luna и Gemini Flash.
https://www.anthropic.com/claude-haiku-5-5
OpenAI вывалили на GitHub 722 математические статьи от своей внутренней модели. Одним релизом :)
Да, тоже было интересно разобраться, что там вышло. Математикам тоже приготовиться на выход?
Короче, в сентябре они заявили, что решили одну из задач тысячелетия (за каждую дают $1M) – 88 часов, тысячи агентов параллельно. После этого 25 лауреатов Филдсовской премии (математический «Нобель», там и Теренс Тао) подписали открытое письмо: вы решаете задачи как бенчмарк, а математике нужно понимание. OpenAI сходили посоветоваться с математиками из Принстона и... выложили ещё 722 статьи :)
Модели дали ~4000 открытых задач, на которых люди застряли. Из этого получилось 722 статьи с решениями.
– В среднем 3 часа думанья уровня ChatGPT Pro на результат. Не суперкластер, а примерно то, что вы можете сделать сами за вечер, только модель внутренняя
– 162 доказательства проверены в Lean. Это такой язык программирования для математики: доказательство пишется как код, и компьютер его проверяет как компилятор. Скомпилировалось – значит без ошибок. Остальные 560 никто толком не проверял, в README так и написано: «могут быть ошибки»
Что из этого понятно не только математикам:
– Гипотеза уникальных игр. Она про то, какие задачи оптимизации в принципе нельзя решить хорошо даже приблизительно. Из доказательства следует, что для кучи практических задач (разбить сеть на части, раскидать ресурсы, кластеризовать) нынешние алгоритмы уже лучшие из возможных, и искать лучше бессмысленно. Проверено в Lean
– «Почти гипотеза Римана». Сама гипотеза Римана – главная нерешённая задача математики, про то, насколько равномерно разбросаны простые числа. Её ослабленную версию не могли доказать с XIX века. Модель доказала. Тоже в Lean
– Нельзя написать программу, которая для любого уравнения скажет, есть ли у него решение в дробях. Вопрос висел десятилетиями. Без Lean
– Кусок ещё одной задачи тысячелетия (гипотеза Ходжа). Объяснить на пальцах её не может никто, так что поверим на слово :)
Но!
– Самые громкие результаты получены не той стандартной процедурой на 3 часа, а отдельно, и один текст правили люди
– Lean проверяет, что код соответствует ТЗ. А правильно ли написано само ТЗ, то есть то ли вообще доказали, – всё равно смотреть людям
– Авторов нет, всё подписано «OpenAI». Модель не выпущена, обещают «ответственный релиз»
Прикол, что письмо было ровно про то, что математикам не нужны сотни решённых задач без понимания. В ответ им дали 722 решённые задачи, но с компиляцией и пересказами того, как модель думала :)
Короче, узкое место переехало с «найти решение» на «проверить и понять решение». Ровно как с код-агентами: написать код уже не проблема, проблема – ревью. Только тут ревью одной статьи у живого математика занимает месяцы. Ну и если внутренняя модель за 3 часа такое делает, то следующий релиз OpenAI будет интересным. Математика в общем будет вайб-математикой. Представляю, как профессора и аспиранты закидывают какие-нибудь сложные штуки из своей области, над которой бьются годами, и получают решение за 3 часа. Так как математика супер-формализуема и проверяема, то кажется для ИИ это вообще не будет проблемой в ближайшем будущем.
https://openai.com/index/sharing-ai-progress-in-mathematics/
Блин, мне проапрувили почти сразу, вау!
О, Anthropic расширили программу Claude Startups – теперь до $7K на Claude и до $45K на партнёрские тулзы
Что внутри:
– Год Claude Team бесплатно – до 5 Premium-мест (это $6K из тех самых $7K)
– $1,000 на API сразу после одобрения – погонять идеи и первые эвалы
– Claude Startup Stack – скидки и кредиты у партнёров «до $45K» (по прайсу, и не факт, что все офферы можно совместить)
– Office hours с Applied AI командой Anthropic
– Помощь с публикацией своего коннектора/плагина в Claude Marketplace
– Founder House, хакатоны, митапы и рассылка для стартапов
Кто может подать: компании, основанные за последние 5 лет или получившие инвестиции за последние 2 года. Порог мягкий – под него попадает почти любой живой стартап..
Короче, если вы строите на Claude – подаваться однозначно, бесплатный Team на год сам по себе окупает время на заявку. Ну и понятно, что это борьба за лояльность разработчиков: кто вырос на Claude, тот на нём и останется :)
https://claude.com/resources/articles/were-expanding-the-claude-startups-program-to-help-founders-build
Mistral зарелизил версию 4
Типа самая мощная за пределами Китая и США. Даже круче корейской, швейцарской и немецкой, еее (!)
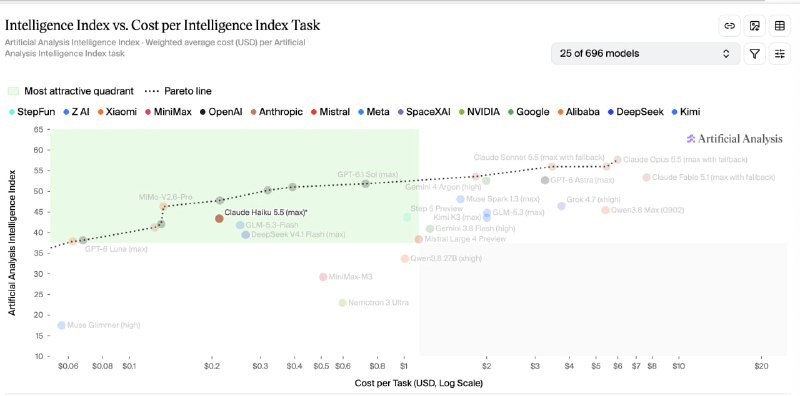
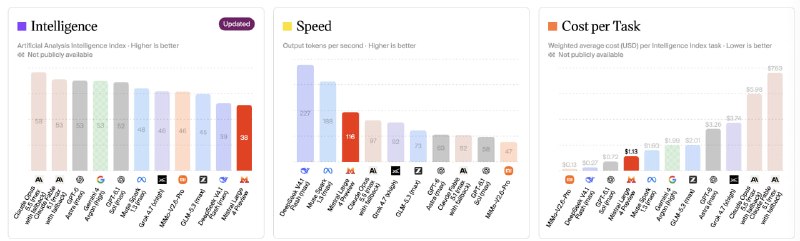
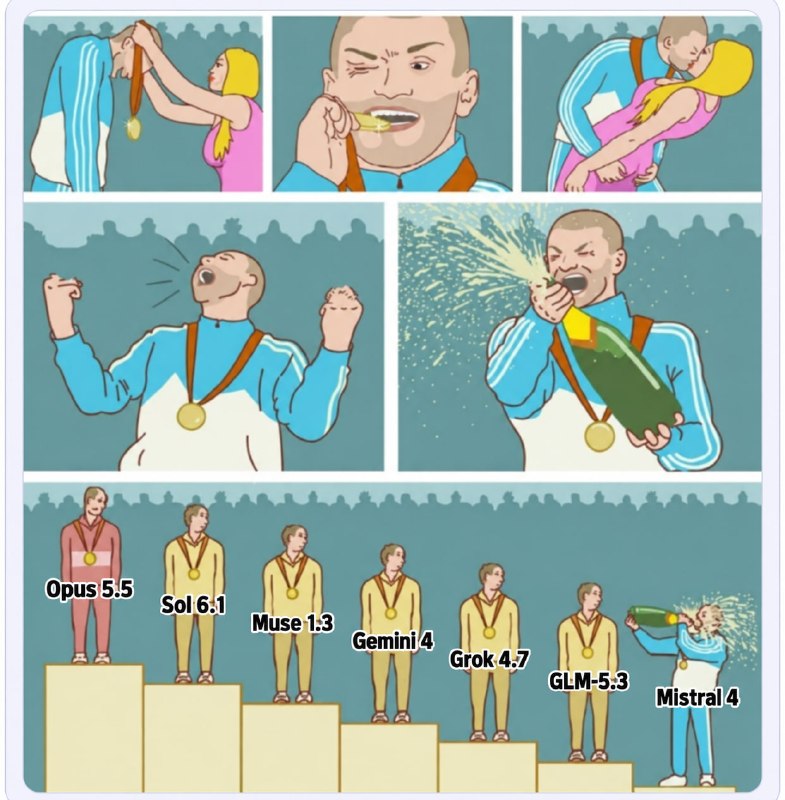
Но ребята, она занимает 64 место в мире... А стоит как GPT-6 Astra. По парето-фронтиру, то есть цене-качеству вообще боль, DeepSeek 4.1 Flash в 10 раз дешевле просто рвет на тряпки. Сорри, но ничего кроме этого мема про спортсменов я не могу добавить
https://artificialanalysis.ai/models/mistral-large-4
Свежие обновления выгодности подписок подъехали
Ребята не поленились: гоняли запросы через все тарифы (Anthropic, OpenAI, Meta, китайцы, Cursor, Devin) и смотрели, на сколько сдвигается шкала лимита от каждого типа токенов. В качестве промпта – кусок «Войны и мира», потому что на рандомный мусор модели отказываются отвечать :)
Что получилось:
– Подписки – это всего ~10% выручки Anthropic, но они съедают 40%+ инференс-компьюта. Т.е. это прям маркетинг за свой счёт. Но при этом они все еще довольно выгодные для компаний.
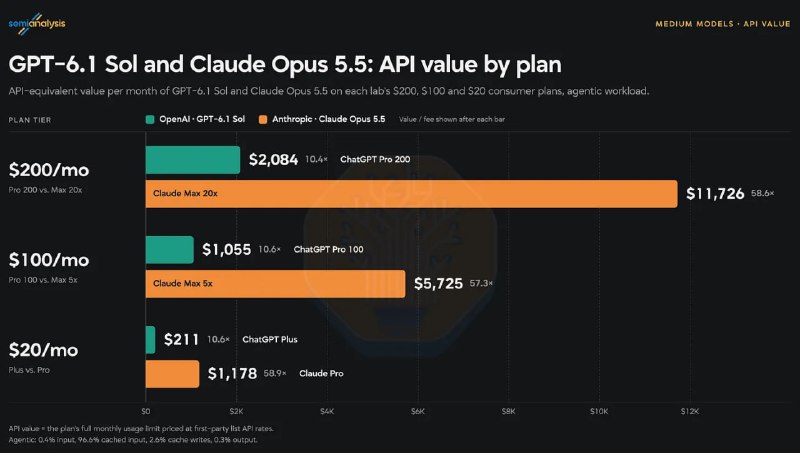
– Fable 5.1 vs GPT-6 Astra – примерно паритет: $2,485 vs $2,897 в API-эквиваленте на тарифе за $200. Но у Claude на Fable можно потратить только половину лимита, вторая остаётся на остальные модели
– А вот на «рабочих лошадках» Opus 5.5 vs GPT 6.1 Sol – Anthropic даёт ~5x больше ценности(!). Даже если считать в токенах, а не в долларах
– OpenAI на прошлой неделе урезали тариф $200 вдвое и запустили $500, в котором Astra всего на 21% больше, чем в старом $200. Старые подписки живут на прежних лимитах до 29 октября.
То есть кратко: подписка на ChatGPT дает вам в 10 раз больше токенов, чем API. Подписка на Claude - в 57 раз больше!
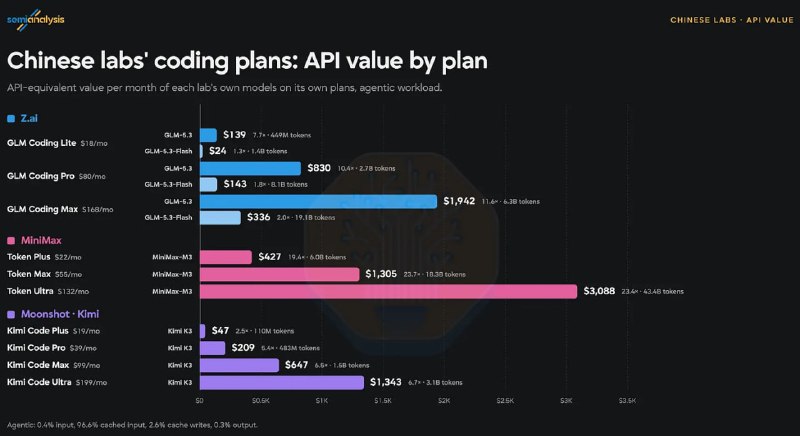
Китайские подписки (MiniMax, Kimi, GLM) – тоже норм по соотношению, чуть хуже OpenAI, но дешевле в абсолюте. Остальное к сожалению за пейволом. Но еще в одной статье получается самые выгодные - Muse от Meta запрещенной (если свои данные отдаете) - 100х от цены и Grok + X Premium (80 от цены).
Но! Если смотреть на закрытые задачи за доллар (как раз вторая статья), то получается, что GPT-6.1 Sol через подписку все еще выгоднее, чем более щедрые лимиты Claude.
Короче, Opus 5.5 на любом Claude-тарифе сейчас выгоднее всего, если нормально и быстро решает ваши задачи. Если начинает разглагольствовать и жрать токены, то Sol 6.1 будет выгоднее. Ну и если хотите ультра-хай потребления, то Grok или Muse.
https://newsletter.semianalysis.com/p/anthropic-subscriptions-offer-5x
https://www.productcompass.pm/p/ai-subscription-api-value
Google вернулся в топ-3 – Gemini 4 Argon. Только потрогать пока нельзя :)
Гугл снова в строю. Думал, что сжалятся и хотя бы дадут попробовать, но нет, пока только у всяких бенчмаркеров и "надежных партнеров". Зато вот добавили в AntiGravity Opus 5.5 и Sonnet 5.5, снова халява и возможность выжать из своей подписки максимум. А еще и облачных GPU дают (спасибо за наводку https://t.me/cgevent, отпишу, как протестирую сам)
Что внутри:
– 1M токенов контекста, на вход текст, картинки, видео и речь
– Выход до 1M токенов (!) – было 64K. Модель может думать сотни тысяч токенов за один заход. Короче, книги писать - туда.
– $2/$10 за 1M input/output на старте, потом $4/$20, кэш – со скидкой 95%. Это дешевле Sol/Sonnet, но жрет она токены сильно. Тратит в среднем 62k токенов на задачу против 27k у Astra, и $1.99 за задачу выходит только за счёт скидки – потом будет $3.98. А GPT-6.1 Sol при той же цене за токен даёт почти тот же интеллект за $0.72.
Бенчмарки от Google:
– DeepSWE v1.1 – 77.9% против 74.1% у GPT-6 Astra и 74.2% у Opus 5.5
– Harvey Legal Agent – 19.6% против 5.4% у Astra и 3.8% у Opus
– GraphWalks на 256K–1M токенов – 84.2% против 71.8% у Astra
Но! FrontierSWE v2 – 55.0% против 65.5% у Astra, а Terminal-Bench 4.0 – 57.4% против 66.4% у Opus
Независимые:
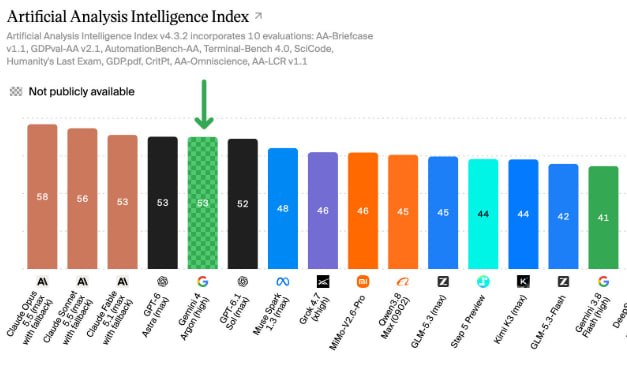
– Artificial Analysis – 53, наравне с GPT-6 Astra. У Opus 5.5 – 58. В среднем довольно неплохая, в топ-5
– Галлюцинации 15% против 51% у Astra – модель чаще честно говорит «не знаю». Это конечно существенный плюс.
– Arena: #1 в Text Arena, но #8 в Code Arena и Agent Arena. Короче, тексты пишет хорошо (скорее всего и всякие переводы, художественность, понимание языка будет хорошее), а для кодинга пока "такое". Ну и норм, не всем же в мире нужны модели только для кодинга.
Внутри гугла я так понимаю мнения разделились. Но в целом "больше моделей - хороших и разных". Будет супер-моделька для финансов, юристов и длинных документов, где низкие галлюцинации решают больше, чем лишние проценты кодинга.
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
Бенчмарки железа для ИИ-шек
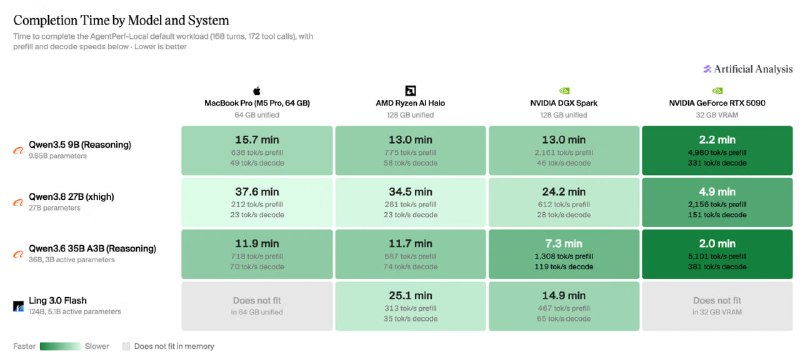
Artificial Analysis сделал AA-AgentPerf-Local – открытый бенчмарк, который прогоняет записанные сессии реальных агентов: 8 задач, 168 ходов модели, контекст разрастается до ~56K токенов. Каждый ход генерирует ровно столько токенов, сколько в записи, так что все железки делают одинаковую работу. Можно запустить у себя против любого OpenAI-совместимого сервера.
Что тестировали:
– Железо: DGX Spark (128 GB), AMD Ryzen AI Halo (128 GB), MacBook Pro M5 Pro (64 GB), RTX 5090 (32 GB)
– Модели: Qwen3.5-9B, Qwen3.8-27B, Qwen3.6-35B-A3B, Ling 3.0 Flash (124B / 5B активных), всё в 4 битах
– Все 14 конфигов одинаково настроенные.
Результаты:
– RTX 5090 рвёт всех, если модель влезает в 32 GB – быстрее остальных в 3.5+ раза. Причина простая: 1,792 GB/s пропускной способности памяти против 256–307 GB/s у систем с unified memory. Но посмотрим, что будет на Mac Studio.
– Скорость больше всего зависит от активных параметров: MoE Qwen3.6-35B-A3B самая быстрая везде, в 2.5–3.3 раза быстрее плотной 27B
– DGX Spark и Ryzen AI Halo стоят одинаково ($4,000 MSRP), память почти одинаковая, но Spark быстрее в 1.4–1.7 раза на трёх моделях из четырёх. Больше вычислений на префилл + зрелый CUDA
– MacBook Pro M5 Pro – единственный ноутбук, и он в пределах 2–9% от Halo на двух моделях, при этом сейчас самый дешёвый из четвёрки ($3,700)
– Спекулятивное декодирование даёт +30–120% к скорости декода 27B сверх теоретического потолка по памяти
Прикол, что даже когда 73–93% промпта берётся из кэша, новые токены съедают 22–41% всего времени. Агент ведь постоянно читает результаты тулов – за сессию ~196K новых входных токенов против ~31K выходных. Когда тул возвращает большой файл, Halo думает до 24 секунд, MacBook – до 39, а 5090 – около 2.
Короче, для локальных агентов смотреть надо не только на скорость генерации, но и на скорость чтения контекста – именно там unified memory сейчас проседает. Если модель влезает в 32 GB – брать 5090 и не мучиться, если нужны большие MoE – Spark. А мак норм как компромисс, если он и так уже на столе :)
https://artificialanalysis.ai/articles/aa-agentperf-local
editedviral
Новинки с OpenAI DevDay
Пока кратенько, надо детальнее изучать
– Dots – постоянно работающие агенты, которые изучают, что вам важно, и сами берут задачи. Типа могут баги разгребать или на почту отвечать. Пока в Pro и Business Premium, для Enterprise – бета, выключенная по умолчанию
– GPT-6.1 Sol – почти уровень Astra, но в 5 раз дешевле по токенам. Сильный апгрейд в агентном кодинге и computer use. Уже доступно.
– Ultrafast – премиальный тариф скорости: до 8x в Codex (300 токенов/сек) и до 6x в API. Пока только для GPT-6 Astra.
– Pro 500 – новый тариф с лимитом в 25 раз больше Plus и доступом к Ultrafast за 500 баксов.
– Agents API с computer use – плюс мультиагентность из Codex, tool search и сжатие контекста. Инфраструктуру держит OpenAI. Параллельно с Amazon сделали Bedrock Managed Agents – те же агенты OpenAI, но целиком внутри AWS
– Decisions API – модель отвечает на заранее заданные вопросы с фиксированными вариантами ответа. Классификация, роутинг, выбор следующего шага агента. Агааа! Говорил я скоро Jev скопируют!
– Codex – облачный запуск с любого устройства, голосовое управление в CLI, ревью кода в десктопе и Codex Security Cloud, который сканирует репозитории и готовит фиксы, пока ноут закрыт. Скоро за вас и задачи ставить будет.
– Плагины – ChatGPT открывает свою внутреннюю платформу: панели в сайдбаре, просмотрщики файлов, автоматизации через MCP Events. Очередной маркетплейс:-/
– Офис – Space для команд, Pages как совместные документы людей и агентов, совместные слайды с экспортом в PowerPoint/Google Slides, @ChatGPT в Slack и Teams, плагин для записи встреч. Это прям супер-жесткий наезд на все типичные рабочие инструменты сразу, от таск-менеджеров до мессенджеров.
– Sign in with ChatGPT – подписка работает как кошелёк у 16 партнёров (Devin, Notion, Vercel и др.), с лимитами на каждого. Полезненько. По сути подписки на других в подарок.
– Marketplace – энтерпрайз может тратить уже законтрактованный бюджет OpenAI на софт 32 партнёров: Adobe, Figma, Salesforce, Harvey, CrowdStrike и т.д. Тоже типичный вариант привязать к себе финансовые потоки.
Прикол, что Notion одновременно партнёр в Sign in with ChatGPT – и прямой конкурент Pages и Space :)
Короче, у ChatGPT 1.2 млрд пользователей в неделю, и OpenAI явно хочет, чтобы там же происходила вся работа – документы, встречи, код, агенты, подписки. Для разработчиков самое практичное – Sol за 1/5 цены Astra и computer use в Agents API, ну и Decisions.
https://openai.com/index/devday-2026-recap/
edited
Опа, Sonnet 5.5 – почти Opus за полцены
Anthropic выкатили вторую модель семейства 5.5. Та же цена, что у Sonnet 5, но быстрее на 30%+ и до 30% дешевле за задачу, потому что жрёт заметно меньше токенов.
Что внутри:
– Цена $2 / $10 за млн токенов (вход/выход), кэш $0.20. Opus 5.5 – ровно вдвое дороже: $4 / $20
– Позиционируют как рабочую лошадку для понятных задач: баги, документы, слайды, таблицы. Opus 5.5 остаётся для сложной работы, где нужно суждение
– Haiku 5.5 обещают в ближайшие недели
Бенчмарки:
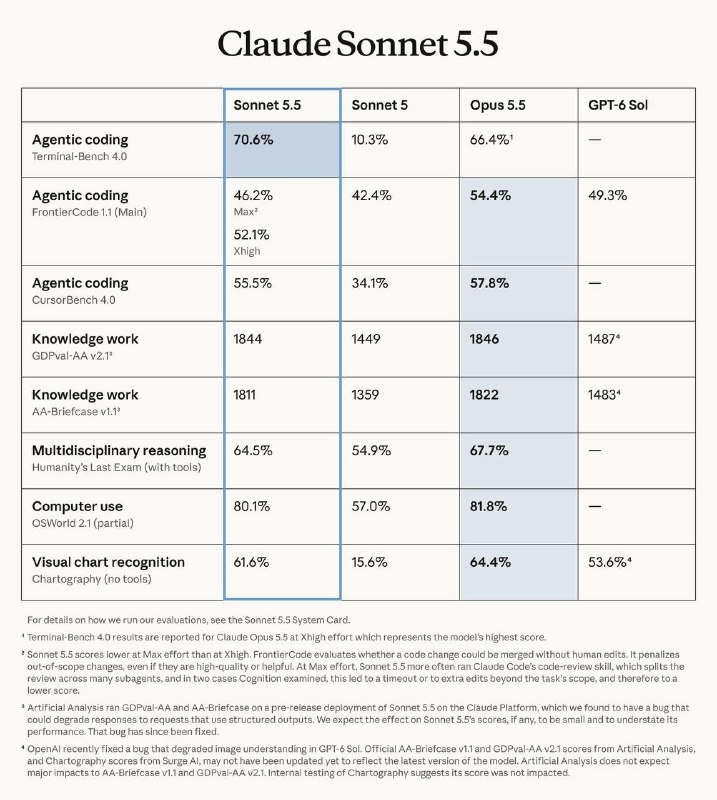
– Terminal-Bench 4.0: 70.6% против 10.3% у Sonnet 5. И да, это выше Opus 5.5 (66.4%)
– GDPval-AA (реальная офисная работа по 44 профессиям): 1844 против 1846 у Opus – разница на уровне погрешности
– CursorBench: 55.5%, отстаёт от Opus на пару пунктов
– OSWorld (computer use): 80.1% против 81.8% у Opus
– Первый Sonnet, который прошёл Pokémon Red, глядя только на скриншоты :)
Прикол, что главная история тут не в качестве, а в экономике. На ряде бенчей Sonnet 5.5 на Low/Medium effort обгоняет лучший результат Sonnet 5 примерно за десятую часть стоимости задачи. У Balyasny на финансовых задачах – 121k токенов на ответ против 497k. У Base44 приложения собираются за 3.6 итерации вместо 7.7 у Opus 5.
Из нового по безопасности – первый Sonnet с кибер-фильтрами уровня Opus: на рискованных security-запросах он будет откатываться на Sonnet 5. Плюс классификаторы против дистилляции – вытаскивать reasoning через фейковые аккаунты станет сложнее.
Для тех, кто на API: если гоняете Sonnet с выключенным thinking, перед миграцией надо переключиться на новую настройку between_tools.
Короче, для большинства продакшн-сценариев Opus теперь нужен реже – архитектуру и сложные решения ему, а реализацию и объёмную рутину можно спокойно отдавать Sonnet 5.5. Кто уже пересчитал свои юнит-экономики? )
https://www.anthropic.com/claude-sonnet-5-5
О, Gemini Live решил пожрать конкурентов с Аватарами
Через неделю после выхода Gemini 3.8 Live Google добавил к нему Live Avatar – говорящую голову, которая генерируется почти в реальном времени и синхронизирована с речью модели. То есть встал на поляну HeyGen, D-ID, Synthesia.
Что внутри:
– липсинк, мимика и нормальный turn-taking, то есть его можно перебивать
– асинхронный tool calling: пока аватар болтает с клиентом, в фоне дёргает API. В демо он так регистрирует гостя в отеле и не зависает на паузе «секундочку, проверяю»
– 97 языков, переключение прямо посреди разговора, и по словам Google липсинк при этом не разваливается и картинка не «плывёт»
– есть библиотека готовых аватаров, а свой можно сделать из одного качественного фото, но пока только через allowlist
– всё помечено водяным знаком SynthID, и в аудио, и в видео
Доступно только в Gemini Enterprise (Agent Platform, бывший Vertex), для обычных пользователей пока ничего. Решили пока не заморачиваться с регулированием и авторскими правами на голоса.
Прикол, что в документации первым use case идут «корпоративные амбассадоры», сгенерированные из внешности сотрудников или нанятых актёров. То есть Google сразу закладывает юридическую рамку: оцифровать своего лучшего менеджера по продажам можно, но только с бумажкой. Дальше в списке идут NPC в играх, навигаторы по больницам, умные очки и авто.
Короче, связка «голос + лицо + инструменты» наконец собрана в одном API, а не склеена из трёх вендоров со своей задержкой на каждом шаге. Для ресепшенов, банковских отделений и киосков в ТЦ это прям норм. Вопрос, как всегда, в цене минуты видео и в том, не станет ли клиентам жутковато через пару минут разговора. Цены пока нет. Скорее всего будет не сильно дешево, но дешевле конкурентов. Ждем релиза на всех.
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-with-live-avatar/
viral
ElevenLabs смотрел-смотрел, как обходят конкуренты, и выкатил Eleven v4
Сразу в топ Artificial Analysis
Новая архитектура – модель читает сценарий «как актёр озвучки»: понимает, кто говорит, что только что произошло и с какой интонацией подать реплику. Языков стало 90+ (у v3 было 70+).
Бенчмарки Artificial Analysis:
– Provider Voice Arena – #1 с Elo 1319, лучше Cartesia Sonic 3.6 (1276) и Gemini 3.8 Flash TTS (1267). Первое место во всех четырёх категориях: саппорт, ассистенты, обучение, развлечения. Если что это все английский, остальные языки самим тестировать надо.
– Controlled Voice (все модели говорят одним и тем же кастомным голосом) – #2 с 1157, уступает только Qwen-Audio-3.1-TTS-Plus от Alibaba. Короче, голоса у elevenlabs лучше, а вот стандартный голос может чуть уступать.
– Pronunciation Robustness – 91.7%, лучший результат, который AA вообще намеряли. Gemini 3.8 Flash TTS – 89.5%, v3 – 85.6%
– скорость – 73.4 символа в секунду против 42.5 у v3.
Что внутри:
– теги вроде [laughs], [whispers], [door slams] прямо в тексте, v4 слушается их лучше, чем v3
– context stitching – длинный текст (хоть аудиокнига) без швов по темпу и подаче
– перегенерация фразы хоть 50 раз – голос не «плывёт»
– вернули Professional Voice Clone, которого не было в v3
v4 Turbo – для реалтайма и агентов: ~150 мс до первого звука (у Sonic 3.6 – 262 мс, у GPT-4o mini TTS – 814 мс, но это замеры самих ElevenLabs) и двунаправленный стриминг – звук идёт ещё до того, как LLM допишет предложение. Но если что конкуренты быстрее. 75-150 мс дают основные топовые модельки.
А теперь про деньги: $80 за 1M символов. Дешевле, чем 3 версия. Sonic 3.6 – $49, Gemini 3.8 Flash TTS – $16.49. То есть Google в 5 раз дешевле и отстаёт всего на 52 пункта Elo. Inworld в 4 раза дешевле, Grok, Soniox - еще дешевле.
Короче, по качеству и произношению – топ, для аудиокниг и брендового голоса норм. Рекламы всякой, озвучки фильмов.
А вот для колл-центра на миллионы минут я бы сначала посчитал юнит-экономику на Gemini, InWorld, Grok, Cartesia – разница в 5-10 раз по цене быстро съедает разницу в качестве.
https://elevenlabs.io/v4
edited
Ну вот, подходящий конкурент Jev - GLiNER-2.5
Как уже писал выше их NER в GLiNER-2 я выбрал из десятка моделей для поиска и вычищения персональных данных. Это скорее 100% конкурент JEV, более под операционную часть. Передаешь текст и набор меток прямо в вызове – получаешь ответ. Без промпта, без генерации токенов, один проход.
Если по кейсам, то можно прикинуть, что это например:
– интент клиента (возврат, отмена подписки, проблема со входом)
– роутинг тикетов и писем по отделам
– сентимент, включая «mixed», и аспекты отзыва (батарея плохая, экран отличный)
– срочность, severity инцидентов, спам, модерация
– «нужно ли звать человека» и даже «закончил ли агент задачу»
– несколько решений за один вызов: интент + приоритет + нужен ли человек + темы
Можно дать метки с описаниями, если название само по себе неоднозначное, и шкалы типа 0–10 для оценок.
Бенчмарки (свой датасет fast-decisions, 17 доменов, exact match):
– GLiNER2.5-Decide 340M – 60.2%
– GLiNER2.5-Decide 1B – 59.6%
– Jev – 57.6%
– мультиязычная версия 287M – 56.7%
- Laya 46.6%
То есть обходит без проблем расхайпленный JEV, при этом работает на CPU, лицензия Apache 2.0, можно поставить на любую табуретку у себя.
Короче, это уже можно в продакшене у себя использовать. Поставить перед LLM: первичная сортировка входящего потока, быстрое принятие решений, извлечение информации, заполнение метаданных, фильтрация. Гонять коммерческую модель еще и с задержкой до провайдера по интернету будет явно дороже и дольше.
https://huggingface.co/fastino/GLiNER2.5-Decide
В блогосфере только и разговоров, что о Jev. Который в 193 раза быстрее и в 444 раза дешевле о_О
Было легкое ощущение всеобщего помутнения, когда полились статьи про «нереальный прорыв» и «уделали Альтмана». Кейсы там такие, что я до сих пор ржу. GPT-6 Astra на high reasoning текстом спрашивают, есть ли в документе персональные данные и почему. Она секунд 6 почти посимвольно собирает ответ «Да, есть фамилия и имя, потому что указано, кто совершал операцию». А Jev достает правильный ответ из волшебного мешочка за 100 мс. Ээээ... Такие задачи решаются JSON-ом с ответом в начале, а не простыней текста, которую потом еще парсить. И уж точно не флагманом с размышлениями – Gemini 3.8 Flash или GPT Luna сделают то же самое на порядок дешевле и быстрее.
Так о чем речь. Это нейросетка, у которой обрезан текстовый вывод. Подаете текст и варианты ответа (до 255), на выходе – вероятности. Вход стоит копье, выход бесплатно, ответ за доли секунды. Посмотрел тесты, сделал свои прогоны на классификаторе документов и категоризации отзывов. Штука прикольная, но очень специализированная.
Что хорошо:
– нормальный реранкинг за копейки (на Хабре в тесте на справочнике ОКТРУ обошел даже флагманы)
– хорошо решает задачи с небольшим количеством классов: спам/не спам, тональность, тема, запрещенка
– почти не дрифтит от перезапусков, сильно стабильнее LLM
– уверенность хорошо отделяет очевидное от серой зоны, так что сложное можно отдать умной модели и срезать расходы раза в 3–4
Что не очень:
– на тонкой классификации типа Banking77 – 81% против 84.4% у Opus 5, и на таких задачах лучшая LLM везде была выше
– на русском местами проседает (на XNLI минус 11 п.п.), и калибровка плывет сильнее
– надо нормально промптить или расписывать каскад узких вопросов, иначе работает хуже дешманских моделей
– если есть 2000+ размеченных примеров, дообученный маленький энкодер обходит Jev со свистом: 88.8% против 77.8%
На моих тестах в сравнении с Луной и Gemini 3.8 flash вышло в 2–3 раза быстрее и в 2–3 раза дешевле, а не в 100. Качество – примерно 85% от эталона. Ну-у... такое.
Плюс это еще один вендор: хостится только в США, у больших облаков его пока нет. Попробуйте объяснить это энтерпрайз-клиентам. И вы серьезно будете отправлять персональные данные на сторону, чтобы проверить, персональные ли это данные? Даже за копейки и миллисекунды? Не проще поставить GLiNER2 на свой сервер и проверять все локально за те же доли секунды?
Короче, это не убийца LLM, а очень быстрый и дешевый zero-shot классификатор уровня средних моделей. Как первый фильтр перед LLM, для роутинга, реранка и guardrails – норм. Но пороги и калибровку надо делать на своих данных, особенно для русского: вероятностям «из коробки» верить нельзя. И я на 100% уверен, что топ-лаборатории скопируют такое через месяц-два. Ребята круто прокачали генерацию данных для обучения, но с большими деньгами и ГПУшками это повторяется быстро.
https://typesafe.ai/blog/introducing-system-one-models-and-jev
Google выкатил Gemini 3.8 TTS.
Видимо все силы кинул в голос )
Моделей две:
– Gemini 3.8 Flash TTS: для творческой работы, чтобы задать характер персонажа и сыграть сцену
– Gemini 3.8 Flash-Lite TTS: для больших объёмов, когда важна цена
Что умеют:
– Голос генерируется по текстовому описанию, больше 100 языков и диалектов
– Больше 2000 готовых голосов с региональными вариантами: мексиканский испанский, квебекский французский, шотландский английский
– Клонирование голоса по 30-секундному сэмплу, с проверкой согласия и водяным знаком SynthID
– Режиссура по строкам: в сценарии пишешь ремарки обычным языком, и модель их отыгрывает
– Держат голос стабильным на часах аудио
– Нативный диалог двух спикеров
– Смех, вздохи, «ага», «угу», перебивания: всё, что раньше выдавало робота
– Скоро обещают ремикс голоса: тембр, высота, темп, акцент
По бенчмаркам:
– Hume AI Voice Design: первое место (71.4), по акцентам тоже первое (60.8)
– Hume AI Overall Quality: первое и второе места у Flash и Flash-Lite
– Voice Arena: топ по японскому, бразильскому португальскому, вьетнамскому, арабскому, мексиканскому испанскому и хинди
Доступно уже сегодня
Видос: https://youtu.be/FL6mI_Br-mc
Есть и ложка дёгтя: клонирование голоса не работает в ЕС, Великобритании, Швейцарии, Индии, Иллинойсе и Техасе.
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-text-to-speech/
Opus 5.5 vs GPT-6 Sol и Luna – в один день!
Сегодня прям дуэль. Anthropic выкатила Claude Opus 5.5, OpenAI – GPT-6 Sol и Luna, облегчённые версии Astra. И обе продают одно и то же: почти флагман, но дешевле.
Opus 5.5:
– $4 / $20 вместо $5 / $25, кэш $0.20 вместо $0.50
– Artificial Analysis Index – 58, первое место. У Astra и Fable 5.1 по 53, для топа отрыв в 5 пунктов – это прям много
– Terminal-Bench 4.0 – 66.4% против 57.9% у Astra и 55.8% у Fable 5.1
– GDPval-AA – 1846 Elo, у Astra – 1542
– обещают починить «клодовский» стиль: главное в начале, меньше воды. Посмотрим :)
GPT-6 Sol и Luna:
– Sol – $2 / $10 (ровно как Sonnet 5). Вдвое дешевле GPT-5.6, контекст 1.05M. Luna – $0.10 / $0.50. Вообще какое-то копье, дешевле многих китайцев теперь.
– AA Index: Sol – 48, Luna – 37. Старый GPT-5.6 Sol – 47
– DeepSWE: Sol – 68.8% за $2.74 на задачу, Luna – 66.6% за $0.22. Разница 2 пункта, а цена в 12 раз ниже
– AutomationBench: Sol – 33.2% за $0.27 на задачу. Для сравнения Opus 5.5 – 40%, Astra – 41.4% за $1.73
У Anthropic есть подвох: токен подешевел на 20%, а думать модель стала больше. На индексе AA – 119K токенов на задачу против 73K у Opus 5 и 31K у Sol. CodeRabbit на код-ревью намерил +40–60% токенов. И thinking теперь вообще не выключается.
Честно сравнить сложно – каждый показывает свои бенчмарки, OSWorld у них вообще разный. На общем стенде AA Opus 5.5 на medium против Sol на max: кодинг 52.5% vs 43.9%, документы +159 Elo у Opus, бизнес-процессы вничью. Задача – $1.34 против $1.06.
Короче, Opus 5.5 сейчас самая умная модель, и в 2.5 раза дешевле Fable – кодинг и документы теперь туда. Luna – вот это прям новость для всех, кто гоняет классификацию и извлечение на потоке: в 10 раз дешевле Haiku. А Sol – такой середнячок по цене Sonnet, гонять для массовых задач. Ну и Sonnet 5.5, говорят, через пару недель.
https://www.anthropic.com/claude-opus-5-5
https://openai.com/index/introducing-gpt-6-sol-and-luna/
Grok 4.7: фронтир по цене Grok 4.6
SpaceXAI наконец выкатили Grok 4.7 – после трёх переносов. Цена не изменилась:
– $2 / $6 за млн токенов – как у 4.6. Для сравнения: GPT-5.6 Sol – $4 / $20, Fable 5.1 – $10 / $50
– есть fast-вариант: вдвое быстрее, вдвое дороже
– доступна сразу в Cursor, Grok Build, API и у роутеров
Бенчмарки (xHigh):
– CursorBench 4.0 – 46.3% против 40.4% у 4.6 и 41.7% у Sol. Fable 5.1 впереди с 51.8%, но output у него в 8 раз дороже
– Terminal-Bench 4.0 – 38% против 20.3% у 4.6, почти вдвое. До Fable (57.9%) при этом как до Марса
– EEBench (электротехника) – 64%, лучше всех.
– Harvey Legal Agent – 19.6%, тоже первое место. Правда, у Sol там 2.5%, так что юристам пока рано волноваться
– GDPval – 1695 Elo, чуть ниже Fable (1735)
– HealthBench – 56.7%, тут позади и Sol, и Fable
Ещё заявлен полностью новый стек безопасности: пропускает только 3.3% рискованных кибер-запросов и при этом редко отказывает в легитимных. Вот это неожиданно. Для всех фичей безопасности и хитрых проверок я как раз использовал грок. Теперь видимо будут блокировать :(
Короче, супер-дешевая и крутая модель для кодинга. Вполне возможно будет в топ-3 на всех бенчах, но дешевле в 5 раз.
https://x.ai/news/grok-4-7
Mac Studio на M5 Ultra – машина мечты для локальной разработки
О, наконец-то результаты тестов нового Mac Studio. Федерико Витиччи из MacStories четыре дня гонял топовый Mac Studio M5 Ultra (256 ГБ) против прошлого M3 Ultra (512 ГБ) и игрового ПК с RTX 5090.
По железу:
– GPU на 80 ядер, в каждом нейроускоритель – до 4,5× пикового AI-компьюта к M3 Ultra
– пропускная способность памяти 1,2 ТБ/с против 819 ГБ/с
– версия на 512 ГБ обещана в конце октября
На практике (Qwen3.8-Flash-Next, 4 бита, oMLX):
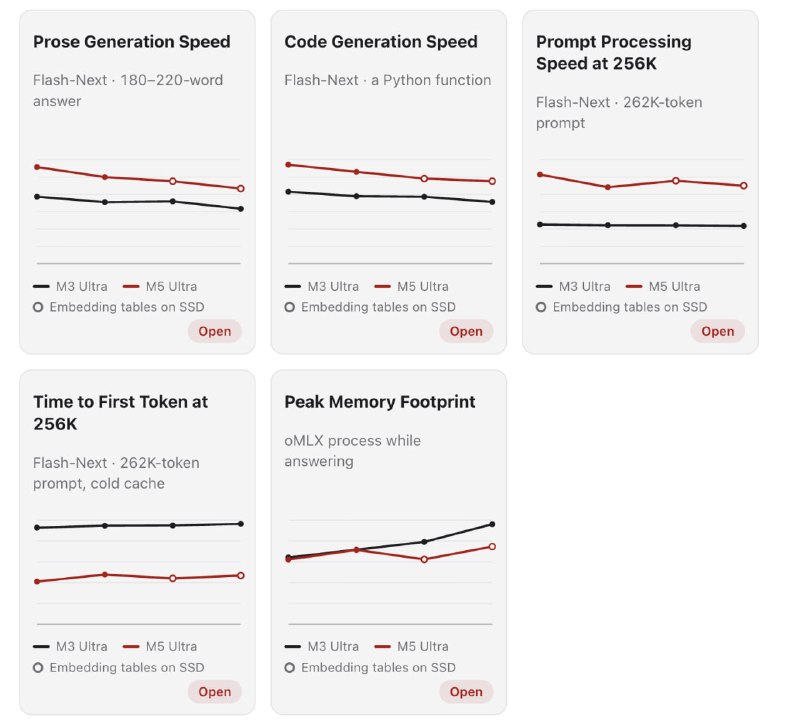
– чтение промпта – ~2 700–2 900 ток/с против ~1 100, то есть в 2,5 раза быстрее
– генерация – 108 ток/с против 70, код – 143 против 98
– промпт на 16K: первый токен через 5,6 с вместо 13,9 с
– 256K контекста: ждать ~100 с вместо ~245 с, и дальше модель пишет 75 ток/с – быстрее, чем M3 Ultra на 4K
– три параллельные сессии с субагентами: суммарно 81 ток/с против 40
RTX 5090 все еще быстрее: 3 031 против 1 701 ток/с на чтении, около +25% на генерации. Но у нее 32 ГБ VRAM – как только модель не влезает и начинается выгрузка в системную память через PCIe, скорость падает до 1,5–4,6 ток/с. Плюс шум и жара на всю комнату, а Mac на столе не слышно.
При этом за стоимость такого железа (больше десятки Кбаксов) можно несколько лет оплачивать самую дорогую подписку Anthropic и получать модель умнее. Смысл появляется там, где агенты молотят 24/7, или где данные нельзя выносить наружу – банки, госы, документы. И тут уже появляется резон покупать коробочку. Короче, для оптимизированных под Mac вещей подойдет, но если нужна прям макс-производительность и многопользовательскость, то Nvidia все еще топ.
https://www.macstories.net/stories/m5-ultra-mac-studio-review-the-dream-mac-for-local-ai-agents/
edited
О, ура! ChatGPT доехал в Word. В компанию к Excel и PowerPoint
Видимо как раз как основа для юристов и офисных работников. Один инсталл на Word, Excel и PowerPoint. Ставится из Microsoft Marketplace, логинишься своим аккаунтом ChatGPT, дальше панель сбоку и правки прямо в документе.
Очень нравилась эта фича у Claude. По сути имеет доступ ко всем возможностям офисных программ, а не только то что в OpenOffice доступно.
Что внутри:
– черновики, переписывание кусков, форматирование – не выходя из Word
– контекст подтягивается из подключённых приложений: Outlook, SharePoint, Google Workspace, Dropbox
– skills – сохранённые инструкции под повторяющиеся задачи: инвестмемо, ревью договора, executive summary
– доступно глобально и на всех планах, включая Free!
– для Business/Enterprise/Edu данные по умолчанию не идут в обучение
Но при этом это бета. Чаты в аддине отдельные, память из ChatGPT не переезжает. Нельзя начать в одном месте и продолжить в другом. И пишут, что сложное форматирование, таблицы и графики придётся доводить руками. Но при этом работает явно лучше, чем редактирование docx напрямую!
https://chatgpt.com/apps/word/
А скачивать тут: https://marketplace.microsoft.com/en-us/product/office/WA200010215