
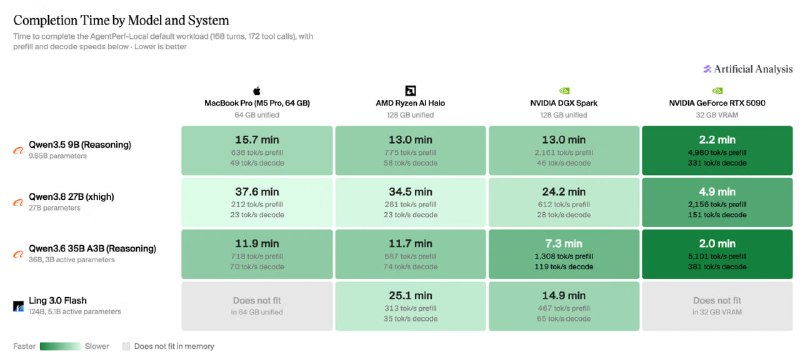
Бенчмарки железа для ИИ-шек Artificial Analysis сделал AA-AgentPerf-Local – открытый бенчмарк, который прогоняет записанные сессии реальных агентов: 8 задач, 168 ходов модели, контекст разрастается до ~56K токенов. Каждый ход генерирует ровно столько токенов, сколько в записи, так что все железки делают одинаковую работу. Можно запустить у себя против любого OpenAI-совместимого сервера. Что тестировали: – Железо: DGX Spark (128 GB), AMD Ryzen AI Halo (128 GB), MacBook Pro M5 Pro (64 GB), RTX 5090 (32 GB) – Модели: Qwen3.5-9B, Qwen3.8-27B, Qwen3.6-35B-A3B, Ling 3.0 Flash (124B / 5B активных), всё в 4 битах – Все 14 конфигов одинаково настроенные. Результаты: – RTX 5090 рвёт всех, если модель влезает в 32 GB – быстрее остальных в 3.5+ раза. Причина простая: 1,792 GB/s пропускной способности памяти против 256–307 GB/s у систем с unified memory. Но посмотрим, что будет на Mac Studio. – Скорость больше всего зависит от активных параметров: MoE Qwen3.6-35B-A3B самая быстрая везде, в 2.5–3.3 раза быстрее плотной 27B – DGX Spark и Ryzen AI Halo стоят одинаково ($4,000 MSRP), память почти одинаковая, но Spark быстрее в 1.4–1.7 раза на трёх моделях из четырёх. Больше вычислений на префилл + зрелый CUDA – MacBook Pro M5 Pro – единственный ноутбук, и он в пределах 2–9% от Halo на двух моделях, при этом сейчас самый дешёвый из четвёрки ($3,700) – Спекулятивное декодирование даёт +30–120% к скорости декода 27B сверх теоретического потолка по памяти Прикол, что даже когда 73–93% промпта берётся из кэша, новые токены съедают 22–41% всего времени. Агент ведь постоянно читает результаты тулов – за сессию ~196K новых входных токенов против ~31K выходных. Когда тул возвращает большой файл, Halo думает до 24 секунд, MacBook – до 39, а 5090 – около 2. Короче, для локальных агентов смотреть надо не только на скорость генерации, но и на скорость чтения контекста – именно там unified memory сейчас проседает. Если модель влезает в 32 GB – брать 5090 и не мучиться, если нужны большие MoE – Spark. А мак норм как компромисс, если он и так уже на столе :) https://artificialanalysis.ai/articles/aa-agentperf-local