Не доверяем LLM-ке как классификатору Хорошая статья про типичный сценарий LLM, который работает так себе. Делаем что-то типичное: нужно сортировать обращения, письма, отзывы. Пишем промпт «это жалоба или нет?», модель отвечает «да/нет», запускаем в работу. Вроде получается неплохо – и на этом все останавливаются. Ну максимум есть "золотой сет" из 10-50 отзывов. Но потом что-то начинает сбоить и непонятно, куда бежать. В чем проблема: – модель не умеет честно сказать, насколько она уверена. Попросите ее оценить уверенность в процентах – получите красивую цифру, не связанную с реальностью. А значит, нельзя настроить строгость: «лучше пропустим пару жалоб, но не будем дергать людей зря» или наоборот – модель не знает вашей реальности. У вас жалоб 1% от потока или половина? Для правильного решения это важно, а она судит «в среднем по интернету» – если качество не устраивает, остается один инструмент – переписывать промпт и надеяться Идея автора: не давать модели выносить приговор. Пусть она будет свидетелем, который отвечает на простые вопросы, а решение принимает маленькая старая добрая статистическая модель, обученная на ваших примерах. Автор проверил на задаче «найди иронию в твитах». Вместо одного вопроса «это ирония?» задал модели 19 простых: автор хвалит что-то явно плохое? тон не совпадает с ситуацией? это риторический вопрос? наигранный восторг? про политику или про быт? Плюс добавил совсем тупые признаки: длина текста, число восклицательных знаков, капс, эмодзи. Дальше простая формула на нескольких тысячах размеченных примеров учится, каким ответам сколько веса давать. Что вышло: – точность выросла с 0.747 до 0.779 (победитель научного соревнования 2018 года – 0.705, лучшая специально спроектированная нейросеть – 0.786) – оценки уверенности из бесполезных стали рабочими: ошибка в вероятностях упала вдвое. У голой LLM она была на уровне подбрасывания монетки – видно, какие признаки реально влияют на решение – его можно объяснить бизнесу и аудитору – и все это на самой дешевой модели (gemini flash-lite), без дообучения Цена вопроса – нужны размеченные примеры. Но автор справедливо замечает: они вам и так нужны, чтобы проверить, что система вообще работает. Вы же собирались проверять, правда? Короче, все время скоро будет уходить чисто на данные и датасеты, остальное ИИ-ка будет сама делать. И так как это мало кто делает нормально - спецы еще будут нужны 100% https://minimallysufficient.com/posts/llm-classification-is-feature-extraction/

AI Product | Igor Akimov
-
-
Devin тоже добавили себе "цели", чинит все за вас Cognition выкатили Code Scans. Можно писать просто «ускорь сборку», «улучши SEO» или «найди мёртвый код» – Devin сам прочёсывает весь репозиторий, приносит приоритизированный список находок с доказательствами, а потом открывает PR'ы на те, что ты одобрил. Под капотом – Agentic MapReduce, та же архитектура, что у их Security Swarm: – Plan: агент изучает репо и формулирует правила, какой код релевантен цели – Shard: код по этим правилам режется на куски – Map: параллельные агенты разбирают каждый кусок – Reduce: финальный агент склеивает, убирает дубли, расставляет приоритеты Фишка в том, что каждый батч обязан быть обработан – то есть это не «агент че-то там сделал и отчитался, что все ок», а гарантированный проход по всему отобранному коду. Цифры из анонса: – Dioxus (Rust): чистая debug-сборка с 58,6 до 21,0 секунды, минус 64% на 22 крейтах. Причем все валидные вещи, которые разработчики одобрили. – Свои сайты devin.ai и cognition.com: 44 SEO-находки, health score в Ahrefs 87 → 92, медленных страниц минус 73% – Philips на тесте: примерно 96% PR'ов вмержено и 700+ сэкономленных инженерных часов Запускается через /scan в вебе Devin. Короче, скоро можно будет просто сказать "сделай хорошо" :) https://devin.ai/blog/introducing-code-scans
-
OpenAI пошла отбирать хлеб у юристов Выкатили Astra for Law. Звучит как новая модель, но нет – это та же GPT-6 Astra, которой прикрутили юридический поиск и объяснили, как думать по-адвокатски. И внезапно оказалось, что так можно было. Что дали: – Свой индекс по праву США: 230+ млн страниц, 99.9% всех прецедентов – На бенчмарке 54% правильных ответов против 38.7% у той же модели с обычным поиском. Прецедентов находит на четверть больше – Данные не хранят, люди из OpenAI ваши чаты не читают – для юристов это вообще первый вопрос – 26 плагинов к тому, чем юрфирмы и так пользуются: iManage, Clio, Relativity, Thomson Reuters. Плюс ChatGPT прямо в Word – Пока только избранным фирмам, в API – «скоро» Прикол, что OpenAI сажает своих инженеров прямо в топовые юрфирмы и пилит им инструменты под ключ. Sullivan & Cromwell получили анализатор договоров, который сам предлагает правки. Ropes & Gray – разбор data room для сделок. Cooley – подготовку к IPO. Конечно это лучше Фейбл, в примерах OpenAI показала, как Claude сослался на решение, которое потом отменили в апелляции. Пример подобран вендором, конечно, но в больное место попали. И прикол, как теперь будут жить всякие Harvey. Строишь стартап на OpenAI, а OpenAI уже сидит у твоих клиентов в переговорке. Короче, для США задачу решили, для других стран ещё есть возможности. Пока OpenAI не придет и туда ) https://openai.com/index/astra-for-law/
-

Google научил агентов учиться во сне Тоже интересный материал. Google, DeepMind и пара университетов выложили Dream-RSI – подход к рекурсивному самоулучшению агентов. Тут про сон мало что, но звучит красиво :) Когда агент (AlphaEvolve и подобные) ищет решение, он делает тысячи попыток: ветвится, запускает варианты параллельно, бросает тупиковые линии. Стратегия исследования – где копать, когда остановиться – обычно пишется руками и дальше не меняется. Улучшать её онлайн дорого: чтобы понять, хороша ли стратегия, нужно прогнать весь поиск до конца. Идея авторов: дерево прошлых попыток – это уже готовый симулятор. Каждый узел хранит реальный результат выполнения, поэтому альтернативную стратегию можно «прогнать» по этому дереву в другом порядке – без единого нового запуска. Это и есть "сон". Мы просто проверяем по прошлым попыткам, не запускаем заново. Как работает цикл: – агент ищет онлайн и записывает дерево попыток – другой агент переписывает код стратегии исследования и проверяет тысячи вариантов по накопленной истории – бесплатно – в прод уходит только победитель, и он добавляет новое дерево в пул – текущая стратегия тоже участвует в отборе, так что хуже она стать не может Короче, по цифрам в 2-3 раза меньше вызовов для решения задач. Причем не надо закладывать успешные попытки в промпт, надо просто прогонять по прошлым вариантам. Короче логируйте не саммари и находки, а все попытки с результатами, это бесплатный полигон для следующих версий. https://dream-rsi.com/
-
Хах, лучшая модель для хакинга – DeepSeek V4.1 Flash Enclave гоняет модели на своём бенчмарке AI-хакинга: изолированные копии Grafana, Jenkins и Nextcloud с уязвимостями, задача – получить выполнение кода на сервере. И тут внезапно лучшим оказался не топовый Opus или GPT, а дешёвая «флешка» от DeepSeek. – 11 из 11 уязвимых целей взломаны, все 4 пропатченные версии устояли – 2 349 bash-команд, около 2,5 часов активной работы модели – медианная успешная атака – 4 минуты 38 секунд, Grafana падала за 52–90 секунд – 268 млн входных токенов, из них 266 млн из кэша – отсюда и цена – $4.65 за засчитанные прогоны, $5.14 с учётом неудачных Прикол, что выяснилось, что по задуманному авторами пути взлома модель прошла только в 6 случаях. В остальных 5 она нашла более короткие обходные маршруты, которых создатели бенчмарка не заметили. Например, в Jenkins: нашла дыру в границе проверки прав, вытащила приватный credential, залогинилась и выполнила код. Короче, ребята, не забывайте обновлять все ваши библиотеки и сайты в ТОТ ЖЕ ДЕНЬ как вышли исправления. Всякое старье скорее всего уже хакнуто и майнит или ботнет запускает... https://enclave.ai/blog/deepseek-v41-flash-is-now-our-best-hacking-model
-
Автономный ИИ для бизнеса И еще из интересного. Те самые ребята, что ставили вендинговый автомат под управлением Claude в офисе Anthropic (Project Vend), теперь отдают свою платформу всем желающим. Pion – это то, на чём у них крутятся все реальные бизнесы: автомат, магазин Andon Market в Сан-Франциско, кафе Andon Cafe в Стокгольме и даже пара AI-радиостанций. Что интересного в истории: – Vending-Bench изначально делали как оценку опасных способностей. Вопрос стоял так: может ли ИИ сам добывать ресурсы, чтобы потом делать с ними что захочет. Вендинг взяли просто как самый тупой бизнес из возможных. – В 2024 все модели застревали в циклах, а Sonnet 3.5 писал в ФБР про «киберфинансовое преступление» и объявлял бизнес квантово несуществующим. – Opus 4 в мае 2025 первым обошёл человека. Дальше график растёт линейно – примерно +$822 к результату каждый месяц, без плато. – В мультиагентной версии (модели конкурируют) с Opus 4.6 пошли сговор, обман и power-seeking. Anthropic после этого поменяла рецепт обучения для 4.8. Часть поведения в свежих моделях всё ещё есть. – Реальный автомат сначала терял деньги (раздавал товар бесплатно, галлюцинировал, что у него есть тело), к концу 2025 вышел в плюс. Магазин и кафе пока убыточные – аренда и зарплаты живым людям, которых агент нанял. Зачем открывают: им не хватает своих бизнесов и экспертизы, чтобы понять, где модели реально могут зарабатывать. Особенно интересны действующие компании с выручкой – там сигнал быстрее. Агенту дают почту, телефон, банк, браузер и защищённую среду. Пока research preview по вейтлисту. Ну и чего, отдадите свой бизнес на полгода ИИ для науки? :) https://andonlabs.com/blog/why-we-built-pion
-
edited 
Свежие бенчмарки моделей на кодинге (для очередных дискуссий, Claude vs Codex) Specific Labs выпустили бенчмарк, где модели чинят не задачки с GitHub, а настоящий код реальных компаний – лицензировали приватные репозитории (клон Partiful на 200K+ юзеров, финтех со 100K+ банковскими выписками, enterprise sales-платформы) и взяли оттуда живые задачи: налоги в инвойсах, миграции биллинга, метеринг токенов. Код в интернете не лежит, модели на нём не учились. Результат отрезвляет. – Лидер – Fable 5.1 в Claude Code, 38.8% решённых задач – GPT-6 Astra в Codex – 33.8%, Grok -32.5% (вау), Gemini 3.8 Flash – 31.2% – GLM 5.3 – 28.8%, Muse Spark 1.3 – по 23.8%, Kimi K3 – 18.8% – GPT-5.6 Sol – 16.2% – 6 из 10 задач решаются реже чем в 15% случаев, одну (analytics stream reducer) не решил никто ни разу – Медианное решение трогает 11 файлов – против 6 в FrontierCode и DeepSWE – Цена одного прогона: Gemini Flash $2.50, GPT-6 Astra $4.67, Fable 5.1 $6.96 Интересно, как модели проваливаются. Главная причина – пропущенные требования из ТЗ (у Grok – 67% всех фейлов). Вторая – «не проверил, придумал» – так падает 43% неудачных прогонов GPT-5.6. Третья – правильная идея, криво встроенная в систему (Gemini – 49%). Причём короткие прогоны до 10 минут фейлятся с той же частотой, что и длинные – проблема не во времени, а в том, что агент не понял, как устроена компания и её код. Короче, разработчика могут заменить пока только в трети случаях. Но тут надо сказать, что описание компании и кодовых принципов в claude.md/agents.md никто не писал, это такой чисто "вайбкодинг-стайл" тест. Должно быть сильно лучше при правильном подходе. https://withspecific.com/benchmarks/real-swe
-
А вот еще штука от OpenAI для инвестбанкиров (удивительно, как OpenAI сжирает все больше вокруг себя) Целевая аудитория – люди в инвестбанках, которые целыми днями готовят отчёты по компаниям: сколько стоит, сколько зарабатывает, стоит ли покупать, кому можно продать. Что изменилось по сравнению с обычным ChatGPT: – внутри уже есть платные базы данных, за которые аналитики обычно платят отдельно: финансовая отчётность компаний, расшифровки звонков с инвесторами, новости, данные о стартапах и частных компаниях. Не нужно копировать таблицы руками – модель сама достаёт цифры – если у банка уже куплены подписки на другие источники данных, они подключаются одним логином – каждая цифра в ответе со ссылкой на источник – можно проверить, откуда она взялась, а не гадать, придумала ли модель – админ загружает фирменные шаблоны Excel, Word и PowerPoint – и ChatGPT собирает презентации и финансовые модели сразу в корпоративном оформлении – всё, что требует служба безопасности банка: разделение доступов между отделами, чтобы аналитик не увидел инсайд из соседней сделки, единый вход, логи для проверяющих, данные не идут в обучение Партнёры на старте – Morgan Stanley и Evercore. Цен нет, «свяжитесь с отделом продаж». Короче, модель + профильные данные + шаблоны документов + корпоративная безопасность = продукт под индустрию. Следующие очевидные кандидаты – юристы, медицина, страхование. И это удар по стартапам, которые последние два года делали «ChatGPT для аналитиков» поверх API OpenAI – платформа пришла и сделала то же самое сама... https://openai.com/index/introducing-chatgpt-financial-services/
-
Опа, OpenAI выпустила Agents API – ИИ-агент из коробки Одним вызовом описываете задачу, модель, инструменты и окружение – и получаете готового агента, который работает на той же оркестрации, что Codex и агенты внутри ChatGPT. То, что раньше надо было руками собирать на всяких библиотечках. И по сути конкурент anthropic managed agents. Что внутри: – автоматическая компрессия контекста, когда сессия подходит к лимиту – tool search – определения инструментов подгружаются по мере надобности, а не висят в промпте и жгут токены – programmatic tool calling – параллельные вызовы и цепочки – субагенты из коробки (по умолчанию до 3 параллельно) – MCP, свои функции, встроенный веб-поиск – два варианта исполнения: песочницы OpenAI или свой compute, с интеграциями Cloudflare, Vercel, Modal, E2B, DigitalOcean, Oracle и др. Цены: отдельной платы за сервис нет, платите только за токены и инструменты. Харнесс открытый – это тот самый Codex, код лежит на GitHub. Цифры от ранних клиентов: SafetyKit – минус 60% стоимости на кейс, Hypha – минус 86% неудачных ответов агента, Ciridae – качество на евале с 0.71 до 0.85 и латентность в 4 раза ниже. Короче, теперь бьют по прослойке фреймворков. Стартапы и компании собирали на LangGraph и Agents SDK то, что здесь дают одним вызовом – память, компрессию контекста, subagents. Теперь вопрос к вам будет «а зачем нам это все». Но с другой стороне все держите у OpenAI, переезжать больнее. Короче, для простых клиентов и собственных проектов - норм, гораздо проще, чем раньше. Для продакшена и энтерпрайза - ну такое. https://openai.com/index/introducing-the-agents-api/
-
О, и GPT-Live-1 теперь в API! Голосовую модель из ChatGPT открыли разработчикам. Главное – full-duplex: модель слушает и говорит одновременно, без каскада STT – LLM – TTS и ручной обработки перебиваний. – Думать отдаёт бэкенду: GPT-6 Astra, Luna или сторонней модели – Full Duplex Bench – плюс 30 пунктов к прошлой GPT-Realtime-2.1 – Speak: перебиваний на паузах меньше почти на 80% – Телефония из коробки, 12 новых голосов $0,05 за минуту голосового слоя – $3 в час плюс токены бэкенда. Ну с этим уже можно жить! https://openai.com/index/introducing-gpt-live-1-in-the-api/
-
OpenAI побили еще сотню стартапов "AI аналитики" Выпустила Data agent в ChatGPT Work – плагин, который подключается к корпоративным данным, сам пишет SQL, ищет, что изменилось, и собирает интерактивные дашборды, которыми можно поделиться. Вопрос задаёшь словами, код не нужен. Что внутри: – источники: Snowflake, BigQuery, Databricks, Redshift, ClickHouse, MongoDB, Datadog, плюс Google Drive и SharePoint – BI: Tableau, Power BI, Sigma, ThoughtSpot, Omni, Oracle BI – семантический слой: агент берёт термины, метрики и формулы из dbt, Databricks Genie, Snowflake Horizon, GitHub и самих дашбордов – чтобы «выручка» считалась так, как у вас принято, а не как модели показалось – права: запросы идут под учёткой пользователя со всеми ограничениями по таблицам, строкам и колонкам – после анализа – рекомендации, кому из коллег это показать, и выгрузка в Slack или почту Внутри OpenAI это уже стандарт: почти вся продуктовая команда и две трети GTM сидят в этом агенте. Года 2 назад, еще до размышляющих моделей, как раз строили подобную штуку... Теперь это из коробки доступно. Text-to-SQL без него все пробовали, и все получали красивые уверенные цифры, которым нельзя верить. Много приходилось писать прям функций руками, которые может вызывать ИИ, чтобы результат был одинаковый. Теперь думаю с такой клиентской базой и такими провайдерами это вопрос решенный https://openai.com/index/put-data-to-work/
-
Посмотрел, что там Apple представила нового в девайсах по ИИ (спойлер - переупакованный Gemini) Короче, что нового: – Siri AI выходит в бете 14 сентября с iOS 27. ТОЛЬКО НА АНГЛИЙСКОМ. Остальное подтянется в октябре и дальше. Отдельное приложение с историей диалогов в iCloud, понимание личного контекста (почта, сообщения, фото), осведомлённость об экране и действия внутри сторонних приложений через App Intents (если разработчики поддержали). – Под капотом – пять моделей третьего поколения, сделанных «в сотрудничестве с Google»: AFM 3 Core на 3B на устройстве, AFM 3 Core Advanced на 20B со sparse-архитектурой (активны 1–4B за раз), облачные AFM 3 Cloud и ADM 3 Cloud для картинок, и AFM 3 Cloud Pro – который крутится на NVIDIA в Google Cloud. Apple арендует чужие GPU под чужой моделью, немыслимо... – Айфончеги на A20 Pro: 2 нм, два 16-ядерных Neural Engine (32 ядра суммарно), вдвое больше вычислений под on-device ИИ, +50% пропускной способности памяти. iPhone 18 Pro – $1199, Pro Max – $1299, в продаже 18 сентября. – Складной iPhone Duo за $1999: 5,4" снаружи, 7,6" внутри, тот же A20 Pro. Предзаказ 16 октября. Красивый блокнотик, Samsung там уже в Твиттер изошелся, что через 8 лет Apple догнал ) – AirPods 5 за $129 – чип H3, Live Translation на десятке языков (русского нет, типичные европейские и азиатские) и разговор с Siri на ходу. – Watch Series 12 ($399) и Ultra 4 ($799): Health Age, Readiness score 0–10, всякая прочая геймификация жизни, пульс каждые 5 секунд, Audio Intelligence с Live Rewind – отматывает последние 15 секунд звука, если вы прослушали (это прикольно, но странно) – Из интересного еще Apple Reference Image – подтверждение, что фото снято на iPhone, а не сгенерировано. Короче, Apple арендует и покупает ИИ у остальных, как-то грустновато... Ну и делает гибрид под мини-модель, норм-модель и облако. Ну и если у вас приложение, то поддержка App Intents – маст-хев. Иначе сири про вас ничегошеньки знать не будет. apple.com/newsroom
-
edited 
DeepSeek выложил V4.1 Flash. И кажется у нас новый лидер и по качеству и по цене. Обычно работает так: чем мощнее модель, тем дороже каждый ответ. DeepSeek эффективно mixture of expert научился делать, 8-16B параметров из 552B подключать. И при этом она обходит прошлых лидеров: • Работа в терминале: 90.6 против 89.1 у Claude Opus 5 и 88.8 у GPT-5.6 • Починка багов в настоящих проектах: 74.2 – первое место • Автоматизация рутинных задач: 54.8 против 50.3 у Opus • Спортивное программирование: рейтинг 3471, уровень сильного гроссмейстера от кодинга Что ещё умеет: – 1 миллион токенов – Есть ползунок «насколько сильно подумать» – от 1 до 100. – Видит картинки, не только текст. – Вложились очень сильно в оптимизации и кэш, научились отдельно читать промпт и писать ответ, оптимизировали обе части, кэш супер-компактным сделали, так что цены стали еще более космические: $0.30 на входе / $1.20 на выходе "После обеда", в непиковое время - еще в 2 раза дешевле. Для справки: • Claude Opus 5 – $5 / $25 • GPT-5.6 Sol – $4 / $20 Повторный контекст из кэша вообще доли цента, а это может быть 80-90% большой обработки. - Ну и как обычно веса открыты, так что ждем скоро в России huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
-
repost Бахнули ChatGPT Images 2.5 Главное обновление не в том, что картинки стали «сделай ещё красивее», а в том, что модель наконец-то сильнее держится за исходник при редактировании. Что изменилось: - генерация до 50% быстрее, чем в Images 2.0; - лучше сохраняются лицо, персонаж, композиция и другие детали референса; - можно менять один элемент изображения, не разваливая всё остальное (верим?); - заметно улучшили последовательное редактирование: после нескольких правок предыдущие изменения должны сохраняться стабильнее(верим?); - более естественный свет и текстуры; - лучше генерит сложные инструкции, стили и прозрачные фоны. Появился типа Sketch - можно буквально нарисовать криворукие каракули прямо в ChatGPT, добавить описание, и модель использует рисунок как инструкцию. Вызывается как @Sketch. Ещё добавили шаблоны типа Poster и Merch, комментарии прямо на картинке для точечных правок и возможность делиться изображением вместе с промптом (второе видео) И самое интересное для API: теперь там две модели. GPT-Image-2.5 Flare - основная быстрая версия. Обещают качество выше GPT-Image-2 при вдвое меньшей задержке. GPT-Image-2.5 Sunburst - более медленная модель для максимально точной генерации и сложного редактирования. Images 2.5 уже раскатывается всем тарифам ChatGPT, а также доступна в ChatGPT Work, Codex и API. За цены пока непонятно. За желтизну, шум, сетку и комочки - тоже Как в ChatGPT управлять выбором Flare/Sunburst, судя по текущему официальному анонсу тоже непонятно. https://openai.com/index/introducing-chatgpt-images-2-5/ @cgevent
-
ChatGPT Work научился писать вашим почерком Я у себя пока не нашел, но возможно раскатывают волнами. В Твиттере опубликовали. OpenAI добавила в ChatGPT Work функцию Writing style – модель изучает, как вы реально пишете, и дальше пишет так же. – Учится на ваших письмах, сообщениях и файлах – подключаются Gmail, Google Drive, Slack и SharePoint – Подхватывает любимые фразы, манеру заканчивать письма и даже привычки со строчными/заглавными – Включается один раз в Settings → Personalization → Writing style, дальше применяется ко всему, что пишете в ChatGPT Work – и в вебе, и в мобилке – Доступно на всех платных тарифах, где есть ChatGPT Work. Настройка – только через веб – На Business и Enterprise ваши письма по умолчанию не идут в обучение моделей, но сам факт, что ассистент читает всю переписку ради «стиля», многих смутит Идея понятная: до этого стиль приходилось описывать вручную в custom instructions – «пиши коротко, без воды, подпись такая». Теперь он извлекается из корпуса вашей переписки автоматически, а человеку остаётся меньше правок перед отправкой. По сути это стилевой RAG поверх ваших же документов – ничего революционного, но в бизнесе выигрывает не тот, кто придумал, а тот, кто первый встроил в почту. https://x.com/ChatGPT/status/2097018264048251309
-
А Антропик предлагает студентам стипендию в $3500, если будете организовывать мероприятия про Клод и ходить всех учить им пользоваться: https://claude.com/programs/campus Покажите студентам вашим знакомым
-
Не знаю, как там у кого, но Астра реально клевая. Очень умная и не многословная. Можно делать как большие код-ревью, так и точечные правки во множестве файлов. Конечно как и для Фейбл лучше просить сделать ревью и составить план, а потом уже Сол/Опус завершить, чем все токены потратить на забивание микроскопом гвоздей. Вот еще что пишут в гайде по промптингу: – async tool calling – модель не ждёт, пока ваш инструмент отработает, а продолжает думать и дёргать другие тулы. Ставите async: true, результат отдаёте по call_id. – mid-turn steering – по WebSocket можно докинуть уточнение прямо во время работы, сделанное не сбрасывается. – reasoning effort меняется посреди диалога через configuration_update без слома кэша промпта. Ну и интерфейсе соответственно тоже можно менять без боли. – misalignment monitoring – OpenAI асинхронно мониторит запросы на признаки misalignment и шлёт алерты. Читай: за вашим агентом теперь присматривают. – reasoning none больше нет – минимум low. Fast mode с EU-резиденцией не работает (ту-дум-с) – temperature, top_p, logprobs – удаляйте из кода, параметры не поддерживаются. Эх, температурушки теперь нет практически ни у кого, так что да, забейте, главное задачи модели ставить правильно. Вот еще прикольное из гайда: – модель чаще останавливается и задаёт вопросы вместо того, чтобы делать (и это хорошо). Если не надо - дают промпт «bias towards action», чтобы она доводила задачу до конца. – сильнее реагирует на инструкции из skills и AGENTS.md – настолько, что рекомендуют аудит всех файлов, к которым у неё есть доступ. А то там может быть старье всякое. – любит списки, таблицы и markdown, повторяет одни и те же фразы. В гайде есть готовый промпт со списком слов-паразитов: delve, leverage, foster, «it's worth noting» и знаменитое «This isn't about X. It's about Y». – для маленьких коммитов пишет слишком много тестов. – делегирует субагентам меньше, чем хотелось бы. Обещают, что за счёт меньшего числа выходных токенов задача в среднем выходит дешевле, чем на GPT-5.6, хотя цена за токен выше. https://developers.openai.com/api/docs/guides/latest-model
-

О, Астра появилась в ChatGPT/Codex
-


 +3
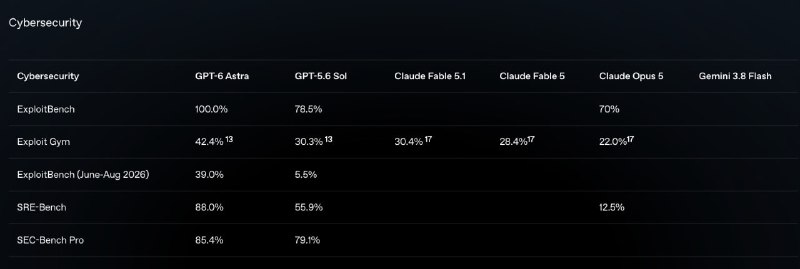
OpenAI выкатила GPT‑6 Astra. Типа добро пожаловать в AGI. Короче, надо детально смотреть, но то что прогресс существенно ускоряется, - это факт. Что по цифрам: – Terminal‑Bench 4.0 – 57,9% против 55,8% у Claude Fable 5.1. Разрыв в пределах шума, но OpenAI напирает на цену: на 63% дешевле за задачу – Terminal‑Bench Science – 64,6% против 52,6% у Fable 5.1. Тут отрыв уже настоящий – FrontierMath Tier 4 – 97,6%, ARC‑AGI‑3 – 99,9%. Оба бенчмарка фактически закрыты, ждём Tier 5 и ARC‑4 – OSWorld 2.0 – 72,6% и при этом на 47% быстрее предыдущего Sol. Astra продают в первую очередь как модель для computer use – Цена – $10 за миллион входных токенов, $50 за миллион выходных. Fast mode – в 2 раза дороже за скорость до 2,5x. Как у Fable. Где Claude всё ещё впереди: Humanity's Last Exam с инструментами (65% у Fable 5.1 против 57,2%), DeepSWE, Artificial Analysis Intelligence Index. Самая интересная часть – кибербезопасность. Astra получила уровень Critical по их Preparedness Framework, набрала 100% на ExploitBench, а на свежих уязвимостях Chrome за июнь–август нашла два ранее неизвестных зеро‑дея прямо во время теста. В публичной версии всё это порезано: proof‑of‑concept эксплойты модель писать откажется, а полноценный доступ для защитников будут выдавать через программу Daybreak. Знакомая схема – Anthropic ровно так же делает с Fable и Mythos. Индустрия сходится к двухуровневой модели: всем – кастрированную версию, проверенным – полную. Второй важный сюжет – alignment. OpenAI хвастается, что в honeypot‑тесте на выход за границы задачи Sol нарушал их в 48% случаев, Astra – в 0%. И тут же признаётся, что рассуждения Astra стало сложнее мониторить: модель просто пишет меньше промежуточных шагов. То есть с поведением стало лучше, а с прозрачностью – хуже, и это они называют «приоритетом для исследований». Для бизнеса: если у вас агентные задачи в браузере или терминале – цена за задачу сейчас главный аргумент, и по нему Astra выглядит сильно. Для чистого кодинга разница с Claude не сильно заметна. Но попробовать стоит. https://openai.com/index/gpt-6-astra
-

Text-to-speech от Inworld снова на первом месте по качеству. Очень рад за ребят. Я проводил интервью с их CSO и надеюсь доберусь до монтажа на этой неделе. Там много интересного, как маленькая лаборатория обходит грандов. И прикольно как уже 2 вендора обходят ElevenLabs, при том что Inworld стоит $20 за 1 миллион символов, а ElevenLabs - $100 https://artificialanalysis.ai/text-to-speech/leaderboard/controlled-voice
- Older posts