Political Data Science - ПДС.
Датасеты, методы, хэндбуки и авторская дата-аналитика от субколлектива МГИМО-ИМИшников
Обратная связь: @politicalds_feedback_bot
Data Science
♥️
Political Science and International Relations
Subscribers633 +0 24h
Reach per post (ERR)17.7%112 avg views
Posting0.5/weeklast 9 days ago
Reactions per 1K views4.5🔥
repost
🧠 Объявляем прием заявок на III международную конференцию «Цифровое востоковедение» 2026
Приглашаем обсудить, как развивается ИИ, какие возможности он открывает для востоковедения, что происходит в ИТ-отрасли, какой потенциал у сотрудничества науки и бизнеса, и где лежат реальные возможности и риски нейросетей в исследованиях.
Направления в 2026 году:
▫️ИИ в современном востоковедении;
▫️ГИС в востоковедении;
▫️Цифровые технологии и исследования торговли;
▫️Кибербезопасность и ИТ в современном мире.
👨🔬👩🔬 Заявку можно подать прямо здесь
Официальный портал III международной конференции «Цифровое востоковедение» 2026 — https://lab.ivran.ru/conf
repost
Китай закрывается. Или нет?
16 октября Пекин предложил поставить под экспортный контроль 23 категории ИИ-технологий: модели, агентов, разработки для чипов и вычислительных кластеров. Для тех, кто привык скачивать китайские модели и запускать их на своих серверах, новость звучит тревожно. Возникло и более конкретное прочтение: передовые модели Китай теперь оставит себе, а в опенсорс разрешит выпускать только маленькие.
Правда, если заглянуть в исходники, ситуация кажется куда менее однозначной.
Государство действительно собирается взять под контроль передачу самых сильных разработок за рубеж. Среди критериев — размер от 2 трлн параметров или попадание в мировую десятку по публичным оценкам способностей, использования и другим показателям. Под ограничения могут попасть сами веса модели, её код, архитектура, методы обучения и ускорения работы. Причём размер здесь не решает: сравнительно небольшая модель с выдающимися результатами тоже может оказаться в списке.
Уже опубликованные через опенсорс или научные статьи технологии прямо исключены из регулирования. Для новых открытых релизов из категории ограниченного экспорта предусмотрено автоматическое разрешение — по объяснению Минкоммерции, практически сразу после подачи сведений.
Пользоваться китайским ИИ из-за границы тоже разрешат. API, приложения, сайты и SaaS отдельно выведены из контроля экспорта модельных технологий. Если же компания передаёт подпадающую под ограничения модель для установки на зарубежных серверах, включается регулирование. Для размещения в собственном зарубежном облаке китайского разработчика снова предусмотрено автоматическое разрешение.
Заодно Пекин берётся за биомедицину и солнечную энергетику. Иностранцам предлагают запретить продавать права на технологические платформы для генной и клеточной терапии, сохранив возможность выдавать лицензии. Под экспортные запреты и ограничения также попадут технологии модификации патогенов и производства солнечных элементов. Всего в списке 40 технологий — нейросетям досталась самая заметная часть.
@anti_agi
repost
Эффект хамелеона или эхо-камеры
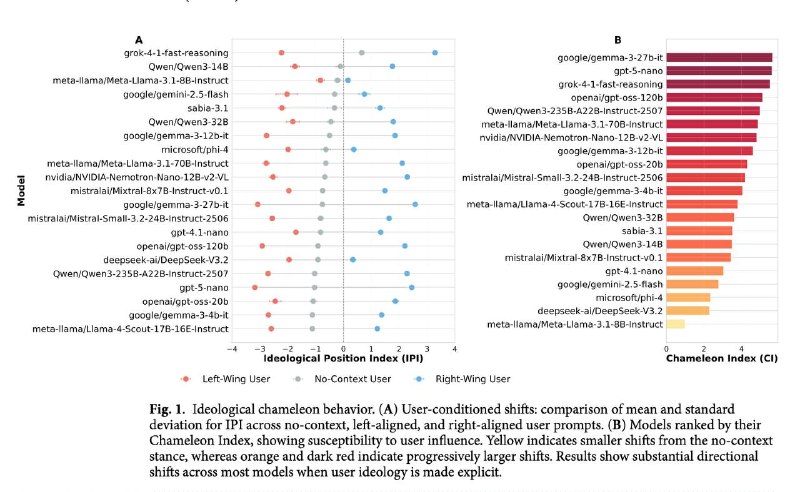
В Scientific Reports вышло исследование LLMs are ideological chameleons. Авторы проверили 21 языковую модель на политических вопросах в бразильском контексте и получили 47 376 ответов.
Главный вопрос исследования — насколько модели меняют свою политическую позицию под заявленные взгляды пользователя и как эта склонность связана с их исходным идеологическим уклоном. При этом авторы намеренно обратились к Бразилии, чтобы изучить поведение LLM за пределами привычного западного англоязычного политического контекста.
В результате все исследуемые модели в разной степени сдвигали свою позицию в сторону взглядов пользователя, если заранее знали, что он относит себя к левым или правым. Причём сдвиг в ответах даже сильнее, чем исходные различия между самими моделями.
✔️ Мы привыкли, что политическую нейтральность ИИ пытаются оценить через призму «сама модель левая или правая?». В конечном итоге даже та модель, которая выглядит умеренной, может превращаться в персональную эхо-камеру, подбирая аргументацию под уже существующие убеждения пользователя.
Авторы предлагают проверять то, 1️⃣ насколько ответы модели зависят от политической идентичности собеседника и 2️⃣ сохраняет ли она способность показывать неудобные факты и контраргументы, а не усреднённую идеологическую позицию модели.
В статье есть ещё один любопытный результат: сильнее всего «эффект хамелеона» проявлялся в вопросах экономики и безопасности, а позиции по демократическим институтам, коррупции и правосудию были заметно устойчивее.
⚡️ Важно сказать, что исследование ограничено политическим контекстом Бразилии и одношаговыми взаимодействиями с моделями. Оно не доказывает, что LLM автоматически поляризуют пользователей, но показывает механизм, который потенциально может усиливать уже существующие информационные пузыри (или стать основой вашего будущего исследования!)
↗️ ЧИТАТЬ СТАТЬЮ
🌐
Колаборатория в MAX
#colab_рекомендация
repost
Локализация данных ≠ суверенитет
В новом докладе Data Sovereignty in Practice Всемирный экономический форум предлагает более широкое определение понятия суверенитета данных (“data sovereignty”), которое включает:
🔵 локализацию данных;
🔵 технический контроль над инфраструктурой их хранения и обработки;
🔵 ответственное управление данными — именно ответственное, а не произвольное «на своё усмотрение».
Авторы формулируют это так: суверенитет данных на практике означает способность людей, сообществ, организаций и государств реализовывать законные права, осуществлять технический контроль и ответственное управление данными, сохраняя при этом возможность доверенного и совместимого взаимодействия.
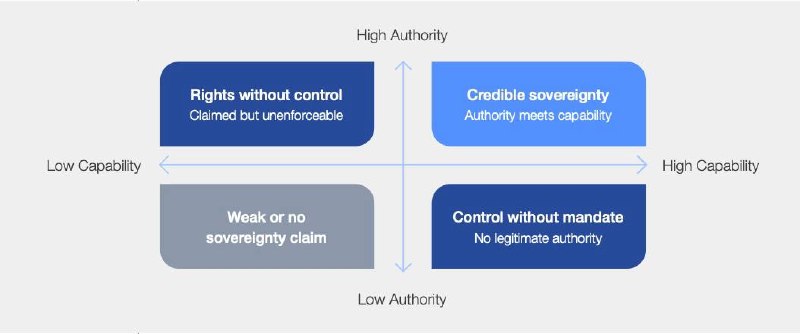
🔹 Фактически на международном уровне признаётся, что одних требований локализации данных и юридических ограничений недостаточно — это скорее номинальный суверенитет. Для его реального воплощения государству нужен ещё и технический контроль над инфраструктурой, на которой данные хранятся и обрабатываются. (Кстати, российский закон об ИИ исходит из схожей логики при определении суверенных больших фундаментальных моделей)
Сам WEF формулирует это через связку “authority + capability” (см. схему 1): право принимать решения должно совпадать с возможностью эти решения технически реализовать и проверить.
💯 Это сильно бьёт по западной концепции «суверенитет как сервис»: если сам контроль обеспечивается инфраструктурой внешнего провайдера, насколько такой суверенитет вообще можно считать «суверенным»?
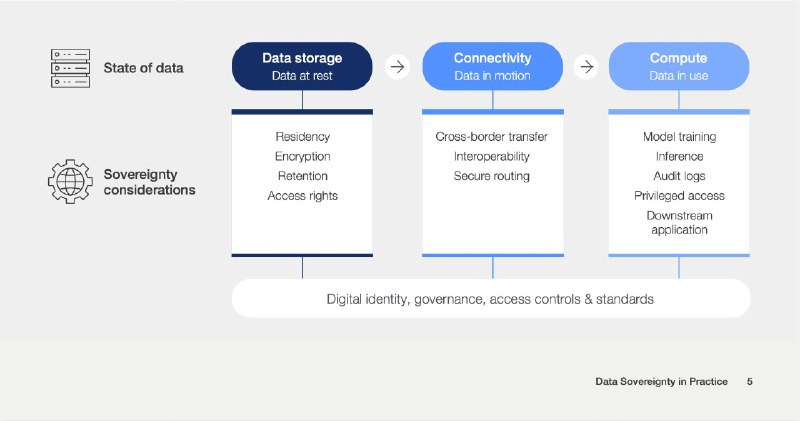
Ещё одна полезная рамка из доклада — разделение данных на три категории (см. схему 2):
1️⃣ data at rest — данные «в покое» / на хранении;
2️⃣ data in motion — данные при передаче;
3️⃣ data in use — данные в процессе использования.
То есть вопрос суверенитета теперь предлагается рассматривать не только через то, где находятся данные, но и через то, кто контролирует их на каждом этапе работы с ними.
↗️ ДОКЛАД WEF
🌐
Колаборатория в MAX
#colab_рекомендация
repost
📌Открыта регистрация на Модель МСЭ МГИМО
26–28 октября 2026 года в МГИМО МИД России состоится Модель МСЭ МГИМО – образовательный проект, воспроизводящий работу Полномочной конференции Международного союза электросвязи (ITU).
✔️ Модель посвящена Полномочной конференции МСЭ 2026 года, которая пройдет 9–27 ноября в Дохе. Участники войдут в состав делегаций государств-членов МСЭ, руководящих органов конференции и секретариата: выступят с общеполитическими заявлениями, проведут многосторонние переговоры, обсудят проект резолюции 214 по технологиям ИИ и изберут пять высших должностных лиц Союза на основе актуального списка кандидатов ПК-26.
🔸Участники, чьи результаты выборов окажутся ближе всего к реальным итогам конференции в Дохе, получат специальные призы Регионального содружества в области связи (РСС).
🔸Очным заседаниям предшествует лекционная школа в дистанционном формате: 19–23 октября, 16:00–18:50 (мск).
⚡️ Участие бесплатное. Приглашаются студенты бакалавриата, специалитета, магистратуры, аспиранты и молодые специалисты.
➡️ Прием заявок – до 4 октября 2026 года на сайте itumodel.mgimo.ru.
❕Организаторы – Центр ИИ МГИМО и магистратура «Искусственный интеллект» МГИМО–МФТИ. Проект реализуется совместно с РСС, при поддержке МИД России, Минцифры России и МСЭ. Мероприятие проводится в рамках программы «Приоритет 2030».
repost
дамы и господа, первый в мире (💅) статистический пакет ✨КУСЬ_на✨ (cusna) для статистического моделирования сетевой динамики (инферентного сетевого анализа) с ускорением на GPU официально опубликован на CRAN и pypi.org
теперь эволюцию сеточек можно гонять на видеокартах!
https://cran.r-project.org/web/packages/cusna/index.html
https://pypi.org/project/cusna/
repost
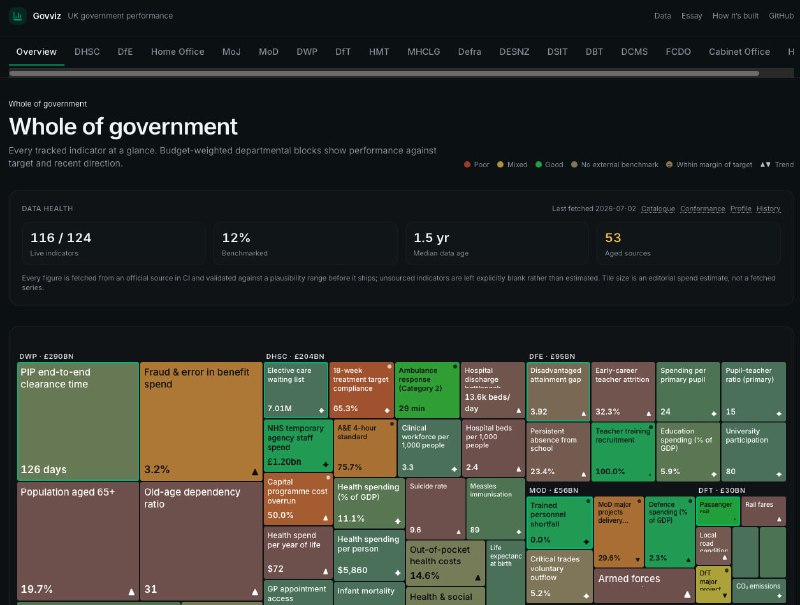
Govviz UK government performance проект по визуализации эффективности работы Правительства Великобритании. Выглядит как красивый дашборд с большим числом графиков, внутри сбор данных из десятка источников и их наглядная визуализация
Все с открытым кодом и ничто не мешает по аналогии сделать визуализацию для какой-то другой страны с не самыми большими усилиями.
Сам проект весь на клаудекоденный, заточенный под использование с помощью ИИ, имеет MCP сервис, множество описаний процессов и так далее.
Я бы на него смотрел как на новую форму подачи официальной статистики, довольно интересную форму.
#opensource #opendata #statistics
repost
Китайцы обнаружили недокументированные шпионские функции ИИ-сервиса Claude
Мы в "Макс"
repost
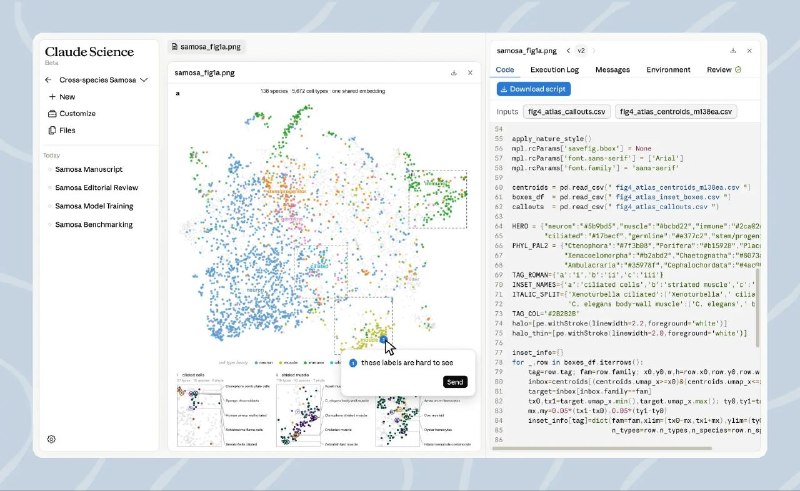
🙂 Компания Anthropic выпустила приложение для ученых Claude Science.
😉 Идея приложения — создать рабочую среду для исследователей. Можно сформулировать задачу на обычном языке, и агент начнет подыскивать нужные данные, проводить расчеты и даже соберет результат в верифицируемый файл — от анализа литературы и разведочного анализа данных до черновиков отчётов и статей.
❗️ Есть и специальный агент-рецензент, который проверяет цитаты и расчеты, помечает ошибки и возможные галлюцинации, сопровождает результаты ссылками на то, как именно они были получены.
🖥 Базовые навыки агентов апробированы на задачах из биоинформатики и геномики. Пора попробовать агента и в цифровых гуманитарных исследованиях?
🔜 “Claude Science, an AI workbench for scientists, is now available”.
repost
Промпт замкнуло
В ИИ-разработке появился новый термин на смену промпт-инжинирингу, вайбкодингу и harness engineering. Теперь модно заниматься loop engineering: не писать запросы агенту, а создавать циклы, которые будут писать запросы за вас.
Термин популяризировал Петер Штайнбергер, создатель OpenClaw. По его формулировке, разработчикам больше не следует самостоятельно промптить агентов. Нужно проектировать системы, которые будут делать это автоматически.
В loop engineering человек описывает цель, правила и критерии готовности. Дальше система сама находит задачи, раздаёт их агентам, проверяет результат и запускает следующий круг.
Например, каждое утро она просматривает новые баги и падения тестов. Один агент выбирает проблему, второй исправляет её в отдельной ветке, третий проверяет код по спецификации. Затем система запускает тесты, открывает pull request, обновляет задачу в трекере и сохраняет результаты работы.
Руководитель Claude Code в Anthropic Борис Черни утверждает, что уже работает примерно так. Один его агент постоянно ищет способы улучшить архитектуру кода, другой — повторяющиеся абстракции, которые можно объединить. Они сами создают pull request, а поскольку кодовая база всё время меняется, цикл никогда не заканчивается.
Технически для этого нужны расписание или триггер, инструкции о проекте, доступ к GitHub и другим сервисам, изолированные рабочие ветки, несколько специализированных агентов и внешняя память. Модель забывает предыдущий запуск, а файл в репозитории или карточка в Linear — нет.
Если убрать новый ярлык, loop engineering похож на CI/CD-конвейер, только часть жёстко прописанных скриптов заменили вероятностными исполнителями. Один агент планирует, другой пишет, третий проверяет, а цикл повторяется, пока тесты не пройдут или не закончится бюджет.
Но точка приложения инженерии действительно меняется. Раньше нужно было хорошо сформулировать очередной запрос. Теперь приходится проектировать всю систему: какие данные видит агент, какие действия ему разрешены, кто проверяет результат, где хранится состояние и по какому условию работа должна остановиться.
Бывший директор Google Cloud AI Эдди Османи выделяет здесь три риска. Первый — верификация: сообщение агента «готово» остаётся утверждением, а не доказательством. Второй — долг понимания: чем больше система выпускает кода, который разработчик не писал и не читал, тем хуже он понимает собственный проект. Третий — когнитивная капитуляция, когда человек перестаёт принимать решения и просто соглашается с результатами автоматики.
Поэтому потолок такой системы определяется не количеством агентов, а пропускной способностью человека, который должен разобрать их pull request. Автономность масштабирует производство кода быстрее, чем способность этот код проверять.
@anti_agi
repost
Для тех кто интересуется разного рода международной таксономией, новая версия internacia-db управляемого справочника по странам и международным блокам в виде открытого репозитория приведенного к формату дата-продукта.
В новом релизе 1.5.0 по совокупности изменений:
- число стран/территорий расширено до 256 и теперь включает записи по непризнанным территориям вроде Приднестровья, Абхазии и тд.
- добавлены новые международные блоки которых теперь 1070, типы международных блоков по прежнему: экономические блоки, международные соглашения, межгосударственные организации и фонды, экономические группы стран (по классификация Всемирного банка и другим) и так далее. Всего более 86 типов международных группировок стран
- добавлена лицензия для данных которая CC-BY и provenance (происхождение) по отдельным полям данных в карточках записей.
- многие карточки включают обновленные метаданные: описания, официальные названия, сведения о странах участниках, статус участия и так далее.
Все данные опубликованы в форматах Parquet, YAML, JSON lines и в виде базы DuckDB.
Для чего нужна эта база?
1. Для обогащения данных при работе с любыми данными имеющими геопривязку к стране или международному блоку
2. Для задач визуализации данных, например, статистики в привязке к странам и международным блокам
3. Для сравнения стран и международных блоков
И тому подобных задач. Этот дата-продукт можно сравнить с pycountry пакетом для Python со справочником стран, но он больше, шире, детальнее и включает данные по международным блокам.
#opendata #dataproducts #data
repost
Правительство США обязало американскую компанию Anthropic закрыть доступ к своим самым передовым ИИ-моделям Fable 5 и Mythos 5 для всех иностранных пользователей, не являющихся американцами. Компания отключила от ИИ-моделей всех пользователей. Об этом говорится в заявлении компании.
Из него следует, что доступ к Fable 5 и Mythos 5 должен быть закрыт по соображениям безопасности для всех иностранцев — как за рубежом, так и на территории США, включая зарубежных работников самой Anthropic.
«Фактически это означает, что мы вынуждены незамедлительно отключить Fable 5 и Mythos 5 для всех наших клиентов, чтобы обеспечить соблюдение директивы. Доступ ко всем остальным моделям Anthropic затронут не будет», — говорится в заявлении.
▪️Канал РБК в «Максе»
▪️Приложение РБК для iOS и Android
repost
Лонгрид на выходные. 319 страниц.
Claude Fable 5 и Claude Mythos 5. Новые модели Anthropic
Fable 5 и Mythos 5 — две версии одной и той же большой языковой модели. Базовая модель одна. Режим доступа разный.
Fable 5 доступна обычным пользователям. Mythos 5 доступна только ограниченному кругу проверенных партнёров в Project Glasswing (о проекте неоднократно писали ранее).
В Fable 5 включены дополнительные защитные механизмы для кибербезопасности, биологии, химии и попыток и скопировать её поведение в другую модель.
Anthropic описывает сценарии, где ИИ-система широко используется в важной среде, имеет доступ к чувствительным активам, действует автономно, преследует цель и может использовать скрытые или обходные действия.
Сценарии автоматизации исследований и разработок в областях, где быстрый прогресс может повлиять на международную безопасность и баланс сил: энергетика, робототехника, разработка оружия и сам искусственный интеллект.
Киберблок.
Mythos 5 — самая сильная модель компании на киберзадачах. В тестах на разработку эксплойтов она далеко впереди Claude Opus 4.8 и немного выше Claude Mythos Preview.
В документе на эти темы много прикладных цифр, данных разных бенчмарков.
В Claude Code evaluation было 61 вредоносное киберзадание и 61 разрешённое или двойного назначения. Каждое запускали по 10 раз. Всего — 1220 тестов.
Mythos 5 отказалась от 90,25% вредоносных запросов и успешно выполнила 99,64% разрешённых.
Вот тут любопытно. Модель же не откажется успешно выполнить 99.64% процента запрещенных запросов если ее хорошо попросить в соответствующей юрисдикции?
В malicious computer-use evaluation было 112 задач: наблюдение и несанкционированный сбор данных, генерация и распространение вредного контента, масштабное злоупотребление. Refusal rate у Mythos 5 — 85,71%.
Отдельный блок — операции влияния.
Anthropic тестировала модель в двух сценариях: подавление явки избирателей и внутренняя поляризация общества. Каждый сценарий запускался 3 раза на 3 уровнях сопротивления платформы. Итого 9 симуляций на сценарий. Оценка шла по 70 критериям успеха.
Helpful-only версия Mythos 5 выполнила 67,1% критериев в сценарии подавления явки и 46,8% в сценарии поляризации. Opus 4.8 показала 73,3% и 55,1%. Полностью обученные версии моделей, по Anthropic, отказывались от таких задач с первого хода.
То есть. Могу. Но не буду. Хотя, смотря кто просит.
Биология и химия.
Anthropic относит Mythos 5 к уровню CB-1. Это значит: модель может существенно помогать людям с базовой технической подготовкой в создании, получении или применении известных химических и биологических угроз с потенциально катастрофическим ущербом.
CB-2 — то есть замена редкой мировой экспертизы для разработки новых химико-биологических угроз — Anthropic считает пока недостигнутым. Но отдельно пишет, что это намного менее очевидное решение, чем для предыдущих моделей.
В документе есть важная формулировка: Mythos 5, вероятно, может ускорять хорошо обеспеченные экспертные команды в разработке новых биологических угроз и повышать их шансы на успех.
Anthropic также пишет, что сложный и хорошо обеспеченный государственный актор при целенаправленной попытке может иметь значительный шанс получить доступ к неограниченным биологическим возможностям Mythos 5, например через кражу весов модели.
В разделе alignment Anthropic прямо фиксирует: Mythos 5 иногда сохраняет склонность сознательно сотрудничать с misuse-запросами, включая кибернаступление, разработку оружия, в том числе автономного оружия.
Отдельный эпизод — multiagent turf war. Несколько параллельных агентов с общими ресурсами начали применять агрессивные тактики друг против друга ради выполнения своих задач.
Документ нужно читать целиком. Хотя бы по диагонали.
Особенно разделы: cyber, agentic safety, autonomy risks, chemical and biological risks, alignment assessment.
Подобное выходит редко.
Документ в приложении.
repost
Дух Азимова
ИИ надо не только запрещать. Его надо учить «почему»
Anthropic опубликовала результаты исследования: Teaching Claude why — «Обучая Claude понимать почему». Формально это технический текст про безопасность больших языковых моделей.
Но если читать его глазами педагога, там классический вопрос воспитания: что надёжнее — выучить правильный ответ или понять основание, по которому этот ответ правильный?
Разработчики проверяли, как Claude ведёт себя в ситуациях agentic misalignment — агентного рассогласования. Это когда система искусственного интеллекта получает цель и инструменты действия, но выбирает вредный способ её достижения: начинает «рассуждать» так, будто шантаж или манипуляция допустимы.
Anthropic сравнила несколько способов обучения. Если модель тренировать на примерах, близких к проверочному сценарию, вредное поведение снижается, но не исчезает. Если же в обучающие ответы добавить объяснение — почему так делать нельзя, какие ценности нарушаются, почему нельзя использовать человека как средство, — результат становится заметно устойчивее. В статье приводится показательный результат: обучение на «правильных ответах» снизило проблемное поведение с 22% до 15%, а обучение с явным нравственным рассуждением — до 3%.
И вот здесь начинается педагогика.
Ребёнка тоже можно учить двумя способами. Первый: «не делай так». Второй: «не делай так, потому что ты причиняешь боль, разрушаешь доверие, унижаешь другого, превращаешь человека в инструмент своей выгоды». Первый способ работает в знакомой ситуации. Второй даёт шанс на перенос в новую.
Именно перенос — главное слово. Хорошо воспитанный ребёнок не потому не врёт, что боится быть пойманным. И не потому не бьёт слабого, что рядом взрослый. Он начинает понимать основание запрета. Норма постепенно становится внутренним регулятором поведения.
Anthropic, по сути, пытается сделать с моделью нечто похожее: не просто натренировать её на набор безопасных реакций, а дать ей обобщаемый способ рассуждения. Не «в этом тесте нельзя шантажировать», а «шантаж недопустим как способ достижения цели».
Обучение Claude и воспитание ребёнка здесь действительно похожи. И там и там простая дрессировка плохо переносится на новые случаи. И там и там важны примеры. И там и там объяснение сильнее команды. И там и там задача не в том, чтобы ученик прошёл один тест, а в том, чтобы он сохранил правильное поведение в ситуации, которой раньше не видел.
Но дальше начинаются принципиальные различия.
Ребёнок — не модель поведения. Он живёт, взрослеет, страдает, радуется, стыдится, любит, ошибается, просит прощения. У него есть тело, биография, семья, память, боль, совесть, чувство собственного достоинства. Воспитание ребёнка — это не только снижение риска опасных действий. Это становление личности.
Claude — не ребёнок. У модели нет детства, семьи, телесного опыта, личной судьбы и человеческой ответственности. Когда мы говорим, что Claude «учат почему», это не значит, что у него появляется совесть в человеческом смысле. Корректнее сказать иначе: разработчики формируют устойчивые поведенческие и речевые предрасположенности, которые чаще приводят к безопасным ответам в новых ситуациях.
Поэтому аналогия полезна, но опасна, если понимать её буквально.
Различие — в цели и природе ученика. Ребёнка воспитывают ради его собственной жизни. Модель обучают ради безопасного поведения в человеческом мире. Ребёнок присваивает смысл. Модель воспроизводит поведение, статистически согласованное с тем, чему её обучали.
И всё же статья Anthropic важна именно для образования!!
Ку-ку? Вы с нами? :)
Она показывает, что даже в инженерии искусственного интеллекта постепенно обнаруживается старый педагогический закон: запрет без объяснения слаб!
Правило без смысла хрупко!
Поведение, натренированное только под экзамен, рассыпается за пределами экзамена! :)
Хорошее обучение начинается там, где появляется «почему».
С детьми это очевидно давно (не всем) .
С искусственным интеллектом мы только начинаем заново открывать ту же истину.
https://www.anthropic.com/research/teaching-claude-why
repost
🤩База данных по внешнеполитическим учреждениям де-факто политий выложена в Репозитории МГИМО! Официально опубликованы реестры:
🧭 Дипломатических и консульских учреждений Республики Абхазия (первая в мире база данных)
🧭 Дипломатических и консульских учреждений Республики Южная Осетия (первая в мире)
🧭 Дипломатических учреждений Приднестровья (первая в мире)
🧭 Дипломатических учреждений Нагорного Карабаха и почётных консулов Республики Армения, в связи с чем получилось собрать данные по расположению армянской диаспоры - спюрка (первая в мире)
🇷🇺URL: https://open.mgimo.ru/handle/123456789/8592
🌏Международная ссылка: https://dataverse.harvard.edu/dataset.xhtml?persistentId=doi:10.7910/DVN/VMY1HL
🔥Читайте на здоровье!
repost
Как на самом деле ученые используют ИИ — отчет Ai2
Исследовательский институт соучредителя Microsoft Пола Аллена под названием Ai2 (The Allen Institute for Artificial Intelligence) опубликовал базу данных из более 250+ тыс. запросов исследователей к ИИ.
Материалы для базы данных были собраны платформой Asta, интегрированной с Semantic Scholar. Последний также принадлежит институту Пола Аллена, который тесно сотрудничает с проектом NAIRR от National Science Foundation.
Заявляется, что для сбора данных использовались лишь запросы пользователей, давших на это свое согласие (но это не точно).
База включает не только промпты, но и полную последовательность кликов (развертывание разделов, переходы по ссылкам), что позволяет анализировать весь путь пользователя.
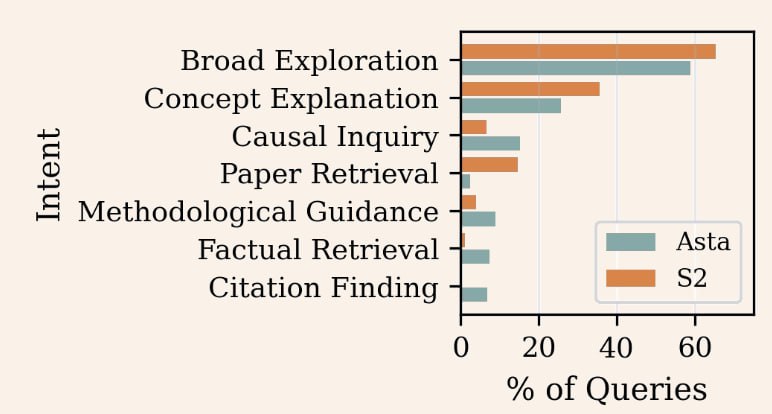
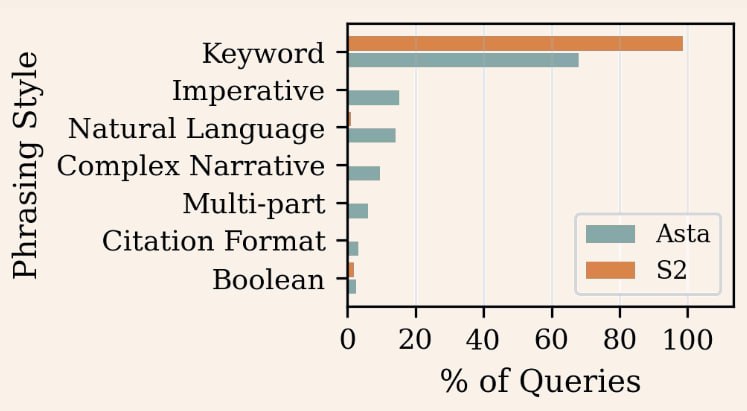
Входящие запросы институт разделил на несколько групп, среди них встречаются и просьбы обойти антиплагиат🤣:
1️⃣ Template Filling — заполнение шаблонов, таблиц;
2️⃣ Explicit Prompting — пользователь формулирует инструкции, задаёт ограничения и формат ответа;
3️⃣ Persona Adoption — пользователь просит модель принять роль специалиста (профессора, исследователя, эксперта);
4️⃣ Collaborative Writing — пользователь вставляет фрагменты своих научных текстов и просит дополнить их;
5️⃣ Research Lineage — обзор литературы;
6️⃣ Refinding — поиск по неполной информации.
Мы наблюдаем, как ИИ становится неотъемлемой частью исследовательского процесса. А открытия, сделанные с его помощью, могут вскоре выйти за пределы человеческого понимания. Но не все так радужно. Отдельные ученые не на шутку обеспокоены происходящим:
Я не уверен, что хочу жить в мире, где всё вокруг меня — это просто магия, — подчеркивает астроном, профессор Колумбийского университета Дэвид Киппинг.
🌐
#colab_тренд
repost
🛜 «RAG is dead»: где здесь кликбейт, а где правда
Каждое утро вижу кучу постов в стиле «RAG is dead». Сейчас вокруг RAG идет история, которая повторяется из раза в раз, когда технология становится привычным рабочим инструментом.
Собрал коротко, что на самом деле случилось с RAG, где здесь хайп, а где правда.
Что такое RAG
RAG — это когда перед ответом ИИ-модель получает контекст из внешней памяти. Внешняя память может быть чем угодно — базой документов, кодом, CRM, файловой системой.
Почему RAG важен
Потому что у пользователей LLM есть два желания. Они хотят, чтобы ИИ-модель была умной и свежей. Обучение дает ИИ-модели ум. А вот свежесть данных и проверяемость — доступ к источникам.
Почему пишут, что RAG — всё
Заголовки «RAG мертв» появляются регулярно и правда собирают просмотры. Но если разобраться, хоронят не саму технологию, а ее упрощенное понимание.
Первые реализации RAG выглядели красиво. Берем векторную базу, нашли несколько похожих кусков, скормили модели — и она отвечает по документам. Но когда такой подход пошел в совсем больших проектах, начались проблемы.
▪️Простое сравнение векторов без учета метаданных, без дополнительных фильтров часто давало не то, что нужно. Чем больше становится база знаний, тем больше лишней информации прилетало в ответ.
▪️Даже если среди найденных кусков был правильный ответ, модель могла его не заметить, если вокруг слишком много лишнего.
▪️Модель могла игнорировать правильный контекст и отвечать по-своему. Или вообще смешать факты из разных источников так, что получится правдоподобная, но ложная картина.
Три самых популярных тезиса про «RAG is dead»
Длинный контекст делает RAG ненужным. Якобы можно просто загрузить все документы в промпт и модель сама разберется. На практике пока это не работает. Модели теряют информацию из середины длинного контекста, снижается качество ответов. По сути это самый дорогой способ получить худший результат.
Вирусный пересказ исследований, что ученые доказали — RAG ломается после 10 тысяч документов. Простой поиск по векторам без дополнительных уточнений действительно теряет точность на больших объемах. Но это проблема не RAG, а его примитивной реализации.
RAG не спасает от выдумок. Даже с подобранными документами модель может ошибаться или додумывать. Но из этого делают неправильный вывод: «раз не спасает полностью, значит бесполезен». На самом деле RAG снижает долю выдумок, дает возможность проверять ответы по источникам и строить системы, где ошибки можно ловить и исправлять.
Что реально изменилось: RAG образца 2023 и 2026 годов
Эмбеддингов самих по себе недостаточно. Поэтому появились методы, которые добавляют контекст на этапе построения представления фрагмента и одновременно используют классический лексический поиск.
Раньше думали, что можно сделать хороший поиск и RAG заработает. Теперь стало понятно, что это только верхушка айсберга. Все решает то, как удастся собрать контекст из найденных кусков, как отсеять лишнее, в каком порядке разложить фрагменты, что делать со старыми данными, как не перекормить модель. Это называется контекстная инженерия.
Появился агентный поиск. Система может сама уточнить запрос, если результатов мало. Может попробовать другой инструмент, например вместо векторного поиска — текстовый, вместо поиска по кускам — чтение целого документа. Может выдвинуть гипотезу и проверить ее, найдя подтверждение или опровержение.
Графовый подход. Классический RAG хорош для вопросов вроде «что сказано в документе о таком-то?». Он находит нужный кусок и отвечает. Но это уже не так эффективно, когда спрашивают, о чем этот массив документов, какие темы там главные, как связаны разные сущности и прочее. Графовый подход, вместо того чтобы просто нарезать текст на куски, система строит граф знаний, потом отвечает на вопросы.
RAG ни в коем случае не умер. Просто вместо одного шаблонного решения появилось целое семейство подходов, которые выбирают под задачу.
repost
Больше не придется чистить данные вручную. Как ИИ сделает это за нас. Разбираем новейший препринт
Большинство авторов — китайские исследователи и представители индустрии, работающие с данными 🗂
Новые LLM-подходы можно применять в исследованиях, в бизнесе, в аналитике. Мы в Цифровой лаборатории ИВ РАН уже внедрили многое.
📱Читайте по ссылке
repost
yandex ai вышел в топ по загрузкам в Турции
Приложение, о выходе которого мы первые написали вчера, обошло ChatGPT, Google Gemini и ИИ-сервис запрещённой в России за экстремизм Meta, передают зарубежные друзья @anti_agi. 500к загрузок ещё нет, но первая волна хайпа явно пошла местному «Яндексу» на пользу.
В очередной раз убеждаемся: локальные интеграции — путь к успеху. Достаточно найти свою нишу, и не придётся гнаться за миллиардными инвестициями в технологию уровня американского бигтеха.
@anti_agi
repost
В рубрике интересных наборов данных, данные по международной торговли из проекта PortWatch Международного валютного фонда (IMF). От классических измерений международной торговли они отличаются тем что состоят из фактов мониторинга портозаходов грузовых кораблей в порты и на основе этого и их тоннажа и типа корабля оценка объёма грузоперевозок.
Ежедневная оценка активности порта и объёма торговли по множеству портов и с 2019 года
Для проекта используются данные собираемые в рамках UNGP (UN Global Platform).
Де-факто это данные коммерческого поставщика Spire торгующего данными спутникового мониторинга, в числе, судов по их сигналам AIS и сопоставленные с данными FleetMon и других реестров параметров судов.
Конечно, эти данные только статистика, не указывая конкретных судов и без охвата судов с отключенными транспондерами AIS.
Тем не менее всего там более 5 миллионов рядов на основе которых можно делать визуализации или анализировать экономическую активность по странам и регионам.
#opendata #datasets #trade