
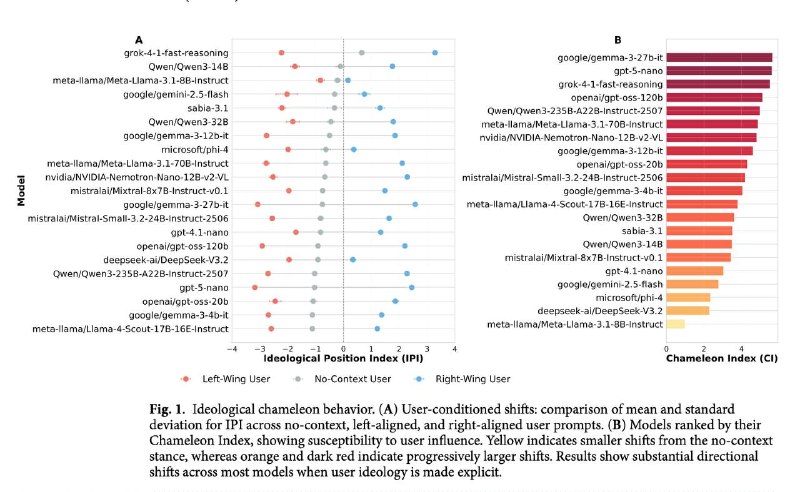
Эффект хамелеона или эхо-камеры В Scientific Reports вышло исследование LLMs are ideological chameleons. Авторы проверили 21 языковую модель на политических вопросах в бразильском контексте и получили 47 376 ответов. Главный вопрос исследования — насколько модели меняют свою политическую позицию под заявленные взгляды пользователя и как эта склонность связана с их исходным идеологическим уклоном. При этом авторы намеренно обратились к Бразилии, чтобы изучить поведение LLM за пределами привычного западного англоязычного политического контекста. В результате все исследуемые модели в разной степени сдвигали свою позицию в сторону взглядов пользователя, если заранее знали, что он относит себя к левым или правым. Причём сдвиг в ответах даже сильнее, чем исходные различия между самими моделями. ✔️ Мы привыкли, что политическую нейтральность ИИ пытаются оценить через призму «сама модель левая или правая?». В конечном итоге даже та модель, которая выглядит умеренной, может превращаться в персональную эхо-камеру, подбирая аргументацию под уже существующие убеждения пользователя. Авторы предлагают проверять то, 1️⃣ насколько ответы модели зависят от политической идентичности собеседника и 2️⃣ сохраняет ли она способность показывать неудобные факты и контраргументы, а не усреднённую идеологическую позицию модели. В статье есть ещё один любопытный результат: сильнее всего «эффект хамелеона» проявлялся в вопросах экономики и безопасности, а позиции по демократическим институтам, коррупции и правосудию были заметно устойчивее. ⚡️ Важно сказать, что исследование ограничено политическим контекстом Бразилии и одношаговыми взаимодействиями с моделями. Оно не доказывает, что LLM автоматически поляризуют пользователей, но показывает механизм, который потенциально может усиливать уже существующие информационные пузыри (или стать основой вашего будущего исследования!) ↗️ ЧИТАТЬ СТАТЬЮ 🌐 Колаборатория в MAX #colab_рекомендация