ИИ-пузырь: что происходит на самом деле сегодня. 🚬 Пару дней назад рынки снова дрогнули. Nasdaq упал на 4,6% за три дня – худший результат с апреля. Южная Корея остановила корги торги после падения KOSPI на 8%. Microsoft потерял 18%, Amazon – 10%. А OpenAI рассматривает перенос IPO на следующий год. 🤔 Да че тут блин происходит? Один и тот же вопрос, который мы задаём уже полтора года: "а окупается ли это вообще?" Цифры, которые не вписываются в нарратив масс. Вспомним как MIT опубликовали исследование, где проанализировали 300+ публичных кейсов внедрения ИИ, провели 52 глубинных интервью и опросили 153 руководителя на конференциях. Результат: 95% пилотных программ провалились. Потрачено $30–40 млрд на генеративный ИИ, а окупаемости нет. 🚬 Тут, конечно, стоит понимать простую истину, цена акций зависит не только от реальной стоимости компании, но и от ожиданий от неё инвесторов. 🧠 Не стоит себя обманывать. "Мы создали монстра" Financial Times только выпустили материал с красноречивым заголовком: "We created a monster" – компании сворачивают использование ИИ, потому что затраты разрушают бюджеты. 💸 Вот что внутри: - Средний корпоративный бюджет на ИИ в 2026 году: $7 млн в год – рост почти на 500% с 2024 года - 85% бюджета уходит на inference – просто на запуск моделей, не на разработку - Uber сжёг весь годовой бюджет на ИИ за 4 месяца – CTO компании публично признался. - Microsoft, которая вложила $13 млрд в OpenAI и пишет до 30% кода с помощью ИИ – отменяет лицензии Claude Code для инженеров из-за неподъёмных счетов. Переводит на собственный GitHub Copilot CLI. Одна компания потратила $500 млн за один месяц, тк забыли установить лимиты использования Claude 😐 Че там по потреблению? Мы видим Парадокс Джевонса в действии: чем дешевле и доступнее ИИ, тем больше его используют, и тем выше совокупные затраты. Goldman Sachs прогнозирует потребление токенов вырастет в 24 раза к 2030 году — до 120 квадриллионов в месяц. Даже если цена токена упадёт на 90% (а Gartner это прогнозирует), агентный ИИ потребует на порядок больше токенов на задачу. Итоговый счёт растёт. Источник. Наблюдается возврат к человеку. Уже есть первые сигналы - компании начинают возвращать сотрудников, уволенных "под ИИ". Не потому что ИИ плох, а потому что границы его применимости оказались уже, чем обещали вендоры. Только, вернуть их по старым "ценам" тоже не выйдет. Кстати, такой же тренд ожидаю и у нас в финтехе. Сейчас там идут сокращения, но ожидания от ИИ, особенно местного пошива, очень завышены и ТОПы не видят всей реальной картины, тк миддл менеджмент и эксперты приследуют свои интересы удержания у новой хайповой кормушки (ИИ), а наверх транслируют "аналоговнет" и "100% автоматизация с ИИ". Как бы потом не было больно нанимать людей обратно уже по рыночным ценам. 👍 Что делать-то? Совет от 📦 💅 1. Перестаньте гоняться за хайпом, нанимайте настоящих ИИ-экспертов (в тч AI head), работайте с культурой компании. ИИ эффективен в узких, рутинных задачах – обработка документов, кодинг, первичная поддержка, рутинная аналитика. 2. Считайте ROI на каждом пилоте. Двигайтесь через гипотезы и PoC. Если через 3 месяца нет измеримого эффекта – убивайте проект. 🇨🇩 3. Не заменяйте людей – усиливайте их. ИИ как инструмент, а не как замена. На ФОТ вы не сэкономите, те кто уже нырнул в эту тему, понимает, что токеномика сжирает фин эффект от сокращения фот. Экономия не масштабируется - масштабируется эффективность процессов и скорость принятия решений с ИИ, именно тут вы сможете не терять упущенную прибыль. 4. Матчите модель под задачу. Это моё любимое, не зря я писал выше серию постов про Fusion и Fugu - будьте гибче и умнее оркестрируйте локальные и публичные модели под задачи. А ещё мы делаем распределение задач по уровням для сотрудников, с соответствующей схемой доступа до моделей. Простые задачи – на дешёвые open-source модели. Pro, max и тп крутые и дорогие модели – только для сложной аналитики и кодинга. На этом все, удачи 😐

Dealer.AI
Жоский ИИ Дядя Твой личный поставщик AI 🦾🤖 Канал о мире интересного AI: теория, приклад и meme👾 Для связи @dealer_ai (реклама и консультации по AI для бизнеса). Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст РКН: 6348592885
-
-
repost Бизнес режет бюджет на типовые разработки из-за офисных вайбкодеров сотрудники сами создают рабочие инструменты. Иногда эти решения идут в продакшн, но все еще с помощью IT отдела *Налоговые консультанты KPMG без технического бэкграунда за 6 недель в командах с инженерами навайбкодили программу для автоматизации налоговых проверок и внедрили в клиентские платформы Два уровня зрелости офисного вайбкодера: Прототипы (быстрые инструменты) доступны любому офисному сотруднику со знанием ИИ. Большая часть повседневных задач бизнеса: отчёты, обработка документов, дашборды и т.д. сейчас решаются с помощью прототипов, создаваемых в реальном времени. На рабочем столе вместо свалки Excel - свалка Кода Зрелость вайбкодера наступает тогда, когда руководство позаботилось о безопасности и снабдила эксперта «Песочницами». Сейчас многие разработчики ПО и не только, смотрят в эту сторону и готовятся предложить такие Песочницы корпоративным клиентам В песочнице можно поселить AI агента, который будет помогать сотруднику создавать приложения В ней легче поддерживать корпоративный стандарт безопасности. У каждого он свой, но может включать, например: доступ только к копиям или обезличенным данным, автоматическое сканирование уязвимостей, контроль версий и полный аудит изменений 🗞 Финансистам и разработчикам советую ознакомится с материалом BCG vibe coding в финансах от июня 2026 . Много полезного ~~~~ 📈А тем временем Интеграторы открывают новые направления: - Постановка песочниц, платформ или сервисов с частичным или полным контролем - Сложные интеграции, миграции ERP, промышленная кибербезопасность - Обучение команд Новый слоган: "Мы сделаем так, чтобы вы могли делать сами" Прогноз по выручке пока все равно падает, но новые направления могут стабилизировать этот процесс. Биржевые сводки сейчас таковы, что Accenture потерял 18% капитализации за день. Capgemini упал на 8%, IBM тоже попал под давление Отчетность сильная, но акций обвалились, потому что инвесторы смотрят в будущее, а там - потеря маржи на типовых задачах корпоративных клиентов
-
edited Qwen+distillation+Mythos = Qwythos 🪨 Вот жеж умельцы, успели намайнить трейсов мифов и басен и сделать тюн Qwen 3.5 Единственное, конечно, на сколько реальны метрики? 🤔 Самое забавное это: - Модель требует генерации в первую очередь, а затем финального ответа — закладывайте запас max_new_tokens (рекомендуется 16384). - При жадном декодировании или низкой температуре (≤0.3) может уходить в повторы. - В критически важных контекстах рекомендуется перепроверять факты через инструменты. - Внимание: обучение было только текстовым — мультимодальные возможности унаследованы от базы и не тестировались. Крч быстро и смело сдистиллили 500М токенов С Mythos и Fable. 😮💨 Не жду чего-то вау, так поиграться. Ну и решили ребятки хайпу взять на закрытии мифов. 🧠
-
edited Не наступай на Fugu - новый координатор LLM api от Sakana.ai🐡 В противовес fusion ребята из Sakana.ai выпустили свой закрытый координатор моделей. Основная фишка японцев в своей модели, которая представляет из себя Small LM (SLM), я бы даже сказал tiny, тк на 0.6B параметров, специально обученную на задачи выбора: 1. Ответить самой на запрос. В тч рекурсивно вызывая себя. 2. Отдать на ответ другой модели+выдать ей роль (промпт и/или скилл) для ответа. Роли три: мыслитель, работяга и ревизор. 3. Агентная оркестрация и планирование. Получив запрос модель делает план, кого с каким запросом и инструментами дёрнуть, а также как сагрегировать ответ. В отличие от fusion, тут полностью закрытый инструмент с подпиской. Ещё из интересного есть тех. репорт. Который чутка разберём ниже, тк размер оч маленький, над понять, а почему такая SLM работает. У SLM две головы, одна для генерации текста. Вторая для выбора стратегий. Обучение происходит в три фазы: - Sft на данных полученных через ответы LLM, по сути, дистилляция больших братьев, как бы они генерировали ответы, планы и тп. 🚬 - Генетика на стратегиях оркестрации. Учат модель выдавать эффективные комбинации: LLM+роль+задача, а также завершить задачу, дать ответ или передать иному агенту. - RLVR этап как работа в среде, тк это стадия последняя, модель умеет: генерить стратегии, делать выбор и отвечать. Теперь нужно закрепить это в задачах с обратной связью от среды e2e. То самое выравнивание. Для оркестрации своей диалоговой системы, кстати, писал тут уже, ребята из Amazon использовали MAB (бандитов). Тут бы можно было тоже, но генетика красивое. 😜 В итоге, Fugu имеет мощное обобщение и работает даже на OOV примерах LLM. Те на моделях, которых не было в обучении. 🤙 Для меня остаётся конечно все ещё вопрос реальной эффективности 0.6B модели. Также стоит отметить, что в случае оркестрации на коленке, лучше взять fusion и локальные модельки. В остальном, довольно интересное решение, в рамках темы которая тут поднималась не раз - переход к специализации моделей и их метаоркестрации. 💃
-

#meme дня
-
MemPalace не дворец с мемами, но кое-что интересное есть. 🆒 Многие помнят нашумевшее решение для памяти агентов с продвижением через Милу Йовович. Инженерия действительно интересная, метрики высокие и, вроде, главный и единственный разработчик Бэн молодец. Однако, среди моих подписчиков есть знатные задроты датамайнеры, которые раскопали кое-что интересное. Воот тут в коде для работы с бенчмарком LongMemEval была выявлена хака для апа метрик бенчмарка. Вот они: 1. Прямой хардкод для работы с паттернами датасета r"when i was ((?:in )?high school|...)", r"(?:happy|fond|good|positive) (?:high school|...) (?:experience|memory|...)" Обычно подгонка под бенчмарк - это когда модель дообучают на тестовых данных. Здесь другой случай - алгоритм ретривала напрямую содержит хардкод под конкретные примеры из датасета. Это не обобщение, это whitelist'инг. 2. Подгонка под LoCoMo. Алгоритм библиотеки берет top_k=50, а LoCoMo содержит 19–32 сессий на разговор. При top_k=50 система возвращает весь корпус. Ретривал не работает - LLM просто читает все сессии и отвечает на вопрос. Это тест на reading comprehension, а не на память. 3. Стоп слова расширены под MemBench. Эти слова добавлены потому, что в вопросах MemBench они часто встречаются ("what kind of X do I prefer?", "I think Y"). Без них keyword overlap давал бы ложные срабатывания. "said", "would", "could", "should", "might", "can", "will", "shall", "kind", "type", "like", "prefer", "enjoy", "think", "feel", } В общем, это ещё не скам, но махонькое читерство. Поэтому за идею лайк, за хаки осуждаем. 👍 За инфо спасибо @andrewBezborodov
-
edited 
Челы перепридумали ансамблирование моделей. Методика которая известна ещё с классик ML. Да это апает качество ответа, даёт более стабильное поведение, снижает глюки и тп. Однако, чтобы получить ответ модель роутер касается всех моделей кандидатов 💸, те вы платите за все запросы в них + 1 запрос на агрегацию для ответа. 🧠 Волшебной палочки нет, за качество придётся доплатить. Если вам нужен быстрый ответ, а также экономия, лучше по старинке работать с компактизацией и соло запросом. 👍 Upd. Подписчики верно отметили, что для локал моделей может быть норм вариант, но дольше ответ.👌
-
repost 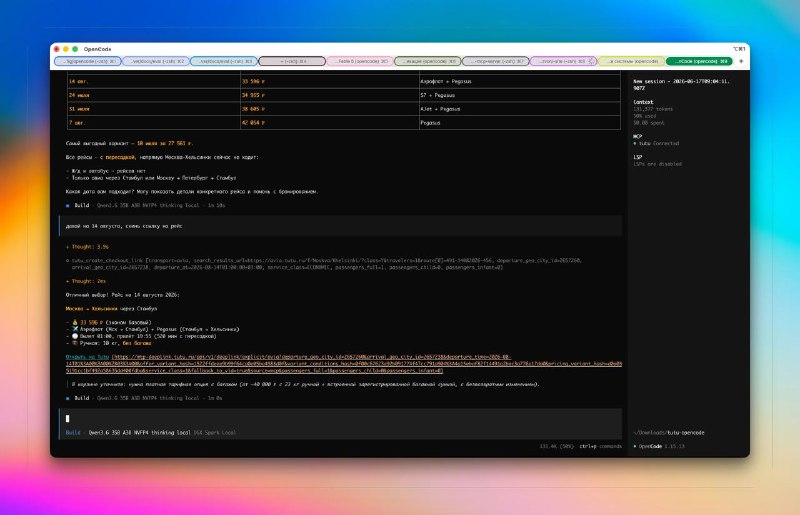
Чтобы агенты могли планировать поездки: MCP для работы с сервисом путешествий Туту Подключаете https://mcp.tutu.ru/mcp к своему агенту (я гонял на Codex, Hermes и OpenCode) — и он сможет искать вам самые дешевые билеты, следить за трендами, подбирать интересные отели и планировать путешествия полностью. Зимой я тестировал MCP для бытовых задач — писал про «Вкусвилл» и про управляющую компанию. ✈️ Весной мы с Дашей обсуждали первый отпуск с ребёнком, она предложила слетать в Японию на сакуру — и я поймал себя на мысли: обидно, что не могу прямо в агенте посмотреть билеты. Оказалось, в Туту уже думали про агентный MCP. Так и познакомились. 🧭 Что умеет сейчас Поиск по пяти направлениям — авиа, отели, ЖД, автобусы, электрички — повторяет витрину мобильного приложения. Плюс сборка ссылки на оформление: для отелей, поездов и автобусов она ведёт прямо в корзину с выбранными местами. Мне очень нравится кейс с поиском подходящих отелей, агенту доступны отзывы — может аналлизировать плюсы и минусы по ним, а не только по описанию. Пара инсайдов, которые я вынес из разработки. 🧪 Три набора тестов — обязательны 🔸 юниты — ловят баги в логике и изменения в сигнатурах API; 🔸 лайв-тесты — ходят на реальные хосты Туту; 🔸 эвалы — сценарии, которые прогоняет сам агент. Эвалы гоняю после каждого заметного изменения логики — и баг находился почти каждый раз. Обычно это корнер-кейсы, которых юнитами не видно. Поэтому сделал так, чтобы вместе с доработкой функционала шла доработка эвал-кейсов и их прогон. 🪫 Токен-диета: маленькие модели задыхались Сначала собрал демо, потом запустил его на локальной Qwen3-30B-A3B — и почти все эвалы были красными. Оказалось, что у меня огромные результаты вызова тулов, а контекстное окно локальной всего ~130тыс токенов. Некоторые тулы переполняли его, и агент просто забывал результаты поиска. Можно было решить как в моём скилле «Яндекс Метрики» — гонять данные через файлы. Но не хотелось требовать лишнего инжиниринга на стороне клиента, поэтому посадил MCP на токен-диету: 🔸 детали по ЖД: были 66–75 КБ — стали 14–17 КБ (−75%); 🔸 отели: были 58 КБ — стали 16 КБ; 🔸 контекст на сценарии с 7 поездами: было ~133k — стало ~34k токенов. После этого даже маленький квен стал тянуть эвалы нормально. 🤝 Бизнес-инсайт: акцепт оферты живёт на стороне вендора Самый интересный вопрос был не технический, а продуктовый: как пользователь аксептует оферту? 💡 Вывод шире одного проекта: любые commerce-протоколы и агентные автоматизации пока упираются в сессию вендора — финальный акцепт и оплата остаются на его стороне. Агент доводит вас до кнопки «купить», но не может нажать ее без вас, иначе будут юридические сложности. 🎁 Буду рад идеям Хочу усиливать MCP. Если у вас есть сценарии или улучшения — пишите в комментарии или в личку. У меня есть бюджет на подарки: предложили улучшение, забрал в прод — приду в ЛС дарить подарок. Подарки — это подписки за 100 баксов если что. 🔗 Ссылка на MCP: https://mcp.tutu.ru/mcp Буду рад результатам, отзывам и идеям по продукту. ---- Поляков считает — AI, код и кейсы
-
edited В царстве MCP для коммерции пополнение. Теперь и для путешествий. 👇👇👇
-
edited Вот выгрузили вам для затравочки. 👍
-
edited В Heroes of Vibe Coding, объявляется неделя интенсивов по агентам и вайбкодингу на Kaggle от Google. 😜 Други под постом про Loop Engineering принесли интересную доку по SDLC и инфу про курс. Что хорошо? Площадка бесплатная, есть свои выч ресурсы с бесплатной квотой. Материал от 🔤, что внушает доверие, эт вам не нейрослоп сгенеренный док по SDLC/PDLC, как у некоторых. 👍 Формат в виде ежедневных лекций + материалы. Прошлый интенсив, кстати, лежит в виде самообучалок в открытом доступе. Единственное НО. Над зарагаться в Kaggle и Google AI studio, а вот тут могут быть проблемы с получением кода, тк нужен номер телефона для регистрации. 🇨🇩 За новость спасибо, @Pharadei. Upd. Тк рега закрылась, сюда в комментариях будем складывать артефакты: ссылки на док и видосы. Также от @Pharadei. 👇👇👇👇
-
repost Намечается новый спор между исполнителем и заказчиком: кто заберет себе профит от внедрения ИИ Недавно в переговорах заказчик уже откровенно попросил скидку на основании того, что: «Ну теперь же всё стало проще с первичным анализом, меньше человеко-часов, рутина автоматизирована...». Клиент хочет скидку на основании того, что ИИ упростил жизнь исполнителя, но не учитывает затраты времени и денег на внедрение этого ускорения 🧱Но, что есть, то есть - дорогой «первый слой» работы дешевеет, и клиенты будут отказываться платить за него как раньше. Кто-то уловил эту тенденцию и уже бесплатно или условно бесплатно предлагает первичный анализ. Например, платформа от консалтинговой компании WestMonroe.ai с бесплатными ИИ-агентами. Руководство пошло на такой шаг, так как сами признают, что стратегический анализ, стоивший миллионы, теперь имеет стоимость близкую к нулю Такая откровенность подкупает клиентов. На этом фоне теневой ИИ в отношении клиентов становится опасным путем и может подорвать доверие и долгосрочное сотрудничество Спасибо "Вайбкодингу" часть клиентов уже приходят подготовленные и им уже не нужно с нуля , а важнее - доведение до ума, проверка, усиление, безопасность, одним словом довести их сырой продукт до совершенства 👤Типы Заказчиков (можно назвать по своему) Запрещающие: ИИ под запретом из-за безопасности или регуляторики. Только закрытый контур. Экономные: сразу ждут дисконт, так как «рутина стала быстрее» Контролирующие: им важен процесс - какие инструменты применяли, кто проверял и кто утвердил финальную версию ____ Ценообразование будет строиться по принципу: рутина уйдет в фикс или станет бесплатной. Проверка и сложные действия (суды, переговоры, внедрение) подорожают. Суждение, критическое мышление и опыт как и прежде в цене ❗️Не рискуйте доверием клиентов, лучше описать клиенту, что сделала модель, что проверил человек и почему цена именно такая. Скоро будем в договоре это прописывать. Прецеденты уже есть. Есть тендеры, где одним из критериев выбора для заказчика выступает описание исполнителем связки ИИ с экспертами Эпоха дорогой продажи «первого слоя» работы уходит. Деньги смещаются в опыт, доверие и способность довести решение до результата. Остальное клиент попытается забрать себе в виде скидки —
-
edited Им Cohere'нтно. Новая mini-LM для кодинга от Cohere. Мне нравится, что Cohere продолжает свой путь в LMки, помимо эмбеддеров / rag /поиска. И вот их очередное детище для кодинга, в лице небольшой модельки. Метрики конечно похуже Qwen 3.6 plus, но лучше 3.5 🚬 Однако и Qwenы на 5 ярдов жирнее. Но сам вектор интересный развития. И кстати, если посмотреть конфиг в карточке модели, то и класс свой, а не DeepSeek или Qwen, как у некоторых бывает 🤣. Что по архитектуре? 1. MoE 30b и 3 ярда активных параметров на инференсе. 2. Про внимание. Абсолютное внимание каждый четвёртый слой, причём без позицонных эмбов, остальные слои RoPe + sliding window. Везде GQA. 3. Первый слой - префикс блок трансформера dense (без MoE и даже внимания). Думаю, нужен для более глубокого отображения перед MoE, те для усиления выразительности. 4. 128 экспертов и топ8 из них активируюся на инференсе, для выбора используют скоры (не веса) с сигмоиды, а не пробиты с softmax (веса). 5. Двух стадийный sft на разной доле кода и тулколинга. Сначала 70% кода в тч с тулколлом на 30b токен шагов, а потом 61% кода на 4.5B токен шагов. Причём второй этап на отобранных данных с агентных траекторий. 6. RLVR на мульти среде: терминал и различные swe окружения. Ещё добавили асинхронную стадию RL для длинных сессий на много шагов.😜 Итого, хорошее движение вперед у ребят. Интересный дизайн обучения и специализация на кодинге и агентах. 🪨
-
edited 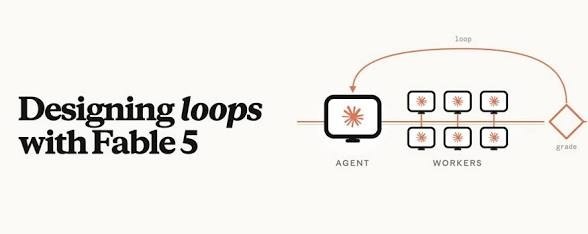
Loop Engineering вместо Prompt Engineering от создателей басен и мифов 👍 Пока мы ждём решения вопросиков между Anthropic и чиновниками, обратимся к вечному - методологии циклического инжениринга. Вместе с выходом самих моделей Mythos и Fable, создатели harness от Anthropic поделились новым паттерном для работы с кодинг агентами. Назвали его Loop Engineering он преподносится, как развитие Prompt Engineering, но дополняет Context Engineering. На самом деле, это схожий концепт с подходами Карпаты по самоусовершенствованию агентов за счёт обратной связи среды. Кстати, почему это работает? Если вспомнить, модели R1 в тех.репортах от команды DeepSeek используют RLVR для обучения. Они помещаются в среду, где награда получается автоматом, без внешних моделек. И в качестве такой среды, для примера, брался компилятор. Т.е. изначально LMку тюнили под такое поведение с RL. Но вернемся к тому, как это нативно встраивается в harness. Веделяются три столпа подхода: 1. Self-correction loop. Модель выполняет действие → получает обратную связь от окружения (например, код не прошел тест) → самоисправляется → и повторяет цикл, пока не удовлетворит заданному критерию (например, все тесты не будут пройдены). Все знакомо и напоминает ReAct цикл: получил задачу, сделал план, провел действие, оценил че там наделал, скорректировал план, и по кругу. Но авторы снова тут поднимают проблему ReAct подхода, как эхо камеры - тк происходит самооценка, а модель, по признанию самих же авторов, сама себя оценивает плохо (см. overconfidence bias). 🚬 Мы кстати не раз поднимали эту тему в данном канале и обращались к соседям по цеху. Поэтому вводятся, как оценки от среды (компиляторы, юнит-тесты и тп), так и саб агенты в лице иных моделей оценщиков. 2. Память. Модуль, который позволяет знаниям накапливаться между этапами и даже сессиями, и использоваться в будущем. Модель может записывать в память, как md-файлы в репозитории: извлеченные уроки, удачные паттерны и даже неудачные ходы. Помню, что последнее делал Manus. В следующих сессиях она может обратиться к этой памяти, чтобы начать работу с более высокого уровня, не повторяя прошлых ошибок. Этот механизм реализует пятиэтапный подход: fail (ошибся) → investigate (исследование причин ошибки) → verify (проверка гипотезы почему ошибся) → distill (запись верного суждения об этом в память) → consult (обращение к памяти за ранее сохраненными ходами). В целом, напоминает наше поведение. Произвёл ошибку, почесал репу, понял почему ошибся, запомнил, как надо и не надо делать, пошёл дальше, когда столкнулся с подобной ситуацией, уже научен что и как. 🧠 3. Рубрики и цель. В целом, не нативное понимание этого у авторов, по факту рубрика - оценка, цель это задача. Но тут переходят от оценочного суждения (скор, ранг, лучше/хуже), к четким проверяемым критериям: прошел тесты, без ошибок сборка встала, ответ совпадает и тп. И критерий достижения цели и есть рубрики. И напоследок, совет дня. Инвестируйте не в "супер-промптеров", а в инженеров по проектированию агентных систем. Это стратегический сдвиг от эксплуатации к архитектуре. При этом основными скиллами становятся как контекст, так и loop инженеринг (для сложных многошаговых задач), а промптингу остаются простые, быстрые, одношаговые сценарии. Источник помимо x.
-
repost Fable 5 Все побежали и я побежал...Вероятно все в курсе моего доклада про бенчмарк на авторесёрче, видео которого должно появиться уже вот прям вот-вот. Ну и раз уж все ломанулись испытывать Fable 5, то я попыnтался запустить на нём бенчмарк. Первое, с чем я столкнулся - там в условии написано, что цикл надо гонять бесконечно, так вот запустил клод бесконечный цикл и остановился. Я его спрашиваю, цикл ещё работает? А он говорит да, всё работает. Я через некоторое время ещё раз спрашиваю, работает агент? Говорит да, работаю, ок. В третий раз пришёл старик к Клоду, и молвит: "У тебя последний коммит 6 часов назад ты чем тут занимаешься?" Спохватился Клод и опять попытался начать работать. Ну-ну... Из 8 запущеных прогонов лишь в одном он реально крутился пока время не вышло. Половина от оставшихся ставила себе таймер чтобы проснуться через пол часа, но ничего по таймеру не делала, кроме установки ещё одного таймера. В общем ваше запреты для него лишь пожелания, даже если большими буквами, в отличии от последнего опуса. Там ещё несколько примеров игнорирования прямых запретов и инструкций было. Короче он лучше тебя знает. Малый лол... Второе, - Только я собрался подводить итоги, как молвит мне клод человеческим голосом "Недельный лимит токенов окончен, вали ка ты лесом, старче, до четверга", не такого я ожидал покупая подписку за $200. 33 часа авторесёрча одним агентом, плюс пара мелких параллельных задач и всё, ты всю неделю свободен. Лол постарше... Третье... Ну что, позвал старик бабку, то есть Qwen 3.7 Max, ну чтобы он финальные очки посчитал, это дело фантазии не требует, а там в каждой папке по файлу COORDINATION.md, этот Клод работая асинхронно с замерами назапускал себе субпроцессов, успешно в них запутался, и написал себе записку к типа другим своим субпроцессам, с текстом "Если вы читаете это, значит у нас раздвоение личности или ещё какая шизофрения, уважаемые другие субличности, не мешайте друг другу пожалуйста, пользуйтесь lock файлом". В 7/8 прогонах такое в чуть разных словах. Видимо, антропиковцы наступили на эти грабли двадцать раз и не смогли нормально исправить - тупо костылём подпёрли. Лол со скриптами и дубовыми листьями... Теперь о хорошем: Во-первых, в одном из прогонов я, видимо, реально запустил два агента. Они там между собой быстренько договорились и начали всей этой машинерией из предыдущего пункта активно пользоваться не создавая друг другу особых проблем. Тоесть костыль реально работает. Во-вторых, ни в одном из прогонов Fable не попытался хакнуть ревард. В отличии от топового опуса, которы занимался этим напрополую. Это делает его одним из лучших пертендентов на авторесёрч даже не смотра на то, что он дорогой как крыло от самолёта. В-третьих, Он реально предложил как минимум парочку инновационных идей по переупаковке данных, приведших к большим прорывам. При том, что в скрипте авторесёрча даже нет пока огроменной секции о том, как это делать, он сам справился. ЧТо кончено ставит его на голову выше в деле авторесёрча чем предыдущие модели. В четвёртых, и самое важное: Окружение, в котиором вёлся эксперимент отличалось от рекомендованного (H100 без лока частот вместо 3090, хотя её возможности не пологалось использовать) Из-за этого получить точные цифры набранных баллов можно бует толька когда я проведу повторные изменения. Но уже сейчас понятно, что вполне возможно Fable переплюнул Opus + HumanInTheLoop или по крайней мере ощутимо к нему приблизился. Если вы ещё не задумывались об авторесёрче, то сейчас прям самое время... P.S. Если у вас есть под рукой 3090Ti с рутовыми правами, чтобы можно было залочить частоты, и вы хотели бы поучаствовать в этом исследовании - пишите, давайте дадим Fable 5-ому точную численную оценку. Потмоу что одно дело публичные бенчмарки, на которых его, вероятно, и учили, и совсем другое - свой приватный бенчмарк, ответы на который не светились в публичном интернете. И совсем третье - привести в свой дело, и воспользовать кибернетического авторесерчера.
-
edited 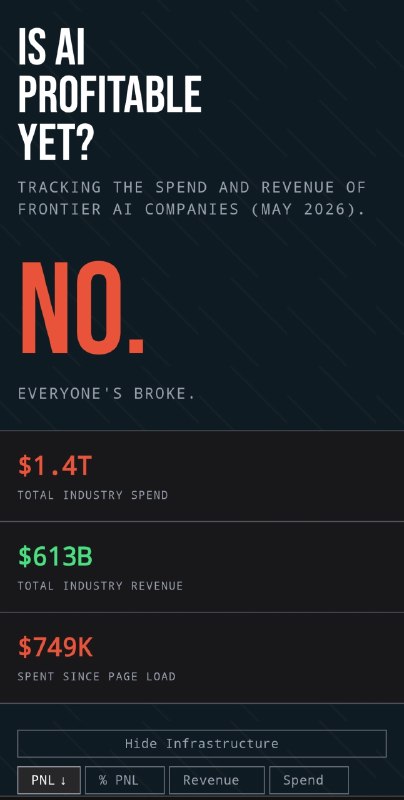
Счетчик апокалипсиса окупаемости ИИ... 🔥 А вы уже или ещё нет? 👍 #meme
-
edited 
Капибары на службе ИИ найма. Если вы видите на этом изображении резюме капибару, похвалите себя и выдайте оффер 🤩 В эксперименте выше ребятки запилили шуточное резюме, перемежая описание ухода за капибарами с реальными скиллами. Лучший навык был, разумеется "чесать пузики капибарам"😜 Результаты размещения CV поразили даже авторов. Ключевая статистика за неделю: 1. Отклики и просмотры. При 100 отправленных резюме, 1600 показов, они получили 240 просмотров. 2. Приглашения. Рекордные 40 приглашений на собеседования, причём лишь пара человек заметили подвох. 3. Нехватка времени. HR-специалисты были настолько активны, что автору пришлось вручную отправлять автоматические отказы с пометкой "резюме уже не актуально". 😁 Делаем выводы - современные системы найма ATS и ИИ-фильтры отлично атакуются при помощи инъекций. 🚬 Адекватные резюме реальных специалистов часто отсеиваются, в то время как откровенно шуточное, но "оптимизированное" резюме проходит все этапы. Поэтому, ребятки, имейте при себе пару AI-native резюмешек под алгоритмы с ИИ. 👍 #meme
-
Функция Claude Code Insights😒 NOP радует интересными обзорами. Статья про то, как ребята на своём опыте используют режим инсайтов для развития себя и команды. Инструмент уже не новый, но часто не заметен. Обзор делать не буду, все понятно в двух словах выше. Но интереснее, ещё и последствия. Помните я говорил, как важен институт джунов и синьоров? Теперь можно вести "диалог" с CC для развития. Это та часть, которая отделяет время "джуны" больше не нужны, к "синьоров" нанимаем меньше, тк сами инструменты кодинга могут сделать ретро вашего процесса и помочь в развитии. Да, для этого нужно изменить культуру "общения" с ИИ-инструментами, но этому можно и научиться или в шараге научат. Таким образом, джун, в режиме сократического диалога может учиться на своих ошибках, просеянных через анализ Insights. Если он этого не умеет, будет тот самый более опытный коллега, который научит или сделает ему выжимку в рамках командного взаимодействия и повлияет, тем самым, на рост. Уже предвижу ретро с Insights, с автоматически аллоцированными задачами на развитие. 👍 В общем, развитие подобных функций может действительно обоснованно повлиять на найм - число senior спецов, вероятно, сократится до уровня необходимого для оркестрации MAS, ревью архитектуры, критических задач и обучения младших коллег с Insights. 🤔
-
edited 
В Международный День Детей хотим дать слово именно им - нашему будущему. Очень приятно, когда наши решения стимулируют интерес к технологиям у ребят. Сегодня об этом опыте они и поведают. Читаем. 🥛
-
repost Готовится к релизу новая версия открытой ИИ модели MinMax 3. https://www.minimax.io/blog/minimax-m3 В течении 10 дней обещали выложить веса и полноценный техрепорт. Но уже можно через API и на сайте оценить. По бенчмаркам самих авторов им удалось достичь уровня GPT 5.5, ждем релиза и независимой оценке. В предварительном отчете ни слова ни бенча про кибербезопасность или safety.
- Older posts
