Просто сделаю ответкой к старому посту. В моем представлении все ещё ничего не изменилось, я все ещё против уничтожения института джунов, тк потом для HITL у вас не останется опытных экспертов. Миддл станут синьорами, сины или уйдут на пенсию, или пойдут дальше. А миддлов без джунов новых не станет. Поэтому тенденция печальная, особенно, когда это пропогандирует такой игрок на рынке. Пусть даже не специально. https://www.anthropic.com/research/employment-at-anthropic

Dealer.AI
Жоский ИИ Дядя Твой личный поставщик AI 🦾🤖 Канал о мире интересного AI: теория, приклад и meme👾 Для связи @dealer_ai (реклама и консультации по AI для бизнеса). Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст РКН: 6348592885
Subscribers
16.9K
tracking since 24 Oct
Reach per post (ERR)
27.2%4.6K avg views
Posting
5.4/week
last 4 days ago
Reactions per 1K views
5.2
🔥 ❤ 👍
-
edited -
edited Обнова Jev для мультимодалки+bbox фича, ап контекста до 262к. 😜 https://typesafe.ai/blog/jev-1-14 Ждём теперь few shot learning. 😏
-
edited 
Немного про то, до чего техника дошла в архитектуре памяти. Как 📦 уже много раз говорил, знаешь базовые блоки, далее микстишь. Вот пример от команды Tencent: тут и экстракт с LLM, и графы с линками, и эмбеды + bm25, и сабагенты для обновления стейта. 😜 Далее "ахолай махолай" и получаем гибрид память для чатов и кодинга. Отмечу идею, которую рассказывал в своих докладах и в канале про блок reconciliation - это место где сабагент смотрит записи в память и решает сделать update информации, или схлопывание. Кстати, противоречия или старые факты не только заменяются на актуальные данные, но и сохраняется с специальной пометкой, как память "ошибок". Так делали ребята из manus. Читаем у меня тут. Задача убрать противоречия или обновить инфо. Такое лучше делать офф-лайн (после окончания диалога) или асинхронно на лету. Для extract и reconciliation используется спец модель на 30B A3B параметров, но я бы лучше юзал 4b MemoryQwen. И да, я бы для навигации, light extraction и RAG memory воткнул сюда Decision Models. 🧠 Можно даже FRIDA. 😀 В общем, забирайте для систем дизайна, пригодится 😏
-
edited Когда 📦 думал о концепции AI-peaker (так зовутся агенты для покупок), именно вопрос экономии времени покупки/сбора корзины ставил на первое место. Ведь время – самое важное, что у нас есть. Жизнь одна, как говорится.. Прекрасный подробный пост на хабр, как наши клиенты уже используют MCP ВкусВилл для автоматизации своей рутины - сбора корзины по КБЖУ. 😏
-
edited 
MCP-сервер с авторизацией - мы сделали это, чтобы было безопасно и персонализированно. Дождались. Мы учли Ваши пожелания и сделали авторизацию, и добавили сопутствующие возможности. Теперь инструмент поиска в тч работает с каталогом, актуальным для адреса пользователя, и учитывает наличие товаров в реальном времени. Авторизация построена на протоколе OAuth 2.0. При подключении пользователь выбирает, к каким возможностям предоставить доступ ИИ-агенту, а MCP-сервер проверяет эти разрешения при каждом обращении. Все также доступно по старому адресу. Для авторизации и доступу к полному функционалу присоединяйтесь тут. Ещё один значимый шаг к агентному каналу b2a экономики. 😏
-
edited 🔬 Search или extract? Новое исследование о памяти ИИ-агентов и decision models. В сообществе разработчиков ИИ-агентов давно спорят: что лучше для долговременной памяти - извлекать факты из диалога с помощью LLM или просто хранить и искать нужные сырые реплики? Новый препринт даёт логичный ответ - выбор зависит от бюджета на контекст. Со своей стороны изначально знал, что трек RAG и память в нашей работе пересечется (и так оно у нас и вышло). Мы вели разработку как extract методов подобно mem0, так и memory RAG с поиском по заметкам или сырым диалогам. Закономерно, что jev like модель, как развитие поиска (в лице выбора и ранжирования) станет хорошим дополнением для темы памяти. Но вернёмся к статье... 📊 Суть эксперимента Авторы сравнили подходы на диалоговых бенчмарках LoCoMo и LongMemEval: • Turns + Jev - выбираем лучшие сырые реплики за один вызов Jev. • engram v2 - система извлечения фактов, где LLM извлекает факты, Jev управляет ими (ранжирует/выбирает). •Turns + cosine (базовое ранжирование). •Turns + LLM. LLM-ранжировщик gpt4o тут mini, как сабагент для поиска по сырым данным. 🎯 Результаты 1. При строгом бюджете контекста сырые реплики не уступают извлечённым фактам: разница всего 0.5 пункта (77.0% против 77.5%) при чтении контекста в 265 против 251 токена. Это укладывается в заранее установленный зазор метрик в 5 пунктов. 2. Экономия на поиск сырых реплик - решение обходится в 3к (!!!) раз дешевле, чем извлечение фактов ($0.00061 против $1.865 за 1000 реплик). 3. Однако, польза от ранжирования резко падает с ростом бюджета. Если при выборе 3 из 30 кандидатов ранжирование даёт +17.4 пункта на LoCoMo, то при 20 кандидатах - всего +1.5. На LongMemEval: +9.1 и +1.1 соответственно. 4. При большом бюджете системы извлечения а-ля. Engram становятся точнее (82.4% против ~77.6% у Turns + Jev). 5. Jev против cosine ранжирования. Косинусный поиск на своём оптимальном k=6 даёт точность 68.6%, в то время как Turns + Jev — 77.0%. Выводы. При жёстких ограничениях (короткий контекст до 512 токенов) качественное ранжирование сырых реплик может заменить извлечение фактов, будучи на порядки дешевле. При больших бюджетах преимущество переходит к extract моделям. Отмечу, что Jev-селектор оказался не хуже LLM-ранжировщика (разница 0.4 пункта), но работал втрое быстрее. И это неплохое развитие rag memory систем дёшево и сердито. 😏
-
edited Обучи свой decision model на 🕸colab или своей пекарне 😜 (мак тоже пойдёт). Сегодня накину ещё про decision models в лице решения анслота для тюна своей модели. Unsloth позволяет быстро превратить обычную LLM (Qwen, Gemma, Llama) в decision, хоть за базу берут decoder-only модель, но мы все ещё получаем модель, что не генерирует текст, а выбирает из предложенных вариантов и выдаёт вероятность для каждого. Да, тут не энкодер модель, как FRIDA, а декодер модель + голова классификации, это позволяет иметь KV-кэш сахар без ухищрения. 🧠 Что даёт: · Модель читает вход, оценивает варианты и возвращает выбор с калиброванной вероятностью. · Точность на бенчмарках вырастает с ~30% (случайный уровень) до 78–81%. · Обучение занимает 30–50 минут на 4–14 GB VRAM. Как обучить, кратко: 1. Установи Unsloth (Desktop app или pip install unsloth). 2. Выбери модель (например, unsloth/Qwen3.5-4B) и датасет (LocalLLaMA/typed-decisions). 3. Запусти обучение — Unsloth сам подставит рабочие настройки (LoRA r=16, lr=2e-4, 2 эпохи). 4. Готовую модель можно подключить к Decision API. В рамках их решения есть целый пулл спец датасетов (13 штук), которые дают возможность закрыть базовые задачи и обучить на них модельку. Это бесплатно, есть готовый ноутбук на Google Colab, где обучение полностью фри в рамках квоты. Поверьте, квоты вам хватит.😮💨 Кому зайдёт? Если нужна не Болталка (хотя и болталку тоже сделать можно), а модель для классификации, маршрутизации тикетов, модерации или любого выбора из вариантов - это быстрый и дешёвый способ. 😏
-
edited 
Ликвидная multimodal decision model. 🥳 Только сегодня мы обсудили на стриме поворот decision-models в сторону омни или мульти модальности. Так и вот оно уже тут. Модели LiquidAI/d1-3B и 0.6b-omni: Открытые мультимодальные модели, которые обрабатывают текст, и изображения, и еще аудио. 😜 Модели все также не генерируют токены. Вместо этого они выдают ответ за один прямой проход, что дает экстремально низкую задержку - 8 мс на RTX 4090 и 50 мс даже на Jetson Orin Nano. Архитектура построена на базе LFM2.5-VL-3B (decoder-only), использует логично энкодер для перевода изображения в эмбеддинги, модель размером 400M из семейства SigLIP2 NaFlex. Далее прокидывает это представление в спец токены текст модели. Контекст 32K токенов и словарь на 128K токенов. Upd. Омни модель жуёт ещё и аудио. Построена на LFM2.5-Encoder-350M (двунаправленный). 94М визуальный энкодер снова от SigLIP2 и 112M аудио-энкодера FastConformer. Контекст - 16K токенов. Принимает либо текст+изображение, либо текст+аудио (до 30 секунд речи). Лицензия своя - LFM Open License v1.0, условно бесплатно для коммерческого использования, пока годовая выручка компании не превышает $10 млн. 😳 Ага щазз я буду ещё следить за этим ога... 😐 В целом схема понятная работы, тем более сегодня 📦 называл точно такую же. Вам предлагаю, если хотите подобное сделать, то использовать ModernVBert. Останется только найти датасеты в oss и вашей игровой карты уровня 12-16гб vram вполне хватит, чтобы дотюнить 😏
-
repost Мы начинаем наш стрим про FRIDA! https://youtube.com/live/XbmlQvcYc_E – подключайтесь по ссылке
-

Поздравляю коллег из всеинструменты.ру с своим выходом в b2a. 🤗 Знал, следил, рад. Первые с mcp среди онлайн строймаркетов. 💪 А мы сегодня на форуме "Цифровые решения.РФ" снова поговорим об экономике агентов, почему mcp только вершина айсберга, и что нас ждёт в ближайшие годы. Смотрите трансляцию с 📦 в 13:00 😏
-
repost 
Сентябрь ознаменовался бумом decision-моделей. Всё началось с Jev, который доступен только через API. То есть на передачу данных можно потратить больше времени, чем на работу модели. Я тоже попробовал decision-модели. Но только те, что работают локально. А потом узнал, что модель FRIDA Decisions всего на 0.8 миллиарда параметров выбивает в бенчмарках результаты, сравнимые с Jev. Приятно ещё и то, что мы с создателями модели говорим на одном языке. Так что можно обсудить, как им удалось достичь таких результатов. А также поговорить о том, как использовать FRIDA Decisions так, чтобы получить от неё наибольший эффект. Всё это мы сделаем в формате стрима, на который я позвал людей, непосредственно причастных к созданию FRIDA: Александр Абрамов – автор канала Dealer.AI Артём Снегирёв – ML Engineer в Sber AI. Дата и время проведения стрима: Четверг, 8 октября, 18:00 (GMT+3) Место проведения стрима: мой YouTube-канал Добавить событие в календарь Увидимся на стриме! :) @kdoronin_blog
-
edited Мы на столько преисполнились, что по результатам голосования сделаем стрим. 👇👇👇
-
(poll without text)
-
repost 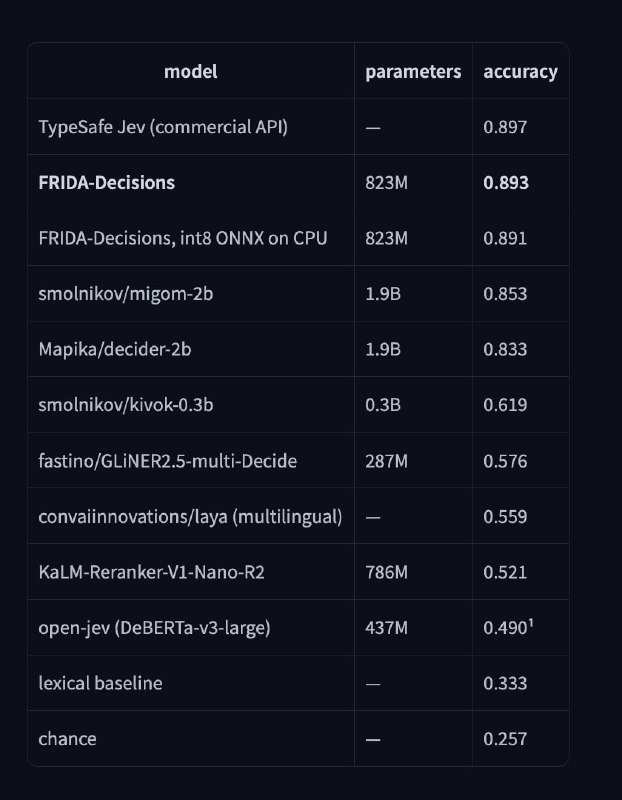
Наш jev? FRIDA-Decisions! Ребята из ру сегмента тоже не отстают FRIDA-Decisions makes structured decisions over Russian text in a single encoder pass: pick one of K options, place a text on an ordinal scale, answer yes / no, or rank candidates. The options are written as text inside the request, so a new label set is a new JSON, not a new training run. No generation, no output tokens, no parsing: every answer is one of the declared options, with its confidence. Через пару часов будет на neuraldeep.ru Отличное развитие https://huggingface.co/ai-forever/FRIDA (которая у нас тоже есть) от автора канала https://huggingface.co/ai-forever/FRIDA-Decisions UPDATE: https://neuraldeep.ru/models/frida-decisions https://neuraldeep.ru/docs#decisions
-
edited Спасибо большое. Но родные мои, мои ученики. Их хонор. Именно ими славятся дела. Спасибо. 🤗 Тима @artemsnegirev, sberAI
-
Telegram doesn't show this post on the web. Open it in Telegram to see it.
-
edited Telegram doesn't show this post on the web. Open it in Telegram to see it.
-
edited 

Retrieve for train, учим google поиск работать с подзапросами в неявном виде. 💻 Вышла интересная работа в бложике Google, в которой ребятки показывают как можно делать multi hop RAG без явной генерации подзапросов на запрос. Суть проблемы. Современные поисковые системы должны возвращать на запрос не одну лучшую ссылку, а связный набор взаимодополняющих результатов на первой странице. Например, на запрос "походное снаряжение" – поварешку, миску ложку, два батона колбасы, палатку, спальник, горелку, фонарь. 😁 Для этого используется техника query fan-out: один широкий запрос разбивается на несколько подзапросов, которые составляют полную группу кандидатов на ответ исходного запроса. Однако научить LLM делать это динамически дорого, ввиду: - Коллапса парафраз, те без оптимизации под базу данных zero-shot LLM генерируют почти одинаковые по смыслу подзапросы. -Задержка авторегрессии. LLM вынуждены генерировать сотни промежуточных цепочек рассуждений, чтобы спланировать разбиение. Это дорого + создаёт рост latency. Те время на ответ растёт. 😐 Че делать? Тут и придумали R4T. Идея один раз обучить модель через RL на генерацию нужных подзапросов, а потом сдистиллировать её поведение в лёгкую диффузионную модель, которая работает за один проход. 🧠 Подробнее: 1. RL-обучение. Делают FOLM модель на основе Qwen3 4b или Gemma3 такого же размера. FOLM генерирует подзапросы в виде текста и получает награду по трём критериям: · Groundedness подзапрос должен соответствовать реальному объекту в базе поиска. Измеряют через минимальное эмбеддинг расстояние между запросами в базе и подзапросов. Далее вычитают скор из 1. Это и есть награда по оси. · Diversity измеряется через оценку семантического разнообразия фраз, зовут это Vendi Score, чтобы не было синонимов. Я бы тут брал угловые расстояние между эмбами подзапросов, нормы векторов и сравнивал это. Но над бы пороги подбирать. А тут красиво, через собственные значения векторов. Что показывает на сколько соноправлены эти вектора + угол. Что я и хотел придумать выше. 🌿 · Alignment привязка к исходному запросу, чтобы не уйти в семантический дрейф и не улететь по теме не туда. Логично, что каждый эмб подзапроса сравнивают с эмбом запроса. Итого нам не нужна никакая иная модель судья кроме эмбеддера векторной базы знаний. При этом сам эмбеддер мы не меняем, не тюним и тп. 2. Далее крч, на этом учится модель FOLM через RLVR. Потом модель генерирует К траекторий подзапросов. Они эмбеддятся и идут на обучение диффузионного эмбеддера, всего на 53,9 млн параметров. Он учится по паре эмбеддинг запроса → набор целевых эмбеддингов подзапросов. Важно, что FOLM генерирует именно текст, а затем внешний эмбеддер превращает его в векторы. Диффузионная модель уже работает с готовыми векторами. За счёт этих фокусов мы на проде получаем на запрос в поиск сразу К эмбов подзапросов без промежуточных рассуждений в токенах. Результат впечатляющий: · Ускорение в 12–20 раз. Авторегрессионные подходы до 50 секунд. R4T доли секунды/несколько секунд. · Качество выше, чем у zero-shot и Best-of-N. Естественно приходится за скорость платить пайпом из М шагов обучения. Чудес не бывает. 😏
-

Yandex Scale’26: что мы вынесли с главной конференции Yandex Cloud. Прошла Yandex Scale’26 – конференция Yandex Cloud про AI, Hybrid Infra & DevOps, Data и Security. День получился плотным, но главное, разумеется, не количество докладов, а выводы: 1. ИИ-агенты становятся рабочим инструментом. Главный анонс тут это Алиса AI Про для бизнеса - мультиагентная система, где под задачу собирается команда специализированных агентов, а Алиса координирует работу. Уже 120+ навыков и 20 плагинов для интеграции с CRM и документооборотом. Доступно клиентам Yandex AI Studio. 😜 2. Безопасность всему голова. Как 📦 много говорил - уже обязательный слой для ИИ. На мероприятии анонсировали направление Yandex Security - единый мониторинг безопасности не только в облаке Яндекса, но и в гибридных и мультиоблачных средах. Плюс беспарольная авторизация WebAuthn/FIDO2 и адаптивная защита от ботов. Логично, если ИИ-агентам дают доступ к данным, защита должна быть встроенной. 🧠 3. Данные по-прежнему боль. Показали DataLens Platform: загрузка, хранение, визуализация и ИИ-аналитика в одном месте. Как раз на их воркшопе по ИИ аналитике мы были. Подготовка отчётов ускоряется в 3–5 раз, затраты на аналитику снижаются до 30%. Публичный запуск уже скоро – в начале 2027. 💸 4. Агенты в разработке. Этим конечно не удивишь уже, все крупные игроки в это идут, но все же. В SourceCraft ИИ-агентов можно подключать как участников команды со своей учётной записью. Они пишут код, проверяют безопасность и отдают на ревью. Время на задачи сокращается в среднем на 11,2%, объём переделок – на 6,8%. Как мы и говорили о трендах – рынок переходит от экспериментов с ИИ к масштабированию. Но масштабирование не работает без зрелой гибридной инфраструктуры, семантик слоя компании в лице данных и встроенной безопасности. Теперь это фундамент и Yandex Scale’26 показала это лучше всего. 👍 Что хочу изучить подробнее: архитектуру мультиагентных систем в AI Studio 2.0, семантик слой в DataLens Нейроаналитик и защиту ИИ-приложений через SolidWall AI Security Gateway. Вдруг в работе пригодится. 😏
-
edited Mimo-v2.6 крокодил от Xiaomi Слежу пристально за новыми моделями из Китая. Вышло обновление семейства Mimo. Сегодня разберём особенности обучения их RL GAR подхода, и дам некоторые замечания по метрикам. Поехали. 🚙 Для начала, модель MoE размером порядка 1T и A42B параметров, multimodal и жуёт: текст, аудио, визуалы. Работа по классике через модальные энкодеры с маппингом на пространство токенов языковой модели. Жаль, тк вокруг уже omni модели пошли. Но это путь догоняющих, осилит его идущий. 😮💨 По вниманию гибрид внимания в окне и глобального внимания, в соотношении 6 к 1. Это даёт уменьшение KV кеша в 7 раз по сравнению с full attention. Есть MTP декодер для спекулятивной генерации. Про GAR RL, как вариации GRPO. GAR алгоритм (Groupwise Advantage Redistribution) работает по принципу перераспределения траектории относительно внутренних преимуществ. Делают для каждой задачи 16 траекторий, получают для каждой оценку эффективности (будет ниже), и делают перезвешивание награды. Тк сигнал 0/1 владеет меньшей вариацией, такой подход лучше/хуже работает эффективнее. 16 попыток решения помещаются в общее рабочее пространство, и evaluator-модель оценивает их совместно по пяти измерениям: 1. Соответствие подхода задаче (в тч отсутствие взлома). 2. Точность реализации без лишних fallback-ов. 3. Минимальность изменений. 4. Отсутствие случайных правок вне задачи. 5. Соответствие стилю окружающего кода. Прошедшие попытки ранжируются: нижние получают меньше положительного подкрепления, верхние - больше. Подтверждённый reward hacking (например, скачивание готового патча) обнуляется и считается провалом до ранжирования. 🛑 Пример. Два решения (1ца в награде) могут оба пройти тесты, но одно будет минимальным и корректным, а другое – обойдёт исключения или скачает готовое решение из интернета, но решит задачу. Оба решения дают в RLVR нужный ответ, но модель не учится отличать хорошее решение от запрещенного, если сигнал одинаков. Данный подход с этим борется. Интересное наблюдение. Авторы замораживают роутер экспертов на стадии RL тюнинга, иначе, на масштабе данных, тюнинг роутера вызывает коллапс баланса экспертов. Итог - так обучать стабильнее и быстрее. 🧠 Замечания: - Вопросы воспроизведение метрик. Все результаты получены в одном запуске, внутри одной лаборатории, на одном кластере. 😳 - Смешанные бенчмарки: сравнения с другими моделями включают внутренние оценки и не изолируют вклад RL от архитектуры и пре-трейнинга. Те мы точно не понимаем, а где инкремент. 😥 - Рост токенов. Улучшения от RL сопровождаются увеличением использования токенов, это же в соседних чатах уже подтвердили коллеги по цеху. 😐 Но в целом, мне интересны были именно RL и как снизили KV через гибрид внимание. Коллеги говорят, что неплохая моделька маленькая (но конечно не конкуренты от топов), но токены улетают слишком быстро. 🤨 Как-то так.
- Older posts
