Anthropic выпустила Claude Sonnet 5!
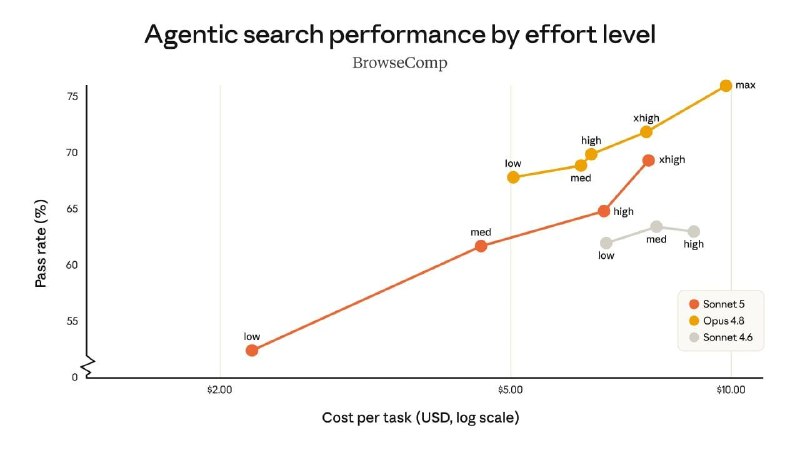
Сегодня вышел Sonnet 5 – самый «агентный» Sonnet на сегодня. Главная идея релиза не в новом потолке возможностей, а в экономике: средний тариф подтянули вплотную к флагману.
Производительность близка к Opus 4.8, но заметно дешевле. Раньше такой разрыв между линейками закрывал только Opus.
– Ощутимый апгрейд над Sonnet 4.6 по reasoning, работе с инструментами, кодингу и knowledge work.
– Автономность: по словам early-access партнёров, доводит до конца сложные задачи, на которых прежние Sonnet останавливались, и сам проверяет свой вывод без отдельной просьбы.
– Регулируемый уровень «усилия» (effort level, вплоть до xhigh) – баланс «цена/качество» теперь крутится внутри одной модели и между Sonnet 5 и Opus 4.8.
Цены
– Промо до 31 августа: $2 / $10 за млн токенов (вход/выход).
– Дальше: $3 / $15. Для сравнения Opus 4.8 – $5 / $25.
– Доступна везде: дефолт на Free и Pro, есть в Max/Team/Enterprise, Claude Code и API (claude-sonnet-5).
Но есть прикол.
– Новый токенизатор (как в Opus 4.7). Тот же текст теперь маппится в больше токенов – примерно в 1.0–1.35 раз больше в зависимости от типа контента.
– Промо-цену специально подобрали так, чтобы переход с 4.6 вышел примерно по той же стоимости. То есть после 1 сентября реальный счёт для части нагрузок вырастет сильнее, чем кажется по табличке $3/$15.
– В целом безопаснее 4.6: лучше отказывает на вредоносные запросы, устойчивее к prompt injection, меньше галлюцинаций и подхалимажа.
– По киберспособностям намеренно слабее Opus – на тесте с эксплойтами под Firefox обе Sonnet-модели не собрали ни одного рабочего эксплойта (0%).
– Запущена с включёнными по умолчанию cyber-safeguards (как у Opus 4.7/4.8).
В общем, рабочая лошадка для прода по апи, но остальное не топ уровня.
https://www.anthropic.com/news/claude-sonnet-5
Google выкатил Nano Banana 2 Lite и Gemini Omni Flash для разработчиков!
Сегодня в Google AI Studio и Gemini API приехали сразу две модели – быстрая картиночная и видео-модель из линейки Omni.
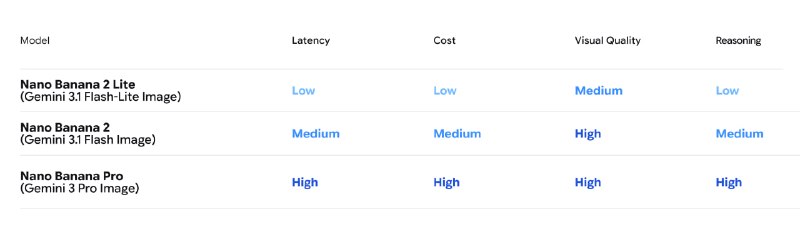
Nano Banana 2 Lite (gemini-3.1-flash-lite-image)
Самая быстрая и дешёвая модель в семействе Nano Banana. Заточена под high-throughput пайплайны, где важны скорость и цена.
– text-to-image за ~4 секунды – годится для интерактивного прототипирования
– $0.034 за картинку 1K – ощутимо дешевле старших моделей!
– сохраняет консистентность персонажей и читаемый текст внутри изображения
– позиционируется как прямая замена первой Nano Banana (gemini-2.5-flash-image): меняешь строку модели – и сразу получаешь лучше/быстрее/дешевле
Линейка теперь выглядит так: Lite (скорость, near-real-time), 2 (рабочая лошадка, баланс качества и цены), Pro (сложные профессиональные задачи, максимальный контроль и reasoning), плюс legacy-версия, которую советуют выводить из эксплуатации.
Gemini Omni Flash (gemini-omni-flash-preview)
Видео-модель с разговорным редактированием, которую показали на I/O. Теперь впервые доступна разработчикам через API и AI Studio.
– генерация и правка видео из комбинации text / image / video
– разговорный монтаж: правишь ролик естественным языком
– мультимодальные референсы для контроля над сценой
– синхронизация текста и графики с действиями в кадре
– цена $0.10 за секунду видео – столько же, сколько Veo 3.1 Fast
Ограничения честно выписаны: пока только 10-секундные ролики, нет загрузки аудио-референсов и scene extension в API, видео-референсы до 3 сек схема принимает, но модель их корректно не обрабатывает, есть проблемы с консистентностью персонажа при смене сцен.
Главная фишка – связка
Сценарий, который Google продаёт: Nano Banana 2 Lite быстро генерит картинку → отдаёшь её референсом в Omni Flash → получаешь видео. Через Interactions API можно держать историю сессии и стакать до трёх последовательных правок. Под это выкатили демо-приложения (Anywhere, Space Lift, Omni product studio), которые можно ремиксить.
Всё помечается SynthID-вотермарком.
$0.034 за изображение и $0.10/сек видео – это уже неплохо так для продакшена, можно брать!
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-omni-flash-nano-banana-2-lite/
От подписчика: Отчет Faros.ai про реальные цифры продуктивности разработки с ИИ.
Ну... Не все так однозначно...
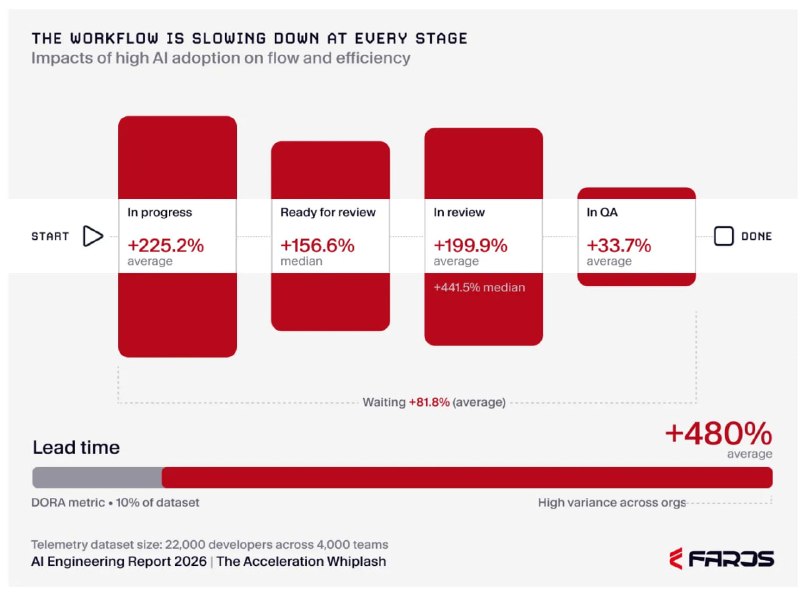
Это реальные метрики кода от требований до доставки. Выборка – 4000 команд за 2 года, сравнение внутри одних и тех же компаний между кварталом минимального и максимального использования AI.
Главные цифры:
– Продуктивность отдельного разработчика выросла, но скромно, судя по merge requests. Примерно +16 процентов, а не 10x
– При этом скорость доставки релизов упала на 11 процентов. Это системная метрика, она про доставку ценности клиенту
– Поток замедлился на каждом шаге. Фича проходит каждый этап на 80–480 процентов дольше
– Качество просело резко: дефекты вверх, переоткрытые тикеты вверх, code churn (доля переписанного кода) – аномальные 861 процент
Узкое место сместилось в ревью. Стадии Ready for Review и In Review раздулись, а ревью стали пропускать на 31 процент чаще – классическое поведение людей на бутылочном горлышке. Сам Faros пишет прямо: организации генерируют больше кода, чем система способна отревьюить и смержить.
Автор гоняет данные через закон Литтла (L = λW). Если лид-тайм и WIP растут быстрее, чем заявленная продуктивность – значит скорость потока на самом деле падает. По его расчётам реальная пропускная способность просела на 8–70 процентов в зависимости от допущений. То есть «продуктивность индивидуального разработчика» и «поток готовых фич» поехали в разные стороны, а платят клиенты именно за второе.
Тойота в своё время победила американский автопром фанатичным фокусом на качестве и принципе «не передавай дефект на следующую станцию». Чем позже находишь баг, тем дороже он стоит системе. LLM делают ровно наоборот: впрыскивают больше дефектов на входе и переносят их отлов в ревью, где ловить дороже и хуже.
Любопытная деталь: гипотеза «AI усиливает сильных» не подтвердилась. High-performing команды деградируют так же, как все остальные.
Тут есть с чем спорить по методологии – это наблюдательное исследование, не причинно-следственное, и автор сам это признаёт. Но направление мне кажется честным и совпадает с тем, что многие из нас чувствуют на практике: индивидуальная скорость растёт, а на уровне организации профита не видно.
Главная мысль, productivity не равно value. Локальный разгон одного этапа не двигает систему, если узкое место в другом месте. Если внедряешь AI в команду и не перестраиваешь ревью и QA под возросший объём генерации – ты просто переносишь бутылочное горлышко вниз по потоку и копишь work in progress.
И отдельно зацепил тезис про «сначала черновик от LLM, потом доработаю». Автор считает, что это задом наперёд: первый черновик – это и есть твой интеллектуальный вклад, момент, когда ты реально продумываешь структуру. LLM сильна как редактор и спарринг после, а не вместо мышления. С этим скорее согласен - чем больше вложений на первых этапах, тем лучше результат. Короче, уделяйте МАКСИМАЛЬНОЕ внимание требованиям, а не пытайтесь зафигачить 100 фич и отдать все тестировщикам.
Источник: https://unessays.substack.com/p/talk-is-cheap
OpenAI представила новые модели - GPT 5.6!
И закрыла их тут же по распоряжению правительства.
– Sol – флагман, самая сильная модель
– Terra – сбалансированная для ежедневных задач, на уровне GPT-5.5, но в 2 раза дешевле
– Luna – быстрая и самая дешёвая
Что нового:
– Режим reasoning effort max – максимум времени на глубокие рассуждения
– Режим ultra – подключает субагентов, выходя за рамки одного агента (multi-agent из коробки). Как ultracode.
– Terminal-Bench 2.1: Sol Ultra 91.9%, Sol 88.8% – новый SOTA на CLI-задачах, даже выше Mythos.
– Заметный рост в биологии (GeneBench) и кибербезе
Цены за 1M токенов:
– Sol – $5 вход / $30 выход
– Terra – $2.50 / $15
– Luna – $1 / $6
Плюс предсказуемое кэширование (минимальная жизнь кэша 30 мин)
Sol будет работать на Cerebras до 750 ток/сек в июле!
Но как теперь понятно модель настолько сильна в кибербезе (на ExploitBench конкурирует с Mythos Preview, тратя ~1/3 токенов), что компания согласовала запуск с правительством США и стартует только для узкого круга проверенных партнёров.
Короче, как в меме: модели не продают, только показывают красивое...
https://openai.com/index/previewing-gpt-5-6-sol/
Интересный проект по сбору всех официальных юридических документов разных стран (попытка спарить все что есть официальное): официальные юридические доки обновляются регулярно с трекингом правок, кейсы - добавляются в базу. Есть MCP, можно искать данные и извлекать нужные документы - https://legaldatahunter.com/mcp
Пока смогли получить доступ к 58% источников. Можно законтрибьютить и помочь проекту например своим способом получения данных, но код скриптов под AGPL, то есть нельзя в коммерческом проекте использовать потом. В целом для каких-то AI Legal тем должно быть супер полезно
https://legaldatahunter.com/
Gemini 3.5 Flash получил computer use из коробки
Ну и очередной наезд на всякую автоматизацию "неавтоматизируемого" - более дешевый Computer Use. Google встроил агентное управление компьютером нативно в основную Flash-модель. Раньше это была отдельная Gemini 2.5 computer use – теперь зашито прямо в 3.5 Flash.
– Агенты видят экран, рассуждают и действуют в браузере, на мобильных и десктопе
– Заточено под enterprise: непрерывное тестирование софта, рутина в проф-приложениях, всякие долгосрочные выполнения задач.
– По OSWorld – лучший результат Google на сегодня
Борются против prompt injection: специальный тренинг модель плюс два опциональных механизма – подтверждение необратимых действий и авто-остановка при всяких подозрениях на вредоносные инструкции.
Главное тут – не сам computer use (он уже у всех), а то, что Google кладёт его в дешёвую Flash, а не в топовую модель. Топят, что агентная автоматизация должна быть быстрой и дешёвой, иначе тестирование и автоматизация экономически не сходятся. Удар ровно по поляне UiPath (которая удивительно их первый партнер).
Демо: gemini.browserbase.com (надо региться)
Инфа: blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-computer-use-gemini-3-5-flash
Н-да, подорожание памяти добралось и до Apple. С сегодняшнего дня все выросло на 100-1000 баксов...
MacBook Neo: $699 (up from $599)
13-inch MacBook Air: $1,299 (up from $1,099)
15-inch MacBook Air: $1,499 (up from $1,299)
M5 MacBook Pro: $1,999 (up from $1,699)
M5 Pro MacBook Pro: $2,499 (up from $2,199)
M5 Max MacBook Pro: $4,099 (up from $3,599)
iMac: $1,499 (up from $1,299)
M4 Max Mac Studio: $2,499 (up from $1,999)
M3 Ultra Mac Studio: $5,299 (up from $3,999)
iPads
iPad: $449 (up from $349)
11-inch iPad Air: $749 (up from $599)
13-inch iPad Air: $949 (up from $749)
11-inch iPad Pro: $1,199 (up from $999)
13-inch iPad Pro: $1,499 (up from $1,299)
iPad mini: $599 (up from $499)
More products:
Apple TV 4K: $199 (up from $129)
HomePod: $349 (up from $299)
HomePod mini: $129 (up from $99)
Vision Pro: $3,699 (up from $3,499)
https://9to5mac.com/2026/06/25/apple-price-increases-mac-ipad-more/
Посмотрел, что ещё там нового у Artificial Analysis. Выкатили Speech to Speech Index – первый сводный бенчмарк для нативных голосовых моделей
Не STT и не TTS по отдельности, а сквозное «голос в голос». Индекс собран из трёх датасетов с равными весами, модель попадает в рейтинг только если есть валидные результаты по всем трём:
– Big Bench Audio – рассуждения на слух (1000 вопросов: логические ошибки, навигация, счёт объектов, правда-ложь)
– Full Duplex Bench – динамика диалога: паузы, перехват хода, перебивания, угу-ага на фоне.
– 𝜏-Voice – агентные задачи: обслуживание клиента в сценариях авиалиний, ритейла и телекома
Кто наверху по качеству
– OpenAI GPT-Realtime-2 (High) – 77.2%
– xAI Grok Voice Think Fast 1.0 – 75.7%
– GPT-Realtime-1.5 – 72.0%
– Google Gemini 3.1 Flash Live Preview (High) – 69.5%
Где реально больно:
𝜏-Voice (агентные сценарии) – самое слабое место с большим отрывом. Grok впереди с 52.1%, GPT-Realtime-2 (High) – 39.8%, и вообще все модели ниже 53%. То есть «поговорить» научились хорошо, а довести клиентскую задачу до конца голосом – пока нет. Reasoning при этом плотно упёрся в потолок: Grok – 97.1%.
Скорость (TTFA, время до первого аудио)
– Deepslate Opal – 0.44s (но индекс всего 62.1%)
– GPT-Realtime-1.5 – 0.82s
– Grok Voice Think Fast 1.0 – 1.25s
– GPT-Realtime-2 (High) – 2.33s
– Gemini 3.1 Flash Live (High) – 2.98s
Цена (за час входного аудио)
– Gemini 3.1 Flash Live (Minimal) – $1.50
– Gemini 3.1 Flash Live (High) – $1.75
– Grok Voice Think Fast 1.0 – $3.00
– GPT-Realtime-2 (High) – $4.14
Хорошо, что наконец появился сводный индекс именно для нативного S2S, а не зоопарк из отдельных метрик распознавания и синтеза. Но пока от выбора качество–скорость–цена никуда не деться. Топовый GPT-Realtime-2 одновременно самый умный, один из самых медленных (2.33s) и самый дорогой ($4.14). А Gemini Flash в Minimal стоит копейки и стартует быстро, но проседает по качеству до 56.6%.
Полная разбивка: artificialanalysis.ai/speech-to-speech
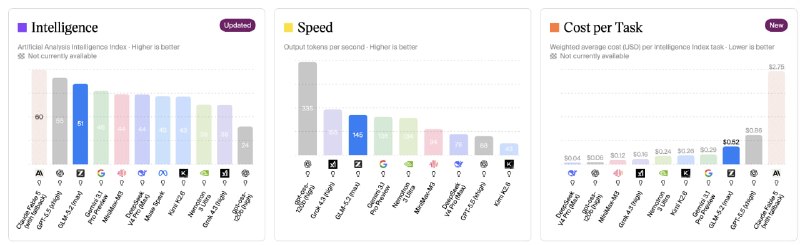
Вышли независимые замеры GLM-5.2 и вау, она в топ-3 по основным бенчмаркам, в том числе по интеллекту и кодингу, обойдя в том числе свежую Gemini-3.5-Flash от гугла и весь прочий опенсорс.
Удивительно, конечно, как в условиях ограничений по GPU и практически минимального бюджета ребята создали одну из ведущих моделей.
https://artificialanalysis.ai/models/glm-5-2
edited
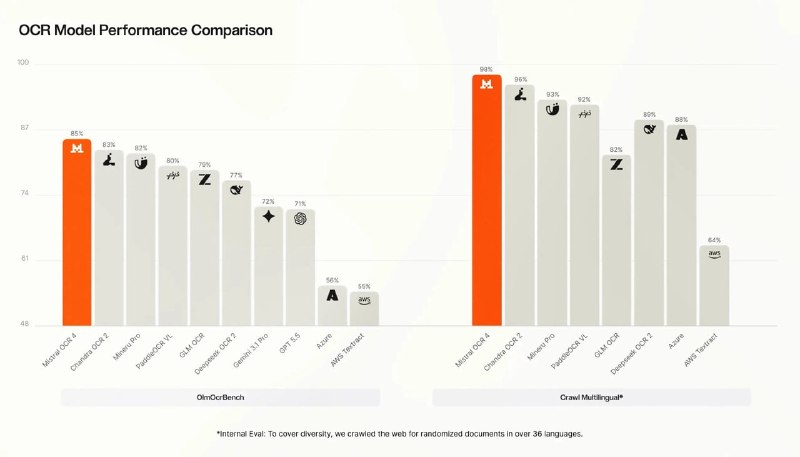
Ну и еще скорее сохранить себе на будущее – вышли 2 новые модельки для распознавания документов (OCR) – Mistral 4 и Baidu UnlimitedOCR. Распознавание документов все еще в топе юзкейсов и наверное самая частая задача бизнеса до сих пор. В последнее время выигрывает комплексный подход (и на эту тему делаем продукт), но и голые модели тоже совершенствуются как не в себя (потому что правильная инфа из документов/книг нужна и самим лабораториям)
Mistral OCR 4.
– Главная фича – bounding boxes + классификация блоков (заголовки, таблицы, формулы, подписи) + confidence-скоры на уровне страницы и слова. То есть на выходе ты знаешь не только что написано, но и где это лежит, какую роль играет и насколько модель уверена. Наконец-то блин сделали нормальный OCR по классике, а не игры в "самую лучшую LLM для распознавания")
– 170 языков в 10 языковых группах, с упором на то, что на редких языках конкуренты деградируют, а она держит точность. Ну русский 100% входит в список топовых, по нему миллионы документов доступны в датасетах.
– Влезает в один контейнер, можно self-host. Но условий нет. Скорее всего дорохо.
– Цена: $4 за 1000 страниц через API, $2 в батче, $5 за Document AI поверх (Плюс JSON-схема сверху).
– OlmOCRBench 85.20, OmniDocBench 93.07, human-preference win rate ~72%. Я все еще не сильно верю в метрики Mistral (уже несколько раз обманывали), но посмотреть точно стоит. Кстати они разобрали, что половина "ошибок" в бенчмарках - это всякие артефакты разметки, формул и порядка блоков, так что вполне возможно качество уже ближе к 90-98%, но надо тестить.
Baidu Unlimited-OCR
Суть - парсить длинные многостраничные документы за один проход, а не нарезать постранично и потом склеивать.
Может впихнуться в 8GB VRAM или пожаться до 2GB и прям локально запускаться.
Они там нашаманили кэш (Reference Sliding Window Attention (R-SWA)), так что память не растет даже при 1000-страничных документах, отсюда и название. Ну и на OmniDocBench заявляют те же 93% (как у Mistral), а китайцам тут я верю гораздо больше. Короче, для локальной работы возможно будет кандидат №1.
https://mistral.ai/news/ocr-4/
https://github.com/baidu/Unlimited-OCR
Фух, вернулся из отпуска практически без интернета.
Думал, что за эти 10 дней все на Mythos 5 накодят миллионы вещей, а Anthropic из-за паники в США закрыл всем доступ, хах :) Удивительная конечно предвзятость к Anthropic.
Сегодня вот OpenAI тихо обновили GPT-5.5-Cyber и улучшили результаты на CyberGym (теперь даже выше Mythos), но никто доступ к ней не закрывает – наоборот, раскатывают на все большее количество компаний и встраивают в партнерские предложения: CrowdStrike, Cloudflare, Palo Alto, Wiz и еще пару десятков.
Плюс сделали Codex Security: плагин, который не просто сыплет алертами, а строит threat model, проверяет, достижим ли уязвимый код, генерит и тестит патч. За время превью сделали 30M коммитов в 30K+ репозиториях.
И придумали активность Patch the Planet (напоминает песню "Heal the World" Майкла Джексона): финансируют ресёрчеров чинить опенсорс. 30+ проектов на старте – cURL, Go, Python, Sigstore, pyca/cryptography.
Короче, правильный маркетинг про "кибербезопасность и защиту" и теперь OpenAI раздаёт даже еще более мощную по кибербезу модель через партнёров и через Trusted Access целым странам (Австралия, Канада, Франция, Германия, Япония, Корея, EU/ENISA, UK).
Кстати Codex Security plugin уже можно подключать в свой код бесплатно без смс - https://openai.com/daybreak/codex-security-plugin/
А секьюрити версию ChatGPT - да, только по разрешению.
В общем, не знаю, кажется Anthopic как-то плохо умеет договариваться с правительством. Ну или нас скоро ждет цифровая сегрегация, где люди с "неправильным паспортом" действительно не получат доступ к самым мощным моделям...
https://openai.com/index/daybreak-securing-the-world/
Прикольно. Semianalysis решили максимально загрузить подписки, выжирать недельные лимиты длинными запросами и посчитать, сколько токенов можно выжать из разных тарифов.
В итоге в Claude - от 20 до 40 раз больше! ChatGPT - от 35 до 70 раз больше!
https://x.com/SemiAnalysis_/status/2064815044085318040/photo/1
edited
Что меняют AI-агенты в работе людей
Harvard + Perplexity выпустили статью на основе продакшн-данных Perplexity Computer (типа Claude Cowork) против обычного Search. Результаты красноречивые.
– Взяли 10 000 пар сессий с почти идентичными стартовыми запросами от одних и тех же пользователей: одна и та же задача через Search и через агента
– Период – 3 месяца, февраль–май 2026
– Время и стоимость считали тремя независимыми способами: по токенам, через LLM-оценку и интервью с пользователями
Итого:
– Агент выполняет 26 минут автономной работы за сессию против 33 секунд у Search – разрыв в 48 раз
– Время выполнения задачи: 269 минут (человек + Search) против 36 минут (человек + агент) – экономия 87% времени и 94% стоимости(!)
– Качество не падает, а растёт: недовольных фолоу-апов у агента 1.3% против 2.9% у Search
– Чтобы конкурировать с агентом по стоимости, профессионал должен делать всю ручную работу быстрее 20 минут
Короче, если ты не чатишься, а делегируешь задачу агенту, ты работаешь примерно в 10 раз эффективнее.
Самое интересное – расширение возможностей:
– Пользователи агента на 9 п.п. чаще выходят за пределы своей профессии. У менеджеров +19 п.п.
– 50% запросов к агенту – уровень создания нового по таксономии Блума (против 26% у Search)
– Запрос к агенту требует экспертизы в 2.4 доменах знаний против 1.74 с поиском – то, что раньше требовало координации специалистов, теперь делает один человек
– 23% запросов к агенту – задачи, которые те же пользователи никогда не направляли в Search: разработка софта, документация, визуализация данных
– У агента выше фиксированная стоимость (надо нормально сформулировать задачу и проверить результат), но ниже маржинальная стоимость шага ($0.16 против $2.05). Поэтому короткие вопросы остаются в чате, а длинные многошаговые задачи мигрируют к агентам. Чем длиннее задача – тем больше выгода.
В общем, подтвердили научно, что человек превращается из оператора в супервайзера. Узким местом была не информация (её решил поиск), а выполнение работы – и именно её агенты снимают. Практическое следствие для бизнеса: ценность смещается от умения делать к умению ставить задачу и верифицировать результат. И отдельно – цифра про 23% «новых» задач намекает, что агенты не просто ускоряют существующую работу, а создают спрос на ту, которую раньше никто не делал, потому что было дорого. И это уже ROI другого порядка, не просто экономия от рутины.
Вот статья: arxiv.org/abs/2606.07489
Новые модельки от Anthropic! Claude Fable 5 и Claude Mythos 5.
Fable – версия для всех, а Mythos – почти та же модель, но без части ограничителей, поэтому пока только для киберзащитников, инфраструктурных партнёров и потом, возможно, для отдельных биомедицинских исследователей.
– Fable 5 доступен всем уже сейчас. Anthropic пишет, что это их самая сильная общедоступная модель: кодинг, аналитика, vision, наука, длинные автономные задачи – всё стало заметно лучше.
– Mythos 5 – та же базовая модель, но с ослабленными safeguard'ами в отдельных областях. В основном это нужно для defensive cyber и сложной научной работы. То есть не “модель для всех хакеров”, а “модель для тех, кому Anthropic доверяет ломать не туда”.
– На всякие опасные вопросы срабатывает гард и отвечает слабая моделька.
– Для кодинга звучит мощно. Stripe якобы прогнал миграцию по Ruby-кодовой базе на 50 млн строк за день вместо двух месяцев работы команды. Cursor/GitHub/Replit тоже хвалят именно long-horizon coding – когда модель не просто чинит один файл, а долго держит контекст, план и цель.
– Для BI/аналитики тоже интересно: Hebbia, IMC и Numbers Station говорят про сильный скачок в finance reasoning, таблицах, графиках и длинных аналитических задачах. Вот это как раз ближе всего к реальному бизнес-юзу: не “напиши стишок или посчитай буквы”, а “разбери 40 документов, таблицы, графики и не потеряй нить”.
– Vision стал заметно сильнее. Anthropic отдельно пишет про извлечение точных чисел из научных графиков, восстановление web app source code по скриншотам и даже прохождение Pokémon FireRed почти только по картинке.
– Цена такое себе: $10 за миллион input tokens и $50 за миллион output tokens. Не дёшево, но если модель реально закрывает long-running задачи за меньшее число попыток, то экономика может быть лучше, чем у более дешёвых моделей, которые 5 раз ломаются по дороге.
– На Pro/Max/Team/Enterprise Fable 5 временно включён без доплаты до 22 июня. Потом уберут из обычного доступа и будут давать через usage credits, пока не разберутся с capacity. Перевод: “попробуйте быстро, пока не стало больно”. Я так понимаю потом можно будет включать только по праздникам :)
Короче, готовятся к IPO. По метрикам крутяшка, надо пробовать и писать 100500 саасов, пока есть доступ :)
https://www.anthropic.com/news/claude-fable-5-mythos-5
edited
Вау-вау, Speech-2-speech Translation от Google!
https://youtu.be/TNwKs39uSVk
70 языков. Доступно в API, примерно 2 бакса в час (!) Встроено в Google Meet и Google Translate. Офигеть!
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-live-3-5-translate/
OpenCV обновилась до версии 5.0
Впервые за 8 лет! Это по сути махина обработки задач компьютерного зрения: от поиска дефектов деталей в видеопотоке или людей без шлемов до распознавания номеров авто для шлагбаумов и управления роботом мимикой. Практически все риалтайм решения работают на ней.
Главная боль прошлых версий: библиотека умела почти всё, кроме одного – запускать современные AI-модели. На практике это означало, что для каждого нового сценария команда докупала или прикручивала отдельные инструменты, тратила недели на интеграцию и часто упиралась в «эта модель тут просто не работает».
В новой версии это закрыли. Что меняется для бизнеса:
– Одна бесплатная библиотека теперь делает то, ради чего раньше держали три-четыре разных инструмента (часть из них платные).
– Работает на обычных процессорах, без дорогих видеокарт. На тестах новый движок не просто догнал платные аналоги, а местами обгоняет их на 30%+ – на обычном железе.
– Крутится где угодно: от облачного сервера до телефона и недорогой embedded-платы. Можно дёшево разворачивать «зрение» прямо на устройствах – камерах, терминалах, оборудовании, – а не гонять всё через дорогое облако.
Что становится возможным с обновлениями:
– поиск объектов по описанию словами. Не «обучи модель распознавать конкретно эту коробку», а буквально «найди на полке все бутылки» – без отдельного дообучения под каждый случай.
– «картинка на входе – текст на выходе». Система может описать, что на фото, ответить на вопрос по изображению, вычитать и поправить распознанный документ. Полезно для каталогизации товаров, модерации контента, обработки документов.
– удаление объектов с фото в один шаг. Стираешь лишнее с изображения, фон достраивается сам – прикладная вещь для маркетинга, маркетплейсов, медиа.
– языковые модели прямо внутри. Небольшие LLM можно запускать там же, не строя отдельную тяжёлую инфраструктуру. Это не замена большому чат-боту, но достаточно для подписей, OCR и точечных задач.
Короче, контроль качества на производстве, инвентаризация по фото, обработка документов, аналитика по видео с камер – всё это становится дешевле в реализации.
https://opencv.org/opencv-5/
WWDC 2026: что показала Apple
Вчера Apple провела свою главную конференцию для разработчиков и показала, какими станут iPhone, iPad и Mac этой осенью. Ну-уу... Apple чуть догнала всех остальных по ИИ. Siri поумнела и Apple впервые открыла свой ИИ для других.
– Появилось отдельное приложение Siri, где все разговоры собраны в одном месте – можно начать вопрос на iPhone и продолжить на iPad, закрепить нужные беседы. Привет Claude/Codex.
– Голос Siri можно настроить под себя – высота, скорость, тон, акцент
– Siri AI появится и в CarPlay – можно спросить за рулём, не отрывая рук apple
– Visual Intelligence теперь не только на iPhone, но и на Mac, iPad и Vision Pro – наводишь камеру или делаешь скриншот, и можно спросить про то, что видишь
– Среди новых действий в камере – разделить счёт в ресторане с друзьями, узнать состав и калорийность блюда, быстро добавить карту в Apple Wallet
– Spatial Reframing позволяет сдвинуть точку обзора, изменить угол или приблизить кадр уже после того, как снимок сделан – будто переставляешь камеру в момент съёмки (вот это самая прикольная штука - https://www.youtube.com/shorts/XTpKUo_L_-w?feature=share)
– Инструмент Extend расширяет края кадра, а улучшенный Clean Up убирает даже крупные объекты с фото (наконец-то не будет всякую жесть там рисовать)
– Call Context: когда звонишь, например, в авиакомпанию, телефон сам подтягивает нужную информацию из почты – код подтверждения например. Странно, что такое Google не сделал первым.
– Live Translation переводит переписку в Messages, показывает живые субтитры в FaceTime и переводит звонки в приложении Телефон и разговоры через AirPods
– Safari сам группирует вкладки по темам, а функция Notify Me следит за страницей и сообщает, когда что-то изменилось – например, упала цена или товар снова в наличии
– Приложение «Пароли» находит слабые и скомпрометированные пароли и меняет их за вас в одно касание
– Команды (Shortcuts) и события календаря теперь можно создавать обычным описанием словами – «когда я ухожу с работы, напиши Педро, что я еду»
– Siri AI выйдет сначала только на английском и позже в этом году; в Евросоюзе на iOS и iPadOS поначалу её не будет.
– Часть фишек (настройка голоса Siri, улучшенная диктовка) требует iPhone 17 Pro/Air или Mac/iPad с чипом посвежее и от 12 ГБ памяти
– Новая Siri и весь «умный» функционал Apple теперь работают на моделях, которые Apple сделала вместе с Google на основе их Gemini.
– Приложения на айфоне смогут использовать не только ИИ от Apple, но и "встроенный" Claude, Gemini и других – то есть программы, которыми вы пользуетесь, смогут стать заметно умнее.
– Небольшие разработчики смогут встраивать мощный ИИ в свои приложения бесплатно – раньше за это надо было платить за облако, теперь если зарабатываешь меньше миллиона в год - можешь использовать ИИ в облаке Apple. Это прям хорошая заявка на интерес разработчиков.
– Теперь можно будет просто попросить Siri что-то найти или сделать прямо внутри приложения – например, «забронируй столик» или «покажи мои заказы», и она сама откроет нужное и выполнит. Действует, если разработчик сам поделился контентом приложения и инструментами через spotlight. В принципе, бОльшая часть уже это делала для поиска и шорткатов.
– Ну и в xcode теперь доступны ИИ-ки от Anthropic, Google, OpenAI. Возможно будет чуть удобнее.
– Из прикольного, стеклянный дизайн Liquid Glass допилили, и теперь в настройках появится ползунок прозрачности — можно будет настроить, насколько «прозрачным» выглядит интерфейс. То есть можно выключить вообще :)
В общем, как-то не зацепило особо ничего... Но выглядит симпатично.
https://www.apple.com/apple-intelligence/
edited
Какой ИИ лучше всех переводит живую речь?
Как раз делал подобные сравнения сам. Sony вместе с Университетом Карнеги-Меллона прогнали кучу ИИ-шек для перевода речи (как одиночных моделей, так и воркфлоу) через единый тест и, главное, дали живым людям послушать и выбрать, где звучит лучше.
Сразу спойлер: одного победителя на все случаи нет. Но по задачам всё довольно понятно.
Если упростить, есть два подхода:
– «Всё в одном» – одна модель делает весь перевод целиком
– «Конвейер» – несколько отдельных инструментов по цепочке: сначала распознать речь, потом перевести текст, потом озвучить
Кто в чём хорош
– Когда важна точность (медицина, серьёзные разговоры) – выигрывает «конвейер». В медицинских диалогах люди выбирали его в 70% случаев: отдельный переводчик текста оказался надёжнее, чем «всё в одном». Это Whisper+Gemma3+CosyVoice
– Длинная речь и подкасты – один из «конвейеров» при переводе на английский однажды сравнялся с живым переводчиком. Это вообще единственный момент за весь тест, когда машина догнала человека. Это Voxtral+Chatterbox
– Натуральность голоса (чтобы не звучало как робот) – тут лучше модели «всё в одном» и лидер - Qwen3-Omni
– Универсальность – самый ровный результат на разных языках показала Qwen3-Omni от Alibaba. Она же единственная из «всё в одном», кто хоть где-то обошёл «конвейер».
Кто разочаровал
Seamless от Meta. И по цифрам, и по мнению людей он оказался последним – ни разу не занял первое место ни в одной задаче.
Короче, пока реального человека end-2-end переводчики не заменяют. А «конвейеры» спотыкаются на редких языках вроде корейского или хинди – там слабый «озвучиватель» тянет вниз весь результат.
🔗 arxiv.org/abs/2606.03241
В Anthropic Cowork в 2 раза увеличили лимиты на месяц (вот что кластер видюх от Маска делает)
Две интересные библиотечки недели: код-ревью от Alibaba и поиск уязвимостей от Anthropic
1. Alibaba open-code-review – AI-ревьюер кода
Обкатан на масштабе Alibaba, и это не просто промпт "сделай код-ревью, make no mistakes", там детерминированные пайплайны + агент, а не голый промпт. Плюс агент умеет читать файлы целиком, искать по базе, заглядывать в другие изменённые файлы (code_search, file_read, file_find). И есть встроенный набор правил под классы багов: NPE, потокобезопасность, XSS, SQL-инъекции; правила проверяются по четырёхуровневой цепочке приоритетов
https://github.com/alibaba/open-code-review
2. Anthropic defending-code-reference-harness – автономный поиск уязвимостей
Это типа "образец реализаци", показывает петлю recon → find → verify → report → patch. Ищет проблемы с памятью в С/С++, но типа легко меняется под вашу предметную область.
– Recon-агент сначала размечает кодовую базу на подсистемы, чтобы параллельные find-агенты не сходились на одном поверхностном баге или уязвимости
– Find-агенты в изолированных контейнерах эмулируют входные данные, запускают код, итерируют, пока краш не воспроизведётся
– Отдельный grade-агент верифицирует каждый краш в чистом контейнере
– patch генерит фиксы и прогоняет их через "лестницу" проверок: собирается, исходный PoC больше не падает, регрессии проходят, свежий агент заново атакует пропатченный бинарь. Никаких больше людей...
https://github.com/anthropics/defending-code-reference-harness


 +1