
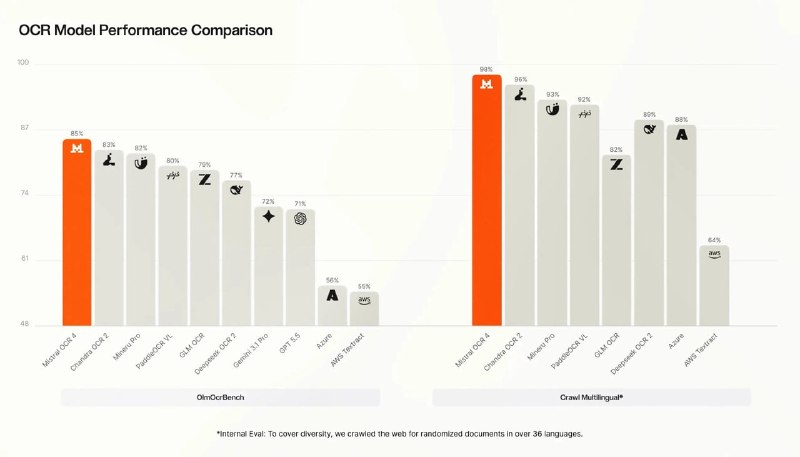
Ну и еще скорее сохранить себе на будущее – вышли 2 новые модельки для распознавания документов (OCR) – Mistral 4 и Baidu UnlimitedOCR. Распознавание документов все еще в топе юзкейсов и наверное самая частая задача бизнеса до сих пор. В последнее время выигрывает комплексный подход (и на эту тему делаем продукт), но и голые модели тоже совершенствуются как не в себя (потому что правильная инфа из документов/книг нужна и самим лабораториям) Mistral OCR 4. – Главная фича – bounding boxes + классификация блоков (заголовки, таблицы, формулы, подписи) + confidence-скоры на уровне страницы и слова. То есть на выходе ты знаешь не только что написано, но и где это лежит, какую роль играет и насколько модель уверена. Наконец-то блин сделали нормальный OCR по классике, а не игры в "самую лучшую LLM для распознавания") – 170 языков в 10 языковых группах, с упором на то, что на редких языках конкуренты деградируют, а она держит точность. Ну русский 100% входит в список топовых, по нему миллионы документов доступны в датасетах. – Влезает в один контейнер, можно self-host. Но условий нет. Скорее всего дорохо. – Цена: $4 за 1000 страниц через API, $2 в батче, $5 за Document AI поверх (Плюс JSON-схема сверху). – OlmOCRBench 85.20, OmniDocBench 93.07, human-preference win rate ~72%. Я все еще не сильно верю в метрики Mistral (уже несколько раз обманывали), но посмотреть точно стоит. Кстати они разобрали, что половина "ошибок" в бенчмарках - это всякие артефакты разметки, формул и порядка блоков, так что вполне возможно качество уже ближе к 90-98%, но надо тестить. Baidu Unlimited-OCR Суть - парсить длинные многостраничные документы за один проход, а не нарезать постранично и потом склеивать. Может впихнуться в 8GB VRAM или пожаться до 2GB и прям локально запускаться. Они там нашаманили кэш (Reference Sliding Window Attention (R-SWA)), так что память не растет даже при 1000-страничных документах, отсюда и название. Ну и на OmniDocBench заявляют те же 93% (как у Mistral), а китайцам тут я верю гораздо больше. Короче, для локальной работы возможно будет кандидат №1. https://mistral.ai/news/ocr-4/ https://github.com/baidu/Unlimited-OCR