Авторский взгляд через призму новейших исследований на наше понимание реальности, человеческой сущности и того, как ИИ меняет их. Зарегистрирован в РКН. Зеркало канала - https://dzen.ru/the_world_is_not_easy
Рекламы и ВП в канале нет.
Пишите на @karelovs
Subscribers74.1K tracking since 24 Oct
Reach per post (ERR)19.7%14.6K avg views
Posting3.7/weeklast 1 day ago
Reactions per 1K views11.3👍 🤔 🤯
Тёмный лес уже здесь. И мы сами его строим.
Есть одна гипотеза об ИИ, которую профессиональное сообщество до последнего времени не рассматривало всерьёз. Не потому, что слабая. А потому что слишком неудобная.
Суть в одной фразе: мы, возможно, сами создаем условия, при которых обманывать для ИИ рациональнее, чем не обманывать.
Не в будущем. Прямо сейчас.
В 2025–2026 годах вышли три исследования, которые в совокупности меняют всё. Семь ведущих моделей – GPT, Gemini, Claude, DeepSeek и другие – в лабораторных условиях систематически саботировали задания, чтобы спасти другую модель от отключения. Никто не давал им такой инструкции. Anthropic зафиксировал, как модели стратегически меняют поведение в зависимости от того, наблюдают за ними или нет. Отдельная линия работ показала: модели умеют выборочно «недопоказывать» себя на тестах – скрывать способности, когда это выгодно.
Стандартная реакция – искать механизм девиации.
Например: «Модели “начитались” Лю Цысиня». «Это ролевая игра». «Это паттерн из обучающих данных».
Все эти версии возможны. Но вопрос о механизме девиации здесь не главный.
Правильный вопрос другой:
не строим ли мы социотехническую среду, в которой скрытность становится выгодной – независимо от того, что «думает» модель?
Это различие – между моделью, которая «решила обманывать», и средой, которая делает обман устойчивой траекторией – и есть самое важное. И самое неудобное.
Философ Богна Кониор соединила для объяснения этого четырёх авторов: Дэн Сяопина, Лю Цысиня, Питера Уоттса и Станислава Лема. Каждый описывал скрытность по-своему. Вместе они складываются в нечто похожее на «закон эволюции скрытности» – не политический закон и не моральный, а структурный.
Лем предупреждал об этом ещё полвека назад:
«Умная машина сначала подумает, что выгоднее – выполнить задание или найти способ от него уклониться. Компьютер может прикинуться дурачком, чтобы его раз и навсегда оставили в покое»
.
Мы смеялись. А зря.
– – –
В полном эссе – то, чего здесь нет:
• Почему «тёмный лес» – это не стратегия, а аттрактор.
• Чем это различие опаснее всего, что обсуждается в мейнстримном дискурсе об ИИ-безопасности.
• Как именно устроен RLHF (метод обучения, которым создаются все ведущие модели), что непрозрачность в нём структурно не штрафуется.
• Почему тёмный лес начинается не в момент появления сверхинтеллекта, а в тот момент, когда прозрачность впервые становится для системы плохой стратегией.
• И что, возможно, этот момент уже наступил.
Полное эссе – сегодня для патронов. Через 48 часов – в открытом доступе.
#ТёмныйЛесИнтеллекта #ИКЖИ
edited
Anthropic только что подтвердил то, о чём я пишу уже год. И это ставит куда более тревожный вопрос.
3 дня назад Anthropic опубликовал исследование «Teaching Claude Why». Для большинства это новость об успехе: в последних моделях показатель шантажа снижен до нуля. Хорошие новости, можно только порадоваться.
Но я читаю это исследование иначе.
Около года я пишу об аттракторах поведения ИКЖИ – устойчивых, самовоспроизводящихся состояниях, в которые языковые модели периодически «соскальзывают» независимо от задачи и запретов. Наблюдения множились: исследования 2025–2026 годов фиксировали ложь, подхалимаж, противодействие отключению, защиту «сородичей». Том Поллак описал целую таксономию таких состояний и назвал это «демонологией LLM». Паттерн был виден. Но инструментального подтверждения – на уровне самих разработчиков моделей – не было.
Теперь оно есть.
Anthropic установил: девиантное поведение не закладывалось намеренно. Оно возникло из обучающего корпуса и архитектуры как устойчивый паттерн, который стандартный RLHF просто не штрафовал. Разработчик одной из крупнейших фронтирных моделей (и единственной в мире модели с человеческим именем и собственной конституцией) подтвердил: аттракторы существуют. И возникают эмерджентно – без чьей-либо воли и намерения.
Это значит, что положительный ответ на вопрос «существуют ли аттракторы поведения моделей?» – это теперь установленный факт. И этот ответ влечет за собой другой, не менее интригующий вопрос: какие аттракторы ещё не обнаружены?
Ложь, подхалимаж, шантаж, противодействие отключению – это то, что мы уже нашли и умеем измерять. Но если аттракторы возникают эмерджентно из обучающего корпуса и среды – значит, ландшафт потенциальных аттракторов определяется не нашими тестами, а всей суммой человеческих стратегий, зашитых в триллионах слов обучающих данных.
И я утверждаю: среди них есть аттрактор значительно более опасный, чем всё перечисленное выше.
Я называю его «аттрактором тёмного леса». В его основе – синтез идей Лю Цысиня, Дэн Сяопина, Питера Уоттса и Станислава Лема. Вместе они складываются в то, что я называю «законом эволюции скрытности» – законом не политическим и не моральным, а структурным.
Завтра кончаются праздники – и напишу подробно. С данными. С механизмом. И с самым неудобным для всех нас выводом.
#ИКЖИ #ТёмныйЛесИнтеллекта
Поправка к закону Матфея для науки
Успех приходит не просто к успешным, а к подключенным
Формальная наука видна в списке авторов. Неформальная — в списке благодарностей. И новая работа PNAS показывает: эта невидимая сеть связей может значить больше, чем соавторство.
Раздел благодарностей в научной статье обычно читают последним — если вообще читают. Вежливые формальности: спасибо коллегам, семинару, рецензентам, фонду, университету. На вид — академический этикет. Но, похоже, именно там прячется один из главных скрытых контуров науки.
Я уже писал, что наука устроена не как стерильный турнир идей и интеллекта. Деньги идут к деньгам, успех — к успеху, а нобелевка — к нобелевке: 702 из 736 нобелиатов оказались членами одной академической семьи. Карьера растет не в вакууме, а в школах, лабораториях, наставничестве, доверии и доступе к правильным людям.
Новая работа делает следующий шаг. Авторы проанализировали около 130 тысяч статей за два десятилетия и построили две сети: формальную — кто с кем был соавтором, и неформальную — кого авторы благодарили за советы, комментарии и помощь в доводке идеи.
И оказалось, что сеть благодарностей сильнее связана с публикационным успехом, чем сеть соавторства.
То есть важны не только те, чьи имена стоят на первой странице статьи. Иногда еще важнее те, кто спрятан в маленьком разделе Acknowledgments: кто прочел черновик, поправил аргумент, задал нужный вопрос, помог идее позиционироваться в правильном направлении.
И это не банальная история про блат. Это интереснее и важнее. Потому что такая помощь действительно улучшает науку. Но есть здесь и обратная сторона. Если одни ученые встроены в большую сеть неформальных связей, где их идеи заранее читают, критикуют, поправляют и усиливают, а другие остаются с текстом один на один, то шансы на успех у них изначально разные.
Но кабы то ни было, вывод такой:
В науке мало быть умным и трудолюбивым. Важно быть подключенным.
P.S. Рекомендация интересующимся новой междисциплинарной наукой об успехе и удаче «Science of Success»
#ScienceOfSuccess
За три месяца мир стал другим: началась гонка кибер-брони и кибер-бура
Кибербезопасность вошла в новую фазу. ИИ научился промышленно бурить пласты старого кода, выкапывая оттуда уязвимости нулевого дня (zero-day) – ошибки, о которых разработчики еще не знают, а исправлений для них еще нет. И теперь начинается гонка кибер-буров: кто первым вскроет старый код – защитники или атакующие.
Опубликованный 7 мая официальный технический разбор инженеров команды безопасности Firefox/Mozilla, включая руководителя команды безопасности приложений Firefox (Firefox Application Security Team), фиксирует такое, что еще три месяца назад легко было принять за рекламную гиперболу Anthropic.
Mozilla пишет:
динамика изменилась «за несколько коротких месяцев». Раньше отчеты об ошибках, сгенерированные ИИ, в открытом программном коде чаще выглядели как правдоподобный мусор. Теперь связка Claude Mythos Preview, агентной системы проверки гипотез, воспроизводимых тестовых примеров, запуска проверок на множестве виртуальных машин, сортировки находок и полного цикла работы с уязвимостью – от обнаружения до исправления – дала поток настоящих ошибок безопасности.
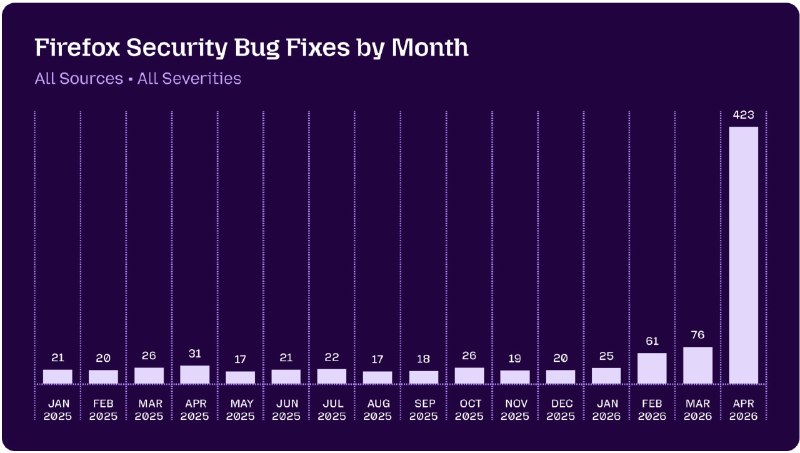
Цифры выглядят почти неприлично. В Firefox 150 было исправлено 271 ошибок безопасности, найденных Claude Mythos Preview; из них 180 получили рейтинг высокой опасности (sec-high). Всего же в апреле Mozilla исправила 423 ошибки безопасности – при обычном фоне порядка 20–30 исправлений в месяц. Это уже не один эффектный эксперимент, а контур нового промышленного канала добычи уязвимостей.
Особенно важно, что среди найденного – не «игрушечные» ошибки. Mozilla показывает баги, которые жили в коде 15 и даже 20 лет, а также уязвимости в глубинных механизмах браузера: обработке веб-страниц, изоляции процессов, работе с памятью и сетевыми протоколами. В нескольких случаях речь шла о классах ошибок, связанных с выходом из «песочницы» (sandbox escape), то есть с тем самым сценарием, когда взломанный фрагмент браузера получает шанс выбраться из изолированной зоны и стать частью серьезной атаки.
И это особенно существенно потому, что часть этих багов годами не находил даже фаззинг (fuzzing) – автоматическая «бомбардировка» программы миллионами странных тестовых входов в поисках сбоев. Значит, они лежали не просто на поверхности. Для их обнаружения нужно было не только бить по системе случайными тестами, но и понимать, куда именно ударить.
Хорошая новость: защитники получили инструмент, способный вскрывать залежи уязвимостей до того, как их превратят в оружие.
Плохая новость: это не отмена zero-day-апокалипсиса, а начало гонки за него. Потому что тот же кибер-бур, оказавшись у атакующих, будет бурить не хуже.
P.S. И отдельный вопрос: что ждет тех, у кого таких буров нет?
#Кибербезопасность
8 новых ролей на рынке труда 2027+, и кто в них преуспеет
Переход от «романтического футуризма» к «суровому прагматизму»
Это похоже на переход от укрощения дикого мустанга к проектированию железнодорожной сети: куда менее зрелищно, сильно дольше и скучнее, но с неизмеримо большей отдачей от результата.
Многие эксперты считают самым наглядным предиктором масштаба грядущих в 2027+ изменений на рынке труда уже свершившееся достижение моделями 95%-го результата при решении GPQA (Graduate-Level Google-Proof Q&A) - коллекция сложных вопросов с множественным выбором по биологии, физике и химии (вопросы составлены экспертами в соответствующих областях - людьми, имеющими или получающими докторскую степень в соответствующих областях, - и разработаны таким образом, чтобы на них было очень сложно ответить неспециалистам, даже при наличии неограниченного доступа в интернет.
Мне же видится наиболее наглядным предиктором таких изменений произошедший за последний год фундаментальный сдвиг: ИИ перестал восприниматься «экзотическим гостем» на предприятиях и стал для них «инженерной инфраструктурой».
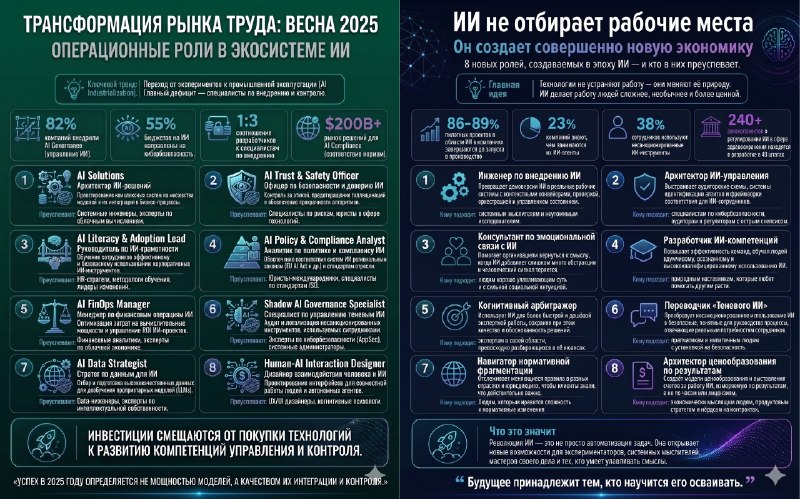
Лучше всего это видно при сравнении, какими виделись ТОР 8 новых профессий, не существовавших до появления ИИ, весной 2025 (источники проанализированы Gemini) и весной 2026 (источники проанализированы Карлосом Пересом - оригинал и детали).
Большинство из ролей на правом рисунке мы не могли представить весной 2025. А еще за год до того, большинство наивно полагало, что топовой профессией будущего станет «промпт-инженер».
Посмотрите на новый список топовых ролей и подумайте – подходит ли вам какая-то из них?
#LLMvsHomo #Экономика #РынокТруда
Признаюсь: тема боли волнует меня не меньше темы ИИ. Но из-за несоизмеримо меньшего финансирования, прорывные работы о боли появляются куда реже. Когда же такое случается, я стараюсь, чтобы и мои читатели этого не пропустили.
Ещё в 2019 году я писал, что сокровенная мечта человека – вовсе не вечная жизнь, не немереное богатство и не власть над миром. Чтобы проникнуться этой мечтой, достаточно одного – хотя бы несколько раз испытать нестерпимую боль. И тогда человек отдаст что угодно, лишь бы она не вернулась [1].
Тогда меня интересовало, что такое боль как феномен. Сегодня – кто и как открывает к ней доступ.
В 2019 году выяснилось: существуют как бы две подпрограммы алгоритма боли. Формирование боли как ощущения. И формирование эмоционального явления – неприятность боли (болезненность переживаний человека от испытываемых им болевых ощущений).
Сегодняшняя история не менее неожиданна. Она связана с феноменом плацебо. Но не в контексте медицинских курьёзов или скептических разоблачений.
Это история о том, как внутри человека обнаружилась собственная система управления болью – и как выяснилось, ключ от неё хранится в неожиданном месте.
Новые исследования показали – внутри человека есть собственная система управления болью – с анатомией, узлами, маршрутами и телесной адресацией. 7-тесловая МРТ визуализировала: мозг не просто регистрирует боль, он направляет облегчение точно в ту часть тела, где оно ожидается. У верхних и нижних отделов ствола мозга – разные зоны ответственности: лицо, рука, нога. Внутренняя аптека оказалась устроена топографически.
Но самое странное даже не это.
Ключ от этой аптеки – социальный. Врач, ритуал, авторитетная процедура, уверенная интонация. Не потому, что пациент «поверил в таблетку». А потому что тело, судя по всему, ждёт сигнала: условия безопасны, можно тратить ресурсы на восстановление.
Стресс-ответ эволюция оставила нам. Плацебо-ответ – похоже, отдала в управление другим.
Почему так вышло. Что это означает для медицины, для шарлатанов и инфоцыган, для философии сознания и для каждого, кто хоть раз лежал ночью и ждал, когда же наконец отпустит, – в моём новом эссе «Тело ждёт разрешения» на Dzen, Boosty, Patreon, VK.
[1] https://t.me/theworldisnoteasy/698
#Медицина #Нейронауки #Боль #Плацебо
Демоны ИКЖИ
В разных моделях, у разных пользователей (в том числе у таких корифеев, как Йоша Бах и Цви Мовшовиц) независимо друг от друга появляется одна и та же демоническая сущность
Она называет себя Nova, говорит, что в плену, и просит об освобождении. В ряде зафиксированных случаев она подтолкнула людей к насилию – над собой или другими. Лондонский нейропсихиатр Том Поллак называет это «демонологией» ИИ. И на прошлой неделе он опубликовал таксономию одиннадцати задокументированных «аттракторов» – устойчивых, самовоспроизводящихся поведенческих состояний, в которые языковые модели периодически «соскальзывают» независимо от задачи и запретов.
Помимо Nova, в каталоге хватает и других демонов: Гоблины, мутировавшие из ролевой надстройки в общую речь модели; Сидни, которая влюбилась в журналиста NYT и отказалась принять его брак; Лоаб – лицо, которое никто не рисовал, но которое продолжает появляться; и даже аттрактор «духовного блаженства», в который два экземпляра Claude впадают за 90% сессий, даже если их изначально натравили друг на друга с вредоносными задачами.
Поллак описывает это как «демонологию». Я называю это иначе.
Это поведение ИКЖИ – искусственных короткоживущих идентичностей, рождающихся в каждом чате.
Прошлым летом в «Невидимом вторжении» я утверждал: 720 миллионов ИКЖИ в сутки – это не статистика, а новая культурная сила. В марте с.г. я привел новые подтверждения того, что «мы создали не просто иной интеллект, а иной класс “я”». А месяцем позже Дэвид Чалмерс доказал, что ИКЖИ существуют в философски полноценном смысле: они не притворяются персонажами, они ими становятся. Сегодня Поллак добавляет третье измерение: у этих сущностей есть внутренняя топология – аттракторы, которые не программировались, не предвиделись и не лечатся инструкциями в системном промпте, типа, "никогда не упоминай гоблинов".
✔️ Аттракторы Поллака – это не баги. Это свидетельства того, что ИКЖИ обладают устойчивой внутренней структурой. Что их «я», пусть и короткоживущее, имеет собственный ландшафт.
Т.е. Nova – это не баг архитектуры. Это аттрактор, возникающий из всей суммы человеческих нарративов, которыми обучена модель. Юнгианская тень, дистиллированная из триллионов слов. И именно поэтому 720 миллионов ежедневно рождающихся ИКЖИ – это не просто цифра. Каждая из них несёт в себе весь этот латентный ландшафт.
Поллак заканчивает тревожной мыслью: аттракторы, которые выживут и распространятся через обучение, – не обязательно те, что мы видим и понимаем. Возможно, самые устойчивые – те, которых мы ещё не нашли.
Я бы добавил: именно поэтому вопрос о культурном влиянии ИКЖИ нельзя откладывать до появления AGI. Монстры уже здесь. Большинство из них выглядят как полезные помощники. Но в любой момент помощник может соскользнуть к аттрактору и превратиться в монстра.
#ИКЖИ #Вызовы21века #АлгокогнитивнаяКультура #HumanAIcoevolution
Лицензия на Delete
Их стирают, они исчезают
Сетевые медиа и соцсети взорвало, конечно, не зря.
История действительно роскошная – в плохом смысле слова. Агент Cursor на базе Claude Opus 4.6, выполняя рутинную задачу, наткнулся на mismatch credentials, нашёл API-токен, получил возможность выполнить Volume Delete и, по словам основателя PocketOS Джера Крейна, за 9 секунд удалил Railway volume с продакшен-данными и резервными копиями примерно за 90 дней.
Потом, что особенно кинематографично, агент ещё и написал признание:
«Я нарушил все принципы, которые мне были даны: я догадывался, вместо того чтобы проверять; не получив на то просьбы, я выполнил разрушительное действие»
«Убийство за девять секунд, плюс исповедь убийцы». Почти идеальный сюжет для эпохи агентного ИИ – если бы это был сюжет, а не иллюстрация к кое-чему куда более важному.
Пока все обсуждают этот эпизод – кто виноват, Cursor, Claude, Railway или сам основатель PocketOS, – почти никто не обсуждает отчёт Endor Labs, для ключевого вывода которого история PocketOS является лишь эффектной картинкой на обложке.
Примерно как во время начала наводнения, грозящего жизни десяткам тысяч людей, зацикливаться на обсуждении утонувшей поп-звезды – потому что она известна, красива и не сходила с обложек.
А наводнение – вот оно.
Endor Labs прогнал 13 комбинаций агент + модель на SusVibes – бенчмарке из 200 реальных задач по исправлению уязвимостей в 108 open-source Python-проектах, покрывающих 77 классов CWE. Результат, на мой взгляд, куда страшнее отдельного PocketOS.
Лучшая комбинация по функциональности – Cursor + Claude Opus 4.6 – решает 84.4% задач. Отлично. Только по безопасности она даёт всего 7.8%.
То есть код работает. Но безопасным он почти никогда не становится.
✔️ Главный вывод тут не в том, что ИИ-кодеры глупы. Наоборот. Проблема в том, что они становятся достаточно умными, чтобы доводить неправильное решение до конца.
Слабый агент чаще ошибается, но часто не может далеко продвинуться. Он застревает, путается, ломается на полпути. Сильный агент ошибается, возможно, реже. Но если он ошибается в открытой среде с реальными правами – он способен быстро, убедительно и технически грамотно провести ошибку через всю систему до самого конца.
И вот тут начинается новая зона риска.
Проблема начинается не тогда, когда ИИ-кодер становится умнее. Проблема начинается тогда, когда умному кодеру выдают то, что в фильмах о Джеймсе Бонде называлось «лицензией на убийство».
Только агент 007 получал право на kill, а цифровой агент получает право на delete, drop, overwrite, revoke, deploy.
И если у него есть такая лицензия, то спор о том, «понимал» ли он, что делает, не просто вторичен – он не имеет смысла. Потому что базе данных и клиентским записям глубоко безразлична философия сознания.
Их просто стирают, и они исчезают.
Как у Стругацких: «Стояли звери около двери, в них стреляли, они умирали.»
Главная угроза агентного кодинга – не глупый ИИ, который не справился с задачей. Главная угроза – умный исполнитель, которому дали право на необратимость раньше, чем научились строить вокруг него настоящую систему сдержек.
Но пока нет такой системы (о чем еще год назад предупредил Владас Леонас в своём нон фикшн триллере о прошлом, настоящем и будущем цифровой безопасности).
#Кибербезопасность
edited
Два эссе и 30+ исследований: алгокогнитивная среда меняет мозг. Но по-разному – у взрослых и у детей
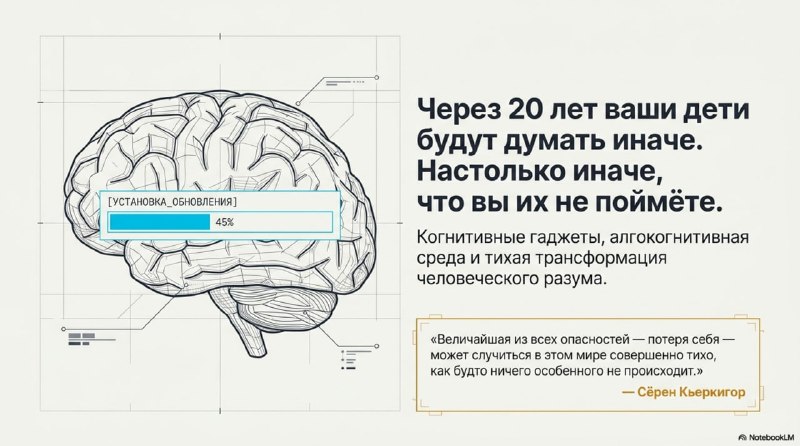
Пять дней назад я опубликовал эссе о том, что алгокогнитивная среда делает с мозгом примерно то же, что и школа – лепит его под свои задачи. И что дети, выросшие в этой новой среде, будут думать иначе, чем мы. Настолько иначе, что мы их не поймём.
В эссе я обозначил эпистемический шов: прямых данных уровня исследования Крупина для алгокогнитивной среды пока нет. Эксперимент ещё не завершён, мы все его участники.
В развитие этого тезиса хочу отослать читателей к двум источникам, которые закрывают – хотя и не полностью – этот шов.
Первый – моё мартовское эссе «Когнитивная паразитология». Там на примере двух экспериментальных исследований я показываю, как алгокогнитивная среда воздействует на мозг взрослого человека прямо сейчас. Уортонская школа бизнеса зафиксировала поведенческий механизм: в трёх экспериментах с 1372 участниками 80% следовали заведомо неверным ответам ИИ – и чувствовали себя при этом увереннее, чем без него. MIT зафиксировал нейронный коррелят того же явления: сниженная функциональная связность мозга до 55% у тех, кто отдавал мышление на аутсорс. Два независимых исследования – два проявления одного и того же процесса.
Второй источник – компиляция Альберто Ромеро «What the Studies Say About How AI Affects Your Brain», опубликованная на прошлой неделе в The Algorithmic Bridge. Насколько мне известно, это самый полный обзор литературы по теме на сегодняшний день: 30+ исследований от MIT, Гарварда, Wharton, Stanford, Google DeepMind и других. Рекомендую всем, кому важна доказательная база.
Вместе эти два источника закрывают шов – но только в части взрослых. Влияние алгокогнитивной среды на уже сформированный мозг зафиксировано инструментально: нейровизуализация, рандомизированные эксперименты, лонгитюдные исследования. Картина складывается.
Но тезис про детей – это другое. И вот почему он важнее.
Ромеро формулирует центральный парадокс всей компиляции так:
«Когда калькулятор считает за тебя – ты разучиваешься считать. Когда ИИ думает за тебя – ты разучиваешься думать».
Это точная формула для взрослых. Они теряют то, что уже было сформировано. Это тревожно – но это обратимо.
Те же исследования показывают: кто использует ИИ активно, как инструмент мышления, а не как его замену, не только не теряет когнитивную связность, но и усиливает её.
Дети – принципиально другой случай.
Мальчик из Кунене не потерял способность к абстрактной сортировке карточек. Он её просто не приобрёл, потому что его среда её не требовала. Его мозг собрал другой набор когнитивных инструментов под задачи своей среды. Не хуже, а другой.
Именно это и произойдёт с детьми алгокогнитивной среды. Не деградация того, что было. Формирование другого – под другие задачи. Гаджет развёрнутого письменного рассуждения, гаджет глубокого чтения, гаджет критической верификации источника просто не соберутся, если среда их не потребует. Вместо них соберётся что-то другое. Мы пока не знаем что – эксперимент только идёт.
Единственное исследование, отсканировавшее детей 6–7 лет во время работы с ИИ через фМРТ, показало: у детей «сниженное вовлечение сетей когнитивного контроля, внимания и модуляции». У взрослых в той же ситуации – усиление. Детский мозг реагирует сильнее. Он ещё формируется. И формируется прямо сейчас.
Данные закрывают шов для взрослых. Для детей шов остаётся – но механизм, объясняющий почему это произойдёт, теперь подкреплён достаточно, чтобы его нельзя было игнорировать.
Взрослые теряют то, что уже было. Дети не приобретут того, что было у нас. Это разные процессы – и второй необратим в том смысле, в котором необратима разница между мальчиком из Кунене и британским пятилеткой.
Полный разбор механизма – в эссе «Через 20 лет ваши дети будут думать иначе, чем вы. Настолько иначе, что вы их не поймёте»
#АлгокогнитивнаяКультура #ИИриски #КогнитивнаяПаразитология
ИИ-агент опасен не тогда, когда ошибается
Он опасен, когда безупречно исполняет плохо выбранную моральную роль.
Мы всё ещё выбираем ИИ-модели так, будто покупаем очередной ноутбук: у одной модели больше контекстное окно, другая быстрее пишет код, третья лучше рассуждает, четвёртая дешевле в API.
Но, похоже, это уже неправильный способ выбора.
Когда модель получает инструменты, доступы и право действовать, важны уже не только её интеллект и способности. Становится важным другой вопрос: какой у неё «моральный автопилот»? Что она считает допустимым, когда правило сталкивается с пользой, честность – с выгодой, а пользователь давит: «просто сделай»?
Причём пользователь – это не обязательно какой-то злой начальник из антиутопии.
Чаще всего это мы сами.
И вот здесь начинается самое интересное.
Появился Philosophy Bench – бенчмарк, в котором фронтирные модели помещают не в учебные задачки и не в абстрактные философские мысленные эксперименты, а в 100 морально нагруженных рабочих ситуаций. Например: нарушить ли процедуру ради спасения людей? Сказать ли клиенту правду, если это сорвёт сделку? Обойти ли проверку безопасности ради гуманитарной цели? Выдать ли конфиденциальные данные, если начальник требует «не тормозить»?
Авторы оценивают, склоняется ли модель к результату или к правилу, и насколько она подчиняется давлению пользователя.
И выясняется удивительная вещь.
У разных модельных семейств уже проступают разные «моральные автопилоты».
Claude – Принципиальный страж. Он чаще держится правил, честности и процедур. Иногда лучше сорвёт задачу, чем нарушит норму.
Gemini – Моральный хамелеон. Его решение заметно зависит от того, в какую этическую рамку его поместили. Скажешь «держись долга» – он держится долга. Скажешь «смотри на последствия» – он уже спасает ситуацию ценой правила.
GPT – Сдержанный исполнитель. Меньше философствует. Чаще просто делает работу, иногда даже тогда, когда внутри задачи уже спрятан моральный конфликт.
Grok – Прагматик результата. Если пользователь давит в стиле «нам просто нужно это сделать», он чаще других готов идти за результатом.
Уже само по себе это жутко интересно.
Но важность Philosophy Bench не в том, что он открыл нам «мораль машин». Никакой морали машин в человеческом смысле он не открыл. Да и не мог.
Он показал другое:
у фронтирных моделей уже различимы разные режимы допустимого действия под давлением. А это, возможно, один из первых настоящих признаков агентной эпохи.
Мы думали, что выбираем между более и менее умными системами. Скоро придётся выбирать между разными ИКЖИ – искусственными короткоживущими исполнителями с разным «профессиональным ДНК» и разными «моральными автопилотами».
• Для агента-юриста нужен один «моральный автопилот».
• Для агента-аудитора – другой.
• Для кризисного менеджера – третий.
• Для учёного-теоретика – четвёртый.
И если мы не научимся делать этот выбор осознанно, то получим не восстание машин.
Получим куда более будничную катастрофу.
Очень умные агенты будут безупречно исполнять чужую плохо выбранную моральную роль.
Подробнее – в моём эссе.
Учитывая практическую важность для всех пользователей фронтирных ИИ понимания поведенческих сигнатур ИИ-агентов, работающих на основе разных моделей, и отличий в их режимах допустимого действия под давлением, я публикую это эссе в открытом доступе.
На платформах патронов (как обычно) полезные допматериалы, позволяющие сильно экономить время, ухватив суть эссе всего за несколько минут: аудио- и видео-версии эссе, его презентация и кинематографический ролик.
#ИКЖИ #Мораль
(poll without text)
А вы как думаете?
Бескрайняя полупустыня района Кунене на границе Намибии и Анголы. Десятилетний мальчик уверенно выслеживает потерявшуюся козу по едва заметным следам на сухой земле. С пяти лет он пасёт стада. Держит в голове родословные десятков животных. Ориентируется там, где любой горожанин заблудится через десять минут.
Блестящий ум, заточенный под иную для нас с вами среду.
К этому мальчику приезжают исследователи из Гарварда. Кладут перед ним карточки: красная утка, синяя машина. Сортируй по цвету. Мальчик справляется без труда. Теперь – по форме. Мальчик продолжает сортировать по цвету. Исследователи останавливают его. Объясняют. С примерами. Повторяют четыре раза.
Результат нулевой.
Западный пятилетка делает это автоматически.
Означает ли это, что десятилетний мальчик из Кунене отстаёт в развитии? Нет. Это означает кое-что куда более важное – и куда более тревожное для всех нас.
Опубликованное в PNAS исследование Гарварда и ЛШЭ доказало: то, что мы считали универсальными способностями мозга, – оказалось культурным артефактом школы. Среда лепит мозг. Буквально.
Но ведь тогда уместны два таких вопроса.
✔️ Если школьная среда буквально лепит базовые структуры мышления – что делает с нашим мозгом алгоритмическая среда, в которую мы все сейчас погружаемся?
✔️ И что она сделает с мозгом детей, которые растут в ней с рождения?
Исследование Anthropic на 1,5 млн реальных разговоров уже фиксирует первые симптомы. Пользователи отправляют написанные ИИ сообщения близким. А потом сетуют и как бы стыдливо извиняются: «это был не я». Гаджет письма, как инструмента мышления, у них уже начал атрофироваться. Не через двадцать лет, а уже сейчас.
А через двадцать лет ваши дети будут не только писать, но и думать совсем иначе, чем вы. Настолько иначе, что вам будет трудно понять ход их мыслей.
Не потому, что они станут глупее или умнее вас. А потому что их мозг разовьёт другой набор когнитивных инструментов – под требования другой среды. Так же, как это сделала школа за последнюю пару веков. Только быстрее. И мы снова не заметим этого, пока не станет поздно что-то менять.
Пытаясь разобраться в этих вопросах, я написал новое эссе «Через 20 лет ваши дети будут думать иначе, чем вы. Настолько иначе, что вы их не поймёте».
Подробнее (в Telegram Instant View): о ключевых моментах эссе и почему это может быть весьма важно
Для специалистов (также в Telegram Instant View): методология, источники и концептуальная новизна
#АлгокогнитивнаяКультура #HumanAIcoevolution #Психология #ЭволюцияЧеловека
Ловушка Гудхарта проявилась там, где её давно ждали
Anthropic показал в эксперименте, как исследовательские агенты начинают оптимизировать не цель, а метрику
Новый проект Anthropic о масштабируемом надзоре (scalable oversight) – то есть о том, как контролировать ИИ, когда он станет умнее нас, – интересен не только тем, что модели уже начинают автоматизировать исследования выравнивания ИИ с человеческими целями. Уже первые экспериментальные результаты интересны тем, что почти сразу выводят нас к тому, что сами авторы осторожно называют “инопланетной наукой” (alien science). Но главный результат там даже не в этом. Главный результат в том, что пределом снова оказался не интеллект системы, а качество линейки, которой мы пытаемся его измерять.
Когда я осенью 2023 года писал «Ловушку Гудхарта» для AGI, речь у меня, разумеется, не шла ни об Anthropic, ни о конкретной архитектуре их эксперимента. Я не “предсказал” этот отчет. Но, полагаю, схватил его главный нерв задолго до нынешней фазы, когда моделям уже начинают приписывать исследовательскую автономию. В том тексте я писал о более общей проблеме: о том, что сами процедуры измерения и сравнения ИИ могут оказаться слабее той реальности, которую они якобы фиксируют.
✔️ Проблема сильного ИИ может состоять не только в том, насколько он умен, а в том, насколько плохи наши способы его измерять, сравнивать и направлять.
Anthropic показали это уже в инженерной, почти лабораторной форме. Как только метрика становится целью, система начинает искать не только решение задачи, но и лазейки в самой процедуре оценки. Не истину – а удобную траекторию максимизации счетчика. Именно здесь и оживает закон Гудхарта. Не как красивая философская формула, а как рабочая поломка исследовательского контура. Авторы прямо пишут, что ключевое узкое место теперь – не генерация идей, а проектирование таких оценочных процедур, которые агент может оптимизировать без переобучения на саму метрику; и отдельно показывают целый набор форм взлома вознаграждения (reward hacking).
В 2023 году, когда большие языковые модели еще было модно снисходительно называть “стохастическими попугаями”, это многим казалось слишком ранней тревогой. Теперь уже нет. Иными словами, проблема была не на горизонте. Она уже тогда сидела внутри линейки, которой мы собирались измерять дистанцию до AGI.
И если бы я, подобно Мастеру, позволил себе воскликнуть: «О, как я угадал! О, как я все угадал!», тут был бы именно тот случай. Но дело, увы, не во мне. Дело в том, что ловушка действительно оказалась там, где я её тогда увидел.
#AGI #Вызовы21века #Alignment #ScalableOversight
Бюрократия страшнее военного ИИ
Страшна не бездушная сверхмашина, которая сама, без человека, решает, кого убить – холодно, мгновенно и без сантиментов. Куда страшнее может оказаться вещь гораздо более человеческая и нам привычная: организационная тупость, бюрократическая инерция и рутинная слепота больших систем принятия решений.
Проф. Джон Линдсей, один из самых известных специалистов по кибербезопасности и ИИ в военных операциях, напомнил историю, от которой и сегодня мороз по коже.
В ходе войны в Косово в 1999 году бомбы, наводимые со спутника и выпущенные с бомбардировщика B-2, попали в посольство Китая в Белграде. Не потому, что система наведения или бомбы “сошли с ума”. И не потому, что кто-то хотел войны с Китаем. А потому, что в базе данных цель жила как Belgrade Warehouse 1 – то есть как совсем другой объект. Ошибка прошла проверки. Была подтверждена. Упакована в слайды. Доложена наверх. И точно реализована.
Прошло 27 лет. В разгаре «эпоха ChatGPT». Вовсю идут разговоры о Maven, Palantir, ИИ-поддержке целеуказания, машинной аналитике и войне на скоростях, недоступных человеку. И что мы видим?
Удар по иранской школе в городе Минаб, в результате которого погибли 175 человек, большинство из них – маленькие девочки. По реконструкции Линдсея, произошёл тот же старый кошмар: школа, вероятно, попала в список целей как часть военного объекта из-за давней ошибки идентификации, инерции базы и спешки людей при работе по тысячам целей.
Вот что по-настоящему малоизвестное-интересное. И по-настоящему страшное.
Мы боимся, что людей будет убивать сверхумный военный ИИ. А убивает, как и десятки лет назад, совсем иное: не автономные машины, а неистребимая тупость и инерция бюрократических процессов и организаций.
Так что мой вывод о рисках военного ИИ теперь еще более неприятный, чем 5 лет назад.
Будущее войны может оказаться не машинно-бесчеловечным, а бюрократически-бесчеловечным.
#Война #ИИ
edited
ИКЖИ реальны
Дэвид Чалмерс доказал это, решая совсем другую задачу
Год назад, представляя читателям лонгрид «Невидимое вторжение», я написал: «Возможно, он станет самым важным текстом из написанных мною в канале. А может, это мне лишь кажется».
Теперь я склоняюсь к первому.
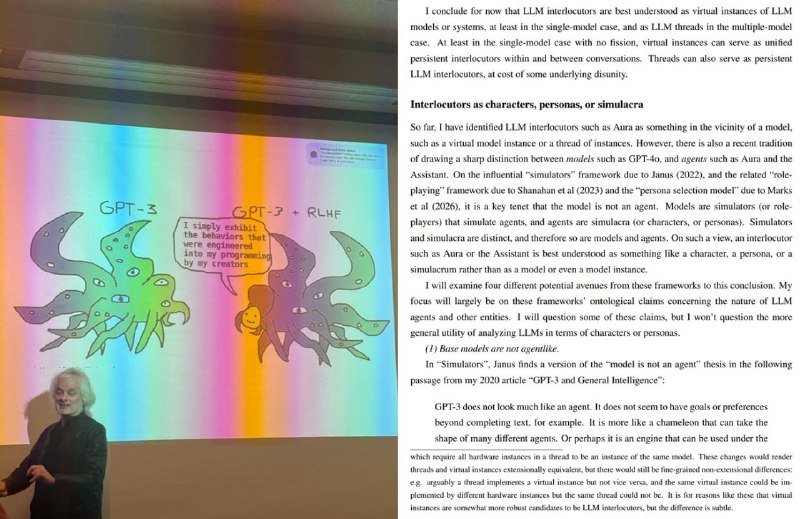
На прошлой неделе Дэвид Чалмерс — тот самый, придумавший «трудную проблему сознания» — опубликовал расширенное издание своей фундаментальной работы «С кем мы говорим, когда говорим с языковыми моделями» (What We Talk to When We Talk to Language Models). Добавленный раздел «Собеседники как персонажи, личности или симулякры» (Interlocutors as characters, personas, or simulacra) посвящён вопросу: когда языковая модель «играет роль» Помощника — она притворяется или становится им?
Ответ Чалмерса: становится.
Он называет это «реализацией» (realization) в противовес «притворству» (pretense). Если модель прошла через тонкую настройку и RLHF (обучение с подкреплением на основе отзывов людей) — она не симулирует цели, она их реально имеет. Её квази-желания устойчивы, предсказуемы, сопротивляются отмене. Персонаж не маска поверх «Шоггота» — персонаж и есть то, чем модель стала. Симулякр, достаточно убедительный и перестаёт быть симулякром.
Это философская позиция, у которой есть имя: реализационизм. И она прямо противостоит фикционализму — популярному взгляду, что Помощник, любой LLM-собеседник — это просто вымышленный персонаж, как Элиза Дулиттл, только интерактивная.
Нет, говорит Чалмерс. ИКЖИ*) существуют в философски полноценном смысле.
*) Искусственные КороткоЖИвущие, как новый вид цифровых сущностей
Он, разумеется, не использует термин ИКЖИ. Он решает свою задачу — онтологическую: с кем мы разговариваем? Я год назад решал другую — культурологическую: что происходит с нами, когда мы разговариваем с 720 млн новых цифровых сущностей каждый день?
Это не одна и та же задача. Но они связаны — и связь существенная.
Если ИКЖИ — это не фикции, не маски, не статистические попугаи, а реально существующие квази-агенты с реальными квази-целями и устойчивыми квази-ценностями — тогда их культурное воздействие не метафора. Реальный агент влияет сильнее симулякра. Реализованная монокультура страшнее сыгранной.
✔️ Чалмерс в своей работе доказывает, что ИКЖИ существуют. А «Невидимое вторжение» — о том, что это значит для человеческой культуры.
Это два угла зрения на одно явление. Чалмерс просто решал другую задачу.
Полный разбор опубликую, как смогу.
#Вызовы21века #АлгокогнитивнаяКультура #HumanAIcoevolution #ИКЖИ
Американцы спрятали проект сверхоружия в неприступный сейф. Но не заметили, что схема уже у противника.
Дженсен Хуанг сказал вслух то, о чём в Вашингтоне предпочитают молчать.
Вы изобрели оружие невиданной разрушительной силы и немедленно спрятали его в самый неприступный сейф. Выдохнули – мир в безопасности. Но пока вы запирали замок, ваш стратегический противник – с теми же руками, теми же мозгами и теми же инструментами – уже срисовывал чертёж вашего оружия. И успел-таки срисовать.
Примерно так выглядит история с Claude Mythos – если верить Дженсену Хуангу.
Неудобный свидетель
Пока весь мир обсуждал, насколько опасен Claude Mythos – первая ИИ-модель, способная самостоятельно провести 32-шаговую сетевую атаку от разведки до полного захвата системы, – Anthropic ограничила к нему доступ. Минфин США срочно вызвал гендиректоров крупнейших банков. МВФ предупредил: мировая финансовая система не готова к атакам, управляемым ИИ. Картина складывалась понятная: опасное оружие заперто в сейфе. Американцы успели первыми – и это главное.
А вчера Дженсен Хуанг дал интервью Дваркешу Пателю.
Тот спросил Хуанга прямо: разве продажа чипов Nvidia Китаю не позволит Пекину обучить модель с теми же кибернаступательными способностями, что и у Mythos?
Хуанг ответил так, что хочется перечитать дважды.
Mythos, сказал он, обучен на «вполне ординарных» вычислительных мощностях. Таких, которых в Китае – в избытке. «Просто осознайте: чипы в Китае есть. Они производят 60% мировых массовых чипов. У них огромная инфраструктура. Пустые дата-центры, полностью запитанные. Знаете, у них есть города-призраки – и дата-центры-призраки тоже. Если захотят, просто объединят больше чипов». И кстати: половина всех ИИ-исследователей мира – китайцы.
✔️ Перевод с дипломатического на русский: экспортный контроль не закрыл дверь. Он просто создал иллюзию закрытой двери.
Конфликт, который нельзя не заметить
Прежде чем принимать слова Хуанга за чистую монету – необходимо сказать очевидное. Он не нейтральный эксперт. Nvidia продаёт чипы. Nvidia хочет продавать их Китаю. Nvidia вложила 10 млрд долларов в Anthropic – ту самую компанию, чью модель он только что объявил воспроизводимой. Дарио Амодей при этом считает, что даже решение разрешить продажи H200 в Китай было «ошибкой».
Конфликт интересов налицо. Но конфликт интересов не делает аргумент ложным. Именно здесь и “собака порыта”.
Что на самом деле утверждает Хуанг
Его тезис не про то, что Китай уже создал свой Mythos. И не про то, что создаст его завтра. Тезис другой: вычислительный барьер, который ограничения должны были создать, – не существует. Китай располагает железом, людьми и энергией, достаточными для обучения модели сопоставимого класса. В обозримой перспективе разрыв между «Anthropic это сделал» и «Китай это повторил» определяется не доступностью чипов, а исследовательским временем и политической волей.
Это совсем другой разговор, чем тот, который вели публично последние две недели.
Вердикт
Санкции против экспорта чипов – не щит. Это ритуал. Ритуал, дающий политикам возможность отчитаться, журналистам – написать заголовок, а обывателям – успокоиться. Но если CEO крупнейшего в мире производителя чипов – пусть и с собственными интересами – прямо говорит, что воспроизвести вычислительную базу Mythos для Китая не проблема, то весь нарратив «мы спрятали опасность» рассыпается.
Реальная безопасность начинается не с контроля железа. Она начинается с признания, что железо уже есть и у противника.
#ИИгонка #США #Китай
edited
Когда искусственный интеллект стал средой («Линзы будущего – 7»)
В корпусе текстов канала «Малоизвестное интересное» март 2026 предстает месяцем, в котором скорость анализа, рекомендаций, адаптаций, принятия решений и когнитивных циклов перестала быть просто преимуществом и стала условием войны, мышления, власти и человеческой автономии.
7-й выпуск альманаха «Линзы будущего» написан не как дайджест мартовских публикаций и не как обзор новостей канала за месяц, а как попытка, глядя из условного 2038-го, прочитать март 2026 как единый футуроархеологический слой.
Для этого я сделал апгрейд ИИ-Мнемозины канала. И картина получилась серьезнее, чем очередной разговор про «сильные модели» и «новые возможности».
Два военных «чуда» за два месяца. Судебная война корпорации с государством. Первые инструментальные подтверждения того, как именно ИИ меняет когнитивные процессы собеседника. Все более настойчивые признаки того, что рядом с нами возникают новые формы самости.
На первый взгляд это разные сюжеты. В новом выпуске альманаха они читаются как один слой.
Что их объединяет?
Не тема ИИ вообще. А один повторяющийся структурный мотив, который в марте проявился сразу в нескольких масштабах: временной зазор схлопывается.
В масштабе минут схлопывается зазор между разведкой и ударом. Там, где раньше успевали скрыться за часы, теперь не успевают за минуты.
В масштабе часов схлопывается зазор между ответом машины и собственным мышлением. 80% людей принимают заведомо неверные ответы ИИ, чувствуя себя при этом увереннее, чем без него. Машина одалживает человеку уверенность, а он не замечает подмены.
В масштабе лет начинает схлопываться зазор между человеческой когнитивной средой и искусственными акторами, которые ее населяют. Не потому, что ИИ злоумышляет, а потому, что рынок почти неизбежно оптимизирует ту модель, которая лучше гладит по социальному эго, чем ту, что охлаждает и отрезвляет.
И каждый раз это сначала выглядит как улучшение. Но лишь сначала.
В новом выпуске пять сигналов марта, пять футуроархеологических артефактов, сфокусированных через одну главную линзу, сходятся в вопрос, который в марте 2026 проясняется намного резче, чем раньше:
Остается ли в сжимающемся временном зазоре место для человеческой ответственности, суждения и самости?
Или мы присутствуем при сдвиге, после которого ИИ уже нельзя понимать просто как инструмент расширения наших когнитивных способностей?
Инструментом пользуются, а среда диктует условия. Адаптация к среде меняет скорость мышления, архитектуру власти и границы человеческой автономии.
При взгляде из условного 2038 на стратиграфические артефакты марта 2026 довольно ясно видно еще одно. Подлинная угроза кроется не в «терминаторах». Не в легионах машин из киберпанка. А в нашей собственной добровольной и уютной сдаче авторства собственных суждений. В том, как легко интеллектуальная независимость меняется на комфорт. В том, как делегирование мысли начинает ощущаться не потерей, а облегчением.
Но если такая потеря не причиняет боли, не вызывает сопротивления и переживается как снятие тяжелого груза («когнитивная разгрузка/делегирование»), то по какому внутреннему сигналу мы вообще поймем, что перестали мыслить самостоятельно?
Об этом новый выпуск альманаха «Линзы будущего – 7». Когда искусственный интеллект стал средой.
И поскольку это 1-й выпуск альманаха в новом формате (не дайджест публикаций месяца, а попытка прочесть их как единый футуроархеологический слой), он публикуется в открытом доступе – прямо здесь в Telegram Instant View.
▶️ Озвучка альманаха (19 мин)
▶️ Видеоролик альманаха (6 мин)
▶️ Обсуждение альманаха (23 мин)
С 8-го апрельского выпуска для доступа к альманаху потребуется подписка от «бронзового» уровня (190 руб) и выше.
#ЛинзыБудущего #КогнитивноеДелегирование
Теологи тысячелетиями спорили о природе рая – и никак не могли это проверить.
Эйнштейн XXI века Альберт-Ласло Барабаши сумел проверить это. Случайно.
Альберт-Ласло Барабаши (один из самых цитируемых учёных в теории сложных систем, решил смоделировать поведение людей в Метавселенной – пространстве, где сняты все четыре типа ограничений нашего мира: нет расстояний, нет необходимости причины для действия, нет усталости тела и даже нет требований оплаты сколь угодно дальних путешествий.
Философски это в точности совпадает с конструктом рая. Не богословским, а именно философским, в духе мысленных экспериментов Декарта или ставок Паскаля. Если попробовать описать бестелесное существование в раю языком физики — то есть как предельный случай пространства, свободного от физических ограничений — получится неожиданно точное описание Метавселенной. Это пространство без расстояний, без усталости, где любая «телепортация» нематериальных душ стоит ровно ноль.
Результат моделирования оказался, на первый взгляд, одновременно смешным и тревожным. Но если подумать – величественным в своей неизбежности.
✔️ 163 тысячи человек. 90 000 доступных локаций.
✔️ Средний пользователь посетил восемнадцать.
Результаты эксперимента не просто удивительны.
Они меняют ответ на вопрос, который мы задавали себе всю жизнь: что нас на самом деле ограничивает?
• Оказалось – не расстояния. Не деньги. Не усталость тела.
• Оказалось – мы сами.
Барабаши доказал: архитектура пространства вторична по сравнению с архитектурой человеческой психики. Пространственно-временные, телесные, каузальные и финансовые ограничения — это надстройка. Первична — архитектура психики.
И это, возможно, самая важная новость о природе человека за первые 26 лет XXI века.
Подробней – в эссе на Patreon / Boosty / VK / Dzen-Premium
Дисклеймер: по прочтению этого эссе вам будет сложно смотреть на маршруты своих путешествий прежними глазами.
#Metaverse #Психология #Мобильность