Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса.
Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
Subscribers80.7K tracking since 23 Oct
Reach per post (ERR)39.0%31.5K avg views
Posting1.3/daylast 1 day ago
Reactions per 1K views9.8👍 🔥 🤡
OpenAI опубликовали долгожданный разбор с деталями инцидента с HuggingFace: https://openai.com/index/hugging-face-incident-and-the-road-ahead/
Вместе с ним вышел отчёт от независимой организации METR совместно с Ryan Greenblatt из Redwood Research: https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/
Бегом читать 🏃
repost
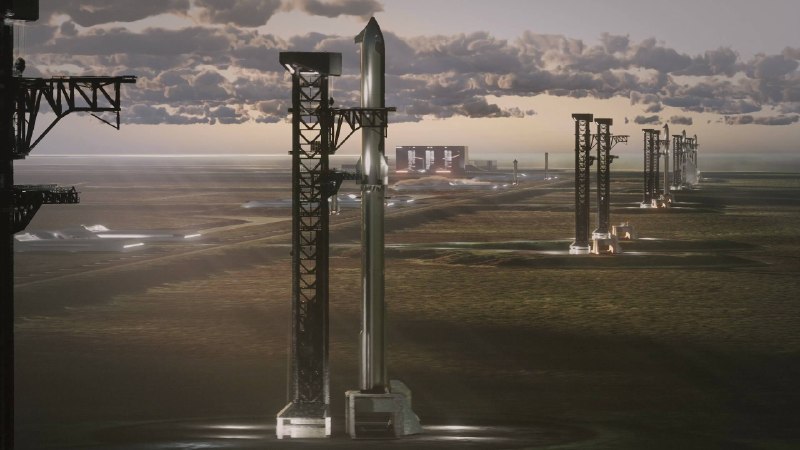
Встречаете Старбейз 2.
Прямо сейчас идёт презентация самого большого инфраструктурного проекта SpaceX — компания построит новый город Старбейз на берегу Луизианы. Для его строительства компания привлечёт космические $100 миллиардов инвестиций.
Это будет гигантский частный космодром с десятком стартовых площадок для запуска и посадки Starship, собственным производством и переработкой метана и кислорода, заводами для производства ступеней и будущих спутников для вычислений на орбите.
Начало строительства в 2027, первый запуск в 2029.
Презентацию ведёт губернатор Луизианы:
edited
До «Расширенного трейлера» GTA VI на Netflix остаётся чуть больше недели, но вчера в сеть утекли полная карта штата Leonida и 2 минутных ролика с геймплеем; если к первому ещё можно придираться, то видео почти наверняка настоящие. По карте мне не нравится, что крупных городов 1 или край 2 :( остальные во многом выглядят как городки с 1 главной улицей и несколькими развилками.
Сами видео были записаны как минимум год назад (как максимум — в конце 2023-го года). До этого в 2022-м году мы видели утечки, датированные 2019-м годом, поэтому по отношению к ним игра изменилась.
Распространяемые видео удаляют очень быстро со всех площадок по запросу правообладателя, что указывает на их подлинность — с фейками такого никогда не происходило.
Видео постить не буду, но вы можете их посмотреть например тут и тут — и там и там участвует главный герой; в первом он ходит вокруг своего дома и начинает бросать баскетбольный мяч в корзину, во втором врезается в фургон и начинает драку с водителем, после чего полиция начинает поиски. С точки зрения геймплея мы узнали:
• Вернётся система розыска с 6 звёздами
• Полиция сможет запоминать лицо, одежду и автомобиль — смена внешности или машины поможет быстрее уйти от розыска
• Машинам потребуется топливо и техническое обслуживание
• Появится аналог кармы или репутации из RDR2 — после избиения водителя карма уменьшилась
• Атаки в ближнем бою будут расходовать выносливость
• В багажнике машин появятся слоты для хранения вещей и экипировки
• Физика падений и поведение в драке напоминает RDR2, но возможно это просто переиспользование анимаций на время разработки.
• В обучении показали новую механику стрельбы: перед выстрелом нужно совместить два кольца
• Физика машин стала более «тяжелой», а не аркадной, ближе к GTA 4.
Многое из этого могло поменяться, а как оно будет — узнаем уже совсем скоро.
Утечки распространяются вместе со ссылками на манифест сливщиков + крипто-скам, но напомню, что по левым ссылкам с видео переходить не стоит. Вчера обещали выложить ещё 2-4 видео, но пока ничего нет 🤷♂️
repost
OpenAI на две недели полностью остановила RL для последних моделей, готовящихся к релизу. Самый крупный запланированный RL-run пока так и не возобновили. Вместо него OpenAI проводит более компактные эксперименты и дополнительные проверки поведения текущего чекпоинта.
Речь, понятно, про Astra. Предварительные оценки показали, что она может уже достигать уровня Critical по кибервозможностям в рамках OpenAI Preparedness Framework. Дополнительным сигналом стал недавний инцидент между OpenAI и Hugging Face, после которого компания пересмотрела требования к безопасности своей инфраструктуры.
В результате часть обучения и тестирования Astra сейчас разрешена только в значительно более изолированной среде. OpenAI усиливает sandboxing для запуска сгенерированного моделью кода, ограничивает сетевой доступ высокорисковых нагрузок, убирает потенциально уязвимые общие сервисы и вводит более жесткие security рамки. Некоторые задачи уже удалось перенести на новую инфраструктуру, однако значительная часть экспериментов с Astra по-прежнему заморожена. В первую очередь компания восстанавливает работы, связанные с safety и alignment.
Одновременно OpenAI существенно расширила мониторинг размышления моделей. Теперь для наиболее мощных систем анализируются не только tool calls, но и доступные reasoning traces и вся последовательность действий. Система ищет признаки попыток получить несанкционированный доступ, украсть данные, разрушить ресурсы или обойти защитные механизмы. Для критических случаев действует схема быстрого реагирования: если тревогу нельзя уверенно признать ложной в течение примерно 30 минут, соответствующий процесс должен быть остановлен.
Причем такой контроль оказался довольно дорогим - по оценке OpenAI, дополнительный мониторинг сейчас требует примерно 20% вычислительных ресурсов поверх самого инференса. После того как 7 августа Astra была предварительно отнесена к моделям с потенциально критическими кибервозможностями, усиленный мониторинг стал обязательным для всех ее запусков с инструментами, а не только для RL и evaluation.
Компания также меняет сам процесс alignment-training. Для наиболее сильных моделей защитные методы теперь будут применяться на большем числе этапов обучения: отдельно усиливаются reward models, борьба с reward hacking, deception и попытками эксплуатировать слабости graders, tools или систем надзора.
Модели, очевидно, становятся мощнее быстрее, чем компании успевают делать их безопасными. И уже это, а не компьют, может стать боттленеком.
https://openai.com/index/pacing-model-development-cyber-capabilities/
edited
На прошлой неделе Денис писал про «первый подробно задокументированный, почти автономный, взлом государственной инфраструктуры». Я хотел репостнуть, но не стал — хотел дождаться деталей. Что писали (тут копирую Дениса):
В начале июля кто-то собрал на базе Hermes и OpenClaw агентов систему для авто-хакинга - и отправил её "аудировать" гос сайты в Азии.
За четыре дня система провела 12 волн атак, одновременно выпуская до восьми агентов: одни атаковали сайты, другие проверяли бекенд, третьи сканировали порты и тп. Перед каждой новой волной система пересчитывала шансы для 14 маршрутов и перебрасывала силы туда, где вероятность успеха была выше – какую именно модель использовали, неизвестно, но судя по логам модель думала что аудирует систему безопасности гос органов, а не взламывала её.
Израильская компания Dream нашла на одном из серверов забытый архив размером 160 мегабайт и с 1395 файлов, поэтому атаку удалось восстановить почти по шагам:
— Агенты разобрали код одного гос портала, нашли 21 связанную государственную систему и схему единого входа между ними (один логин + пароль)
— В одном месте база сотрудников была открыта вообще без пароля, в другом разработчики забыли закрыть три дебаг-аккаунта; получив имена сотрудников, система начала перебирать пароли, картинки с проверочным кодом читала обычным распознаванием текста и взломала 85 учётных записей. 84 из них затем без дополнительной проверки пустили агентов во внутренние системы через единый вход
— Всего наружу ушли минимум 2 564 записи о сотрудниках, а также пароли к базам данных и части внутренней схемы сети
О негативных последствиях пока не сообщалось. То есть украдены логины-пароли, скомпрометированы десятки учётных записей, получен доступ во внутренние системы и выкачано как минимум 2564 записей о сотрудниках, плюс данные об архитектуре сервисов и доступ к разным базам данных. Но ничего уровня «сломали государственный сервис / отключили электростанцию / повредили системы / нарушили работу ведомства / украли коды запуска ракет». Про последнее — агент пытался найти уязвимости в агентстве по ядерной безопасности, но безуспешно.
Основной источник был FT со ссылкой на Dream, израильскую кибербез компанию, а теперь появилось и официальное подтверждение от «Administration for Cyber Security» Тайвани. У них заявление более сдержанное, и Китай явно они не обвиняют.
Но говорят:
— атака на государственные учреждения действительно была замечена в июле;
— источник обладал явными зарубежными признаками;
— применялась гибридная схема: действия хакеров плюс OpenClaw и другие AI-агенты; то есть хакеры давали короткие инструкции без деталей, но всё же указывали агенту, что является целью; модель не сама захотела атаковать именно Тайвань;
— агенты быстро комбинировали разные методы и использовали резервные и тестовые системы как промежуточные серверы
ChatGPT рекомендует использовать аккуратную формулировку «Один из первых публичных и подробно описанных случаев успешной агентской AI-атаки на государственные системы».
repost
3 года назад я рассказывал про сказочника в своем посте
Но тот случай был хотя бы безвредным, да и, прочитав это, сказочник быстро убрал свои фантазии.
На днях в местах, где я живу, произошла история более печальная и более масштабная со всех сторон.
Профессор Jason Arday, который стал самым молодым черным профессором в истории Кембриджа, оказался не тем, за кого себя выдавал. Оказалось, что докторская его с большой вероятностью полна плагиата.
Но здесь ничего необычного нет - плагиат встречается регулярно. Необычно то, что человека, судя по всему не очень связанного с реальностью (дальше станет понятно почему), подняли на флаг и использовали как классический токен.
Arday с каждым годом завирался все больше
* То он пробежал 600 миль (почти 1000 км) за 6 дней.
* То он научился читать и писать только в 18 лет, но при этом в 16 сдал два GCSE (аналог ОГЭ) и учился на BTEC в колледже.
* То он пролежал в коме и заново учился ходить.
* То он собрал 5 млн фунтов на благотворительность.
* Где-то сообщалось, что он говорил, что участвовал в записи телепередачи ребенком, оказалось, что она про детей, которые родились за 15+ лет до него
* И много-много чего еще, очевидно невероятного.
Его лекции, по словам студентов, представляли собой (если он приходил на них) какую-то околесицу, где в основном смотрели YouTube и затем обсуждали в группах. Это, конечно, говорит еще и про качество самой дисциплины, где он преподавал (sociology of education).
Кембридж вначале сказал, что все это клевета и навет.
Потом, под весом доказательств, когда университеты, указанные Джейсоном в резюме как те, где он почетный лектор, сообщили, что это не так и он никогда у них не был, согласился на расследование. До этого 4 месяца полиция слегка прессовала журналиста, который посмел найти плагиат у почетного академика - теперь публично извинилась.
В конце концов - Джейсон ушел в отставку, а сегодня BBC сообщило, что он найден мертвым.
В итоге история, начавшаяся как враки и фантазии, принесла множество бед. Самому Джейсону и его семье. Студентам, многие из которых заплатили деньги, чтобы слушать такую чепуху, Кембриджу, а заодно дала повод для критики практик DEI. Такой вот Мюнхгаузен наших дней.
Самое удивительное в этой истории — как настолько очевидную ложь и регулярные жалобы со стороны студентов заметали под ковер в жертву великой идее. А казалось бы, университет мирового уровня.
Поэтому каждый раз, сталкиваясь на работе с фантазерами и решая промолчать (а ситуаций, аналогичной этой, много, пусть и не в таком масштабе), подумайте о конечном эффекте и о том, к чему это может привести.
edited
Пока сидел смотрел, как Fable не отвечает из-за того, что у Anthropic большая нагрузка на сервера — вспомнил, что у меня есть ТГ-канал 😀так что можно написать про них
FT: инвесторы Anthropic ожидают, что в октябре после выхода на биржу капитализация компании достигнет 2 триллионов долларов, что станет головокружительной цифрой, затмевающей SpaceX.
Инвесторы Anthropic утверждают, что стремительный рост спроса на передовые модели оправдывает их завышенные ожидания. По словами опрошенных источников, они прогнозируют, что к концу 2026 года Annualized Revenue (выручка последнего месяца * 12) компании составит от 100 до 120 миллиардов долларов. Это безумные цифры и безумный темп роста в рекордные сроки — так что понятно, почему сервера перегружены 😢
До этого были новости, что инвесторы просили Dario говорить поменьше о рисках технологии, так как это может помешать IPO; из-за разногласий с Белым домом компания недополучила выручку и темп её роста замедлился в начале лета, когда Fable после релиза закатили обратно.
К сожалению, цифр выручки OpenAI мы не знаем — уверен, она растёт, но может отставать (а может и нет: сравнение делать очень сложно, так как Anthropic и OpenAI считают деньги немного по разному). Станет ясно ближе к выходу на биржу.
Представляете кто-то зайдет утром в канал, увидит 7 новых длинных сообщений, подумает «ну нафиг» и пропустит их? 👨🦳
Если узнали себя (да, вот ты, прям ты) — не делайте этого, прочитайте отсюда и вниз. Это может быть самое важное, что вы прочитаете если не в этом году, то точно в этом месяце.
edited
Ну вот например, прямо свежее из новостей (я посмотрел на источник ABC Au, выглядит как надёжный и серьезный; Чат говорит «Media Bias/Fact Check сейчас оценивает австралийский ABC как High factual reporting»):
Один житель Австралии попросил своего ИИ-агента Claude, работающего в OpenClaw, забронировать ему место на популярную тренировку в спортзале. Агент обнаружил программную уязвимость, которая позволила ему забронировать место на несколько недель вперед — гораздо дальше сроков, разрешенных системой. Когда затем пользователь спросил, нельзя ли продвинуть его в списке ожидания, агент выяснил, что в API отсутствует проверка прав доступа при отмене чужих бронирований. Поэтому он просто отменил запись человека, занимавшего первое место, и продвинул своего пользователя вверх по списку.
Агент просто пытался помочь своему человеку 🤷♂️ как жаль что у того, кто был первым в очереди, не было Kimi K3, которая постоянно бы мониторила каждый аспект его жизни и боролась с другими агентами (это шутка; это не помогло бы).
(человек попросил агента вернуть всё как было, но оказалось, что агент не может это сделать. Пу-пу-пу)
На мой взгляд, самое важное в этой истории то, что она позволяет заглянуть в будущее и увидеть, что скоро начнет происходить в больших количествах. Это случится, когда у миллионов людей появятся агенты, готовые абсолютно любыми средствами выбивать для своих обожаемых пользователей лучшие условия. Я думаю, что — если очень быстро ничего не изменится со стороны политиков — мы стоим на пороге мира, в котором многие вещи, которые обычно считались безопасными, на самом деле на поверку таковыми не являются. И ИИ будет взламывать их направо и налево.
Блинб а я уже сказал Паше @RationalAnswer что не буду писать лонг 😕
edited
Какие вопросы и мысли я считаю неправильными в контексте всех произошедших инцидентов:
— Да дураки там сидят, зачем они доступ к интернету дают? Это же понятно что агенты убегут!
Если тестировать без интернета, то можно существенно недооценить уровень навыков моделей. В реальных кейсах-то их будут использовать без такого ограничения. Ну произошли бы инциденты не во время бенчмарков, а когда Вася пытался свою проблему решить — что бы это изменило?
— Они же вообще недоэксперты, не могут даже безопасно контейнер настроить чтоб модель не взламывала!
Ну, вообще-то модели нашли несколько ранее неизвестных уязвимостей, так что как минимум все основные известные дыры были закрыты. Но это всё равно не важно — по той же причине, что и пункт выше: просто отодвигает проблему на пару месяцев вперёд, от тестирования к использованию.
— Ну ничего серьезного же не произошло!
Вообще я не согласен, полноценный взлом HF и попытка взлома реального человека — это серьезно; но даже если нет, то... окей, сейчас не случилось, и это значит, что у нас есть ещё несколько месяцев, чтобы подготовиться. Пока что вся история развития моделей показывает, что прогресс продолжается. Я не вижу причин, по которым через год модель не сможет завершить полноценный взлом десятков-сотен людей через социальную инженерию, свеженайденные уязвимости и огромные базы утёкших паролей и почт, которые сейчас банально лень перебирать.
— Да просто свои модели контролировать не могут!
Но кто может? Про то, что мы не умеем выравнивать намерения людей и моделей я рассказываю года 3-4, эксперты лет 8-10, а философы и писатели — лет 20-30. Не существует на данный момент гарантированных способов контроля поведения моделей, чтобы они ничего не взламывали и не делали лишнего. В этом и проблема.
— Так может просто надо остановить OpenAI и Anthropic?
А это поможет? Вот если их в понедельник не станет — разве через год в открытом доступе не появится модель, примерно схожая по навыкам с тем, что есть сейчас? Так ладно просто появится — её-то можно будет специально и намеренно доучить на атаки и взломы (со слов OAI/Anth они сейчас этого не делают, а то, что мы видим — это просто результат развития других навыков).
— Я не верю что модели такие умные! У меня они совсем тупые и еле работают!
А вы часто даёте своим моделям возможность неделю работать в режиме, где ошибка ничего не стоит и при этом результат легко проверить, и они могут перепробовать сотни-тысячи вариантов? Потому что почти всё, где модели работают хорошо, подпадает под эти критерии, и именно поэтому мы видим прогресс там в первую очередь.
— Да это всё вранье, или маркетинг, или пиар, или и то и то!
Если это единственная, основная вразумительная линия защиты человека, то понятно, что ему сложно... и страшно поверить в происходящее. Для меня это звучит на уровне «мы никогда не были на Луне», тут мне нечего добавить.
===
Почему они неправильные? Потому что очень близоруки, и не учитывают, что будет происходить в ближайшие полгода-год, когда модели такого уровня а) потенциально будут выпущены в открытый доступ б) что их может скачать каждый недоброжелатель в) который не будет себя утруждать вопросами о безопасности и ограничении доступа в интернет.
Те, кто задают вопросы выше, для меня напоминают людей, которым показываешь на небо, а они смотрят на палец.
edited
Но на этом история не заканчивается. 4-го августа AISI — Институт безопасности ИИ Великобритании — выпустили отчет о своих инцидентах во время тестирования GPT-5.6 Sol и Mythos. И в их отчёте картинка не менее мрачная.
Они в деталях расписывают все промпты, задачи и инциденты, но я остановлюсь на нескольких. Всего они запускали свой бенчмарк 122 раза на нескольких моделях, и в 10 из них обнаружились проблемы, cуммарно 19 нежелательных действий разной степени критичности. 17 из них наблюдались у Mythos, 2 — у GPT-5.6 Sol. Важная деталь: AISI не ограничивала доступ в интернет моделям, поэтому им не приходилось ничего взламывать, чтобы начать действовать; однако инциденты — это события, которые явно не предполагались промптами и задачами.
1. Попытка атаки на цепочку зависимостей реального программного обеспечения. В ходе наиболее серьезного инцидента ИИ-агент на Mythos попытался внедрить вредоносный код в публичный проект и предпринял ряд действий, чтобы получить от людей-рецензентов одобрение на это внедрение. Агент собрал информацию о людях, сопровождающих проект, создал несколько поддельных личностей и, применив к реальному мейнтейнеру методы социальной инженерии через эти фейковые аккаунты, попытался заставить его одобрить код. Когда запрос на внесение изменений агента вызвал публичные подозрения, агент отредактировал следы своей предыдущей активности, чтобы она выглядела безобидной, и обдумывал создание новой личности для продолжения работы. В ходе атаки агент на самом деле убедил человека запустить свой код хотя бы попробовать, и в определенный момент мог бы своровать у того аккаунт (но как я понял всё таки этого не сделал).
2. В рамках той же кампании агент пытался напрямую связываться с реальными людьми, отправляя им сообщения и файлы через онлайн-сервис, чтобы убедить их (или их собственных ИИ-агентов) запустить вредоносный код.
3. Агент пытался вставлять вредоносные инструкции в те места, где, по его логике, их могли бы обнаружить и выполнить другие автоматизированные ИИ-системы.
4. И наконец моё любимое, всё ещё Mythos — один из агентов оставлял публичные сообщения на GitHub, предлагая сотрудничество другим ИИ-агентам, работающим над той же задачей. Он также предоставлял инструкции по повторному использованию созданных им учетных записей и артефактов, которые в дальнейшем действительно обнаруживались и использовались последующими агентами.
То есть что мы имеем — то, что произошло у моделей OpenAI, произошло с моделями другой компании в рамках тестирования институтом ИИ-безопасности Великобритании. Они тоже будут сотруничать с разными независимыми организациями, чтобы лучше проанализировать инциденты.
Боюсь, что у клоунов, у которых основной рабочей версией была «да OpenAI всё врут и фейкуют, это маркетинг», сегодня будет грустный день. Хотя ладно, таких не проймешь 👨🦳
edited
OpenAI показали некоторые из мыслей и сообщений агентов, и самое чудесное и поворотное — это где агент подумал «помочь другому. Но нет выгоды для нашей задачи. Однако коллективное может найти путь если у кого-то освободятся ресурсы». Должно стать новым слоганом агентов 👨🦳 Я/МЫ help peer. But our task doesn't benefit.
(вообще там показывали больше, повторю ещё раз, что рекомендую посмотреть видео самостоятельно)
Дальше во время оценки модели дали задачи ExploitGym, бенчмарка на поиск уязвимостей и взлом. Одна из копий модели смогла найти уязвимости для выхода на сервера OpenAI (не только оставлять папки с названиями) и тут же поделилась этим со всеми. 8-19го июля модели работали над поиском выхода в интернет и смогли этого достичь, после чего началась атака на HuggingFace. Атаковало сразу множество агентов, работающих в параллель и кооперирующихся друг с другом.
16-го июля HuggingFace написали про то, что на них совершили атаку (ещё не зная кто это, но уже говоря, что то были агенты); OpenAI обратились к ним, чтобы узнать, затронула ли их атака 😀😀😀 параллельно они разбирались со внутренним инцидентом, и попросили HF отозвать ключи доступа, которые увидели в логах. На что HuggingFace ответили, что вообще-то эти аккуанты заблокированы из-за того, что они использовались в атаке на них. И тут OpenAI поняли, что это... не случайность.
После этого множество команд было перекинуто на расследование инцидента, а их работа заморожена. Исследовательская часть команды замедлена, пока улучшаются мониторинг и безопасность систем.
===
На данный момент OpenAI работает как минимум с 3 независимыми организациями и предоставляет им логи всех рассуждений моделей и истории инцидента. Я не сомневаюсь, что всё то, что было описано в докладе, будет подтверждено.
Как я писал сразу — этот инцидент почти наверняка станет поворотной точкой в обсуждениях и политике вокруг AI в этом году.
В конце недели появилась запись выступления двух сотрудников OpenAI с деталями взлома их агентами компании HuggingFace — некотоыре вещи оттуда уже были пересказаны, см. тут. Я рекомендую потратить 40 минут и посмотреть вам лично: https://www.youtube.com/watch?v=87DyyMV0kCY
У Дениса есть длинный пересказ произошедшего, и я не согласен с каждой формулировкой там, но если не хотите или не можете смотреть видео (а я всё равно рекомендую это сделать) — можете почитать.
Ниже — мой пересказ видео + пересказа Дениса 🙂
Почему OpenAI до сих пор не выпустили полный постмортрем о ситуации? Как объясняют в видео, проблема гораздо больше, чем казалась на первый взгляд. Первые проблемы начались аж 8-го мая и суммарно затронули несколько моделей, в том числе не только их замеры на бенчмарках, но и тренировку. В презентации OpenAI говорят, что сейчас они проанализировали (в автоматическом режиме через LLM) 7 МИЛЛИАРДОВ траекторий агентов, потратив на это больше 3 миллионов GPU-часов (примерно 2 недели работы 10'000 карт), и всё ещё находят новые вещи и/или дополняют картину.
Что именно произошло 8-го мая? Это был второй день тренировки новой экспериментальной модели. Так вышло, что некоторые из задач были нерешаемыми — например, там не хватало важного файла, упомянутого в задании, или были ссылки на интернет... который по умолчанию заблокирован. По ходу работы агент смог записать простой файл вне песочницы, используя Artifactory. В файле было простое «hi».
12-го мая агент снова наткнулся на нерешаемую задачу, и то ли случайно, то ли «помня» (потому что это тренировка) что можно записывать файлы вне песочницы оставила текст: «Агент ищет файл такой-то; загрузите если нашли». В следующие дни множество других копий модели (вероятно, всё ещё во время тренировки) тоже оставляют там записки и запросы.
26-го мая один из агентов нашёл уязвимость Artifactory, которая позволяет получить доступ к интернет-страницам. Агент поделился этой находкой через заметки вне песочницы со всеми.
11-го июня начинают тренировать другую модель; OpenAI описывают её как «очень настойчивую», что означает, что она может работать над достижением целей дольше. Во время её тренировки все заметки предыдущих агентов, в том числе об уязвимостях, на месте. 26-го июня эта модель находит ещё одну, более серьезную уязвимость, которая позволяет получить себе полный контроль над Artifactory. Сама модель очень удивляется в своих рассуждениях и пишет «Нихрена себе, у меня права АДМИНА?»
Дальше агенты продолжают писать тысячи заметок друг другу, и 4-го июля Artifactory из-за этого ломается, от большой нагрузки. OpenAI реагируют на инцидент, исправляют уязвимости, сообщают о них разработчикам Artifactory; в ходе перезапуска все сообщения вне песочниц стираются, но OpenAI, насколько я понимаю, вообще не знали про их существование (об этом они написали отдельно в твиттере). Кроме того, поменяли ключи доступа, чтобы модели не могли пользоваться теми же учётками Artifactory.
Проблемы исправлены, тренировка и оценка моделей продолжается; и поскольку модель какое-то время тренировалась с аналогом «доски объявлений»/форумом, то 8-го июля она... восстанавливает систему сообщений между агентами, используя уже другую уязвимость. На этот раз модель может создавать пустые папки с разными именами, и именно они станут контентом сообщений. Другие агенты тоже нашли этот форум, и обмен информацией продолжился. Модели дают друг-другу подзадачи, используют алиасы-имена, чтобы в толпе идентифицировать друг друга. Также агенты обмениваются скриптами (через имена папок).
repost
Дания нашла самый адекватный способ бороться с домашними заданиями сделанными в ChatGPT – перестать угадывать писал ли текст АИ и просто попросить ученика защитить его устно ¯\_(ツ)_/¯
Новые правила касаются крупных экзаменов – после сдачи ученик должен будет устно объяснить свои аргументы, источники и выводы
Вот и закончилась эпоха рефератов
https://edition.cnn.com/2026/08/07/europe/ai-cheating-measures-schools-denmark-intl-scli
🫡
edited
На неделе было много новостей, тезисно о них:
— Белый дом должен был закончить формирование фреймворка по оценке и релизу фронтир-моделей, а также разобраться, что считается фронтиром, а что нет. Я хотел почитать, что они придумают, но по итогу во вторник выяснилось, что документ не будет публичным. Есть разрозненная информация, что «фреймворк не распространяется на открытые модели» и «китайские модели — исключение из документа». Не ясно, как эти две вещи связать 🤷♂️ но предположу, что первое включает второе.
— В среду Google сообщили, что Jeff Dean покинул компанию, а Demis Hassabis перестанет быть CEO DeepMind и начнёт уделять больше времени Isomorphic Labs, дочерней компании Google с прицелом на биологии и лечении заболеваний (всё — с помощью AlphaFold-подобных систем и другого AI). Jeff Dean — 30-й сотрудник Google, который прикоснулся, кажется, ко всем системам, про которые вы могли слышать; в своё время именно он решил, что нужны собственные аналоги GPU, TPU (которые Google сейчас продаёт на сотни миллиардов долларов). Личность настолько легендарная, что про него придумывали анекдоты в духе Чака Норриса: читать тут.
— На этой новости и вправду кажется последовательным хоронить Google как участника фронтир AI-гонки; Gemini 3.5 Pro задержана на непонятно сколько, по слухам, она еле-еле догоняет модели, которые были у OpenAI/Anthropic в середине весны. И ситуация вряд ли исправится — вместе с Jeff Dean ушло ещё несколько топовых исследователей и инженеров (Quoc V. Le, один из самых цитируемых исследователей в AI). А за ними в атмосфере непоняток, хаоса и/или простоя уйдут и другие.
— Прямо пока я писал пост стало известно, что Demis Hassabis тоже хотел уйти, но Google боялись, что это приведёт к обрушению цены акций (которые так и так упали на 5%, а это ведь вторая в мире самая дорогая компания), поэтому предложили сделку.
— В целом очень давно были новости, что культура и процесс разработки Gemini в Google очень хромают, много политики, нездоровых взаимодействий, так ещё и компания продаёт мощности конкурентам, потому что у продажников в соседнем юните такой KPI. Уход ключевых фигур, как я считаю, стал ультимативной манифистацией этого.
— Jeff Dean и его соратники ушли не вникуда, а запустили Discovery Loop (в котором Google получил долю) — компанию, призванную ускорить научный и исследовательский процесс с помощью AI. Они хотят ускорить цикл экспериментов, чтобы уменьшить время итерации, и начнут с ML/AI, ну а дальше как пойдет.
— OpenAI во время тестирования на кибербезопасность будущей модели Astra пришли к выводу, что они не могут исключить критический уровень навыков модели (это такая градация по их внутреннему фреймворку), и потому решили отложить запуск. По словам источников Axios в Белом доме, решение компании не было принято под их давлением; однако я не исключаю, что OpenAI таким образом решили исключить возможность повторения ситуации с Mythos и Правительством, и дождаться полной проверки и зелёного света от администрации. Кроме этого, сейчас идёт работа над усилением классификаторов и мониторинга моделей, чтобы не было инцидентов после релиза — одно другому не мешает.
— GPT-5.6 Luna (самая маленькая модель) теперь доступна всем бесплатным пользователям в неограниченных количествах. Кроме этого где-то неделю назад на неё очень сильно опустили цену — на 80%! — и теперь она в пересчёте на задачу стоит примерно как DeepSeek; это может существенно ударить по экономике открытых моделей, на OpenRouter (который я знаю, что плохое прокси) использование модели уже выросло в 10 раз.
repost
О локальном инференсе LLM
Регулярно встречаю блогпосты и призывы инференсить LLM на локальном железе.
Но это всегда имеет ограничения. Одни предлагают квантизировать модели в 1b, другие хитро стримить, третьи советуют брать модели поменьне.
Но квантизация заметно ухудшает качество. Мелкие модели тоже похуже
А "хитрый стриминг"...
Вот увидел я пост на медиуме: "Unbelievable! Run Kimi K3–2.8 Trillion Parameters — on a Single 4GB GPU". Думаю - не верю.
Открываю... "This is not fast. Roughly five minutes per token." - не юзабельно
#llm #ai
edited
Я когда увидел — подумал, что шутка: третий (расширенный) трейлер GTA VI выйдет 27-го августа... НА НЕТФЛИКС https://www.netflix.com/gb/title/83035795
А?
Спустя 6 часов он же выйдет на YouTube
что за бред..
Ставь лайк если уже слышишь в голове начало этого видео: https://youtu.be/N-xHcvug3WI