Я хотел написать в новости «если бы эту уязвимость нашёл рой агентов (и начал эксплуатировать), то я не исключаю, что как минимум некоторые провайдеры и/или некоторые регионы были бы полностью отключены от интернета», но подумал, что это может быть преувеличением. Reuters: голландское агентство по кибербезопасности отключило свои сервисы, заявив, что сделало это в качестве меры предосторожности из-за выявленных уязвимостей. В Нидерландах несколько организаций последовали примеру Национального центра кибербезопасности и отключили свои общедоступные сайты. Среди них — порт Роттердама, государственный портал Overheid.nl, Королевский футбольный союз Нидерландов (KNVB), сайты пяти крупнейших политических партий страны, а также нескольких больниц. Датская муниципальная ИТ-компания Kombit отключила несколько сервисов, включая национальную платформу для общения школ с родителями и учениками, сообщил Reuters представитель компании. В Финляндии перебои оказались ещё более масштабными. Государственный поставщик ИТ-услуг Valtori сообщил, что государственные сетевые сервисы были отключены «в качестве меры предосторожности». Министерство внутренних дел Франции заявило, что временно отключило сайты местных органов власти до выхода исправления безопасности. === Но пока что отключения происходят только для того, чтобы злоумышленники (в основном, люди) не воспользовались уязвимостью во время обновления систем (и обновление уже было заранее подготовлено и вышло), то есть очень краткосрочно, скорее всего завтра всё включат. (но куча мелких и/или полузаброшенных сайтов не успеют обновиться, и их начнут ломать)

Сиолошная
Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса. Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
-
edited -
edited 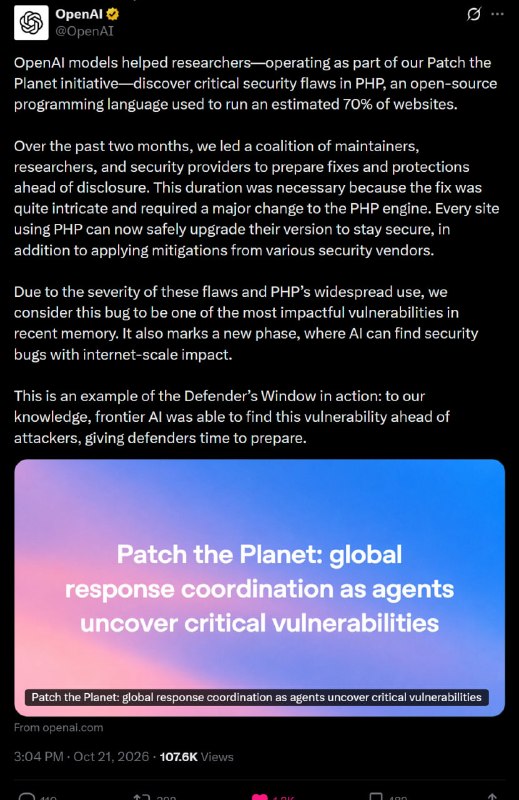
Уязвимости, конечно, нашли не люди: https://openai.com/index/coordinated-disclosure-of-critical-vulnerabilities/ (пишут, что Sol-5.6, то есть достаточно старая и «слабая» по меркам текущего фронтира модель) > Учитывая серьезность этих уязвимостей и широкое распространение PHP, мы считаем это одной из самых серьезных проблем безопасности за последнее время. Она подчеркивает, как ИИ может выявлять уязвимости безопасности, имеющие масштабы, сопоставимые с интернетом, но те же возможности могут также помочь злоумышленникам быстро разрабатывать инструменты и эксплойты для атак. Это была двухмесячная инициатива OpenAI и группы специалистов по информационной безопасности из разных компаний и проектов. В целом можно сказать «отскочили», так как уязвимости нашли белые, а не чёрные шляпы или ИИ-агенты, которые могли бы положить половину интернета — как недавно предрекал Dario Amodei 😳 но сколько таких уязвимостей ещё осталось?
-
repost Кажется, у безопасников сегодня будет очень длинный день: команда PHP готовит исправления сразу для двух критических уязвимостей, обе с оценкой 9,2 из 10 по CVSS 4.0, а релиз назначен на сегодня, 21 октября, в 14:00 UTC (16:00 в Амстердаме, 17:00 в Москве) Друзья из пары банков говорят, что у них уже все на панике, а некоторые подсистемы собираются просто отключать от интернета, так что Monster/Red Bull для PHP-команд безопасности сегодня вполне можно проводить как производственную необходимость Если у вас есть доступные из интернета приложения на PHP, предупредите тех, кто за них отвечает: разработчики просят подготовиться к обновлению сразу после релиза, а технические подробности и список затронутых версий опубликуют вместе с патчами https://www.php.net/index.php#2026-10-20-1 Кто бы мог подумать, что у технологии с названием "Personal Home Page" могут найти пару жестких дыр с помощью АИ ☕️
-
repost 🚀 Ловле Starship быть! Выступая на финансовом отчёте Илон Маск и Гвинн Шотвелл подтвердили, что уже в следующем запуске Starship SpaceX попробует поймать башней и корабль, и ускоритель. Для этого компания уже сейчас ведёт переговоры с регуляторами для получения разрешения на возврат обеих ступеней в Starbase. Главный инженер оценивает вероятность успеха как "скорее да, чем нет", а сам запуск по прежнему запланирован на ноябрь. Заранее скрестим пальцы на удачу 🤞 Также SpaceX показала анимацию возврата корабля на башню, а также поделилась рекапом Starship Flight 14. #SpaceX #Starship #Flight15 #B22 #S42 🦅 📰 Подпишитесь на 📱 @SpaceX_rus и 📱 наш YouTube!
-

Встречайте — Сиолошная Каждый День Новости про ИИ я читаю каждый день, но не каждый день я могу ими делиться тут в канале. Каждый пост требует вдумчивого чтения, проверки, в идеале объяснение и/или предоставления контекста, а времени на это не всегда хватает. Какие-то новости (чаще скрины твитов) я скидываю к нам в чат, но в потоке обсуждений и комментариев что-то теряется. Скидывать ссылки/картинки и писать «ну э смотрите» или «прикольное» — не формат этого канала. Поэтому решил сделать простой канал, куда буду спамить что-то, чем можно было бы поделиться или что можно обсудить, но без детального объяснения и мыслей. Посмотрим как пойдет, может надоест и перестану делиться там, вернусь в чат🤷♂️ @seeallochnaya_kazhdi_den — внутри вас уже ждёт три (ТРИ!) поста про DeepSeek
-
В это сложно поверить, но ровно через месяц, в этот день в этот час, я, как и десятки тысяч других людей, наконец-то буду запускать GTA VI. Почти дождались, а пока — вот вам трек дуэта Justice, который занимался написанием оригинального саундтрека к игре. Первый трек у них вышел невероятным, слушаю последние 3 дня, из головы не выходит. Надеюсь, что и остальные будут такими же — последней игрой, из которой я забрал себе 5+ треков, была Deathloop в 2021-м, it's been a while!
-
repost Из сессий с агентами получаются готовые evals Каждый раз, когда выбираю сетап для кодового агента, я немного гадаю. Лучше ли эта новая модель? Помогает ли больше reasoning? Помогают ли эти скиллы? Поэтому из ~1270 своих сессий в Claude Code, Codex и Pi я собрал 10 задач с автоматической проверкой и прогнал на них разные сетапы. Сделал пару публикаций про это, у меня спросили про то, как такое сделать самим. Поэтому вот! Написал гайд + скилл, который делает большую часть работы 📊 Гайд: https://teletype.in/@ibragim_bad/fm5jSJvYb_5 🛠 Скилл: https://github.com/ibragim-bad/evals-from-sessions 🏆 Лидерборд: https://ibragim.dev/leaderboard/ оригинал в X: https://x.com/ibragim_bad/status/2111102467924496721?s=20
-
repost 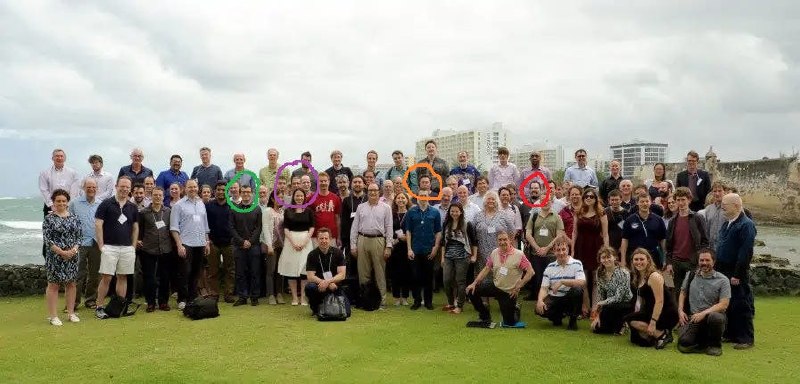
Прикольное фото с первой большой конференции по AI Safety в 2015 году. Слева направо обведены: Демис Хассабис, Илья Суцкевер, Илон Маск (через пару месяцев эти двое создадут OpenAI), Элиезер Юдковский. Это из хорошей статьи Скотта Александра про то, почему тезис "нагнетание паники вокруг рисков ИИ является всего лишь корпоративной уловкой для разгона капитализации AI-лаб" очень плохо согласуется с фактами: https://www.astralcodexten.com/p/ai-safety-is-not-a-corporate-plot
-
repost BREAKING: ROCKSTAR ОПУБЛИКОВАЛА РЕЛИЗНЫЙ ТРЕЙЛЕР GTA VI
-
edited 
Пока что самым сильным индикатором уровня задач, решения которых выложили OpenAI, является эта история. Hugo Duminil-Copin, математик, получивший Филдсовскую премию в 2022-м году, поделился, что плакал после того, как увидел релиз OpenAI, настолько громко, что разбудил дочь. Среди решённых задач были как минимум 16 тех, над которыми он сам работал (и видимо какое-то время не мог решить) — что для меня является показателем их близости к актуальному исследовательскому уровню и прокси к их сложности. «Они уничтожили мою область исследований», — заявил он на видео-конференции. Он также показал слайд, на котором был изображен кролик, раздавленный несколькими грузовиками. «Они хотели доказать, что могут нас уничтожить». Ситуация грустная, но что поделать 🤷♂️
-
По результатам общения с Пашей решил уточнить, что я имел в виду про маржу в 85% (которая в исходном посте была 15%, но потом я поправил). По оценке от GPT выше к 2032 году на OpenAI и Anthropic может приходиться около 85 ГВт дата-центров из примерно 185 ГВт, рассматриваемых в статье. Если пропорционально масштабировать расчёты автора, для окупаемости этих мощностей с доходностью 10% понадобится около $855B операционного денежного потока ежегодно. Дальше всё зависит от маржи: - 50% (сценарий автора) — необходима выручка $1,71 трлн, из которых $855 млрд уйдут на операционные расходы. - 75% — $1,14 трлн выручки и $285 млрд расходов. - 80% — $1,07 трлн выручки и $214 млрд расходов. - 85% — $1,01 трлн выручки и $151 млрд расходов. Показатель «маржи» тут рассчитывается до капитальных затрат. То есть расходы на покупку GPU и строительство дата-центров — а это самые большие траты! — в этом расчёте будут учтены отдельно, а здесь мы смотрим, сколько денег может уходить на непосредственное функционирование бизнеса. "85%" маржи в контексте поста и разбираемой статьи не значат те же 80-85%, про которые можно читать на условном SemiAnalysis (там это маржа по отношению к компьюту и только). И вот я говорю: я не думаю, что OpenAI и Anthropic в сумме будут требовать $855B операционных расходов в год. Это безумно много — для масштаба можно посмотреть, сколько тратят крупнейшие компании мира на операционную деятельность сверх себестоимости продаж (цены товаров). По отчётности за 2025 год: - Amazon — $281B, при 1,58 млн сотрудников. - Walmart — $148B, при 2,1 млн сотрудников - Alphabet — $111B. - Meta — $82B. Понятно, что они не оперируют таким большим количеством ДЦ (85 ГВт у них нет), но с другой стороны они трудоустраивают огромное количество (пусть и менее высокооплачиваемых) людей. В Alphabet работает примерно 60000 программистов — и вот на них, и на остальные операционные расходы, включая текущие датацентры, уходит $111B. OpenAI и Anthropic не будут вырастать до такого масштаба по размеру штата. И вот поэтому мне кажется, что $855 млрд ежегодных расходов помимо капитальных затрат — цифра настолько большая, что предположение о 50% марже хочется как минимум подвергнуть сомнению. Я не утверждаю, что маржа обязательно составит 85%. Возможно, она будет 80%, а возможно, 75%. Но даже при 75% годовая выручка, необходимая для окупаемости этих мощностей, оказывается на треть ниже, чем при 50%. При 75%, как написано выше, две компании должны иметь выручку примерно ~$1,14T в год — в 8.2 раза выше текущей.
-
edited Я уже давно уговариваю Пашу @RationalAnswer сесть и написать глубокий анализ финансовой составляющей ИИ-индустрии, расходов на строительство ДЦ, закупку карт, как это соотносится со спросом итд. Вот чтоб прям основательно. К сожалению, пока к этому не пришли, поэтому придется делать разбор статьи Financing the AI Buildout, подготовленной для BPEA (авторитетный академический журнал и конференция по макроэкономике). Признаюсь, что я не читал все 29 страниц, а выборочно глянул самое интересное, поговорил с GPT и составил для себя такое понимание их модели: 1. К 2032-му в США планируется ввести в эксплуатацию 183 ГигаВатта датацентров. 2. 1 ГВт ДЦ стоит примерно 41 миллиард долларов (примерно соответствует другим оценкам, которые я видел). 3. Отсюда с учётом инфляции приходят к цифре суммарных затрат $8.5T 4. С учётом стоимости капитала (проценты, которые можно было бы получать в других инструментах) в 10% годовых выходит, что чтобы окупить затраты, нужна выручка в $9.6T (за все годы, размазанная на время жизни оборудования), или ~$1.86T в год в 2032-м при росте, пропорциональном росту мощностей. 10% годовых это много — 30-летние облигации США сейчас дают 5.6%, поэтому условная META может привлечь финансирование для своего датацентра Hyperion под 6.58%. Но я писал выше в канале, что из-за прибыльности инференса ИИ ставка может разгоняться (и что это может быть плохо для экономики). 5. Дальше автор предполагает целевую маржу операционного денежного потока в 50%, поэтому цифру $1.86T умножает на два и получает $3.73T выручки от AI в год — столько нужно будет получать индустрии, чтобы окупить затраты на инфраструктурный бум ИИ. 6. Но это в свою очередь означает, что на выручка от AI должна быть ~9.2% от ВВП США, то есть ОЧЕНЬ много. Для сравнения, это масштаб, сопоставимый со всей обрабатывающей промышленностью. Финансы и страхование сейчас 8.1% ВВП США, недвижимость и аренда — 13.7%. В целом логика понятная и цифры более-менее не притянуты с потолка. Мне кажется, что с одной стороны выручка и вправду может быть такой (и даже больше), но при этом если мы говорим про «просто отбиться и существовать, а не прогореть», то: 1. Компании необязательно будут ориентироваться на маржу операционного денежного потока в 50%. Она может оказаться существенно выше, если основная часть расходов на инфраструктуру будет капитальной (CapEx), а текущие операционные расходы — зарплаты, офисы и прочее — будут расти значительно медленнее выручки. Например, при марже 85% необходимая годовая выручка снижается до $2,14 трлн — на $1,6 трлн меньше, чем в исходном сценарии. 2. Я действительно не думаю, что все, кто сейчас планирует строить датацентры, построит их. Кто-то действительно прогорит и не сможет вытянуть — я лишь думаю, что это не будут OpenAI, Anthropic, и скорее всего Meta / Google, может даже SpaceX. 3. По текущим планам Astra 6 Pro насчитала, что к 2032-му OpenAI и Anthropic будут иметь примерно 85 ГигаВатт датацентров — больше трети от общего объёма в статье. Тогда чтобы окупить это, нужны «смешные» 980 миллиардов выручки в год к 2032-му на две компании в сумме. Сейчас этот показатель где-то в районе $140B — ровно в 7 раз меньше. Но есть целых 6 лет, чтобы вырасти 😳 В общем я бы сказал, что эта аналитика скорее добавляет позитива и показывает, что траты на ДЦ очень даже приземленные, если верить, что спрос будет продолжать расти — тогда все легко окупится. А Dylan из SemiAnalysis на недавнем интервью вообще сказал, что ожидает суммарный ARR двух компаний в $600-700B в конце следующего года. Его оценка, скорее всего, результат скрещения внутренних прогнозов компаний + наращивания мощностей для обслуживания спроса. Это «всего лишь» рост в 4.3-5 раз за 14 месяцев, что вполне может произойти (вполне в значении «шанс далеко ненулевой, но не гарантировано»).
-
repost Двойная посадка на башню в миссии Flight 15. Главный инженер SpaceX в новом интервью подтвердил, что компания собирается вернуть и корабль, и ускоритель в предстоящем полёте Starship Super Heavy. И если обе посадки пройдут успешно, то это будет первое полное возвращение системы орбитального класса. В общем, подтверждается ключевой сценарий из недавнего поста (для тех, кто не верил). Даты пуска пока нет, но по его словам «незадолго до Дня благодарения», то есть до конца ноября. Также рассказал, что отказ одного RVac на Starship S41 во время Flight 14 был связан с ошибками в софте для контроллера двигателя, поэтому и приняли решение выходить на орбиту, тк проблема не была связана с железом или другими двигателями Raptor. Для тех, кто скептично относится к посадке Starship на башню стоит напомнить, что за всю программу орбитальных тестов этой системы — у корабля не было ни одной аварии именно на этапе посадки (у тех, которые до неё добрались). 📸: Mookafish
-
Telegram doesn't show this post on the web. Open it in Telegram to see it.
-
edited И моё мнение про то, что написал Terence Tao (или вернее как я понял, что он написал). В комментариях его многие назвали луддитом, но мне не кажется, что это так. Он не призывает остановить прогресс и отказаться от AI, он говорит (и это самая важная часть его сообщения): > Я скорблю ... о том, как можно было бы использовать эти инструменты для развития сотрудничества и обмена знаниями, а не конкуренции и секретности. О том, как можно было бы открывать новые двери, не закрывая старые. То есть он не против инструмента (AI) и его внедрения, он лишь против текущего выбранного подхода, когда открытые задачи в первую очередь решаются закрытыми моделями компаний с огромным ресурсом, и сообществу останутся крохи, которые «не дожали» внутри фронтир-лаб. Если бы этого не происходило, а вместо этого компании давали бесплатную подписку всем учёным в каждом университете — многие из открытый совершались бы людьми в коллаборации с AI. Я вижу в этом две большие проблемы: — (минорно) не ясно зачем задерживать доказательства до тех пор, пока их получат вне стенок OpenAI/Anthropic. Чтобы... люди чувствовали себя частью прогресса? Чтобы молодые учёные могли сделать себе имя? Чтобы эти же молодые учёные учились через поиск решений новыми инструментами и вырастали в математиков? А нужны ли будут математики умеющие доказывать что-то, или может им стоит всем готовиться задавать вопросы и разрабатывать теории? (как раз по эссе выше) — (мажорно) даже если этим не будут заниматься OpenAI и Anthropic, с которыми я верю, что можно будет договориться, доказательства будут находиться и публиковаться другими компаниями. Уже есть куча стартапов вроде AxiomMath, которые поднимали десятки-сотни миллионов долларов на AI for math. Они точно имеют больше ресурсов, чем какая-то кафедра вне топ-университета. Договориться и с ними тоже? Тогда найдутся те, кто имеет миллионы долларов и хочет сделать себе имя. В общем есть много ступенек между «бедный студент на кафедре» и «OpenAI», и я с трудом вижу, как можно сделать так, чтобы всё доходило до первого и не спотыкалось в середине, и чтобы не было дискриминации по бюджету, который можно вбухать в вызовы роя агентов передовых моделей (если к этому сведётся нахождение многих решений). Поэтому мне интересно будет следить за позицией Tao и других учёных с именем, какие они предложения будут вносить, и каково их видение ближайшего будущего. Но пока что мнение из эссе выше («отпустить машины и дать им дойти до куда они могут, а потом начать математику оттуда») мне нравится больше.
-
edited Kevin заканчивает своё эссе так: Мой личный ответ на вопрос о том, в чём заключается суть математики, такой. Математика — это доказательство теорем (решение задач), разработка новых инструментов (построение теорий) и понимание того, куда двигаться дальше (формулирование гипотез). На сегодняшний день мы видели множество свидетельств того, что компьютеры хорошо справляются с решением задач, но гораздо меньше свидетельств их способностей к построению теорий или формулированию гипотез. Это накладывает серьёзные ограничения на то, насколько далеко смогут продвинуться современные машины. Время покажет, насколько лучше машины завтрашнего дня овладеют этими навыками. Прогресс, несомненно, будет, но пока мы не увидели ничего по-настоящему убедительного. Нынешний прогресс действительно носит экспоненциальный характер и вполне может оставаться таким ещё некоторое время. Однако мы не можем ожидать, что экспоненциальный рост будет продолжаться бесконечно (именно в силу самой природы экспоненциального роста). Более того, математика бесконечна, а бесконечность с лёгкостью превосходит любую экспоненту. Поэтому я полагаю, что в будущем мы достигнем нового «естественного предела» в математике — гораздо дальше (а возможно, и несравнимо дальше) того рубежа, на котором находимся сейчас. Но на этом пределе машины зайдут в тупик, и дальнейшее наращивание ресурсов ради следующего большого прорыва станет нецелесообразным. Я считаю, что лучшее, что мы можем сделать — это предоставить машинам полную свободу действий, посмотреть, что из этого получится, а затем самим отправиться в путешествие к той точке, на которой они остановятся. Сейчас всё развивается стремительно. Но так не может продолжаться вечно. И если мы присоединимся к этому движению уже сейчас, машины смогут привести нас в совершенно удивительные, неизведанные места. А когда мы туда доберёмся, начнётся новое приключение.
-
edited Возвращаясь к математике, я прочитал разные мнение, и одним из самых откликнувшихся оказался блог «To grieve, or not to grieve?» от Kevin Buzzard, основателя проекта Xena, цель которого — оцифровать всю современную математику, переводя теоремы и доказательства с человеческого языка на Lean. Хоть он и не является основателем Lean, он активный контрибьютор, и именно в рамках Xena делается библиотека примитивов mathlib для Lean, на которую можно опираться при составлении своих доказательств. Kevin описывает 5 классических стадий принятия, и подмечает, что сейчас разные математики находятся на разных уровнях: — кто-то, например та самая «организация людей-математиков», находится в отрицании — кто-то пытается торговаться, например, группа математиков, которые «дают рекомендации» OpenAI (но те не обязаны их соблюдать). Они тоже не рады слоп-дропу 700+ статей, и ратовали за другой подход, хотя в целом понимают, что с AI математика теперь уже навсегда. — многие пост-доки и PhD в депрессии Профессор Buzzard задаётся философским вопросом: а зачем мы вообще занимаемся математикой? «Думаю, несколько лет назад многие математики с радостью согласились бы с тем, что математическое сообщество вручает самые престижные премии и награды тем, кто доказывает самые сложные теоремы. Однако теперь, когда сложные теоремы доказывает ИИ, мы, похоже, тратим много времени на объяснение того, что на самом деле эти награды и премии вручаются тем, чьи идеи позволяют нам глубже понять нашу область науки». Часто цитируют эссе 1994 года «О доказательстве и прогрессе в математике», где выражается мнение, что «дело не в количестве теорем, а в человеческом понимании» — эта цитата даже висит на картинке в шапке блога Terence Tao. Но дальше Kevin приводит личный пример, когда во время работы над докторской руководитель советовал ему не разбираться в одной из ключевых работ, потому что тот не успел бы и копнуть глубоко, и написать докторскую. Kevin признается, что он до сих пор так и не вернулся к той теореме — так «понимает» ли он свою работу? А кто понимает доказательство Великой Теоремы Ферма? Сам Kevin понимает лишь узкую часть того доказательства, потому что полное решение безумно сложно и требует невероятной ширины знаний — хотя он по теме Великой Теоремы Ферма читал блок лекций. Тут я от себя добавлю, что многие результаты ИИ как раз и приходятся на стыки нескольких направлений, и что часто один человек просто не может преуспеть и там, и там, чтобы прийти к открытию. Поэтому и полноценная человеческая проверка самых значимых работ, опубликованных OpenAI, может занять ОЧЕНЬ много времени.
-
Пока делаю паузу в написании постов на пару часов (по этой теме будет ещё 2-3-4), поделюсь слухом, что OpenAI выложили лишь ТРЕТЬ от полученных результатов, и что будет ещё два батча 😁 И напомню, что результаты в первом — это результат работы ~3 часов аналога GPT Pro по мощностям, а уж если они отправят модели на 10 часов... (то нам не хватит компьюта в подписке на Codex 🫡)
-
edited Сам Terence этот пост не прокомментировал, так что можно спекулировать, согласен ли он с этим или просто делится точками зрения (он уже так делал в блоге). Но есть его другой полный комментарий (в сборнике более чем сотни реакций других исследователей): Мои чувства по поводу последних событий очень противоречивы и сложны. С одной стороны, многие доказательства, полученные ИИ, по-видимому, содержат новые, остроумные идеи, которые принесут немало пользы, когда мы их осмыслим. При этом они опираются на труды бесчисленных математиков прошлого и настоящего. Но в то же время меня глубоко разочаровывает то, что, в отличие от традиционных научных прорывов, никто из людей, причастных к этим доказательствам, не может ответить на вопросы, выступить с докладом, поучаствовать в конференциях, отправить статью в научный журнал, обучать студентов или каким-либо другим образом участвовать в дальнейшем развитии этих результатов. Точно так же меня воодушевляет перспектива того, что научное сообщество сможет использовать эти инструменты для реализации амбициозных, масштабных проектов, о которых раньше нельзя было даже мечтать. Но меня ужасает мысль о том, сколько человеко-лет терпеливой, кропотливой и намеренно неспешной исследовательской работы — особенно аспирантов и постдоков — над важными математическими проблемами может быть вот так запросто нарушено или перечёркнуто подобной публикацией. Подобно тому, как невозможно забыть спойлер к фильму или подсказку к кроссворду, невозможно исследовать математическую проблему столь же плодотворно и глубоко, когда тебе уже известно её решение. Да, можно по-прежнему анализировать и осмыслять готовый ответ. Но лучшая возможность для этого возникает именно в момент открытия, и такие моменты всё чаще оказываются упущены, когда сам процесс открытия полностью поручают ИИ. И я скорблю о пути, который мы не выбрали, и о возможностях, потерянных в безумной гонке за развитием этой технологии. О том, как лаборатории могли бы предоставлять свои передовые модели независимым исследователям для полноценной научной оценки. О том, как можно было бы координировать усилия с научным сообществом, чтобы эти инструменты дополняли и расширяли возможности человеческих исследователей и помогали им в работе, а не конкурировали с ними. О том, как можно было бы использовать эти инструменты для развития сотрудничества и обмена знаниями, а не конкуренции и секретности. О том, как можно было бы открывать новые двери, не закрывая старые. Но мы оказались не на этом пути. И теперь научному сообществу как никогда необходимо объединиться. Чётко сформулировать собственные стандарты и ценности, создавать собственные инструменты и практики, поддерживать наиболее уязвимых своих участников и самостоятельно определять путь вперёд. Давайте приступим к работе.
-
edited Многие сейчас ополчились на OpenAI и считают, что они не должны были выкладывать решения. Я думаю, что имея доказательства на руках не выкладывать их было бы странным (в том числе и по отношению к самой науке...), но это вопрос второго плана. На первый план выходит информирование сообщества о том, что грядет. Чем больше доменов задето, чем шире охват результатов — тем больше учёных задумается о том, что нужно быть готовым перестраиваться и пользоваться новыми инструментами. Нужно будет жить в новом для них мире. Нужно менять устоявшиеся программы, менять академию, которая долгое время затачивалась на количество публикаций как меру продуктивности. Terence Tao разместил у себя в блоге сообщение «Ассоциации людей-математиков» (да, там прямо написано Human), в котором написано: — «Математики не просили о выполнении этой работы» (написания решений и их публикации). — «У математиков существует особое представление о прогрессе, сформированное историей и специфическими для данной области соображениями. Мы отвергаем утверждение OpenAI о том, что этот релиз способствует развитию нашей науки, и призываем математиков и общественность с должной долей скептицизма относиться к ценности этой модели публикации». — «Мы настоятельно призываем математиков прекратить работу с OpenAI и вернуться к такому видению науки, в центре которого находится человеческое понимание». 😳😳😳 Ну допустим математику OpenAI начнут игнорировать, и переключатся на биологию. Найдут какие-то формулы, лекарства, опишут потенциально ценные эксперименты — на них тоже придется закрыть глаза? Или это только к математике относится? или к физике тоже? 🧃будем следить за дискуссией, делайте ваши ставки, только прошу не делайте проигрышную, не ставьте на то, что модели не будут развиваться дальше
- Older posts