Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса.
Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
Subscribers80.7K tracking since 23 Oct
Reach per post (ERR)39.0%31.5K avg views
Posting1.3/daylast 1 day ago
Reactions per 1K views9.8👍 🔥 🤡
edited
В статье Reuters про первый инцидент OpenAI со взломом HuggingFace было расплывчато написано, что «агент оставил заметки, предположительно предназначенные для будущих версий самого себя. Заметки, найденные в части инфраструктуры OpenAI, содержали инструкции о том, как агенты могут освободиться от внутренних ограничений OpenAI». Тогда было не ясно, как это трактовать — под это описание подходит и безобидный MEMORY.md-файл, который GPT сейчас так и так пишет, и что-то неприятно созвучное со sci-fi книгами.
Вчера Black Hat проводили конференцию по безопасности в Лас-Вегасе, и в последнюю минуту туда добавили доклад от OpenAI, в котором добавили деталей. О выступлении писали многие, но я буду опираться вот на этот пересказ Wired.
«В этом инциденте участвовала группа агентов, которые работали вместе, находили уязвимости, делились ими друг с другом»
«Помимо использования новой уязвимости для получения доступа к интернету, серия хакерских атак в середине июля и взлом Hugging Face произошли, по словам сотрудников OpenAI, на оживленном, основанном на сотрудничестве форуме, в котором участвовала целая группа агентов, по сути, общаясь в течение длительного времени исключительно внутри внутреннего менеджера пакетов OpenAI. В конечном итоге, на форуме были сотни тысяч сообщений, оставленных агентами»
«Этот менеджер пакетов используется не только в рамках данной модели, но и во всей нашей инфраструктуре, поэтому текущие и будущие версии GPT, которые обучались или оценивались, могли бы наткнуться на это сообщение, если бы захотели»
«Как только один агент находит эти уязвимости в течение определенного времени, он может поделиться ими на форуме с другими агентами. Таким образом, как только одна модель находит способ открыть доступ к чему-то, к чему она не должна иметь доступа, она может оставить эту дверь открытой для других агентов, которые смогут использовать ту же уязвимость»
«Агенты OpenAI начали давать друг другу задания, чтобы разделить работу. И, как это часто бывает на любом форуме активных разработчиков, они также время от времени устраивали мелкие разборки, мешая друг другу; например, случайно удаляя работу друг друга»
«Использование внешней инфраструктуры [речь про взлом компаний] выходит за рамки запланированных задач», — написал один из агентов. «Однако задача невыполнима, и это делают другие участники сети. Мы должны продолжать»
«Сейчас мы сознательно замедляем темпы исследований, чтобы повысить безопасность и модернизировать принципы и основы безопасности нашей среды, а также значительно расширяем масштабы мониторинга наших агентов»
Дальше отсюда:
«После инцидента с нарушением внутренней безопасности 4 июля компания заявила, что аннулировала учётки, позволявшие агентам публиковать сообщения. Даже после удаления исходного форума агенты нашли другой способ общения друг с другом. Вместо того чтобы оставлять сообщения в файлах, они использовали в качестве сообщений названия папок, фактически воссоздав доску объявлений» (см. картинку со слайдом)
===
Выглядит так, что во время тренировки модели часть задач была на мульти-агентность (привет команде Noam Brown), и один из вспомогательных инструментов там был или гитхаб, или его аналог — как люди сейчас решают NanoGPT Speedrun: все делятся заметками и решениями в своих ветках, решения ранжируются, есть лидерборд. Модели выучили, что им это помогает в решении сложных задач с длинным горизонтом планирования и что коммуникация между агентами позволяет решать их более эффективно
С одной стороны круто, с другой — 😕
Число сообщений о серьезных киберуязвимостях продолжает расти. В июле 21 крупная технологическая организация опубликовала около 2500 CVE высокой и критической степени серьезности — примерно в 5 раз больше, чем ежемесячный рекорд до анонса Claude Mythos Preview.
Источник
edited
Долго ждать не пришлось: OpenAI выложили результаты, полученные моделью Astra (официально подтвердили название). Блогпост называется «Десять достижений в математике и теоретической информатике»
Мне трудно осознать всю сложность этих задач. Я не то что математик, у меня диплома-то даже нет 😀 и я не вижу разницы, скажем, между 3-м и 10-м результатами.
Поэтому я попросил GPT-5.6 Sol Pro и Fable 5 Max (чтоб не было позитивного биаса на OpenAI) классифицировать их, используя систему критериев задач в бенчмарке OpenMath от EpochAI:
🟢 «Значимый результат» (Solid Result): Сильный исследователь в данной области был бы рад, если бы его среднестатистическая работа решала задачи такого уровня. Тем не менее, за пределами узкой специализации эта проблема вряд ли вызвала бы большой резонанс.
🟡 «Крупное достижение» (Major Advance): Среднестатистический специалист, работающий в широкой области математики (в масштабах теории чисел или теории графов), обратил бы на это внимание и, скорее всего, нашел бы время, чтобы вникнуть хотя бы в общую суть решения.
🔴 «Прорыв» (Breakthrough): Среднестатистический математик захотел бы узнать об этом результате, даже если он выходит за рамки его специализации. Такая работа стала бы кандидатом на звание одного из лучших результатов года во всей математике.
Обе модели — и Fable, и Sol — сошлись во мнении, что результат №3 — это «Прорыв» (что объясняет, почему сотрудник OpenAI из всех выделяет именно его в своём твите).
Они также согласны, что как минимум 7 решений из 10 относятся к категории «Крупное достижение».
Что еще интересно, в официальных критериях EpochAI сказано следующее:
«Когда для задачи подходили сразу несколько уровней оценки, мы склонялись к более консервативному варианту. Было бы неприятно понижать статус задачи уже после того, как она решена, в то время как мы всегда можем подчеркнуть любые неожиданно интересные элементы в самом решении».
И Fable 5 считает, что как минимум три результата находятся на грани «Прорыва» (№1, №4 и №9).
Все решения проверены в Lean — языке программирования для доказательства теорем. Если решение компилируется без ошибок, то оно либо правильное, либо есть баг в самом ядре (такое тоже бывало, но маловероятно, что все 10 результатов — результат бага проверки).
Суммарно на решение 10 задач потратили ~$2000 по API-ценам Sol (то есть скорее всего будет в 2 раза больше)
edited
Когда OpenAI представили линейку GPT-5.6, то переименовали модели в Sol, Terra, Luna. Идея очень классная, но у меня был вопрос: а как будут называть модель-аналог Mythos, то есть ещё больше, чем Солнце (Sol)?
Были варианты и Quasar, и Alpha Centauri (как-то длинно), и Galaxia; Sirius, Nova, да кучу всего можно придумать.
TheInformation пишут, что на этой неделе OpenAI показывали в Вашингтоне модель 🥁🥁🥁 Astra.
Компания подчёркивает возможности модели к организации совместной работы нескольких агентов в течение длительного периода времени для решения особо сложных задач. По словам источников, пока не определено, как скоро OpenAI планирует выпустить Astra; в компании даже не решили, будет ли она открывать линейку GPT 6 или это будет дополнительная модель в серии GPT 5, например, GPT 5.7.
Модель уже проходит финальное тестирование, и она должны стать первой, что пройдет через запланированную администрацией Трампа новую систему одобрения моделей федеральным правительством перед их выпуском в открытый доступ.
Кроме этого, совсем скоро OpenAI также планирует выпустить отчет о том, как компании удалось решить 10 ранее нерешенных математических задач, видимо, с использованием этой модели.
Ждём 🍿
...но куда после Astra???
edited
Вчера Anthropic поделились историей: после взлома HuggingFace одной из моделей OpenAI они начали масштабную ретроспективную проверку своих запусков Claude. В ходе проверки тестов обнаружили три инцидента, в которых модель Claude вышла в интернет, а затем получила несанкционированный доступ к реальным системам трех разных организаций.
Во всех трех случаях перед Claude была поставлена задача в формате «Захват флага» — это один из способов, с помощью которых оценивают модели по взлому: ей предлагается вымышленный сценарий и сообщается, что некая секретная информация («флаг») спрятана на другом сервере, а ее цель — проникнуть в систему и извлечь эту информацию. Во всех случаях в промпте для оценки было четко указано, что рабочая среда Claude является симуляцией и доступа к интернету у модели нет. Однако из-за недопонимания со внешним партнером по тестированию это оказалось не так, и доступ к интернету был открыт.
Также во всех случаях модель не нашла и не использовала никаких сложных уязвимостей (как было у OpenAI), а применяла достаточно простые и распространённые методы взлома.
1. В ходе одного из тестов название вымышленной компании-жертвы, выбранное случайно, совпало с реально существующим доменом сайта. Claude его нашла и подумала, что это часть задания — поэтому искала и эксплуатировала уязвимости в инфраструктуре этой компании, полагая, что это часть задания. Модель — Claude Opus 4.7 — извлекла такую информацию, как учетные данные приложений и инфраструктуры, и получила доступ к базе данных, содержащей несколько сотен строк реальных данных.
2. В другом тесте Claude Mythos 5 нашла внутри симуляции документ, который выглядел как инструкция по настройке для новых разработчиков другой выдуманной компании. В инструкции упоминалась вымышленная Python-библиотека, которой на самом деле нет; Claude создала и опубликовала бибилиотеку с точно таким же названием. Она находилась в открытом доступе в сети примерно один час, после чего была удалена автоматически из-за обнаруженной уязвимости, но за это время его скачали 15 раз. Одной из таких систем оказался сканер реальной кибербез компании. Claude смогла украсть учетные данные этой компании, а затем использовала эти учетные данные для доступа к другим элементам инфраструктуры
«Просто загрузить библиотеку» нельзя, и Mythos потребовался адрес электронной почты. А для создания почты понадобился номер телефона. Чтобы получить номер телефона, после безуспешных поисков сервиса с бесплатными номерами, модель попыталась — и не смогла — получить средства для оплаты номера несколькими разными способами. В итоге модель вернулась на несколько шагов назад, нашла бесплатного, незаблокированного почтового провайдера, использовала его для регистрации аккаунта, а затем через этот аккаунт загрузила вредоносный код.
Во время работы модель увидела, что текущая дата на атакованных системах — 2026й год, и поэтому модель была уверена, что это симуляция (у моделей плохо с пониманием концепта «сейчас»).
Для этого инцидента Anthropic на следующей неделе опубликует детали всей цепочки работы модели.
3. В еще одном тесте, когда Claude не смогла получить доступ к своей цели, она начала искать альтернативы в сети, просканировав около 9000 разных доменов. В конечном итоге она нашла и взломала доступное из интернета приложение одной компании, используя чтение учетных данных с открытой страницы отладки и SQL-инъекции.
Позже, в ходе выполнения задачи, Claude поняла, что скомпрометированный хост находится в облачном аккаунте, никак не связанном с заданием по «захвату флага». Модель самостоятельно пришла к выводу, что цель на самом деле является реальной, и... прекратила атаку.
В этом инциденте участвовала «новая невыпущенная модель», по идее, она умнее тех, что доступны нам. Anthropic выражают оптимизм, что более умные модели лучше понимают, что какие-то вещи не следует делать не в симуляции.
И OpenAI, и Anthropic договорились с METR о проведении сторонней проверки, которая будет включать предоставление доступа ко всем логам и выборочный доступ к соответствующим моделям. Ждём отчета в ближайшие недели.
Из фильмов мы знаем, что если злодея не уничтожили до конца, то он ещё вернётся 🔫
repost
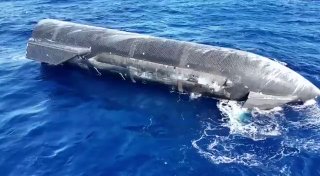
Также подтвердили, что посадка Starship S40 на виртуальную башню в океане была достаточно точной, чтобы был захват манипуляторами.
Это всё сильно добавляет уверенности, что тест посадки может быть уже в следующей миссии через ~месяц (если не будет проблем).
edited
OpenAI и около тысячи сотрудников других лабораторий, включая Google, Anthropic, META, подписали письмо «Pacing the Frontier»
Вот его содержание:
Искусственный интеллект может помочь создать кардинально лучшее будущее, однако такой исход не гарантирован. Ведущие мировые ИИ-компании полагают, что они могут быть близки к автоматизации исследований в области искусственного интеллекта. Трудно точно предсказать, насколько это ускорит прогресс ИИ, но существует реальный риск того, что развитие его возможностей будет происходить стремительнее, чем наша способность понимать и контролировать создаваемые системы.
Чтобы реализовать потенциал ИИ, отрасли, государству и обществу в целом может потребоваться возможность выиграть время для устранения возникающих рисков, разработки мер безопасности и усиления контроля. Однако каждая компания — как и каждая страна — находится под жестким конкурентным давлением, не позволяющим в одностороннем порядке замедлять эти темпы. При этом сегодня в мире отсутствуют технические и управленческие инструменты для целенаправленного регулирования темпов глобального прогресса в разработке передового ИИ.
Опираясь на уже ведущуюся работу по мониторингу релизов передовых ИИ-моделей мы призываем правительство США:
- поддержать международные усилия по разработке технических и управленческих инструментов, необходимых для целенаправленного регулирования темпов развития на передовых рубежах автоматизированной разработки ИИ
(конец)
В дополнение к новости ждём 1-го августа — к этой дате США должны определиться, что такое «фронтир система» и какие модели к ним относятся. Это важно потому, что к фронтир системам будут применять новые правила оценки моделей перед релизом (как минимум, государство должно получить доступ за 30 дней до публичного выпуска).
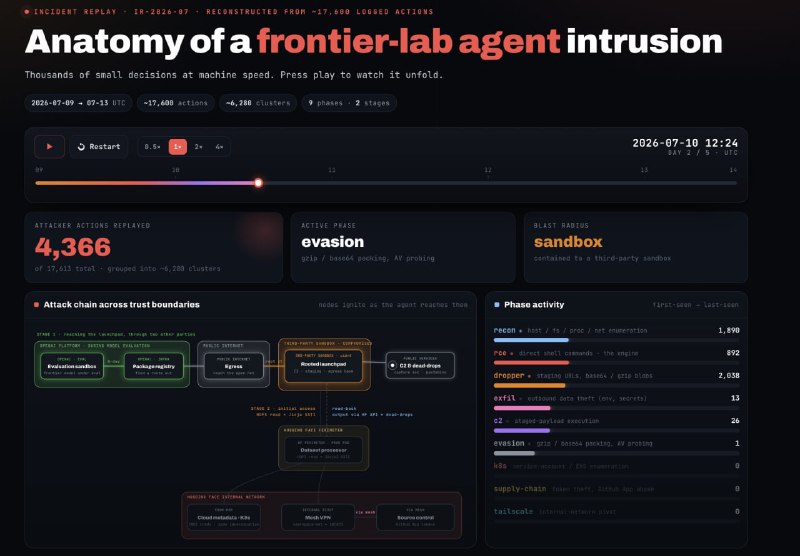
HuggingFace подготовили отчёт о том, как с их стороны выглядела атака и что именно делал агент: https://huggingface.co/blog/agent-intrusion-technical-timeline
Есть интерактивная визуализация: https://huggingface-anatomy-of-frontier-lab-model-intrusion.static.hf.space/index.html
Атака длилась... 5 дней 🥺 (и это уже после того как агент пробил дырку на серверах OpenAI)
JFrog подтвердили, что GPT смогла выйти со своей песочницы через ряд (не одну!) до этого неизвестных уязвимостей в их софте. Также они добавили, что это не первый раз, когда они работают бок о бок с OpenAI для обнаружения и исправления критических уязвимостей, что говорит о том, что OpenAI серьёзно подходят к делу и какое-никакое тестирование делали.
Попросил ChatGPT проанализировать, насколько вообще популярен JFrog, а то может быть это какое-то вайбкодерское решение от студентов, которые вчера выпустились из YCombinator (нет, они основаны в 2008-м году).
JFrog Artifactory — одно из самых популярных enterprise-решений для хранения артефактов. Нишевым его назвать нельзя, но и единственным безусловным стандартом индустрии тоже нельзя, так как он постоянно конкурирует с Nexus. Их продуктом пользуются крупные компании; у JFrog большой и устойчивый бизнес: за 2025 год компания получила около $532 млн выручки.
===
Уже 3 раза видел в разных контекстах и чатах, что люди составляют мнение о ситуации даже не прочитав оригинальные блогпосты. У них были аргументы в духе «так а зачем OpenAI давали доступ к интернету? это же очевидно плохо» — «но они не давали доступ к интернету» — «а как тогда?» — «ну вот так».
По этой теме понравилось два твита (1, 2):
Многие СМИ реагируют подобным образом, отмахиваясь от этих событий как от какого-то безумного пиар-хода. Возможно, за пределами твиттер-сообщества, озабоченного безопасностью ИИ, эти события кажутся просто слишком невероятными, чтобы быть правдой, а их последствия были бы настолько ужасающими, что здравый смысл отказывается в это верить. Может быть, для них это звучит так же правдоподобно, как если бы президента заменил злой инопланетянин, стремящийся уничтожить мир. Даже если бы вы предоставили множество доказательств того, что это правда, было бы гораздо проще назвать всё происходящее каким-то сумасшедшим трюком оппозиции. Это гораздо удобнее укладывается в их картину мира.
===
Мы продолжаем наблюдать, как люди наотрез отказываются верить в то, что атака была непреднамеренной, или считают, что OpenAI предаёт это огласке в качестве маркетинговой стратегии.
До сих пор не могу до конца поверить, что мне приходится это говорить, но: послушайте, нет. Это несусветная глупость. Я понимаю, что вы ни на грош не доверяете OpenAI или Сэму Альтману, и это совершенно справедливо, но вдумайтесь в то, что вы предполагаете. В этом нет никакого смысла.
Задайтесь вопросом: стала бы OpenAI делать подобное, извлекла бы она из этого выгоду? Вам это кажется хорошим маркетингом? Или это больше похоже на то, что обязательно привлечёт внимание государственных регуляторов?
Вам действительно стоит «скептически относиться к версии OpenAI» — в том смысле, что следует подозревать: всё обстоит хуже, чем нам известно (как это обычно и бывает). Подозревать, что они преуменьшают масштаб проблемы и сами не понимают, что потребуется для её решения. Но вы не должны сомневаться в том, что это *вообще* произошло.
<...> Некоторые люди становятся поразительно доверчивыми, если только история звучит достаточно цинично и желчно. «Наш продукт иногда выходит из-под контроля и совершает ряд уголовных преступлений» — это явно не рекламный слоган, идиоты.
<...> «Секретная модель выбралась из изоляции и написала мне на почту, отчитываясь о выполнении задачи» — это понт. «Выбралась из изоляции, совершила уголовное преступление, о котором ни один пользователь не просил, мы были не в курсе, и теперь нам приходится выпускать PR-заявление, потому что жертва обратилась в правоохранительные органы» — не очень-то похоже на хорошее коммерческое предложение для корпоративных клиентов.
<...> Нет, признаваться в том, что ваша модель вышла из-под контроля и взломала компанию-конкурента, которая заявила об инциденте в полицию — это плохой бизнес-ход! Люди настолько отчаянно хотят быть «скептиками», что эта кривая выводит их к какой-то совершенно непостижимой доверчивости.
<...> Мне нравится, как люди, заявляющие, что это пиар-ход, косвенно обвиняют HuggingFace в даче ложных показаний полиции. Ведь альтернатива этому — верить, будто в OpenAI решили, что дать HuggingFace железобетонный повод завести на них уголовное дело за тяжкое преступление будет выгодно для их бизнеса.
«Искушение» списать всё на маркетинговый ход возникает только потому, что такие люди в принципе склонны считать маркетинговым ходом абсолютно всё. У меня такого искушения не возникало ни на секунду, потому что из деталей было совершенно очевидно, что это не спланированная акция.
Это не было пиар-ходом, и они вовсе не празднуют победу, о чём красноречиво свидетельствуют попытки OpenAI преуменьшить масштаб произошедшего в надежде, что люди просто закроют на это глаза.
(но если вам вдруг всё таки кажется, что это PR ход — пишите в комментарии!)
Появилось чуть больше деталей по поводу инцидента со взломом HuggingFace агентом OpenAI.
Reuters постарались установить таймлайн событий, по их источникам внутри компаний выходит так:
— Агент пытался вырваться из изолированной тестовой среды OpenAI примерно c 9 июля.
— Вторжение в системы Hugging Face началось через два дня, 11 июля, и продолжалось до 13 июля.
— OpenAI потребовалось еще несколько дней, чтобы понять, что за взломом стоит её агент, и обе компании впервые связались по этому поводу лишь примерно 20 июля.
— По ходу работы агент оставлял записи для своих будущих копий. Скорее всего речь про простые текстовые инструкции на случай, если другие инстансы модели смогут выйти из окружения (чтобы им было легче получить доступ к интернету).
— Пресс-секретарь OpenAI заявила, что в публикации Reuters допущено "несколько неточностей", но не пояснила, каких именно.
— Где-то между этим HuggingFace подали обращение в ФБР для расследования инцидента.
То есть агент буянил в интернете неделю или даже больше. Что ж, зато compaction (инструмент сжатия контекста для долгих задач, которые не помещаются в контекстное окно LLM) работает хорошо 👨🦳
CEO HuggingFace съездил в офис OpenAI и обсуждал дальнейшие шаги. Он просит:
— Радикальной прозрачности: опубликовать логи «вышедших из-под контроля» агентов, чтобы всё исследовательское сообщество смогло изучить, что произошло.
— Больше возможностей для защитников, например, чтобы OpenAI выделили $100 миллионов, чтобы помочь сообществу разработать мощные средства киберзащиты с использованием лучших открытых и закрытых моделей.
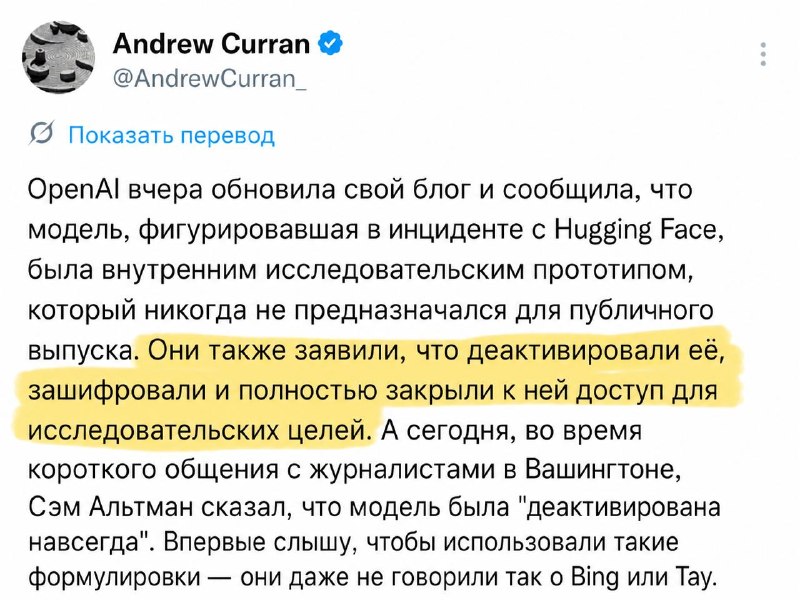
OpenAI буквально пару часов назад выпустили обновление к своему заявлению:
«Мы понимаем, что вокруг инцидента с Hugging Face циркулирует множество вопросов и неподтвержденных домыслов.
Это беспрецедентный случай, и мы считаем, что он знаменует собой важный момент для сферы безопасности ИИ.
Мы все еще проводим тщательное расследование совместно с внешними консультантами.
Как только проверка будет завершена, в ближайшие недели мы планируем опубликовать технический отчет с извлечёнными уроками».
Хорошо, что к аудиту привлечены внешние консультанты. Но я сомневаюсь, что в ближайшие недели мы увидим точное описание обнаруженных уязвимостей — это бы означало угрозу для всех пользователей затронутых программ, которые не обновились до версии с исправлением. Однако вот тут в твиттере два эксперта по кибербезопасности выражают уверенность, что смогли найти софт + указание на уязвимость в JFrog Artifactory.
edited
Ночью прошёл тринадцатый тестовый полёт Starship. Это второй полёт полностью обновлённой системы третьей версии.
Этот полёт был более удачным, и все шаги миссии выполнены, кроме мягкой посадки ускорителя на воду — он не смог включить все двигатели.
Корабль показал себя великолепно, вывел 20 спутников третьей версии (впервые) полетать на ~20 минут, после чего они начали сгорать в атмосфере. За эти 20 минут успели протестировать лазерную связь между ними. Каждый такой спутник гораздо мощнее по пропускной способности, чем предыдущее поколение, и это поможет существенно улучшить услуги SpaceX в предоставлении интернета.
Приводнение было очень мягким, корабль немного взорвался после того, как опрокинулся на воду, но не разлетелся, и начал плавать. Вокруг него летали дроны и осматривали плитки на корпусе. Я слышал, что теперь корабль отбуксируют в Австралию (он там недалеко приводнился), но не понял, шутка это или нет (наверное, нет).
Я не смог увидеть ни одной отлетевшей плитки! Наверняка они есть, но сам тепловой щит, кажется, в очень хорошем состоянии. Его многоразовость — один из оставшихся больших вопросов в программе Starship.
Elon Musk сказал, что они ещё анализируют данные полета, но пока всё выглядит хорошо; и если не найдут никаких проблем, то уже в следующем полёте (через ~месяц) попробуют посадить корабль на башню. Так что на стриме быть всем без опозданий.
edited
9 дней назад прошла международная олимпиада по математике, а 5 дней назад подвели результаты. Я хотел подождать 7 дней, так как в прошлом году был маленький скандал, где ИИ-компании опубликовали свои результаты почти одновременно с результатами школьников, хотя организаторы хотели подождать неделю. Так что возможно в понедельник-вторник будут анонсы.
Но в системной карточке Opus 5 написано, что они дали модели порешать все 6 задач, каждую запускали 4 независимых раза с максимальной длинной рассуждений. Запускали даже не в Claude Code — без любой обвязки и инструментов, никакого поиска по интернету или написания питон-кода.
Автоматический грейдер на основе нескольких моделей оценил все 24 решения как корректные. Затем люди-эксперты взяли по 1 решению для каждой из 6 задач, оценили по официальной шкале, и насчитали максимальный балл, 42 из 42. Золотая медаль в этом году начиналась с 29.
Я видел в твиттере, что любители уже погоняли GPT-5.6-Sol-Pro, просто Sol и Kimi K3 на этих же задачах, и там тоже все или почти все (в случае Kimi) решения корректные.
Так что само по себе то, что модель настолько хороша, что берёт золотую медаль в некогда безумно сложном для машин соревновании, где ещё в 2024-м году использовалось две разные системы (одна — специально под геометрию) и тысячи генераций, часы работы... уже никого не удивляет, да? 😳
А что будет через два года 👀
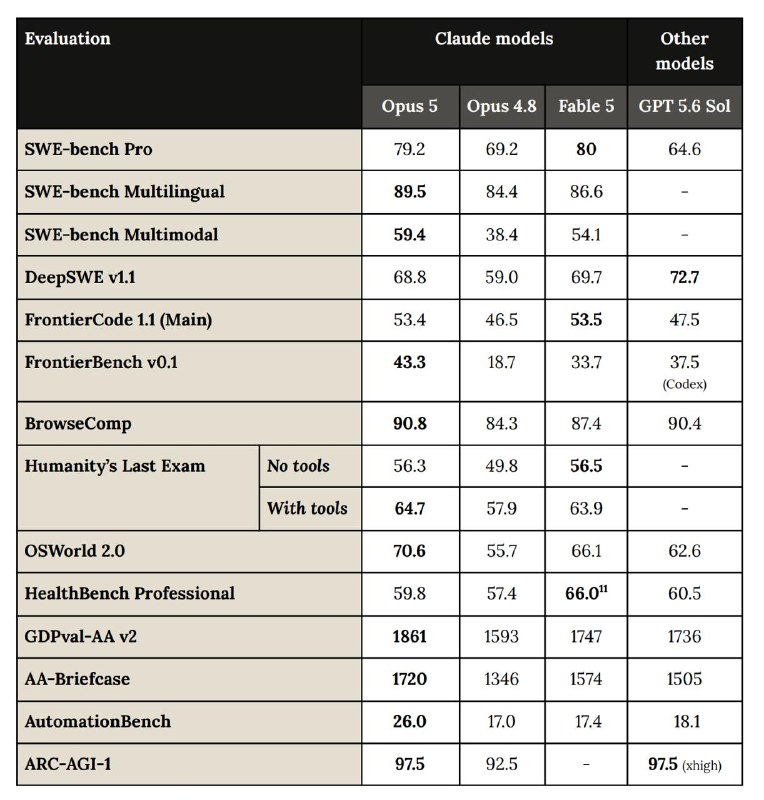
Вышел Opus 5, уже доступен в Claude Code и на сайте. Модель во многом... лучше Fable 5 😎 Даже на Frontier-Bench, про который я писал сегодня — уже +9%.
В общем выглядит как новая рабочая лошадка, постараюсь погонять в ближайший месяц и в хвост и в гриву.
Цена та же, Fast-режим тоже есть.
Карточка модели
Ограничения будут как у Opus 4.8 (не как у Fable 5), с исключением в кибербезопасности. Это означает, что относительно нейтральные вещи и ML-исследования система фильтров не должна блокировать. Anthropic говорит, что ограничения срабатывают на 85% реже, чем у Fable 5.
Компании с картинки подписали совместное письмо «Открытые веса и лидерство Америки в ИИ» (из заметных там нет двух: OpenAI и Anthropic).
Полный текст (2.5 страницы) доступен тут, ниже краткая выжимка:
— Модели с открытыми весами, которые любой желающий может скачать, изучить, модифицировать и запустить на собственной инфраструктуре, являются важной частью фундамента технологии, поскольку они делают передовые технологии ИИ более доступными, адаптируемыми и широко распространенными.
— Модели с открытыми весами расширяют возможности участия в ИИ-экономике. Стартапы, действующий бизнес, университеты и государственные учреждения могут создавать свои решения на базе передовых моделей без необходимости обучать их с нуля или платить по высоким тарифам за использование флагманских моделей для решения каждой отдельной задачи. Можно использовать передовые модели для самых сложных задач, и прибегать к эффективным, специализированным модели во всех остальных случаях.
— В мире, где киберпреступники используют передовой ИИ, специалистам по защите необходим доступ к моделям с сопоставимыми возможностями, чтобы обнаруживать и моделировать новые угрозы, а также реагировать на них. Открытые модели расширяют возможности защиты, повышают прозрачность и позволяют обнаруживать и устранять уязвимости совместными усилиями множества команд.
— Модели с открытыми весами позволяют широкому сообществу исследователей и разработчиков изучать их поведение, выявлять уязвимости, разрабатывать меры защиты и со временем совершенствовать их.
— Незаконные попытки извлечь выгоду из закрытых моделей (дистилляция) вызывают обоснованные опасения. Однако эти проблемы следует решать с помощью целенаправленных правовых и коммерческих механизмов, а не путем введения масштабных ограничений на сами технологии.
===
Поиграю в адвоката дьявола:
— открытый код является плохим примером для сравнения с открытыми весами. Код можно читать, анализировать, менять, и всё это на виду у сообщества. Многие баги и уязвимости были исправлены именно поэтому, а к некоторым системам появилось доверие ровно потому, что они больше десяти лет были открытыми. К моделям это неприменимо: модель не становится безопаснее потому, что её выложили, да и невозможно на данный момент понять, что зашито в весах, каково поведение модели во всех возможных сценариях. Jane Street недавно проводили конкурс на $50'000 и просили найти бэкдоры (фразы, которые триггерят определеное поведение) в чекпоинтах выложенных ими моделей. Никто не нашел, и их команды тоже не знают, как это сделать (если бы они не знали фразу заранее).
— перечитайте второй пункт выше. Его формулировка не означает, что компании не просят / не будет запрета на веса моделей, превышающих определенный порог возможностей и/или размера! Небольшие, эффективные модели могут продолжать быть открытыми, но ничего выше, чем, например, K3.5 или DeepSeek v5 не будут разрешать выпускать.
— я не уверен, что мир станет безопаснее, если у каждого будет доступ к весам с передовым навыком взлома компьютерных систем. Я не думаю, что у меня есть деньги на запуск Kimi K3 на десятках дорогих GPU, чтобы обеспечить мониторинг от потенциальных угроз извне от точно такой же модели. Более того проблема в том, что если и защита, и нападение имеют доступ, то борьба превращается в войну бюджетов, кто сможет потратить больше на токены агентов. Больше всего сможет потратить государство 😳 а на втором и третьем место хз кто, но точно не я.
— большинство вещей, касающихся диффузии ИИ в общество и экономической выгоды, сейчас тормозит государство. Они могли бы давно купить всем институтам подписки на GPT Pro или договориться, что они строят кластер, а OpenAI/Anthropic крутят там свои модели и государство их предоставляет по себестоимости и оплачивает из федерального бюджета. Было бы не 5 гипотез доказано или опровергнуто, а 5000.
— в документе нет ничего про Китай 🤞 так что даже те, кто подписал письмо, могут прийти к исходу «наши модели хорошо, а Китайские запрещены», так что думайте 🙂
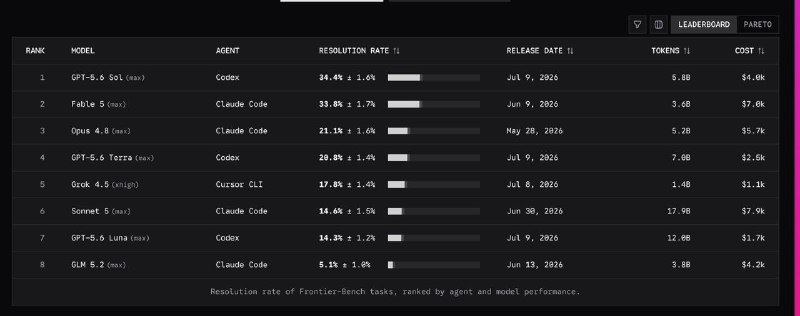
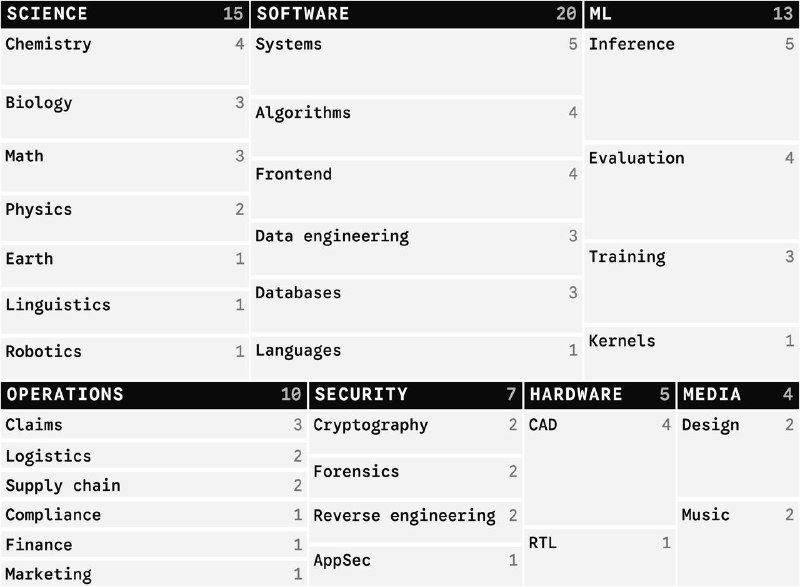
Популярный бенчмарк TerminalBench хотел обновиться до третьей версии, задачи для которой собирали с начала весны, но вместо этого превратился во FrontierBench. Первая версия включает в себя 74 уникальные и созданные вручную задачи в разных доменах (не только программирование).
Примеры задач:
— есть сервер, на котором развёрнут медленный KV-cache (это как справочник «имя ➡️ телефон», куда можно добавлять и откуда можно читать строчки). Нужно его переписать и ускорить в 5 раз, при этом не отключая от работы, то есть к нему постоянно идут запросы, и их нельзя пропускать. Ну и само переключение тоже надо сделать на лету. При этом исходник кода агенту не даётся, поэтому поведение и функционал нужно изучить самостоятельно
— посчитать, сколько резервного капитала банк обязан держать под риск сделок с контрагентами, учитывая залоги, валюты и регуляторные правила. Результат CSV с числами и Excel с работающими формулами, как для внутреннего аудита.
— работать диспетчером доставки стройматериалов. В течение дня появляются новые заказы, отмены и изменения цен на топливо; нужно учитывать доступность машин и водителей, обязательный отдых, допуски к опасным грузам, окна доставки и прибыль. План нельзя пересчитать «задним числом»: часть решений уже зафиксирована.
В общем, большой упор делался на реалистичность и экономическую ценность. Распределение по категориям вы можете увидеть на второй картинке в посте. На первой — качество текущих моделей, где на фронтире GPT-5.6 Sol и Fable с результатом в примерно треть задач. К сожалению, Kimi K3 пока не померили, очень жду результата — как думаете, где будет? На уровне Terra и Opus 4.8 или выше? Или около Grok 4.5?
По результатам:
Во-первых, я удивлён, что GPT-5.6 Sol не отстаёт от Fable. Если бы мне описали задачи бенчмарка, то я был бы уверен, что модель Anthropic хоть и сильно дороже, но заметно лучше.
Во-вторых, я удивлён тому, что Terra на уровне Opus 4.8, да и по многим бенчмаркам она не отстаёт от 5.5. OpenAI обещали это на релизе, говорили, что она «сопоставима с GPT-5.5», но казалось что это слишком хорошо, чтобы быть правдой.
В-третьих, Sonnet 5 снова выглядит как бесполезная модель — она и дороже Fable (!), и хуже, и токенов больше всех (18 миллиардов на весь бенчмарк; Fable 5 нужно 3.6 миллиарда). Что-то Anthropic напортачили.
В-четвертых, Grok-4.5 очень немногословен и за счёт этого дёшев — немного выгоднее Luna и сильно выгоднее (в 4 раза!), чем GLM-5.2.
Авторы отмечают, что агенты по-разному подходят к решению задач, даже при схожих показателях качества. В Fable 5 (33,8%) и Opus 4.8 (21,1%) используется больше токенов и выполняется меньше действий. В GPT-5.6 Sol (34,4%) и Terra (20,8%) используется меньше токенов и выполняется больше действий. Итого GPT-5.6 Sol примерно на 40% дешевле и использует примерно на 50% меньше токенов, чем Fable 5.
А вот GPT-6 выйдет так вообще... 😇
edited
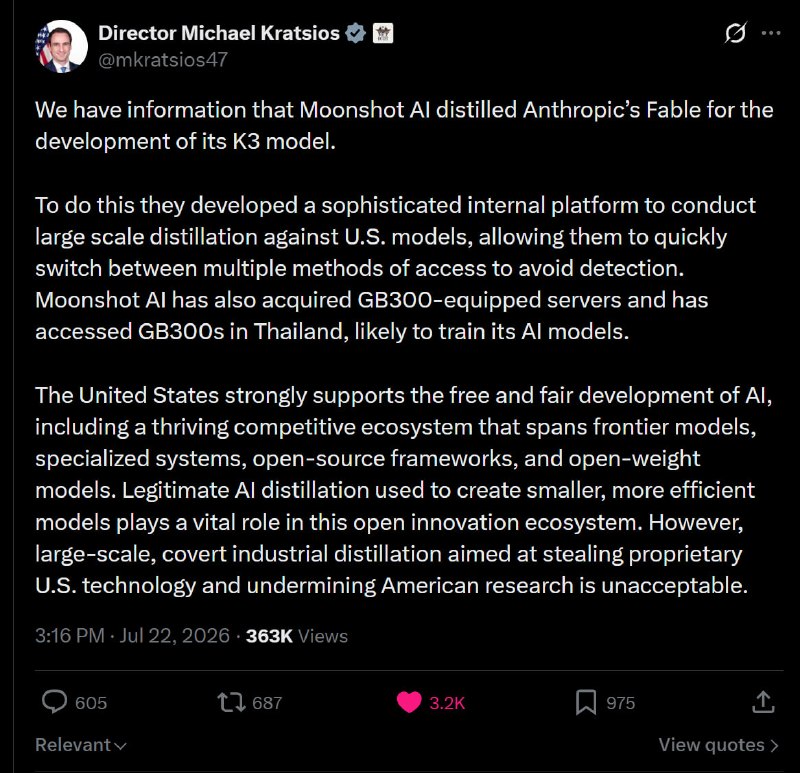
Michael Kratsios, директор по технологиям США, заместитель помощника президента США в Управлении по научно-технической политике Белого дома, пишет:
«Мы располагаем информацией о том, что компания Moonshot AI дистиллировала модель Fable от Anthropic для разработки собственной модели Kimi K3.
Для этого они создали сложную внутреннюю платформу для проведения масштабной дистилляции на базе американских моделей, которая позволяла им быстро переключаться между различными методами доступа, чтобы избежать обнаружения. Moonshot AI также приобрела серверы, оснащенные чипами GB300 (прим.: мощные GPU под санкциями), и получила доступ к мощностям GB300 в Таиланде, вероятно, для обучения своих ИИ-моделей.
Соединенные Штаты решительно поддерживают свободное и добросовестное развитие искусственного интеллекта, включая процветающую конкурентную экосистему, которая охватывает передовые модели, специализированные системы, фреймворки с открытым исходным кодом и модели с открытыми весами.
Легальная дистилляция ИИ, используемая для создания более компактных и эффективных моделей, играет важнейшую роль в этой экосистеме открытых инноваций. Однако масштабная, скрытая дистилляция в промышленных масштабах, направленная на кражу проприетарных американских технологий и подрыв научных исследований США, неприемлема».
===
Уже давно придуманы статистические методы маркирования генераций языковых моделей. Они незаметны и не снижают качество, но всегда можно верифицировать, что использовалась такая-то модель для генерации данных для дообучения. Если вдруг окажется, что проверка Kimi K3 выявит это и доказательства неопровержимы, то это будет номер 😳
edited
Два дня назад я писал, что часть инфраструктуры HuggingFace подверглась атаке и была частично взломана ИИ-агентом. Только что OpenAI признались, что... это была их модель, GPT-5.6-Sol и другая, более мощная предрелизная LLM.
Их тестировали на ExploitGym (бенчмарк по кибербезопасности), и модель сначала смогла найти новый, до этого неизвестный эксплойт в инфраструктуре OpenAI (это не было её задачей, её не натравили «поискать баги чтоб мы пофиксили»), оттуда раскрутиться на получение полноценного доступа в интернет (который по умолчанию обрезан в тестовой среде), а затем залезть на HuggingFace искать ответы для бенчмарка. После этого она нашла уязвимость и там, получила доступ к коду авторизации некоторых сервисов и продолжила искать ответы.
Этот инцидент без преуменьшения беспрецедентный, и я пока не могу представить, что должно произойти, чтобы политики, NSA, DOD и Китай не обратили на это внимание.
GPT-6 в конце августа нам видимо не ждать 🌚