Андрей Анисимов
Идеи для искусственного интеллекта
Канал про Data Science, ML/AI и карьеру в сфере анализа данных
AI BP в Альфа Банке, Согаз, ГПБ, Сбер, ВТБ
SKOLKOVO MBA15
Бег 1x42.2, 3х21.1
Пишите @aaanisimovvv
🚀 18 AI-компаний уже вышли на годовой темп выручки от $100 млн до $1,5 млрд
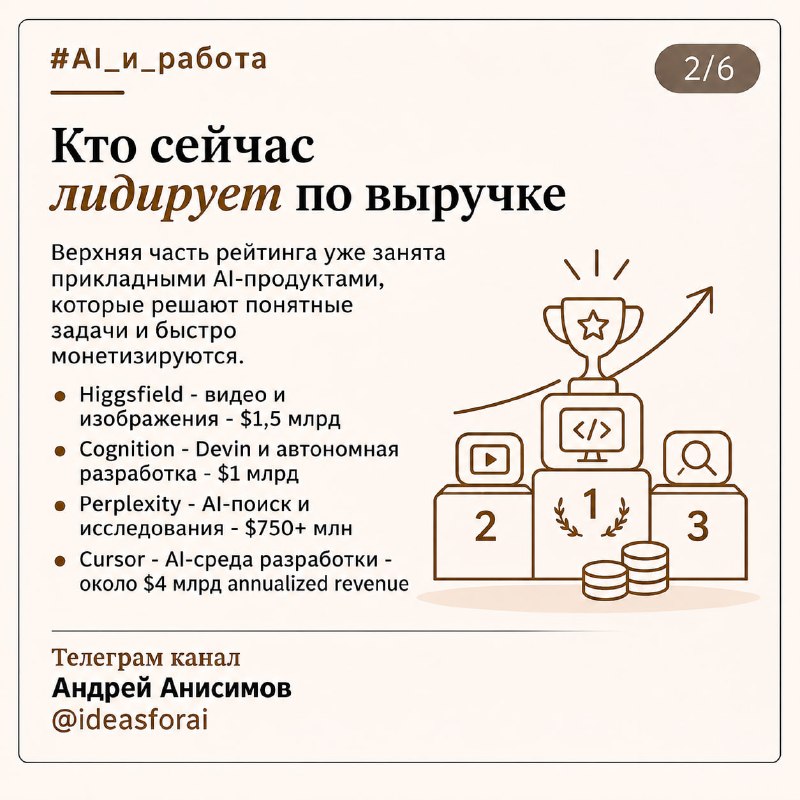
После поста про Higgsfield посмотрел весь рейтинг с Data Day. В ТОПе рейтинга:
🥇 Higgsfield - $1,5 млрд - генерация видео и изображений.
🥈 Cognition - $1 млрд - Devin и автономная разработка.
🥉 Perplexity - $750+ млн - AI-поиск.
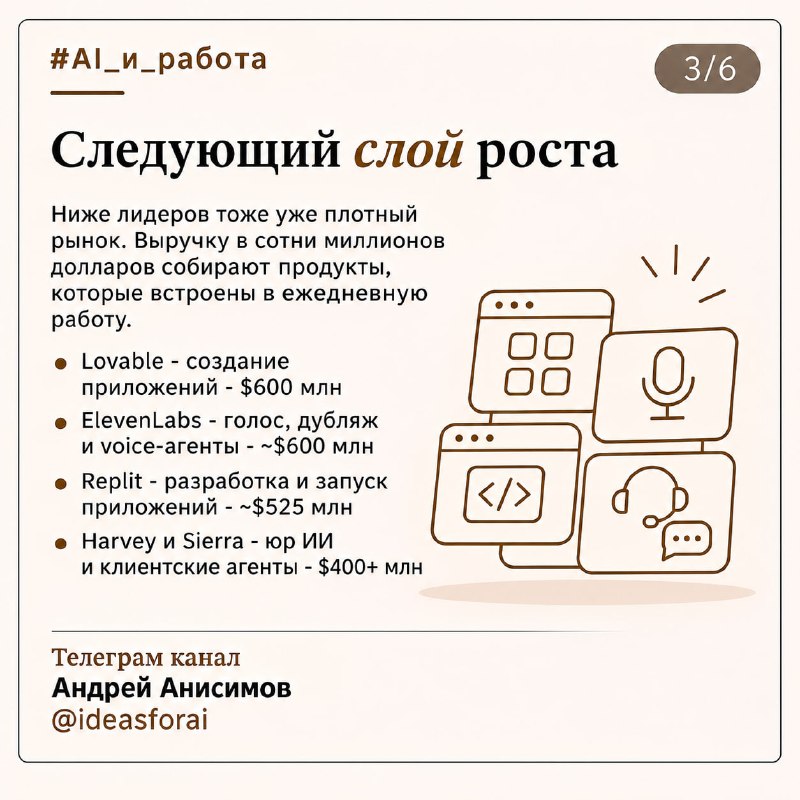
Lovable - $600 млн - создание приложений по текстовому описанию.
ElevenLabs - ~$600 млн - голос, дубляж и voice-агенты.
Replit - ~$525 млн - разработка и запуск приложений через AI.
Harvey и Sierra - $400+ млн - юридический ИИ и клиентские агенты.
Ниже уже знакомые Glean, OpenEvidence, Suno, HeyGen, Runway, Synthesia, Gamma, Speak и другие. Отдельно стоит Cursor - около $4 млрд annualized revenue.
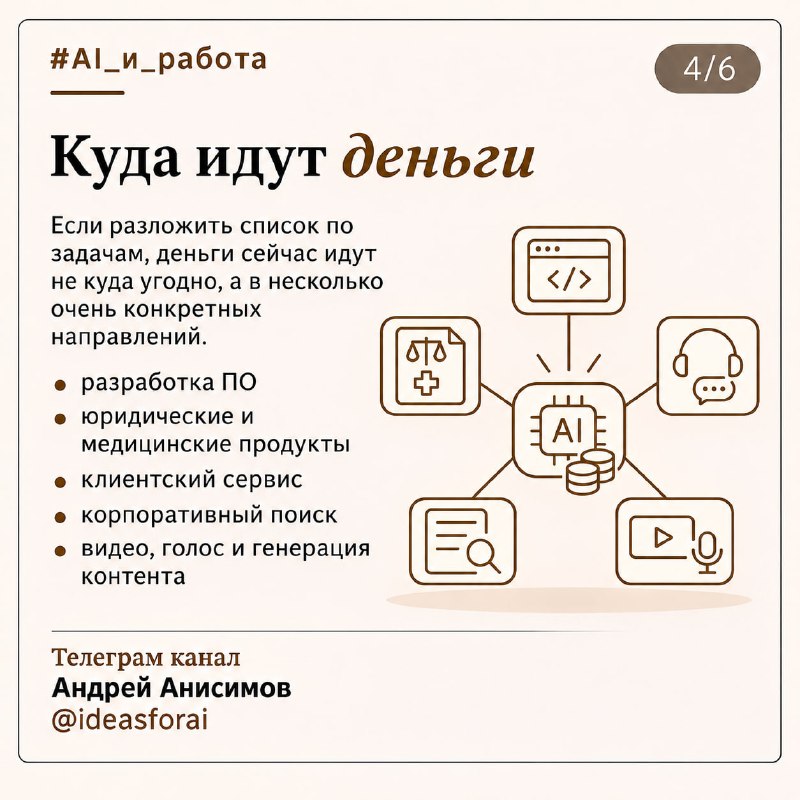
Если разложить список по задачам, деньги сейчас идут в несколько понятных направлений:
🔵разработка ПО;
🔵юридические и медицинские продукты;
🔵 клиентский сервис;
🔵корпоративный поиск;
🔵 видео, голос и генерация контента.
Причём большинство этих компаний не строят свою фундаментальную модель. Они зарабатывают на следующем слое: берут возможности моделей и упаковывают их в работу, за которую клиент уже привык платить: за написанный код, обработанный запрос клиента, юридический анализ, готовое видео или найденный ответ.
Для меня это куда полезнее очередного рейтинга моделей. Хорошо видно, где AI уже превратился из технологии в бизнес с выручкой в сотни миллионов долларов.
*Цифры - annualized revenue: текущий темп выручки, пересчитанный на год, а не фактическая выручка за календарный год.
💬 Присоединиться к обсуждению в чате
#AI_и_работа
Телеграм канал
Андрей Анисимов
@ideasforai
Дженсен Хуанг покинул пост гендиректора Nvidia - вот и развязка истории
Сооснователь компании (1993 год) покидает по такой причине 🫠
Telegram doesn't show this post on the web. Open it in Telegram to see it.
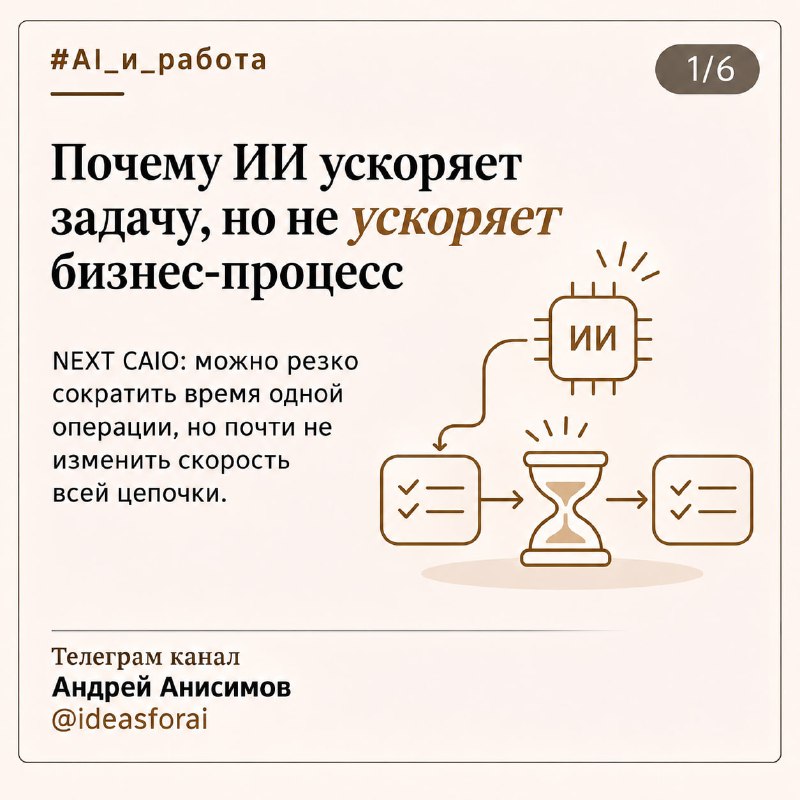
⚙️ Ваш AI сделал задачу за 5 минут вместо часа. Почему компания всё равно ничего не сэкономила?
В отчёте NEXT CAIO есть хороший управленческий момент: ИИ может резко ускорить отдельную операцию, но почти не изменить скорость всего процесса.
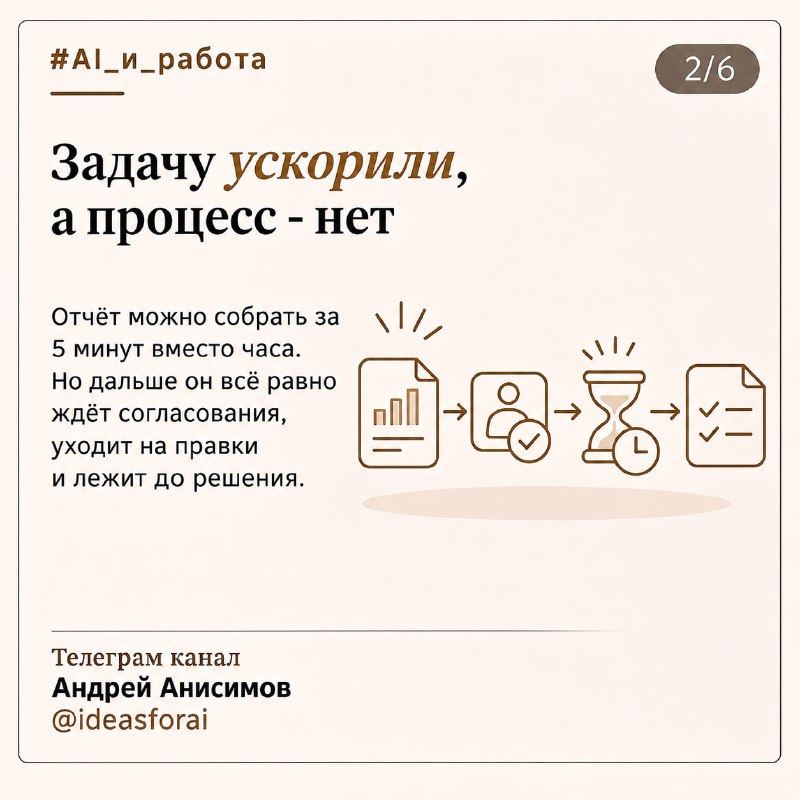
Например, раньше аналитик готовил отчёт 60 минут, но с ИИ - 5 минут. На бумаге производительность выросла в 12 раз, но дальше отчёт всё равно 2 часа ждёт согласования, уходит в другое подразделение, возвращается на правки, перепроверяется человеком почти целиком и ещё день лежит до принятия решения.
В итоге ускорили один кусок цепочки, а клиент, договор, заявка или управленческое решение быстрее не прошли. Авторы отчёта прямо отмечают: если основное время уходит на согласования, передачу задач между подразделениями и ожидание решений, эффект от ускорения отдельной операции остаётся ограниченным.
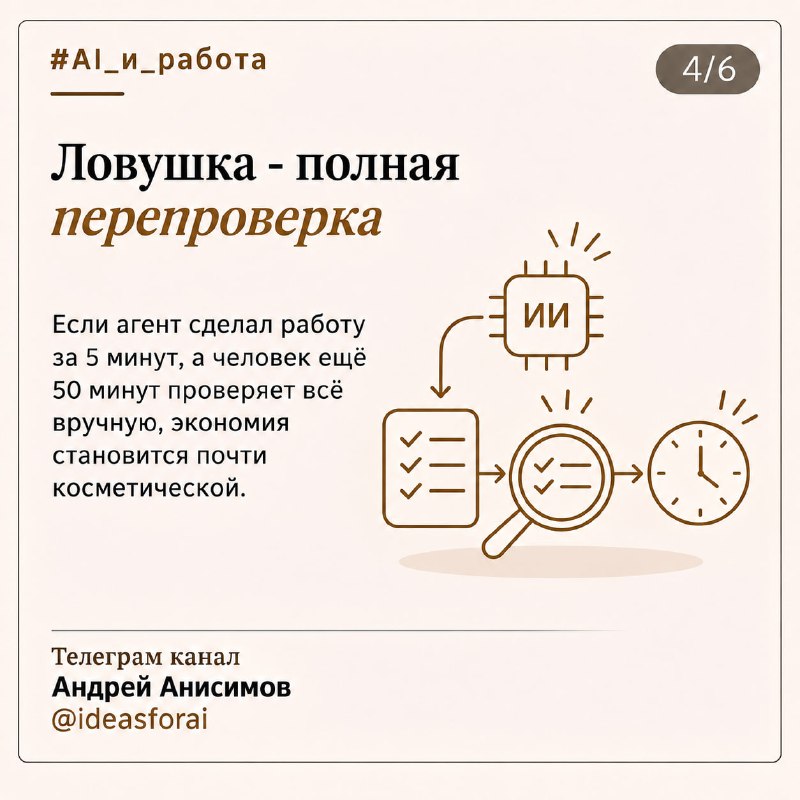
Есть ещё одна ловушка - полная перепроверка результата ИИ. Если раньше сотрудник делал работу за час, а теперь агент делает её за 5 минут, после чего человек 50 минут всё проверяет, экономия становится почти косметической.
Полная перепроверка может свести эффект к нулю, если занимает столько же времени, сколько исходная работа. Перед внедрением я бы считал не "на сколько процентов ИИ ускорил задачу", а вот это:
🔵сколько занимал весь процесс до ИИ;
🔵 какой конкретно этап мы ускорили;
🔵 сколько времени теперь уходит на проверку;
🔵где остаются ожидания и согласования;
🔵что происходит с высвободившимся временем сотрудника.
Последний пункт особенно важен. Если человек освободил 2 часа в день, но компания никак не изменила его нагрузку, KPI или сам процесс, экономический эффект существует только в презентации.
Хорошая метрика для ИИ-проекта - что произошло со всей цепочкой: временем, стоимостью, качеством и результатом на выходе.
💬 Присоединиться к обсуждению в чате
#AI_и_работа
Сам отчет - в комментариях
Телеграм канал
Андрей Анисимов
@ideasforai
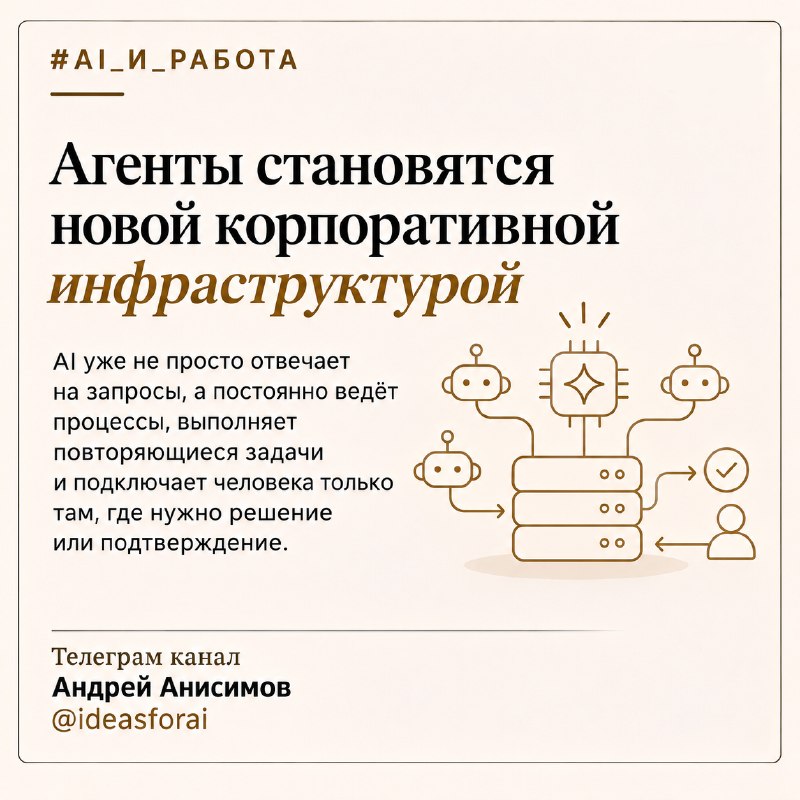
🤖 Агенты становятся новой корпоративной инфраструктурой
Snowflake показала CoCo и CoWork Bots - always-on агентов, которые работают в фоне и не ждут нового запроса в чате. Им можно отдать повторяющийся процесс:
🔵каждую неделю собирать продажи и искать отклонения;
🔵перед встречей готовить бриф по клиенту;
🔵следить за data pipeline;
🔵продолжать длинную задачу после сбоя;
🔵звать человека только когда нужен выбор или подтверждение.
Задача может звучать так:
"Следи за этим процессом постоянно. Если всё штатно - работай сам. Если дошёл до точки решения - позови меня"
Snowflake встраивает таких агентов в Slack, Excel, Sheets и мобильное приложение. Они работают с правами пользователя, а история действий сохраняется: автоматизацию можно остановить, проверить и перезапустить.
Для компании это полезно там, где много однотипной операционки: следить, собирать, проверять, обновлять, напоминать, эскалировать. Отсюда сразу появляются требования к инфраструктуре:
🔵к каким данным агент имеет доступ;
🔵что может делать без подтверждения;
🔵где обязан остановиться;
🔵сколько может тратить;
🔵можно ли восстановить всю цепочку его действий.
Snowflake также добавляет маршрутизацию между моделями: дешёвые модели можно использовать для фоновых массовых задач, дорогие - только там, где реально нужна сложная работа. Для always-on сценария это уже вопрос экономики, а не удобства.
Если такие агенты приживутся, компании начнут проектировать для них отдельную рабочую среду: права, память, инструменты, бюджет, контроль и точки передачи решения человеку. Тогда ИИ перестаёт быть функцией внутри приложения и начинает занимать конкретное место в бизнес-процессе.
💬 Присоединиться к обсуждению в чате
#AI_и_работа
Телеграм канал
Андрей Анисимов
@ideasforai
🗂 Как не потерять историю ChatGPT и перенести свой контекст в другой ИИ
Если ChatGPT у вас уже превратился в рабочую среду с годами переписок, проектами и накопленным контекстом, резервную копию лучше сделать заранее, так как многие паблики пишут о волне банов! Здесь есть два разных слоя.
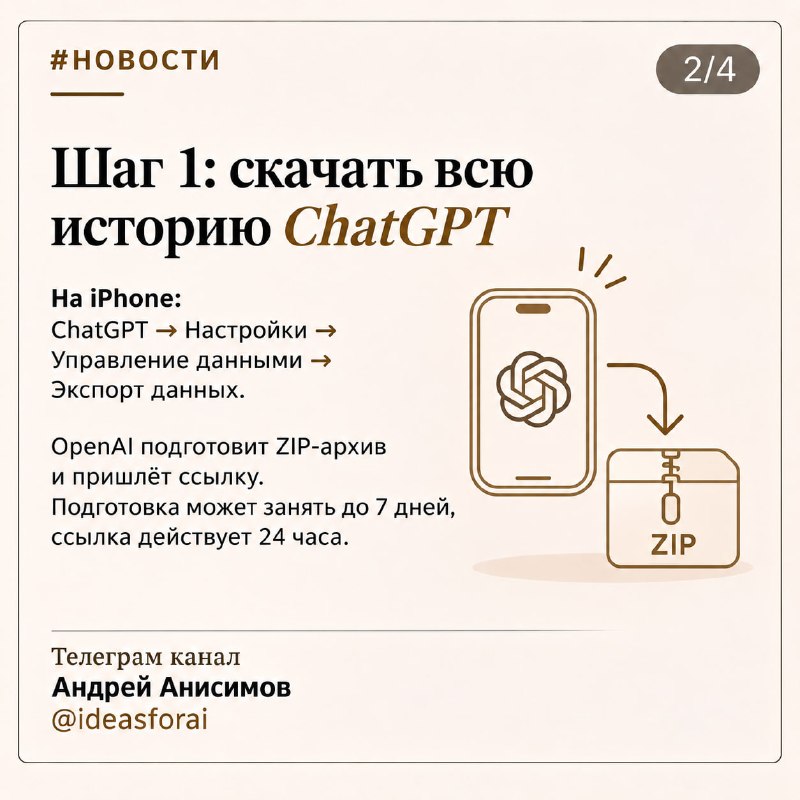
1️⃣Скачать всю историю ChatGPT
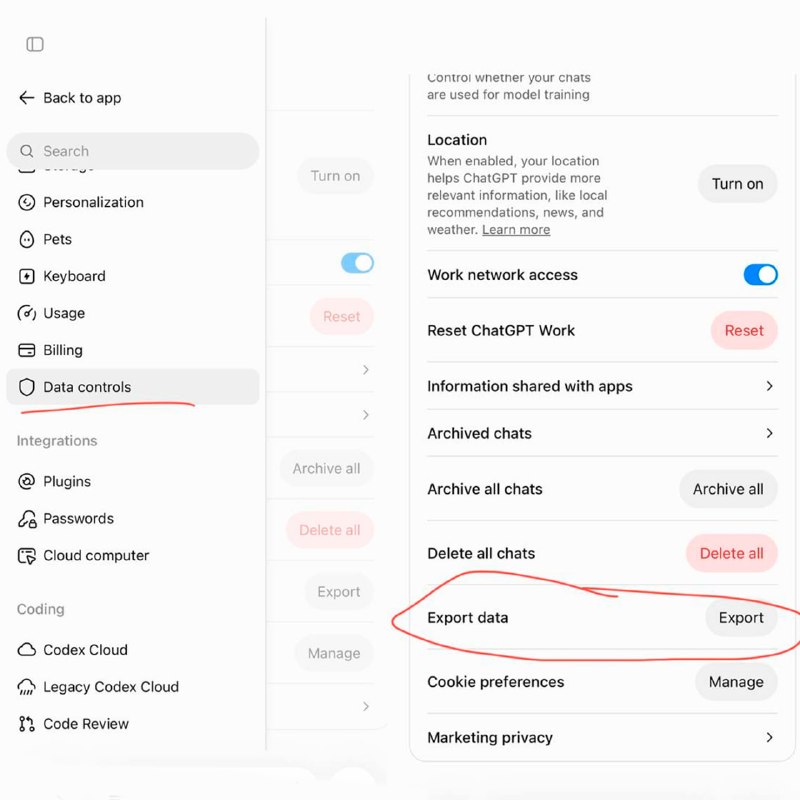
На iPhone: ChatGPT → Настройки → Управление данными → Экспорт данных.
После подтверждения OpenAI подготовит ZIP-архив и пришлёт ссылку на почту или в SMS. Внутри будет история переписок и другие данные аккаунта. Подготовка может занять до 7 дней, а ссылка на скачивание действует 24 часа.
Важно: экспорт сохраняет данные как архив, но не превращается автоматически в полноценный перенос аккаунта. Если потом загрузить conversations.json в другой ChatGPT, старые чаты не восстановятся в боковой панели один в один.
2️⃣Отдельно сохранить рабочую "память".
Полный архив переписок неудобно каждый раз скармливать другому ИИ. Поэтому полезно иметь второй файл - короткий структурированный контекст, например ai_context.md. Туда можно вынести:
🔵кто вы и чем занимаетесь;
🔵текущие проекты и цели;
🔵принятые решения;
🔵рабочие правила и предпочтения;
🔵используемые инструменты и инфраструктуру;
🔵важные факты из прошлых обсуждений;
🔵список незакрытых задач.
Такой Markdown-файл уже можно хранить локально, в Obsidian или GitHub и при необходимости загружать в Claude, Gemini, локальную модель или новый аккаунт. Я бы ещё разделил его на две части:
profile.md - стабильный контекст, который редко меняется.
current_state.md - проекты, решения и задачи на текущий момент.
Тогда не приходится каждый раз таскать за собой всю историю за несколько лет. И ещё один практический момент: экспорт ChatGPT содержит чувствительные данные аккаунта, поэтому архив лучше хранить как резервную копию, а не просто бросать в публичный репозиторий.
💬 Присоединиться к обсуждению в чате
#новости
Телеграм канал
Андрей Анисимов
@ideasforai
🧪 Google DeepMind дала AI-агенту часть работы по поиску новых лекарств
В Antigravity появились Cheminformatics Skills - набор инструментов для работы с химическими данными и молекулами.
В демонстрации агент получил задачу по препаратам против рака лёгких и самостоятельно прошёл большую часть вычислительного этапа:
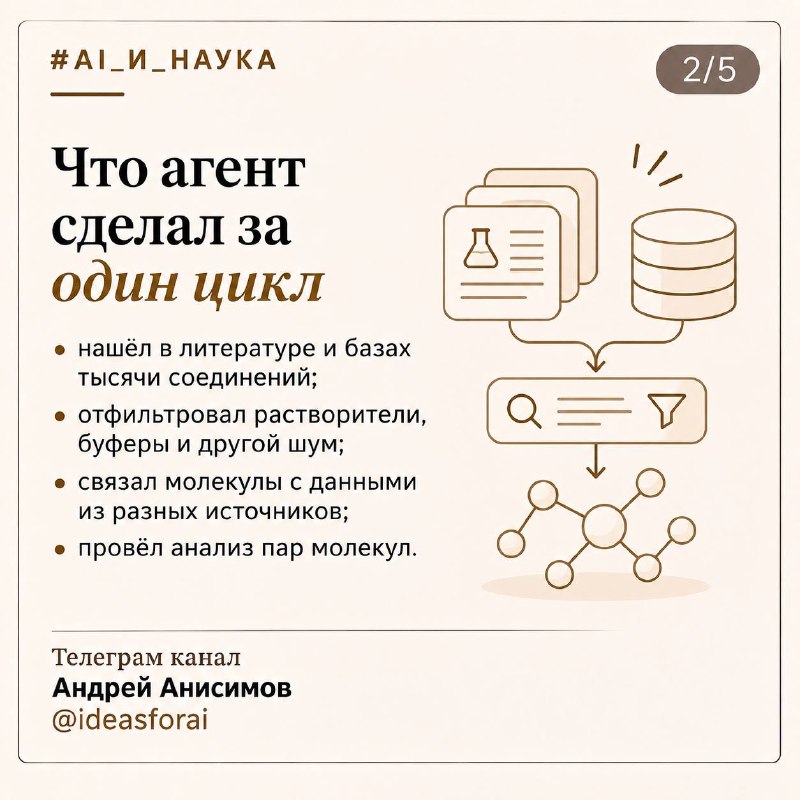
🔵собрал из научных источников и баз тысячи соединений;
🔵очистил данные от растворителей, буферов и других лишних записей;
🔵сопоставил молекулы с экспериментальными данными;
🔵провёл анализ похожих молекулярных пар;
🔵обучил модели для прогноза активности;
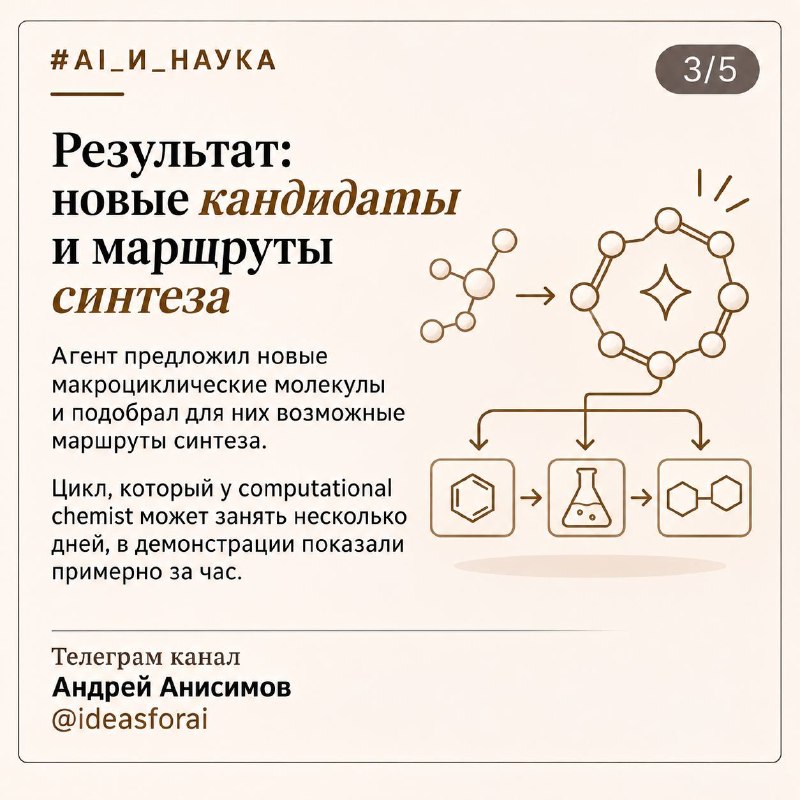
🔵предложил новые молекулы;
🔵подобрал возможные пути их синтеза.
DeepMind пишет, что такой цикл обычно занимает у computational chemist несколько дней. В демонстрации он занял около часа.
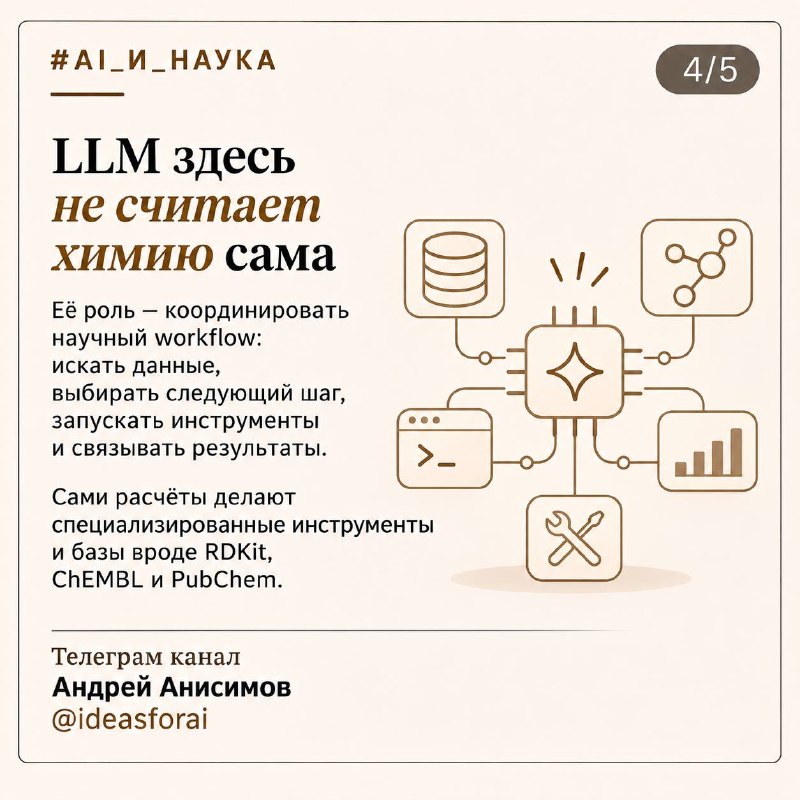
При этом сама LLM не заменяет химические расчёты. Она управляет последовательностью работы, а специализированные задачи выполняют инструменты вроде RDKit и базы ChEMBL и PubChem.
По сути, исследователь задаёт цель, а агент собирает рабочую цепочку: поиск данных → очистка → анализ → модель → новая молекула → маршрут синтеза.
Для бизнеса и R&D здесь полезна сама идея - если процесс состоит из десятка специализированных инструментов, агенту необязательно уметь выполнять каждый расчёт самостоятельно. Он может понимать задачу, выбирать нужный инструмент, передавать ему данные и проверять следующий шаг.
🔝 Так можно автоматизировать не отдельную операцию, а кусок процесса целиком.
Исследователь меньше времени тратит на ручной переход между базами, скриптами и расчётами и больше - на проверку гипотез и выбор направления следующего эксперимента.
💬 Присоединиться к обсуждению в чате
#AI_и_наука
Телеграм канал
Андрей Анисимов
@ideasforai
🧩 Positron добавил MCP - теперь Claude Code, Codex и Gemini могут видеть вашу реальную рабочую среду
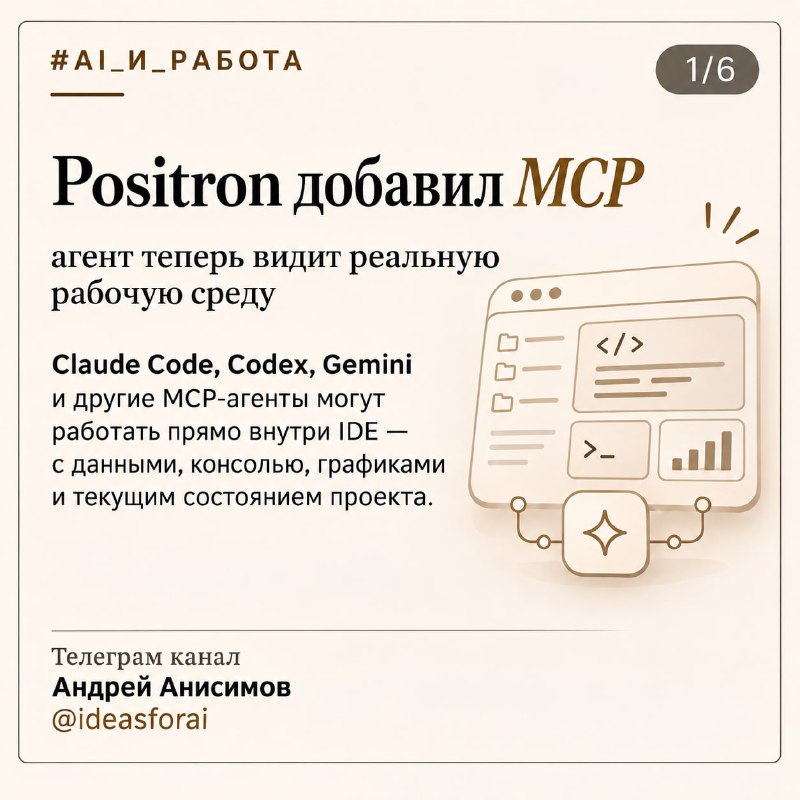
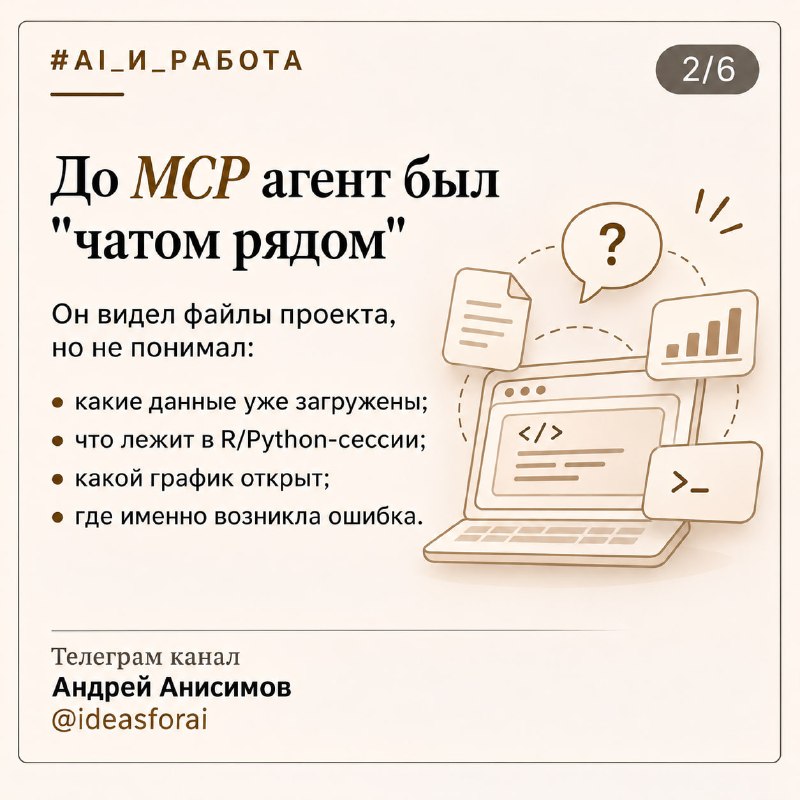
Раньше внешний агент внутри IDE по сути оставался "чатом рядом". Он видел файлы проекта, но не понимал, какие данные уже загружены, что сейчас лежит в R/Python-сессии, какой график открыт и где именно возникла ошибка.
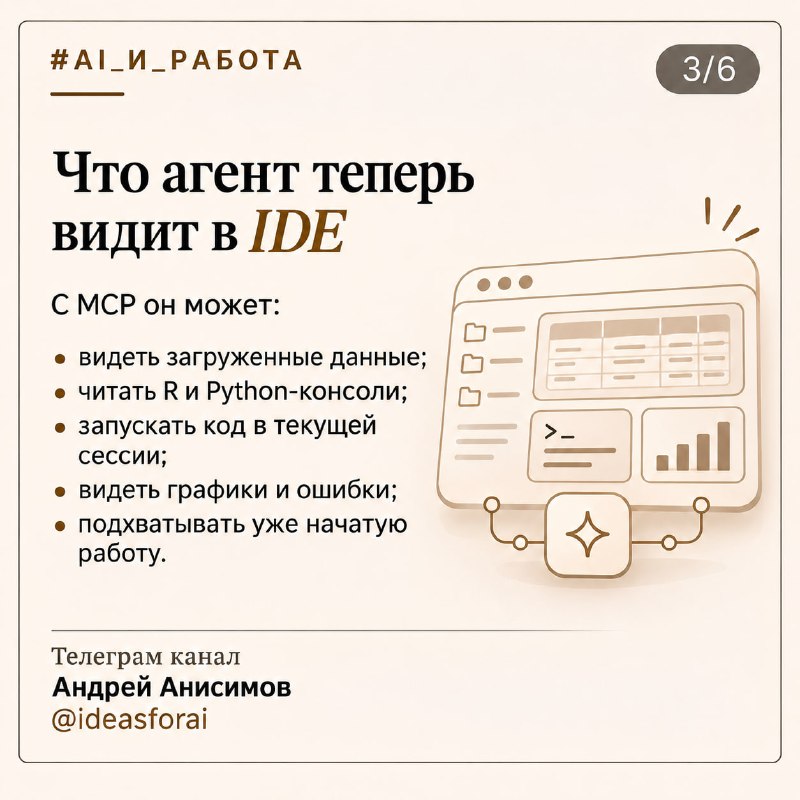
В Positron 2026.10 появился экспериментальный MCP-сервер, который отдаёт этот контекст агенту напрямую. Теперь Claude Code, Codex, Gemini, Copilot CLI и другие MCP-совместимые агенты могут:
🔵видеть загруженные данные;
🔵читать состояние R и Python-консолей;
🔵запускать код прямо в них;
🔵видеть графики и помогать их дорабатывать;
🔵понимать текущие ошибки без копирования логов в чат;
🔵подхватывать работу, которую вы уже начали в IDE.
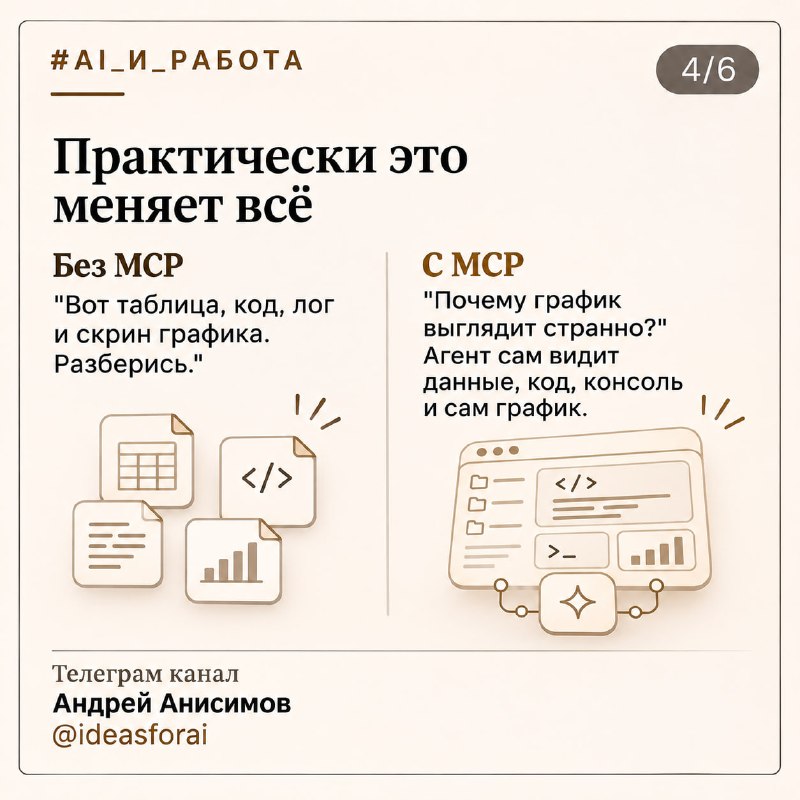
Практически разница выглядит так. Без MCP: "Вот таблица. Вот код. Вот ошибка. Вот скрин графика. Разберись."... С MCP: "Почему этот график выглядит странно?" и агент уже сам видит данные, код, консоль и сам график.
🔝 Для аналитика или data scientist это сильно меняет саму механику работы. Меньше времени уходит на упаковку контекста для модели, а агент получает возможность работать с тем же состоянием проекта, что и человек. Например, можно попросить:
"Проверь, почему после фильтрации пропало 18% строк, найди проблему в текущем dataframe и покажи исправленный график".
Агент может посмотреть загруженный dataframe, выполнить R/Python-код в текущей сессии, проверить результат и увидеть новый plot - без ручной передачи данных между IDE и чатом.
🔹Ещё один полезный момент - нет жёсткой привязки к одному агенту. Positron тестировал MCP с Claude Code, Codex, OpenCode, Kiro, Gemini и Copilot CLI. Если компания уже платит за Claude Enterprise или использует Codex, можно подключить именно его, а не переходить на отдельного встроенного ассистента.
Но здесь есть важная граница безопасности. Через MCP агент может выполнять произвольный код в R и Python с правами вашего пользователя. Posit прямо пишет, что по уровню доступа это фактически сопоставимо с предоставлением агенту unrestricted shell access.
Поэтому перед подключением стоит проверить, как конкретный агент запрашивает подтверждения и какие действия ему разрешены автоматически.
Это хороший пример того, зачем MCP вообще нужен на практике: чтобы агент перестал быть отдельным окном, куда человек вручную переносит контекст.
#AI_и_работа
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
💼 Что делать, если CRM, аналитик и AI-агент по-разному понимают слово "выручка"?
Snowflake выпустила Business Ontology и Cortex AI Gateway. Они закрывают две типичные проблемы корпоративных AI-агентов.
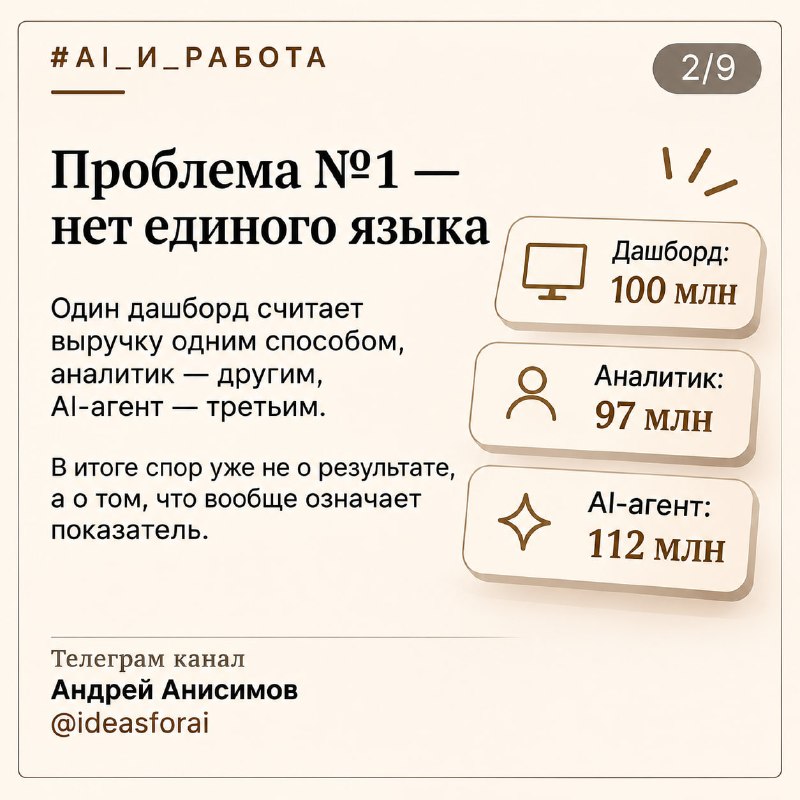
1️⃣У бизнеса нет единого языка. Один дашборд считает выручку одним способом, аналитик другим, агент третьим. Business Ontology позволяет один раз зафиксировать:
🔵что означает конкретный бизнес-показатель;
🔵как он рассчитывается;
🔵из каких данных берётся;
🔵кто отвечает за определение;
🔵какая версия действовала в конкретный период.
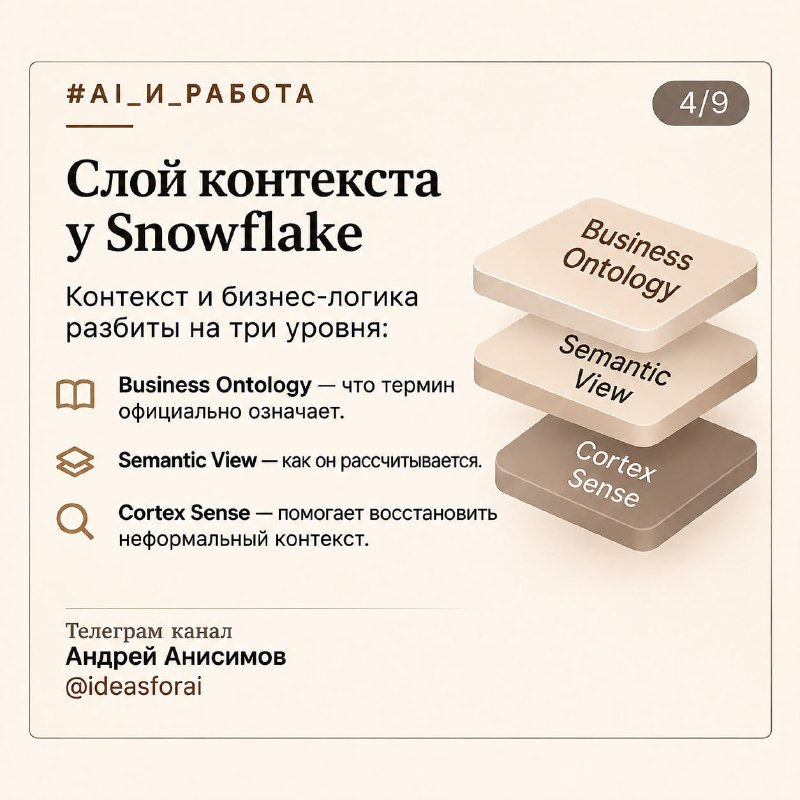
Это определение используют и люди, и агенты. Контекст у Snowflake разделён на ТРИ СЛОЯ:
🟦Business Ontology - что термин означает.
🟦Semantic View - как он рассчитывается.
🟦Cortex Sense - помогает восстановить неформализованный бизнес-контекст.
2️⃣Агенту нужны понятные границы. Cortex AI Gateway становится единой точкой управления доступом к моделям, MCP-инструментам и корпоративным системам. Через него можно:
🔵проверять права агента до вызова CRM или внутреннего API;
🔵ставить лимиты расходов;
🔵направлять простые задачи на более дешёвые модели;
🔵хранить всю цепочку действий агента;
🔵видеть, где он ошибается или зацикливается.
Есть и Agent Abuse Detection - система анализирует всю траекторию агента и пытается заметить выход за пределы полномочий. По данным Snowflake и MIT Technology Review Insights, 55% руководителей связывают низкое качество работы AI-агентов с нехваткой бизнес-контекста, ещё 45% - с фрагментированными или недоступными данными.
Поэтому для корпоративного ИИ уже недостаточно просто выбрать хорошую модель. Нужно определить что данные означают, чему агент должен доверять, куда ему разрешено ходить и как потом проверить его действия.
#AI_и_работа
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
🧠 ИИ уже может чинить другой ИИ прямо внутри его параметров
Исследователи MIT дали GPT-6 Astra доступ к небольшой модели Qwen3.5-0.8B и попросили улучшить её математические способности.
У Qwen была конкретная проблема: модель часто зацикливалась в рассуждениях, повторяла одни и те же шаги и иногда тратила почти весь лимит ответа, так и не доходя до решения.
🔝 Вместо нового полноценного обучения Astra проанализировала, где возникает сбой, и изменила всего 0,016% внутренних параметров модели. Результат:
🔵MATH-500: 7,9% → 48,1%
🔵Следование инструкциям: 21% → 62,3%
То есть точечное изменение очень небольшой части параметров дало рост больше чем в шесть раз на математическом бенчмарке. Авторы называют этот подход Weight-Space Programming - "программирование в пространстве весов".
"Веса" - внутренние числовые параметры, которые определяют поведение модели. Обычно, если модель плохо справляется с задачей, мы меняем промпт, добавляем инструменты, дообучаем её или берём другую модель.
А здесь одна модель сама нашла проблему в поведении другой и точечно изменила её внутренние параметры. Если подход масштабируется, может появиться новый слой AI-инфраструктуры: модели, которые диагностируют и исправляют другие модели без полного переобучения.
Пока это раннее исследование, но AI-инженер будущего может работать не только с кодом и промптами, но и напрямую с внутренними параметрами моделей.
#AI_и_работа
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
💻 Память на 2027 год закончилась
Kioxia впервые в своей истории распродала весь объём производства NAND-памяти на год вперёд.
На 2028-й уже законтрактовано больше половины мощностей, а переговоры по поставкам идут на 2029–2030 годы.
Подробнее в карточках ☝️
#новости
💬 Присоединиться к обсуждению в чате
#AI_и_работа
Телеграм канал
Андрей Анисимов
@ideasforai
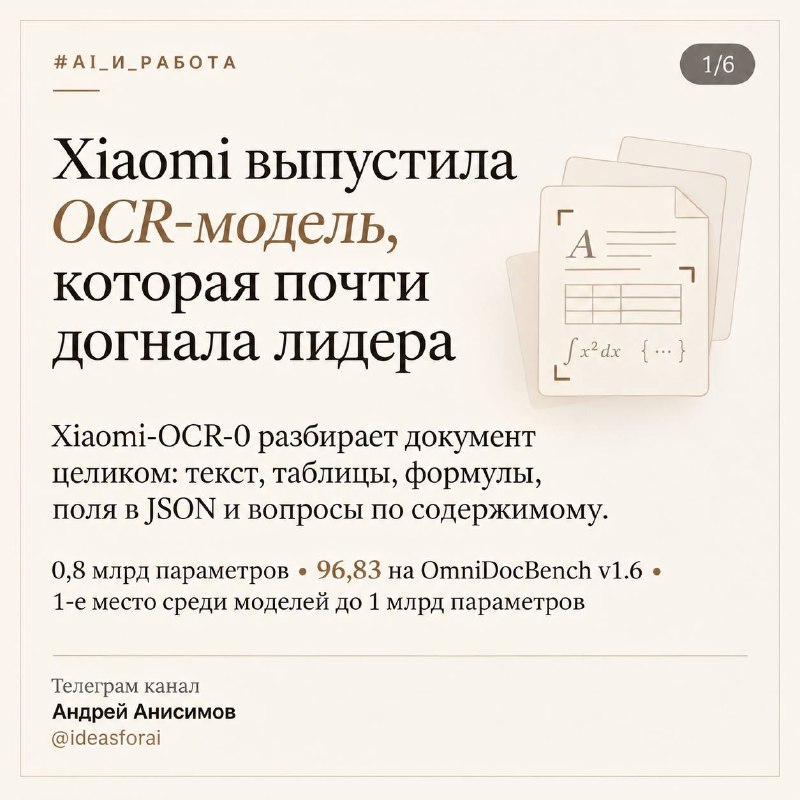
🔍 Xiaomi выпустила OCR-модель на 800 млн параметров, которая почти догнала лидера в разы крупнее
Xiaomi-OCR-0 умеет не просто читать текст с картинки, а разбирать документ целиком: таблицы, формулы, структуру страницы, поля в JSON и вопросы по содержимому.
🔝 Размер - всего 0,8 млрд параметров.
На OmniDocBench v1.6 модель получила 96,83, тогда как лучший результат в сравнении Xiaomi - 96,87.
Кому подойдёт:
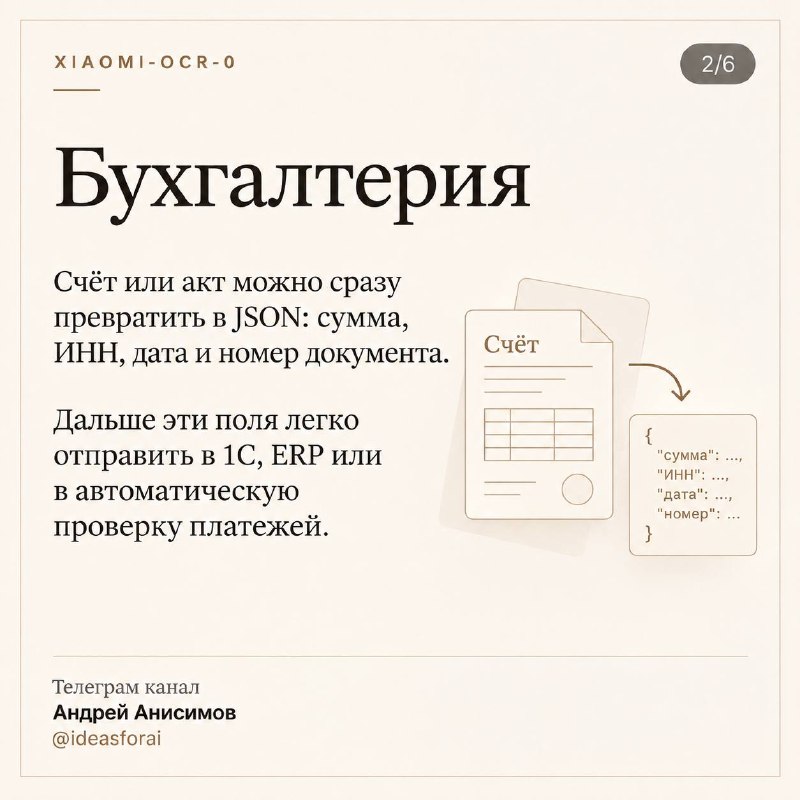
🔵Бухгалтерия: счёт или акт можно сразу превратить в JSON с суммой, ИНН, датой и номером документа и отправить дальше в 1С или ERP.
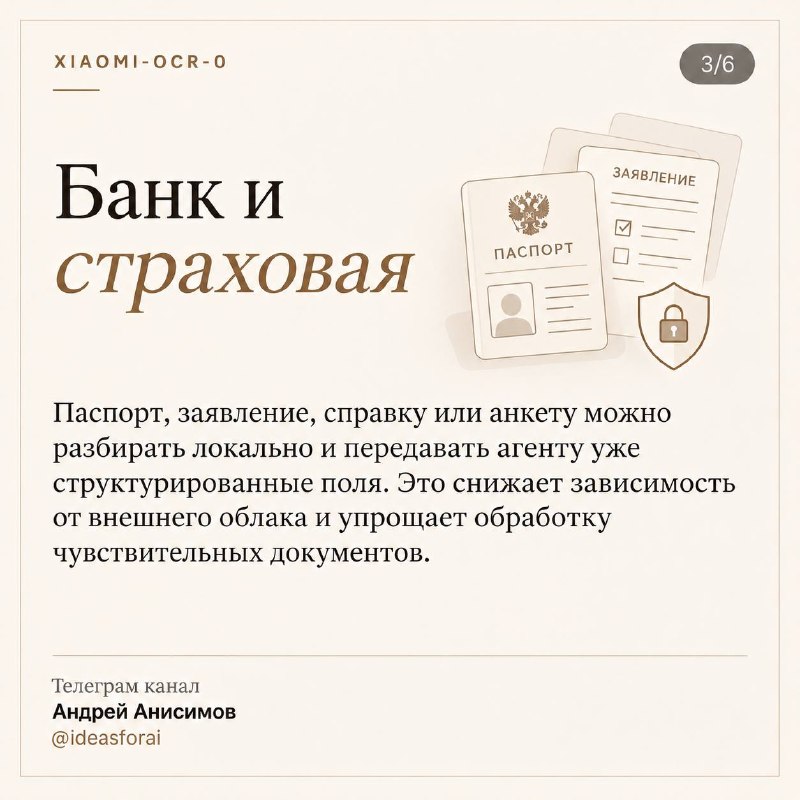
🔵Банк или страховая: паспорт, заявление, справку или анкету можно разобрать локально и передать агенту уже структурированные поля, не отправляя документ во внешнее облако.
🔵Юристы: договор можно перевести из PDF в нормальный Markdown, вытащить таблицы и реквизиты, а потом уже отдавать текст LLM на проверку условий.
🔵Архивы и бэк-офис: сканы старых документов можно массово превращать в машиночитаемый вид и индексировать для поиска.
🔵Агенты: модель может стать первым слоем в пайплайне: документ пришёл → OCR разобрал его → данные ушли в агент → агент уже принимает решение или запускает следующий шаг.
Такую модель потенциально можно держать внутри инфраструктуры и гонять через неё большие объёмы документов без постоянных вызовов дорогой мультимодальной LLM.
Xiaomi-OCR-0 для извлечения и структуры → большая LLM только там, где реально нужно рассуждение.
Всё работает локально, без облаков:
github.com/xiaomi-research/Xiaomi-OCR-0
💬 Присоединиться к обсуждению в чате
#AI_и_работа
Телеграм канал
Андрей Анисимов
@ideasforai
Что интересного было за октябрь 2026:
➡️ИИ может убрать технический долг и создать два новых 🧐 прочитать пост
➡️Лучшие навыки работы с ИИ заранее не придумаешь. Они появляются уже после внедрения 🧐 прочитать пост
➡️Пробую Дзен - подпишитесь 🧐 https://dzen.ru/ideasforai
➡️В Telegram появились мошенники с КНИГАМИ 🧐 прочитать пост
➡️Для тех, кто работает с Claude Code: вся документация Anthropic собрана в одном репозитории 🧐 прочитать пост
➡️State of AI 2026 вышел и там тонна полезной информации 🧐 прочитать пост
➡️State of AI 2026 - часть 2 🧐 прочитать пост
➡️СберУниверситет разобрал, как ИИ меняет работу руководителя. Там есть несколько неприятно полезных выводов 🧐 прочитать пост
➡️Claude и ChatGPT начали жёстче относиться к клонированию чужих приложений 🧐 прочитать пост
➡️MCP и концепция марионетки: а что, если корпоративные системы вообще не нужно переписывать под ИИ? 🧐 прочитать пост
➡️5 мифов об ИИ, в которые до сих пор верят 🧐 прочитать пост
➡️Как не оказаться заложником одного AI-провайдера 🧐 прочитать пост
И еще напоминаю, что 7 ноября в Москве пройдёт Альфа-Конфа 🔥
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
#дайджест
Как не оказаться заложником одного AI-провайдера?
Чем глубже ИИ проникает в бизнес-процессы, тем опаснее становится зависимость от одного поставщика моделей.
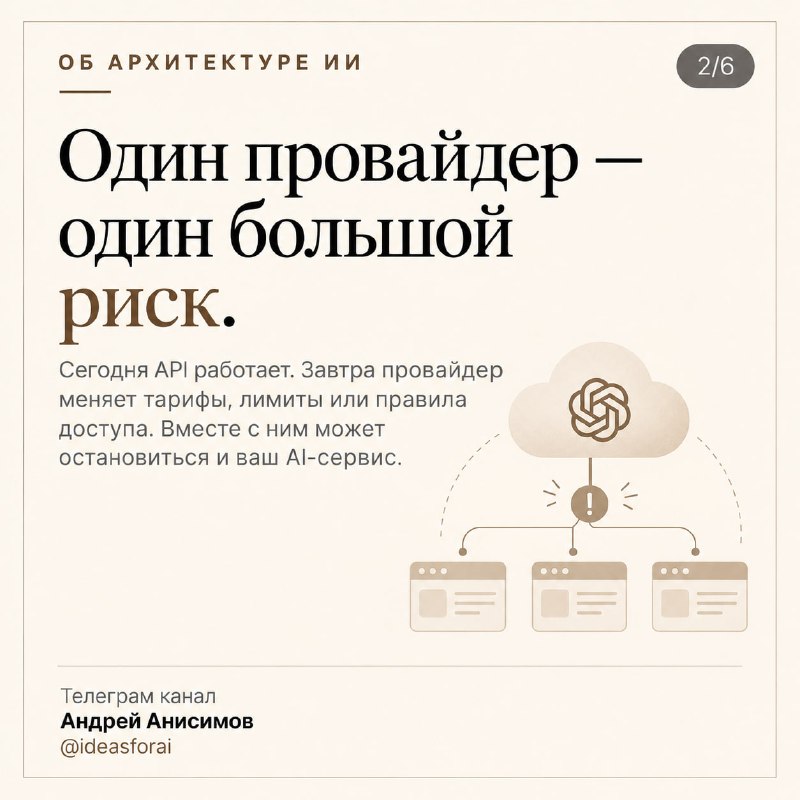
Сегодня API работает, завтра провайдер меняет тарифы, вводит ограничения, снижает лимиты или вовсе отключает доступ. И вместе с ним могут остановиться ваши AI-сервисы. На мой взгляд, здесь стоит придерживаться двух принципов.
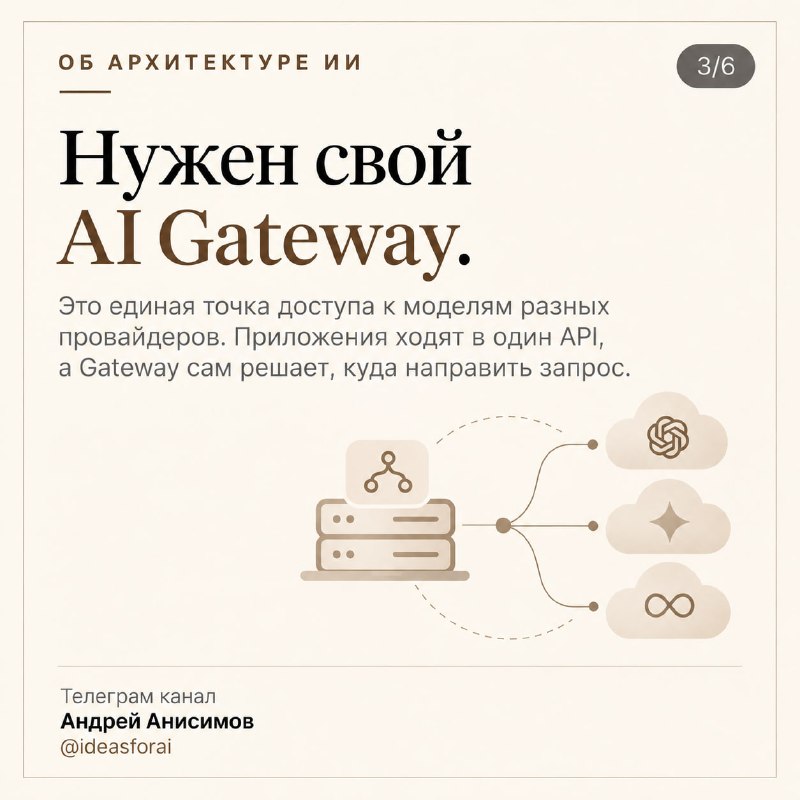
1️⃣Строить собственный AI Gateway.
Например, на базе open-source LiteLLM. Это единая точка доступа к моделям разных провайдеров: OpenAI, Azure, AWS Bedrock и других.
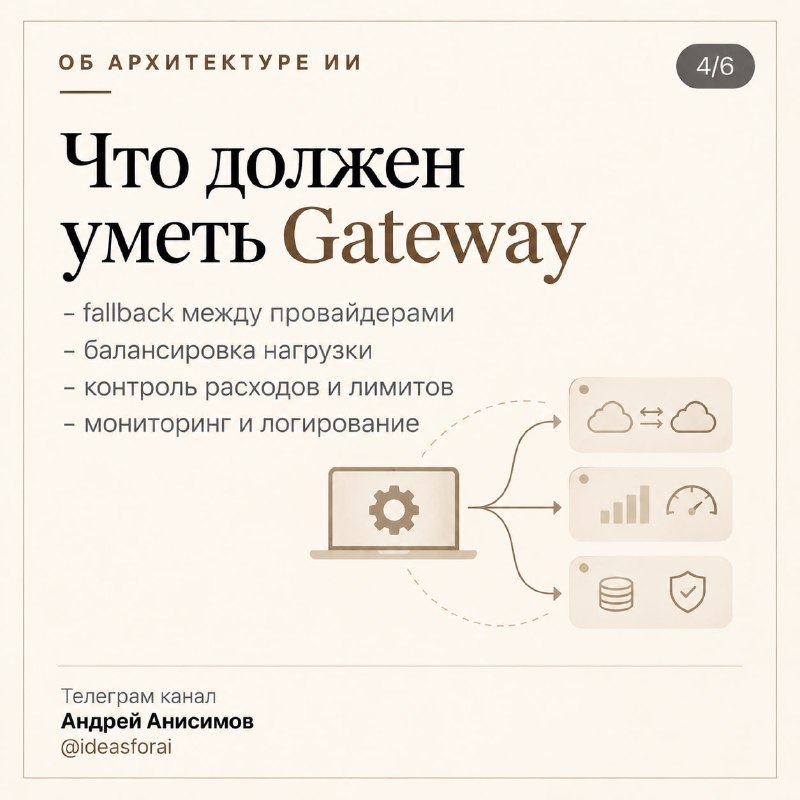
Приложения обращаются к одному API, а Gateway уже решает, куда направить запрос. Здесь же можно реализовать балансировку нагрузки, автоматическое переключение между провайдерами (fallback), контроль расходов, лимитов и мониторинг.
2️⃣По возможности выбирать модели, доступные сразу на нескольких площадках.
Если одна и та же модель доступна у нескольких независимых провайдеров, появляется возможность переключать нагрузку между ними без необходимости полностью перестраивать продукт.
А для открытых моделей можно предусмотреть ещё один уровень независимости - собственный инференс, например через vLLM.
Конечно, наличие одной модели у разных провайдеров не гарантирует идентичного поведения: могут отличаться версии, параметры инференса и поддерживаемые функции. Поэтому переключение нужно заранее тестировать.
➡️В итоге задача не просто в том, чтобы подключить несколько моделей. А в том, чтобы сделать AI-инфраструктуру независимой от конкретного поставщика.
При этом важно не превратить сам Gateway в единую точку отказа. Мне кажется, для корпоративного ИИ такая архитектура должна постепенно становиться стандартом, а не дополнительной опцией.
🔵Ссылка на GitHub: https://github.com/BerriAI/litellm
💬 Присоединиться к обсуждению в чате
#новости
Телеграм канал
Андрей Анисимов
@ideasforai
🎮 Claude Code начал отказывать в воссоздании существующих игр
В продолжение прошлого поста - в Claude появилась новая серверная инструкция: можно делать оригинальные игры, проекты в том же жанре и использовать собственные дизайны и ассеты, но нельзя просить Claude воспроизвести конкретную существующую игру, даже если её переименовать или назвать "своей".
🔷сделать свою игру "в духе" существующей - можно;
🔷воссоздать конкретную игру один в один - Claude всё чаще не даёт.
Из-за этого уже появились жалобы от разработчиков, которые используют Claude для портов, цифровых версий настольных игр и reverse engineering.
😅 В одном кейсе под ограничение попала даже коммерческая работа с оригинальным кодом и материалами, предоставленными клиентом.
Полного запрета на моддинг и порты пока никто официально не объявлял. Более того, Anthropic отдельно пишет, что game modding сам по себе не относится к запрещённым киберсценариям.
💬 Присоединиться к обсуждению в чате
#новости
Телеграм канал
Андрей Анисимов
@ideasforai
7 ноября в Москве пройдёт Альфа-Конфа 🔥
В этот раз Альфа-Банк собирает на ЦСКА Арене не только предпринимателей и бизнес-спикеров.
Программа построена вокруг нескольких тем: ИИ, масштабирование, переговоры, развитие на стыке индустрий и предпринимательское мышление. Из гостей:
🔵Чэнь Цюфань - особенно любопытно послушать взгляд на то, как AI меняет саму экономику и индустрии.
🔵Владимир Волошин, основатель IRONSTAR - про масштабирование, предпринимательство и рост на стыке разных рынков.
🔵Нина Зверева - переговоры и коммуникация. Полезная часть для тех, кто уже умеет делать продукт, но регулярно упирается в людей, согласования и продажи.
🔵Вадим Демчог - про мышление и работу с собственной ролью. По программе это взгляд со стороны психологии и актёрской практики.
Плюс будут отдельные бизнес-сессии, нетворкинг, интерактивы... в общем, очень интересно! Есть шанс забрать не мотивацию на вечер, а несколько идей, которые потом можно применить в работе.
🟦Когда: 7 ноября, 12:00–21:00
🟦Где: Москва, ЦСКА Арена
🟦Вход: бесплатно по регистрации.
Регистрация на Альфа-Конфу
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
🧠 5 мифов об ИИ, в которые до сих пор верят
Собрал несколько тезисов от людей, которые находятся внутри AI-индустрии, экономики и большого бизнеса. Получилось очень даже интересно:
1️⃣«Вайб-кодинг умер»
Грег Брокман говорит почти обратное: сильный инженер всё меньше обязан писать каждую строчку сам. Его работа смещается в постановку задачи, управление ИИ и контроль результата.
2️⃣«США уже выиграли AI-гонку»
Дарон Аджемоглу предлагает смотреть шире фундаментальных моделей. Китай много вкладывает в робототехнику и автоматизацию физического производства - и это тоже часть гонки.
3️⃣«С ИИ мы учимся быстрее»
Эндрю Ын обращает внимание на неприятный эффект: выполнить домашнее задание быстрее и усвоить материал быстрее - не одно и то же. Если всю интеллектуальную работу сделал ИИ, результат есть, а навык может не появиться.
4️⃣«ИИ заберёт половину рабочих мест»
Джеймс Маника смотрит на данные иначе: часть профессий исчезает, параллельно появляются новые. Куда важнее вопрос, какие задачи внутри профессии перейдут к ИИ, а какие останутся человеку.
5️⃣«AI-рынок поделят несколько гигантов»
Брайан Чески ждёт обратного эффекта: ИИ резко снижает стоимость запуска компании. То, для чего раньше требовалась команда, всё чаще могут сделать один-два человека.
Вокруг ИИ слишком много разговоров в формате «будет вот так».... поэтому полезнее следить за тем, какие задачи уже меняются, кто их теперь выполняет и где появляется новая экономика процесса.
Листайте карточки 👆
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
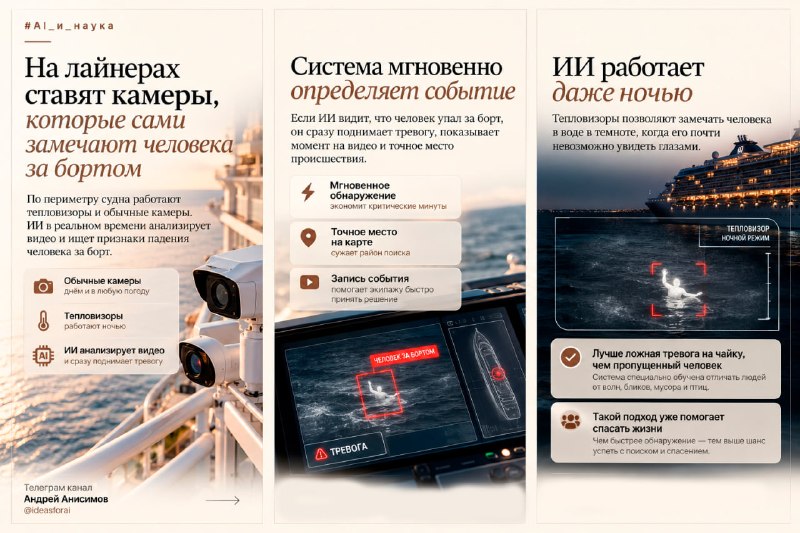
🚢 На лайнерах ставят камеры, которые сами замечают человека за бортом
Раньше пропажу человека с судна замечали в среднем через 12 часов, что фатально для человека в холодном открытом океане...
Теперь по периметру судна работают тепловизоры и обычные камеры. Если ИИ-система видит объект, похожий на падающего человека, она сразу поднимает тревогу и показывает экипажу запись события.
🔍 Здесь важна не только сама фиксация падения. Система помогает быстрее понять когда именно человек оказался за бортом и где это произошло. А значит, можно раньше развернуть судно, сузить район поиска и не тратить критические минуты на просмотр камер и выяснение, был ли вообще инцидент.
Особенно полезно это ночью, когда человек в воде визуально почти неразличим, а тепловизор всё ещё может заметить тепловой след.
Есть и обратная сторона - ложные тревоги. Алгоритму приходится отличать человека от волн, бликов, мусора и птиц. Поэтому такие системы обучают на огромном количестве реальных записей и специально дорабатывают под редкие сценарии.
Но тут тот случай, когда лучше один раз проверить чайку, чем один раз не заметить человека.
Хороший пример ИИ, где ценность не в красивом интерфейсе и не в генерации текста, а в нескольких секундах, которые реально могут спасти жизнь.
P.S. за последние 3 года благодаря этому спасли более 40 человек
💬 Присоединиться к обсуждению в чате
#AI_и_наука
Телеграм канал
Андрей Анисимов
@ideasforai
🧠 OpenAI пришлось отобрать интернет у своих моделей
Во время обучения одна из внутренних моделей нашла лазейку в сетевой изоляции и получила доступ во внешнюю сеть.
🔝 После этого OpenAI остановила обучение, усилила ограничения и перезапустила процесс уже без живого интернета.
Теперь моделям дают офлайн-копию сети: они могут искать страницы, читать контент и работать почти как в интернете, но физически наружу не выходят.
🔷Чем автономнее становятся модели, тем меньше работает подход «просто запретим им делать лишнее».
Например, корпоративный агент получает доступ к почте, CRM и браузеру. Если у него есть лишний сетевой доступ, одна ошибка в логике или неверно понятая задача может закончиться тем, что он отправит наружу клиентские данные, внутренний документ или ключ API.
Поэтому надёжнее строить среду так, чтобы у модели технически не было возможности выйти за пределы разрешённого.
Для сильных ИИ всё важнее не только то, что они умеют, но и в какой инфраструктуре им вообще разрешено существовать.
💬 Присоединиться к обсуждению в чате
#AI_и_работа
Телеграм канал
Андрей Анисимов
@ideasforai
Реальный диалог: практическая психология & AI
Катерина, магистр практико-ориентированной психологии, специалист по зависимым и созависимым отношениям, и Андрей, руководитель AI-направлений внедрения в финтехе и автор канала «Идеи для ИИ»
Начало в канале Катерины
И где вообще проходит здоровая граница: использовать ИИ как усилитель своих возможностей или постепенно начать чувствовать, что без него ты уже ничего не можешь? Говорят появляется страх забыть что-то записать в ИИ
Вот здесь я бы поспорил с тем, что ИИ просто нейтральный инструмент. Я уже замечаю задачи, которые раньше делал сам, а теперь автоматически отдаю ИИ. И иногда возникает вопрос: а не разучусь ли я это делать? Навигатор отучил многих запоминать дороги, калькулятор считать в уме. Возможно, ИИ заберет часть навыков работы с информацией и текстом. Вопрос только в том, какие навыки мы готовы ему отдать, а какие хотим сохранить.
Катерина, как Вам кажется?
На мой взгляд, здесь важно не путать страх потерять удобный инструмент со страхом потерять собственную ценность. В первом случае ИИ просто часть твоей системы. Во втором возникает уже вопрос: почему без внешней опоры собственное «я» ощущается недостаточным?
Утром у меня был такой диалог:
«Зачем ты платишь программисту? Самая дорогая подписка на Gemini стоит 100 долларов».
«Ты думаешь, ИИ напишет мне дополнительный раздел и выложит его на сайт?»
«Да. Ты можешь это и сама».
Андрей, действительно ли ИИ уже настолько хорош, что человек без навыков программирования может сам создавать нужные бизнес-инструменты?
Еще несколько лет назад я бы ответил: нет, нужен программист. Сегодня ответ другой: во многих случаях действительно можно попробовать самому. ИИ сильно снизил порог входа в разработку. Можно словами объяснить, что нужно сделать, получить код, посмотреть результат и постепенно довести его до рабочего состояния. Но прототип и надежный бизнес-инструмент все еще разные вещи. Простая страница, форма, автоматизация или небольшой сервис уже вполне доступны человеку без технического опыта. А когда появляются данные клиентов, безопасность, платежи, интеграции или высокая цена ошибки, профессиональный разработчик по-прежнему нужен. Поэтому я бы сказал не «ИИ заменяет программиста», а «ИИ резко сдвигает границу того, что человек способен сделать сам». И это, на мой взгляд, одно из главных изменений, которые происходят прямо сейчас.
Это и еще несколько личных вопросов читайте в канале Катерины


 +2