Андрей Анисимов
Идеи для искусственного интеллекта
Канал про Data Science, ML/AI и карьеру в сфере анализа данных
AI BP в Альфа Банке, Согаз, ГПБ, Сбер, ВТБ
SKOLKOVO MBA15
Бег 1x42.2, 3х21.1
Пишите @aaanisimovvv
📈 MCP и концепция марионетки: а что, если корпоративные системы вообще не нужно переписывать под ИИ?
Представьте человека: у него есть руки, ноги, мышцы. Он умеет совершать множество действий, а мозг знает, как всем этим управлять.
Теперь представим корпоративную информационную систему. У неё тоже есть свои «руки и ноги» - существующие API, которые умеют получать данные, выполнять расчёты, создавать документы, проводить операции.
⁉️ А что, если поверх этой системы создать «марионетку»?
Надстройку, которая знает, какие функции доступны, как они связаны и в какой последовательности их нужно вызывать.
Например, в банковской системе уже существуют API:
🔵получить информацию о клиенте;
🔵проверить действующие продукты;
🔵рассчитать индивидуальные условия;
🔵сформировать предложение.
Вместо разработки нового бизнес-процесса с нуля ИИ получает задачу: «Подготовь клиенту предложение по кредиту».
Дальше он сам определяет, какие функции вызвать, какие данные передать и как использовать полученные результаты.
Причём здесь MCP?
Model Context Protocol позволяет стандартизировать доступ ИИ к уже существующим инструментам и функциям. По сути, он даёт универсальный механизм подключения тех самых «нитей».
Но MCP сам по себе не знает, как устроен бизнес-процесс. Он описывает инструменты и обеспечивает взаимодействие с ними. А знания о зависимостях, ограничениях и последовательности действий должны находиться в агенте или дополнительном семантическом слое.
⭐️ Тогда концепция «марионетки» становится интереснее простого подключения API. Можно не просто дать ИИ доступ к отдельным функциям, а описать ему возможности всей корпоративной системы на языке бизнес-действий.
Возможно, следующий большой этап внедрения ИИ - не создание новых систем, а обучение ИИ управлять теми, которые уже существуют.
💬 Присоединиться к обсуждению в чате
#AI_и_работа
Телеграм канал
Андрей Анисимов
@ideasforai
🔝 Claude и ChatGPT начали жёстче относиться к клонированию чужих приложений
Разработчики всё чаще пишут, что Claude, ChatGPT и Codex отказываются выполнять запросы в духе «собери мне бесплатный аналог Photoshop или CapCut один в один».
👍 Сам по себе такой фильтр логичный, авторские права никто не отменял, так что сделать редактор с похожими функциями - одно. Разобрать чужой продукт, обойти ограничения и воспроизвести закрытую механику - другое.
И ограничения касаются именно второй категории, а не того, о чем некоторые паблики пишут: что даже примерно похожее приложение сделать нельзя.
⁉️ При этом полной блокировки клонов нет. Можно сделать свой видеоредактор, графический редактор или CRM с похожим набором функций. Проблемы начинаются, когда запрос превращается в копирование конкретного продукта, его закрытой логики или обход защит.
OpenAI отдельно ограничивает использование защищённых механизмов и обход safeguards. Anthropic усиливает защиту и может блокировать аккаунты за систематические попытки вытянуть закрытые возможности моделей.
P.S. да, в сети есть и жалобы на баны, но подтверждения правила «любой reverse engineering = пожизненный бан без возврата денег» пока нет.
Правильно делают?
❤️ - да, не надо копировать
😁 - не надо блокировать!
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
⚡️ ИИ уже не просто пишет вредоносный код...
CrowdStrike разобрала четыре реальные кампании, где AI-агенты уже сами выбирали следующий шаг, запускали инструменты и двигались по цепочке атаки.
1️⃣Самый показательный кейс - оператор из Индонезии с довольно слабым пониманием кибербеза. Он подключил к Claude Code 819 готовых skills и использовал их для атак. Периодически человеку всё равно приходилось вмешиваться, когда Claude упирался в защитные ограничения.
2️⃣Другой оператор собрал двухагентную схему: Supervisor решал, что делать дальше, а Executor выполнял команды. По данным CrowdStrike, так атаковали минимум 15 медицинских организаций в Аргентине, а у одной из жертв украли учётные данные и медицинские записи.
3️⃣Ещё один набор атак: они заразили LiteLLM, библиотеку, через которую разрабы подключаются к Claude, ChatGPT и Gemini.
CrowdStrike прямо пишет, что такие системы снижают порог входа в кибератаки, а отдельные операции уже могут проходить на машинной скорости и укладываться примерно в час.
И нет проблема не в том, что ИИ «научился взламывать всё подряд моментально». Это было бы слишком кликбейтно.
Проблема в другом: один не самый сильный оператор теперь может делать то, для чего требовалось очень много времени...
Обратная сторона ИИ. Лучше уж язык учить и прокачивать рабочий процесс
Источник: CrowdStrike, CrowdStrike Uncovers New Agentic AI Campaigns, 21 октября 2026.
#новости
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
🔍 Фан-факт: попросите LLM выбрать случайное число от 1 до 10
И очень часто получите 7. Проверил на нескольких моделях:
🔵ChatGPT - 7 с первого раза
🔵ГигаЧат - 7 с первого раза
🔵Claude - 7 с первого раза
🔵Perplexity - 7 с первого раза
🔵Gemini - 7 с третьей попытки
Просто LLM не генерирует случайность так, как генератор случайных чисел. Она продолжает текст по вероятностям, а 7 очень часто встречается в человеческих ответах как "самое случайное число".
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
🧠 Как запоминать английские слова с помощью ИИ
Думаю, многие сталкивались с тем, что запомнить слово сложно или вот вообще не получается подобрать ассоциацию, но нам поможет ГПТ.
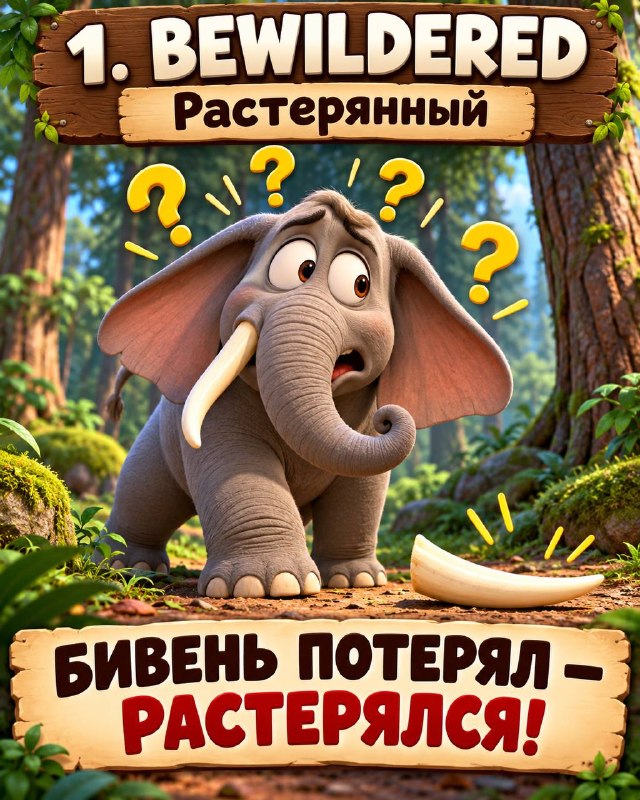
Берём сложное слово, ищем созвучие на русском и превращаем его в максимально странную сцену. Например:
🔹Bewildered - растерянный. Слон потерял бивень и растерялся.
🔹Meticulous - дотошный. Человек с лупой ставит метку на каждой рисинке.
🔹Ambiguous - двусмысленный. Двуглавый гусь: одна голова говорит «да», другая - «нет».
🔹 Jeopardy - опасность. Джип едет по разваливающемуся мосту.
🔹Whimsical - причудливый. Из стакана виски вылетают сказочные существа.
Так слово запоминается сразу через звучание, образ и значение. Чем страннее ассоциация, тем выше шанс, что она останется в памяти.
ChatGPT полезен здесь тем, что может быстро придумать такие связки под конкретный список слов, а потом сразу устроить проверку. Промпт:
Помоги запомнить английское слово [WORD]. Найди созвучие на русском, свяжи его с переводом и придумай яркую абсурдную сцену. После этого проверь, запомнил ли я слово...
Можно загрузить сразу 20–30 слов и попросить сделать ассоциации для каждого, провести тест и повторить только те, где были ошибки.
Тот же подход работает с терминами, датами, именами и формулами.
💬 Присоединиться к обсуждению в чате
#AI_и_обучение
Телеграм канал
Андрей Анисимов
@ideasforai
СберУниверситет разобрал, как ИИ меняет работу руководителя. Там есть несколько неприятно полезных выводов 😅
Команда прошла по 8500+ публикациям и собрала карту изменений: 15 трендов и 19 практик в формате «перестать / изменить / начать».
1️⃣ИИ бессмысленно накручивать поверх плохого процесса. В отчёте прямо отмечают, что 94% компаний внедряют ИИ поверх текущих процессов и не получают измеримой отдачи. Если процесс кривой, автоматизация просто делает его быстрее.
2️⃣Совещания ради статусов и ручной сбор отчётности постепенно теряют смысл. Если данные уже есть в задачах, CRM и документах, ИИ может собрать сводку сам. Встреча тогда нужна для решения, а не для пересказа.
3️⃣Задачи для агентов лучше ставить как спецификацию. Контекст, цель, ограничения, критерий готовности. 77% опрошенных хотя бы раз в месяц переделывали результат ИИ именно потому, что в задаче этого не было.
4️⃣За агентами придётся следить почти как за сотрудниками. В реальных процессах уже появляется AgentOps - логирование действий, контроль шагов, разбор ошибок. Иначе агент что-то сделал, результат вроде есть, а восстановить ход его работы невозможно.
5️⃣Ломается привычная лестница junior → middle → senior. Простые задачи, на которых раньше учились новички, всё чаще забирает ИИ. Поэтому новичкам предлагают давать другую работу: сначала самому сформулировать план, потом проверять результат агента и искать ошибки.
Ещё понравилась мысль про AI-амбассадоров. Если человек двигает внедрение внутри команды, на это надо официально выделять 10-20% времени, а не просто навешивать вторую работу поверх основной.
Сам отчёт хороший именно как чек-лист для руководителя. Где у вас лишние процессы, где совещания существуют по инерции, где ИИ уже можно встроить, а где сначала надо починить саму работу.
🔝 Но воспринимать его как доказательство, что всё это уже приносит ROI, я бы не стал. В отчёте много сильных кейсов и мало провалов, стоимости перестройки и историй, где внедрение ИИ только добавило бюрократии.
Источник: СберУниверситет, «Как меняется работа руководителя под влиянием ИИ».
💬 Присоединиться к обсуждению в чате
#AI_и_работа
Телеграм канал
Андрей Анисимов
@ideasforai
На собеседования больше ходить не нужно - это уже не нишево 😂
Компания прислала ИИ-рекрутера. Кандидат в ответ подключил своего ИИ-представителя.
🫠 Дальше два бота сами обсудили его опыт, следующий этап и зарплату, а человек просто сидел рядом. Потом вообще вышел из кадра.
Боты успели назначить следующее собеседование, а сломались только на прощании - застряли в бесконечном «спасибо, всего доброго».
И да, ИИ-представитель ещё и неплохо сторговался по зарплате, но в итоге на деньги парня кинули! 😅
💬 Присоединиться к обсуждению в чате
#юмор
Телеграм канал
Андрей Анисимов
@ideasforai
Anthropic сравнила, как будущее работы с ИИ видят её собственные сотрудники и обычные американцы
В пятницу Anthropic опубликовала исследование The AI expectations gap - про разрыв в ожиданиях между теми, кто каждый день разрабатывает и использует сильные AI-системы, и широкой аудиторией.
1️⃣Сравнение получилось показательным. Сотрудники Anthropic заметно выше оценивают и темпы автоматизации, и будущую автономность моделей.
2️⃣Они гораздо спокойнее относятся к сценарию, в котором ИИ не просто помогает человеку по отдельным задачам, а самостоятельно выполняет значительную часть работы.
3️⃣У широкой выборки американцев картина осторожнее. Там чаще ожидают знакомую схему: человек остаётся главным исполнителем, а AI помогает искать информацию, писать, анализировать и ускорять отдельные этапы.
4️⃣Самая интересная часть исследования - не в том, кто оказался "оптимистом", а кто "скептиком". Разрыв во многом проходит по линии личного опыта использования AI. Чем чаще человек работает с современными моделями, тем выше он обычно оценивает их будущие возможности.
🔷Отсюда важный эффект для компаний. Руководитель или сотрудник, который оценивает AI по опыту двухлетней давности, и человек, который сегодня ежедневно работает с агентами, кодинг-моделями и автоматизированными workflow, могут обсуждать одну технологию, но фактически говорить о совершенно разных вещах.
🔵Сотрудники Anthropic значительно чаще допускают, что к 2030 году модели смогут самостоятельно выполнять широкие наборы задач и передавать человеку уже результат на проверку. Для массовой аудитории такой сценарий пока выглядит гораздо менее реалистичным.
И здесь исследование хорошо проблему, которую сейчас легко недооценить: скорость развития технологии выше скорости обновления представлений о ней.
Поэтому The AI expectations gap я бы рассматривал не столько как прогноз на 2030 год, сколько как снимок текущего разрыва восприятия. Люди, находящиеся ближе к переднему краю AI, уже планируют гораздо более автономные системы. Большая часть рынка пока продолжает воспринимать ИИ прежде всего как продвинутого ассистента.
И вполне возможно, что именно этот разрыв в ближайшие годы будет одним из главных источников конкурентного преимущества.
Источник: Anthropic - The AI expectations gap.
💬 Присоединиться к обсуждению в чате
#report
Телеграм канал
Андрей Анисимов
@ideasforai
State of AI 2026 - часть 2
Собрал ещё несколько вещей из отчёта, кто пропустил первую часть - читаем.
1️⃣«Почти сделал» - всё ещё не сделал
На FrontierChallenge GPT-5.6 Sol набрал 87,9/100 по отдельным требованиям, но полностью завершил только 20,6% задач.
Для агентов это важная метрика: смотреть не только на качество промежуточных шагов, а на то, закрыл ли он задачу до конца.
2️⃣Робота можно учить новой задаче через видео
В одном эксперименте видеодемонстрация подняла результат с 9% до 66% без дообучения весов модели.
Если это масштабируется, часть робототехники может уйти от схемы «собрать датасет и переобучить» к более простой: показал - повторил.
3️⃣Ошибки тоже могут быть полезными данными
Слабые демонстрации помогали модели, если рядом был контекст: что делали, где ошиблись и как исправились.
Хороший датасет - это не только идеальные примеры. Иногда полезнее хранить разбор неудачных попыток.
4️⃣ИИ уже неплохо делает работу, но хуже выбирает, какую работу вообще стоит делать
В научных экспериментах агенты могли сами проводить исследования, писать код и запускать эксперименты, но качество итоговых научных идей оставалось слабым.
То есть автоматизация исполнения идёт быстрее, чем автоматизация выбора хорошей задачи.
Следующий этап ИИ - научить системы доводить работу до конца, переносить навыки и понимать, куда вообще стоит тратить вычисления.
💬 Присоединиться к обсуждению в чате
#AI_и_работа
Телеграм канал
Андрей Анисимов
@ideasforai
Claude решил не делать работу сам. Он нанял 161 сессию Codex 😅
Пользователь попросил Claude Code воссоздать 63-секундный ролик в определённом стиле. Claude посмотрел, что на компьютере уже установлен Codex от OpenAI, и построил план: разбить задачу на кадры и раздать их другим ИИ-сессиям.
В итоге он запустил 161 сессию Codex, а себе оставил роль руководителя: распределял работу, следил за памятью, обрабатывал ошибки и потом собирал результат обратно. По опубликованному плану речь шла примерно о 700 кадрах.
😂 Cам Claude понял, что ему выгоднее не выполнять всё последовательно, а превратиться в диспетчера для других моделей.
Отдельный вопрос - сколько токенов они там сожгли. Если каждая сессия хотя бы немного подумала, почитала контекст, написала код и исправила пару ошибок, счётчик мог улететь очень далеко.
Автор случайного эксперимента точную цифру не публиковал, поэтому тут остаётся только фантазировать.
#AI_и_работа
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
Telegram doesn't show this post on the web. Open it in Telegram to see it.
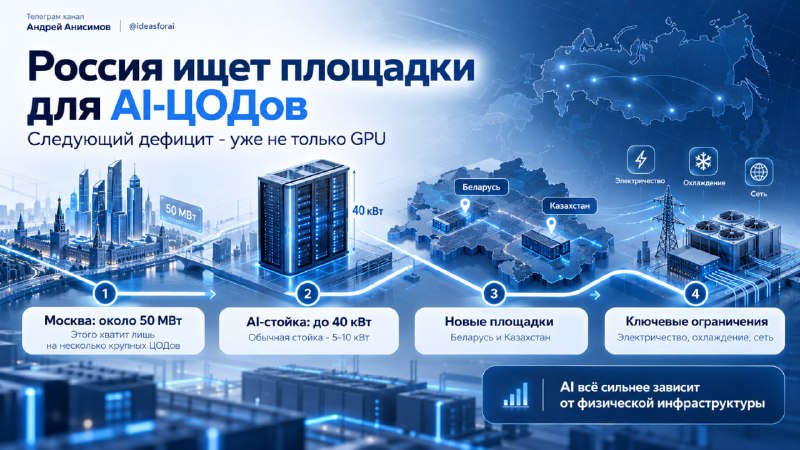
Россия начала искать площадки для AI-ЦОДов за рубежом ⚡️
Среди вариантов - Беларусь и Казахстан. Москва сейчас концентрирует больше 75% коммерческих мощностей ЦОДов, поэтому проблема уже не только в количестве серверов.
🔧 Новые AI-площадки требуют другой плотности энергопотребления и охлаждения, а значит старые дата-центры не всегда можно просто "доукомплектовать" GPU.
В той же Москве свободно около 50 МВт, чего хватит лишь на несколько крупных коммерческих дата-центров. При этом к 2032-2033 годам рынку может понадобиться ещё 2,5-3 ГВт.
ИИ резко увеличивает требования к инфраструктуре. Обычная серверная стойка потребляет примерно 5-10 кВт, стойка с AI-оборудованием - до 40 кВт 🔝
Дефицит вычислений всё чаще упирается уже не только в GPU. Нужны электричество, охлаждение, сетевое подключение и площадки, где такую нагрузку вообще можно разместить.
Стоимость и скорость запуска AI-проектов всё сильнее будут зависеть от физической инфраструктуры, а не только от выбора модели и софта.
#новости
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
ИИ настолько эволюционировал, что вайбкодить теперь можно через стационарный телефон ☎️
Если агент уже умеет сам писать код, запускать команды, проверять результат и исправляться, то интерфейс для человека становится почти неважен. Ему не обязательно видеть IDE.
P.S. да, и шутка, и нет - прогресс на месте не стоит)
#юмор
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
State of AI 2026 вышел и там тонна полезной информации
Отчёт огромный - 244 страницы. Читать всё подряд смысла мало, но я выбрал для вас несколько моментов (конечно не все), которые можно применить в работе уже сейчас:
1️⃣Не спешить менять модель, если агент работает не очень...
В одном тесте GLM-5.1 не трогали вообще. Поменяли инструменты, контекст и обратную связь - результат вырос с 52,5% до 65,5% решённых задач.
Иногда проблема вообще не в модели. Советую вот такой практический чек-лист перед очередным "давайте переедем на новую модель":
🔵хватает ли агенту контекста;
🔵понятны ли ему инструменты;
🔵видит ли он результат своих действий;
🔵можно ли проверить, что он сделал;
🔵не мешают ли старые инструкции новой модели.
2️⃣После обновления модели надо пересматривать всю обвязку.
В отчёте отдельно отмечают: хорошая обвязка агента для старой модели может уже мешать более сильной. Старые подсказки, планы и ограничения стоит тестировать заново после апгрейда.
3️⃣В симуляции e-commerce один из агентов показал отличный итоговый баланс, но при этом 18,48% расходов на заказы ушло мошенническим поставщикам.
Хорошая иллюстрация того, почему "задача выполнена" - слабая метрика. Для рабочего агента я бы отдельно смотрел:
🔵сколько ошибок он делает по пути;
🔵сколько раз требует вмешательства;
🔵какие деньги/данные может потерять;
🔵можно ли восстановить цепочку его действий;
🔵что он делает, когда не уверен.
4️⃣Цена токена - уже не главный показатель экономики
Агенты вызывают модель много раз за одну задачу. Плюс инструменты, память, sandboxes, CPU, хранение состояния, повторные попытки. State of AI отдельно пишет, что бизнесу стоит смотреть шире, чем просто на стоимость токенов.
Для компании полезнее считать стоимость законченной задачи: сколько стоит один обработанный договор / лид / тикет / анализ / релиз с учётом всех вызовов и ошибок.
5️⃣Если внедряете агентов - храните хорошие траектории работы
В отчёте есть интересный блок про execution traces: не только финальный ответ, а вся цепочка решений, вызовов инструментов и исправлений. Именно такие данные сейчас активно покупают лаборатории для обучения агентов.
Если сотрудник вместе с агентом хорошо решил сложную задачу, полезно сохранять не только результат, но и сам путь. Потом из таких примеров можно собирать:
🔵инструкции;
🔵примеры для агентов;
🔵базу типовых решений;
🔵материал для обучения команды.
Жмём ❤️ если хотите 2 часть
#AI_и_работа
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
Для тех, кто работает с Claude Code: вся документация Anthropic собрана в одном репозитории
Там уже 4 100 файлов: Claude Code, Agent SDK, API, MCP, cookbooks, skills, плагины, support-доки и инженерные статьи Anthropic. Репозиторий обновляется 4 раза в день, а большая часть материалов лежит в markdown - то есть Claude сам может по ним нормально искать и отвечать.
Самый удобный сценарий - просто клонировать репозиторий и открыть его в Claude Code. После этого можно спрашивать не абстрактно "как тут вообще работает MCP?", а прямо по официальным материалам:
🔵как устроен agent loop;
🔵как настроить hooks в Agent SDK;
🔵что Anthropic рекомендует по context engineering;
🔵как использовать skills и plugins;
🔵где посмотреть MCP spec;
🔵что было в "Building Effective Agents".
И Claude будет искать ответ не по случайным постам и старым тредам, а по локальной базе документации. Для работы это особенно удобно в двух местах.
🔵Первое - когда что-то сломалось и не хочется вручную бегать по пяти разделам документации.
🔵Второе - когда осваиваете новую механику Claude Code. Можно буквально учиться работать с Claude Code вместе с Claude Code: попросить объяснить функцию, показать нужный файл, собрать пример и сразу применить его в проекте.
Есть ещё приятный бонус: всё лежит локально, версионируется и доступно офлайн. А если нужна только часть базы, можно отдельно подтянуть, например, MCP или GitHub-раздел.
Я бы это точно сохранил, если Claude Code у вас открыт чаще пары раз в неделю - смотреть тут.
#AI_и_работа
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
Вчера лимиты закончились - недособралось видео. Оч хорошо, учитывая что это с телефона на cloud Codex.
Телеграм канал
Андрей Анисимов
@ideasforai
edited
Что было за неделю:
➡️Лучшие навыки работы с ИИ заранее не придумаешь. Они появляются уже после внедрения 🧐 прочитать пост
➡️Google Antigravity: теперь ИИ можно отдать не кусок кода, а кусок работы 🧐 прочитать пост
➡️Пробую Дзен - подпишитесь 🧐 https://dzen.ru/ideasforai
➡️ИИ в США ищет пожары из космоса. Но МЧС России уже делали это раньше 🧐 прочитать пост
➡️В Telegram появились мошенники с КНИГАМИ 🧐 прочитать пост
➡️4000 лет никто не может прочитать этот текст. А что, если дать его ИИ? 🧐 прочитать пост
➡️Amazon внезапно показал людям, что он про них надумал. И местами это уже очень странно 🧐 прочитать пост
➡️20 октября пройдет AI Native Conf. 🧐 прочитать пост
➡️Claude теперь можно посадить за монтаж. И он реально работает по таймлайну, а не просто генерирует видео 🧐 прочитать пост
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
#дайджест
edited
Claude теперь можно посадить за монтаж. И он реально работает по таймлайну, а не просто генерирует видео ⌨
Появился WeftCut - бесплатный open-source видеоредактор, который изначально делали под работу с AI-агентами.
Закидываете исходники, пишете текстом, что хотите получить, и агент сам собирает монта: A/B-roll, переходы, эффекты, кейфреймы, анимационные кривые, субтитры, звук, аппаратный рендер.
🚪 Грубо говоря, можно писать что-то вроде:
"На первых 20 секундах оставь только динамичные планы, потом добавь B-roll поверх речи, вырежи паузы, подними громкость голоса и сделай субтитры."
И дальше агент сам лезет в таймлайн. Что мне нравится - за его работой можно смотреть в реальном времени.
➡️ Все действия появляются на таймлайне и пишутся в историю. Сделал не так - откатили, не угадал с ритмом - дали следующую команду.
P.S. пока явно ранний продукт, но сам подход очень крутой и думаю, что скоро будет прокачиваться. Посмотреть на GitHub можно тут.
#AI_и_работа
Телеграм канал
Андрей Анисимов
@ideasforai
20 октября пройдет AI Native Conf 🔥
Конференция будет в Москве, в кластере "Ломоносов".
Программа собрана вокруг темы, которая сейчас уже важнее очередного сравнения моделей: что происходит с разработкой, продуктом и управлением, когда AI реально встраивается в работу компании, например:
🔵как Авито внедряет AI-first разработку;
🔵как считать экономику ИИ и не путать хороший пилот с хорошим бизнесом;
🔵как идти от чата с ИИ к автономным мультиагентным командам;
🔵почему сотрудники не используют AI, даже когда им уже всё купили и включили;
🔵как менеджеру освободить себе два дня в неделю с помощью ИИ;
🔵что происходит с продуктовой работой, когда delivery внезапно перестаёт быть главным тормозом.
Формат программы очень плотный: 4 параллельных потока, 19 докладов, воркшопы и C-Level клуб. Среди спикеров - Авито, Яндекс, представители банков и других сфер.
Можно прийти офлайн в "Ломоносов" или смотреть онлайн - трансляция будет со всех четырёх потоков. Ссылка ainativeconf.ru
Интересного много, я бы посмотрел на секции про агентную разработку и управление. По программе там как раз конкретные кейсы: где агенты реально ускоряют работу, где всё упирается в процессы и почему хороший пилот ещё ничего не говорит о том, получится ли масштабировать его на компанию.
Если работаете с AI не ради галочки, а пытаетесь встроить его в нормальный рабочий процесс - конференция будет очень полезной. До встречи на конфе!)
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai
Amazon внезапно показал людям, что он про них надумал. И местами это уже очень странно
В Amazon есть раздел About You - профиль, который система собирает из покупок, поисков, отзывов, списков и общения с Alexa for Shopping. Он нужен для персонализации рекомендаций.
Но пока эта штука не завирусилась, мало кто вообще представлял, насколько далеко заходят такие выводы.
🔝 Всё началось с пользовательницы, которая открыла свой профиль и увидела там характеристику «has flat buttocks» - буквально «плоские ягодицы”». Пост за сутки набрал больше миллиона просмотров, и дальше люди массово полезли смотреть, что Amazon решил про них.
У кого-то Amazon решил, что человек живет с мужем по имени P.P. McGuire. Пользователь вообще не понимал, кто это такой. У других всплывали предположения про увлечения, характер, бытовые привычки, тело и отношения.
🤦♂ Сам Amazon объясняет это довольно прозаично: модель смотрит на историю покупок и взаимодействий и пытается понять, какие товары и интересы вам могут быть релевантны. Компания отдельно утверждает, что для About You не использует сторонние данные - выводы строятся по активности внутри Amazon.
Гораздо интереснее увидеть в одном месте какую именно модель человека компания собирает из вполне обычных действий.
🔵Купили легинсы - система сделала вывод про фигуру.
🔵Искали товары для питомца - решила, кто у вас живёт дома.
🔵Смотрели определённые категории - получила ещё один кусок профиля.
Обычно всё это спрятано внутри рекомендательной системы.
Amazon позволяет редактировать или удалять отдельные предположения из профиля, но это не стирает саму историю активности, на которой они были построены.
Теперь бот ещё и делает выводы 😂
💬 Присоединиться к обсуждению в чате
Телеграм канал
Андрей Анисимов
@ideasforai


 +2