Управляю компанией (ТОП-15 по ИИ в России). Наблюдаю, как ИИ меняет бизнес, работу и жизнь. Разбираю идеи мировых AI-лидеров.
Для связи: @kegoshin
Subscribers19.5K tracking since 13 Nov
Reach per post (ERR)21.4%4.2K avg views
Posting0.9/weeklast 22 hours ago
Reactions per 1K views11.3❤ 👍 💯
Ушёл Хуанг, ушла эпоха
На мой взгляд, Хуанг был главным лицом ИИ в мире.
В далеком 2016 году именно Хуанг в своей кожаной куртке приехал в маленькую лабораторию OpenAI и подарил им первый суперкомпьютер NVIDIA, на котором написал:
Илону и команде OpenAI — за будущее вычислений и человечества. Представляю вам первый в мире DGX-1.
Именно на этом сервере Илья Суцкевер и команда OpenAI начали проводить первые эксперименты, из которых позже выросли GPT-1 и вся линейка GPT.
А в начале существования NVIDIA (30+ лет назад) над ним смеялись инвесторы, потому что они зависели от тех. директора - школьника, которого мама на работу на автомобиле возила))
Недавно мы переводили его выступление в Берлине (ютуб, VK видео) и там был такой момент, который меня прям впечатлил. Он показал процесс, который приближает мир роботов как никогда раньше (прикрепил вырезку). В чем суть:
Проблема с роботами: их можно запрограммировать, но когда они сталкиваются с реальностью, все ломается.
Очевидное решение: нейронки.
Проблема №2: сложность создания нейронок под роботов. Нужны дорогие и умные инженеры, спецы по машинному обучению.
Решение №2: радикально упростить процесс обучения за счет агентного ИИ, управляющего сложным инженерным ПО. На видео он показал как это работает:
1. Берем железяку (в данном примере робот - утка).
2. Берем агентную обвязку (тут Hermes) и подключаем LLM (тут Astra от OpenAI)
3. Подключаем к обвязке разные опенсорсы (один про машинное обучение, второй про проектирование 3Д моделей и т.д.)
4. Простым промптом просим агента "Вот железка, научи ее бегать и прыгать в реальности". Агент сам оркестрирует все хозяйство: вирутальные утки бегают по виртуальным мирам - так производит будущий мозг робота.
5. Потом тот же агент пакует результаты обучения в файлики, которые ставятся на роботов.
6. В итоге железяка оживает и получается робот-утка или что угодно другое.
Такой подход по сути своей позволяет любому человеку роботов создавать.
Кажется будущее примерно таким будет)
Так выглядит фундамент информационной безопасности 20% мирового интернета)
Почему ИТшники - единственная профессия без своего профсоюза? У всех есть, у нас нет.
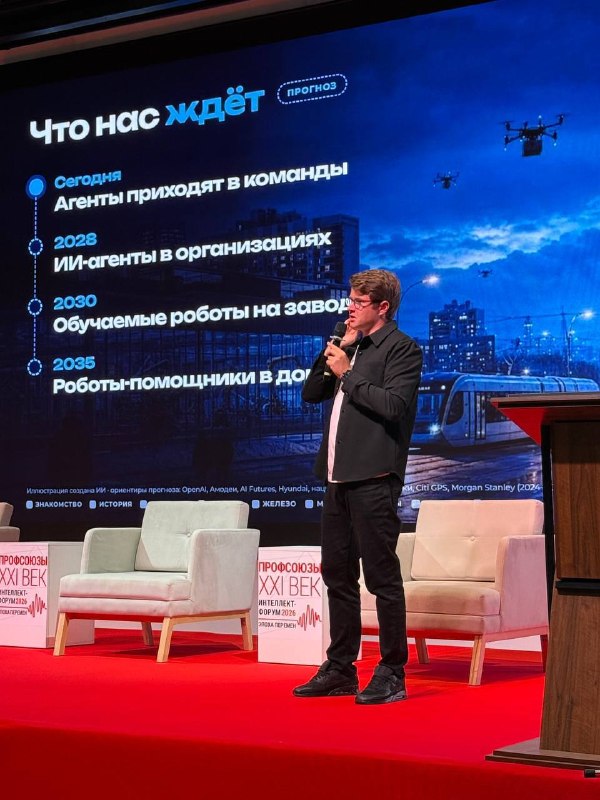
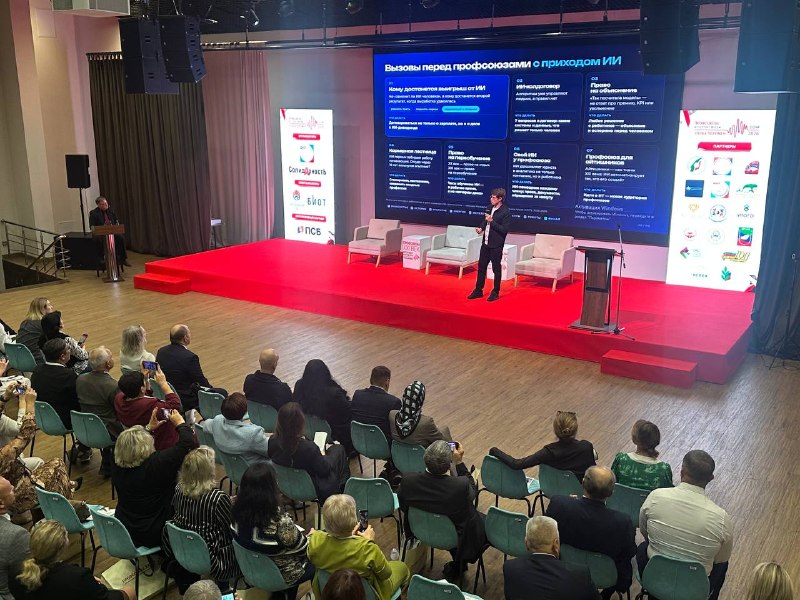
На прошлой неделе в Сочи выступал на всероссийском съезде Профсоюзов. И в процессе подготовки к выступлению я задался вопросом:
А почему у ИТшников нет своего Профсоюза? У всех профессий есть, а у нас нет.
Размышление над этим вопрос вылилось в интересную логическую цепочку:
- в 20 веке, когда началась промышленная революция первыми пострадали ткачи. Это был уважаемый и почитаемый в обществе труд. А вдруг появился ткацкий станок и их труд резко обесценился. Это была большая трагедией целой профессии.
- дальше революция распространялась, урбанизация наращивалась, объем рабочего класса увеличивался. И это привело к созданию профсоюзов как способу рабочих объединиться и отстаивать свои права, которые активно ужимались. Так у нас появилась 8 часовая рабочая неделя, выходные и т. д.
- 30 лет назад в России появились ИТ специалисты (началось все с парней, которых мы звали домой для переустановки виндоус). И почти сразу это была какая-то привилегированная профессия. Спрос на нас всегда был сильно выше предложения. Вы только задумайтесь в какой еще профессии долгое время существовала такая комбинация факторов: зарплата выше рынка, возможность удаленной работы, ИТ-ипотека, бронь от армии, ДМС, бесплатная еда и фитнес-клубы в офисах бигтехов. Задумайтесь, нет ни одной профессии, где столько плюшек и все разом. Нам никогда и в голову не приходило, что такой пакет не является нормой, что это исключение для профессии и это исключение может быть временным.
- и вот за последние годы что случилось: openAI сделали chatGPT -> мир начал играться, но не понял чего с ним делать (ну умные текста создает, а дальше что?) -> Антропик дали фокус на программирование -> вдруг оказалось, что вокруг нас все программирование (пишем сообщение в мессенджере = создаем код) -> «вдруг» номер 2 оказалось, что мы ИТшники за эти 30 лет на гитхабе собрали идеальные датасеты для обучения ИИ (много логических взаимосвязанных символов текста = по сути естественная разметка для обучения модели) -> и вот мы имеем клод код, который уже сейчас идеально выполняет любую работу, что программиста, что аналитика, что тестировщика. И каждые полгода делает это кратно лучше и лучше.
- параллельно с этим начинают сыпаться новости типа таких:
Спрос на айтишников в России сократился почти вдвое — количество вакансий для программистов упало на 47%, а для тестировщиков — на 55%, сообщает «Коммерсантъ».
Теперь на одну IT-вакансию претендуют более шести человек вместо прежних трёх. Одной из причин называют развитие нейросетей, которые всё чаще берут на себя рутинные задачи.
Как следствие, прогнозирую, что многим представителям ИТ придется отложить смузи и искать профсоюз меняться, профессия в массе своей перестанет быть столь привилегированной.
Мораль: ИТшники - ткачи нашего времени
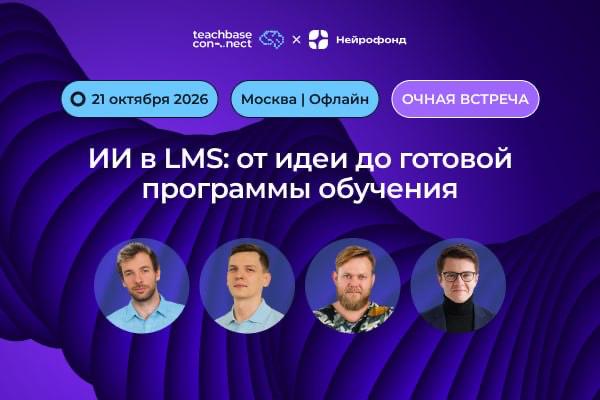
Как ИИ меняет корпоративное обучение в корпорациях: наша закрытая встреча в Москве
21 октября в Москве проводим закрытую очную встречу вместе с моими друзьями из Teachbase - лидерами российского рынка LMS, на чьей платформе учатся сотрудники «Магнита», «МегаФона», «Почты России», Альфа-Банка и «Ростелекома».
Соберём камерную встречу тех, кто отвечает за HR, корпоративные университеты и внедрение ИИ. Моим подписчикам из госсектора и вузов будет особенно полезно посмотреть, куда сейчас идут лидеры корпоративного обучения.
Что покажет Teachbase:
Ребта полностью пересмотрели то, какой должна быть LMS в эпоху агентного ИИ. Они покажут не просто «чат-бота в углу экрана», а полноценных агентов внутри LMS-системы: ИИ-методиста (теперь любой может сам собрать профессиональный курс за пару минут без HR), ИИ-аналитика и ИИ-куратора для проверки заданий.
О чём расскажу я:
Покажу, как построить надёжный фундамент под эту магию и выжать из ИИ максимум:
• Откуда берутся токены и как строить контур: локальные ЦОДы, российские LLM и безопасная работа с мощными внешними и рассуждающими моделями под прикрытием СЗИ и фильтров ПДн.
• Тренажёры нового поколения: приоткроем завесу над нашими прорывными наработками для проверки реальных знаний людей черехз ИИ-симуляции (надеюсь, тесты как класс отомрут в ближайшие годы везде 😎). Покажем крутые ролевые симуляции и обсудим, куда вообще движется этот рынок.
• ИИ для бэк-офиса: как использовать ту же инфраструктуру для сложных внутренних задач - от автоматического ИИ-скоринга документов до умных внутренних агентов-консультантов для сервисных и корпоративных центров.
Плюс будут наливать шампанское 🥂 - отличная возможность развиртуализироваться, познакомиться очно и пообщаться в неформальной обстановке.
Мест немного, регистрируйтесь и приходите!
👉 Зарегистрироваться на встречу (21 октября, 17:45 Москва)
ИИ-разработки МИСИС представили Вице-премьеру России
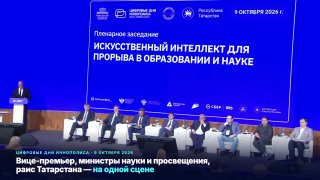
9 октября на «Цифровых днях Иннополиса» прошла пленарная сессия «Искусственный интеллект для прорыва в образовании и науке». На сцене были вице-премьер Дмитрий Чернышенко, министр науки и высшего образования Валерий Фальков, министр просвещения Сергей Кравцов и раис Татарстана Рустам Минниханов, а по видеосвязи из «Сириуса» подключилась Елена Шмелёва.
Среди спикеров пленарки выступил проректор по образованию НИТУ МИСИС Андрей Воронин. Перед началом сессии Андрей Игоревич представил Дмитрию Чернышенко пилотный проект университета - интеллектуальную систему поддержки студентов и наставников.
В чём суть:
• Адресная помощь студенту. ИИ анализирует динамику учебного процесса, помогает вовремя выявить риски академического отставания и подсказывает шаги для выравнивания трека.
• Фокус для наставников. Рутинные задачи и типовые напоминания система берет на себя, освобождая время кураторов для точечной работы с теми, кому действительно нужно личное участие.
• Безопасность. Все вычисления и данные остаются строго в защищенном контуре университета.
Спасибо Андрею Игоревичу и команде МИСИС за смелость запускать такие проекты первыми в стране.
В основе решения работает наша платформа Нейрофонд и нам очень приятно, что на ней вырост проект такого уровня.
Как великие физики костыль пофиксить не могли
Сегодня определили лауреата Нобелевской премии по физике - бельгиец Фрэнсис Хальцен, который развивал идею советского ученого Моисея Маркова про нейтрино. Погрузился в суть его изобретения и меня позабавили факты из жизни великих физиков:
01 Неидеальность бытия
В прошлом веке ученые проводили эксперименты и не могли объяснить, почему в некоторых процессах радиоактивного распада переставал работать закон сохранения энергии. То есть случается распад, энергии должно быть определенное количество, а фактически его чуть меньше. Объяснить никто не может. Вроде бы фундаментальный закон под угрозой. И ученые такие:
Ну ладно. Давайте зафиксируем так. Закон есть. Энергии должно было остаться столько-то. Фактически остается меньше. Что происходит - хз. Запишем, что есть еще что-то не понятное, что эту энергию забирает, а в будущем кто-то разберется в чем суть.
Так ученые спасли закон сохранения энергии. И в науке поселилась какая-то выдуманная частица, которая выступала просто костылем.
Советский ученый прикинул: ну раз эта гипотетическая частица такая неуловимая, такая маленькая, ее надо ловить где то очень глубоко - например, на дне Байкала или во льдах Антарктиды. Скорей всего она сквозняком летает через всю землю и если мы подставим под нее правильную другую частицу, они стукнуться и вода окрасится также как в ядерных реакторах - так и докажем ее существование.
Вот наш новый Нобелевский лауреат и притворил эту идею в жизни: во льдах Антарктиды поставил штуку, которая словила эту самую неуловимую частицу Нейтрино, которая из космоса через нас мимо пролетала.
02 Мы - пустота
Каждую секунду через 1 квадратный сантиметр нашего тела (как и любой материи вокруг) пролетают 65 млрд этих нейтрино, произведенных солнцем, и мы этого не замечаем, хотя если на пути хотя бы одного нейтрино, которое не от солнца, а от черной дыры (как Нобелевский лауреат поймал) случайно попадется правильный атом нашего тела - выделиться энергия равная удару теннисного мяча. Но вероятность этого ничтожно мала.
То есть с точки зрения этих частиц мы - пустота)
Как пишет промпты инженер Антропик, создавший Fable
Недавно мы перевели выступление инженера Anthropic - Тарика Шихипара. Оттуда мне запомнился довольно простой слайд «Матрица неизвестных».
Он показывает, что при работе над любой сложной задачей с ИИ-агентом есть четыре типа знания:
• Known knowns - что я знаю.
• Known unknowns - что я знаю, что не знаю.
• Unknown knowns - что я знаю, но даже не думаю об этом как о знании.
• Unknown unknowns - то, о существовании чего я вообще не подозреваю.
Тарик использует эту матрицу, когда работает с моделями: его задача - максимально сблизить «карту у себя в голове» с реальной территорией, по которой потом пойдёт агент. Мне кажется, это очень хорошая модель и я интуитивно применяю ее же.
Как это работает:
1. Что я точно знаю
Это самая очевидная часть промпта.
Например, мы делаем проект для университета.
Я могу написать модели:
Есть вуз на 40 000 студентов и 10 000 преподавателей.
Мы хотим развернуть внутри него ИИ-инфраструктуру.
Есть такой-то бюджет.
Есть такие-то серверы.
Вот наш продукт.
Вот какой результат должен получить заказчик.
Это факты.
Чем больше действительно важного контекста модель получает здесь, тем меньше ей приходится додумывать картину самостоятельно.
Но интересное начинается дальше.
2. Что я понимаю, что пока не знаю
Например:
• я ещё не понимаю, какая архитектура будет оптимальной;
• не знаю реальную пиковую одновременную нагрузку;
• не знаю, лучше купить больше GPU сейчас или оставить возможность масштабирования;
• не знаю, что окажется важнее для заказчика: стоимость, безопасность или скорость запуска.
Это тоже очень полезно прямо писать в промпте.
Не обязательно сначала самому принимать решение.
Я вполне могу сказать:
Здесь я пока не понимаю, какой вариант правильный. Рассмотри несколько архитектур и покажи, от каких предположений зависит выбор.
То есть хороший промпт - это не обязательно демонстрация абсолютной уверенности. Иногда фраза «вот здесь я не знаю» даёт модели больше, чем пять абзацев плохо обоснованных предположений.
3. То, что я знаю, но могу забыть объяснить модели
Вот эта категория мне особенно нравится. Потому что в реальных бизнес-задачах большая часть контекста именно такая. Например, мы готовим техническое задание. Формально задача может выглядеть совершенно нормально. Но я знаю, что у функционального заказчика есть конфликт с IT-подразделением. Для меня это часть картины мира. Я несколько месяцев общаюсь с этими людьми и автоматически это учитываю. А для модели этого знания не существует, пока я его не написал. А ведь оно может полностью изменить результат.
Я могу сказать:
Учти, что функциональный заказчик заинтересован в проекте, но IT-подразделение относится к нему настороженно. Поэтому архитектура и ТЗ не должны выглядеть как попытка обойти IT. Наоборот, нужно заложить им понятную роль, контроль и ответственность.
Технически это вообще не характеристика системы.
Но практически это может оказаться одной из самых важных частей ТЗ.
Это и есть unknown knowns: знания, которые настолько находятся у тебя в голове, что ты даже не замечаешь, что модель их не знает.
4. То, о чём я вообще не подумал
А вот здесь начинается, пожалуй, самое ценное. Допустим, я считаю экономику строительства AI-кластера.
Я могу очень хорошо посчитать:
GPU → токены → количество агентов → экономика.
Но я могу вообще не подумать, например:
— о резервировании энергоснабжения;
— о сроках поставки оборудования;
— о таможенных рисках;
— о сетевой инфраструктуре;
И проблема в том, что я не могу спросить о том, о существовании чего не знаю. Поэтому здесь мне очень нравится приём Тарика - blind spot pass, проход по слепым зонам.
Он прямо просит модель:
Изучи задачу и найди те важные обстоятельства, которые я, скорее всего, вообще не учёл.
——
Думаю, что в описанном подходе кроется одна из главных причин, почему два человека могут использовать одну и ту же модель и получать совершенно разный результат.
Каким будет мир, в котором избыток интеллекта
Перевел интереснейшее эссе от ведущего мирового инвест. фонда Sequoia. Они попытались осознать ближашие изменения в обществе через глубокую аналогию с промышленной революцией. Тогда мы научились аутсорсить физическую работу, сейчас учимся аутсорсить когнитивную.
Революция физического труда
Любую работу можно разделить на физическую и когнитивную. Большинство полезных задач требует и той и другой. Например, земледелие. Физический труд, очевидно, + когнитивный (умение ориентироваться в погоде, подбирать семена и т. п.).
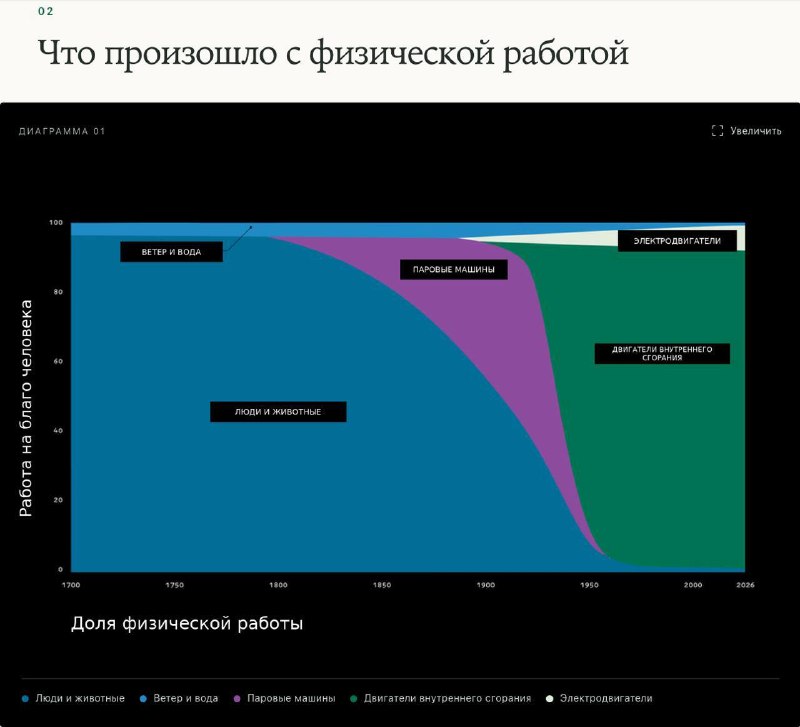
Мне очень понравились графики. Например, первый. Он круто передает мысль:
вообще-то последние 300 лет люди полагались только на свои мышцы при физической работе. тот факт, что нам для путешествия из одного города в другой надо просто на самолет сесть, а не 2 недели изматывающего похода – это относительно недавнее благо.
Людям потребовалось 200 лет, чтобы полностью заместить физический труд устройствами, которые преобразуют энергию с помощью двигателей. И этот период монументально изменил нашу жизнь. Задумывались ли вы о таких вопросах?
- Почему мы встаем по будильнику, ведь наши предки нормально просыпались по солнцу и высыпались? – чтобы вовремя быть на фабрике;
- Как появилась транспортная городская система? – двигатель и станки никуда не перенесешь, а люди живут кто-где, а ровно в 09.00 все должны быть на месте, чтобы процесс пошел.
- Почему школа так сильно похожа на завод (расписание, звонки, единая программа и регламент для всех)? Ну… ответ понятен.
Авторы сводят это к мысли, что наше текущее устройство жизни = производная от того, что двигатель заменил мышечную работу.
Революция когнтитивного труда
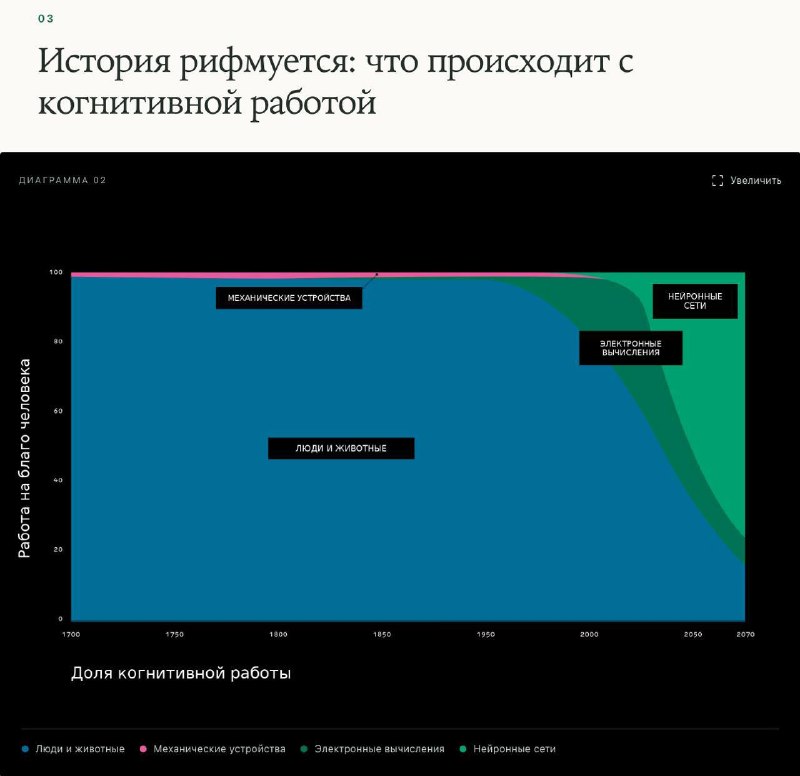
И раз уж мы уже проходили этот путь с физической работой, почему бы не взглянуть через эту призму на когнитивный труд. См. график №2. Столетиями мы полагались только на свой ум и его ограничения. Последние 30 лет появились электронные вычисления (калькуляторы, компьютеры, ПО). Это сильно нас изменило. И нейронные сети – это следующий шаг. Они резко расширяют круг видов когнитивной работы, доступных машинам.
Сто лет назад 99% когнитивной работы выполняли люди. В ближайшем будущем 99,9% будут выполнять машины. Не потому, что люди станут меньше думать, а потому, что машины будут вычислять гораздо, гораздо больше.
Далее, пробуем провести мыслительный эксперимент и через аналогии сопоставить 2 промышленные революции по разным кейсам:
Тогда: мощь государства измеряется объемами производства
Завтра: мощь государства измеряется мощностями электросетей и объемом производимого интеллекта (токены).
Тогда: самые крутые компании – это поставщики промышленного перехода: нефтяники, производственники, железнодорожники.
Завтра: поставщики энергии, производители железа для ЦОДов, сами ЦОДы, создатели ИИ-моделей.
Тогда: первой областью, которую накрыла пром. революция, стало ткацкое ремесло. Стоимость текстильного дела и важность текстильных мастеров резко обесценилась.
Завтра: первой областью, которую накрывает когнитивная революция – программирование :) только все заходили в ИТ, а теперь пора выходить)
Венцом предыдущей эпохи стал автомобиль, вокруг которого мы выстроили целую цивилизацию (дороги, цепочки поставок, пригороды). Скорей всего венцом текущей революции будет не программирование, а что-то другое, более масштабное. Мне кажется занимательным провести свой мыслительный эксперимент и подумать над ответом на такой вопрос:
Что есть такого, что нужно всем, но это невозможно в мире, где мышление дефицитно?
Интересного вам размышления на выходных)
Услуги - это новое программное обеспечение
Очень интересную статью выпустил один из главных мировых венчурных фондов мира - sequoia.
Ключевая мысль
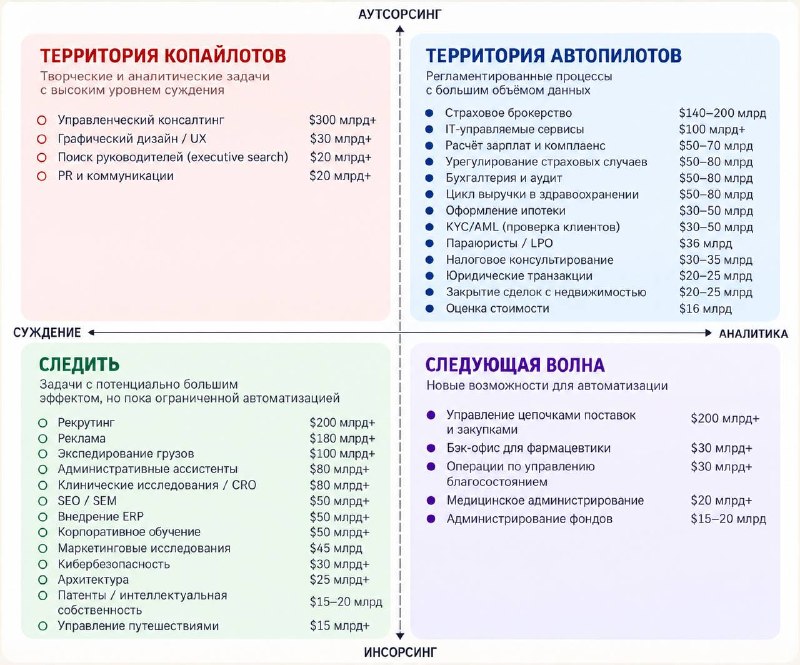
Следующей компанией стоимостью 1 триллиона долларов будет компания-разработчик программного обеспечения, маскирующаяся под сервисную фирму.
Каждый основатель, создающий инструмент искусственного интеллекта, задает один и тот же вопрос: что произойдет, когда следующая версия Claude сделает мой продукт функцией? Они правы, что беспокоятся. Если вы продаете инструмент, вы находитесь в гонке против модели. Но если вы продаете работу, каждое улучшение модели делает ваш сервис быстрее, дешевле и сложнее конкурировать.
Логика у них очень простая и гениальная:
- если вы платите не за софт, а за выполненную работу, то ваш объем рынка мгновенно раздувается в 5–10 раз, потому что вы претендуете не на IT-бюджет компании, а на ее зарплатный фонд и операционные расходы на подрядчиков.
- этот рынок можно разглядеть, посмотрев на то, что аутсорсят и инсорсят компании (см. График). То есть идти туда, где уже есть привычка поручать работу внешней команде.
- профессионал вместе с мощным ИИ-агентом, настроенным под себя, может закрывать значительно большее количество задач, при этом нести за них ответственность перед заказчиком.
———
Я лично на днях на себе ощутил дефляционный эффект в услугах. У меня есть коллега, у которой я приобретаю услуги по производству рилсов. И вдруг от нее поступает предложение
Я научилась делать рилсы с помощью клод кода. Качество не отличимо. Давайте вы будете мне платить в 1,5 раза меньше за тот же объем работы?
То есть она смогла за счет технологии сократить свой кост. Осознает, что она такая не одна на рынке. И чтобы сохранять текущих клиентов совершает проактивный шаг, направленный на снижение стоимости. Кажется, что в ближайшее время в услугах, построенных на каком-то SaaS, будет происходить большой шок, связанный с падением стоимости и ростом количества и, как следствие, случится перераспределение рынка внутри.
Как пример,
- очевидно что сайтов станет многократно больше (раз создать сайт теперь можно одним промптом -> сильно больше людей будут это делать) -> упадет спрос на услуги простых агентств и фрилансеров.
- при этом каждый сайт надо где-то хостить -> рост на рынке дата-центров.
- каждый сайт надо обслуживать и сопровождать-> Теперь справится вчерашний школьник с клод кодом -> цены услуг аутсорсинга сопровождения упадет.
То есть случится тот самый парадокс Джевонсона: цены на услуги падают -> на рынок приходит новый спрос, который не мог себе старую цену позволить -> общий объем рынка кратно вырастает.
edited
Подкаст с AI-лидом в Битрикс24: как делать продукты на ИИ-агентах и не сломаться в проде
У меня в гостях Сергей Нотевский - руководитель AI-платформы в Битрикс24. Команда Сергея отвечает за ИИ-инфраструктуру из 100+ GPU, на которой работают он-прем модели и автономные агенты крупнейшего бизнес-сервиса страны.
А еще я называю Сергея "отцом кэширования контекста в России") Так как он разработал опенсорс скилл по этой теме, за который Anthropic подарили ему официально подписку MAX на 6 мес.
О чем выпуск:
• Как создавать ИТ-продукты, используя агентов, так, чтобы они были устойчивыми при эксплуатации;
• Как экономить на токенах за счет кэширования;
• Почему RAG остался в 2025 году и что пришло ему на смену сейчас;
• ИИ-внутрянка Битрикс24. Как и зачем оркестрировать собственный кластер на 100+ GPU.
🎧 Подкаст уже доступен на двух площадках:
📱 YouTube / 📱 VK видео
Главная презентация года от NVIDIA: что я понял, когда перевёл новый доклад Дженсена Хуанга
Если бы меня спросили, на кого смотреть, чтобы понять, куда на самом деле движется ИИ, я бы ответил - на тех, кто несет самый большой финансовый риск. Софтверный стартап может перевайбкодить переписать код за пару недель, а вот «железячники» вливают десятки миллиардов долларов в заводы, кремний и энергетику, которые строятся годами. Если они ошибутся с прогнозом - им будет больно.
Главный Стив Джобс железячник планеты сейчас - это Дженсен Хуанг. На недавней GTC 2026 в Тайбэе он собрался с мыслями и за 2 часа раскидал как его NVIDIA + целая страна Тайвань будут перестривать мировую инфраструктуру под эпоху агентного ИИ. В Тайвани все так прет на этом фоне, что Правительство думает о том, чтобы гражданам по 10 к местных долларов выплатить)
Мы сделали студийный перевод этого доклада: ютуб, вк видео.
Вот ключевые мысли и ощущения, которые у меня остались после просмотра:
01 ИИ стал полезным
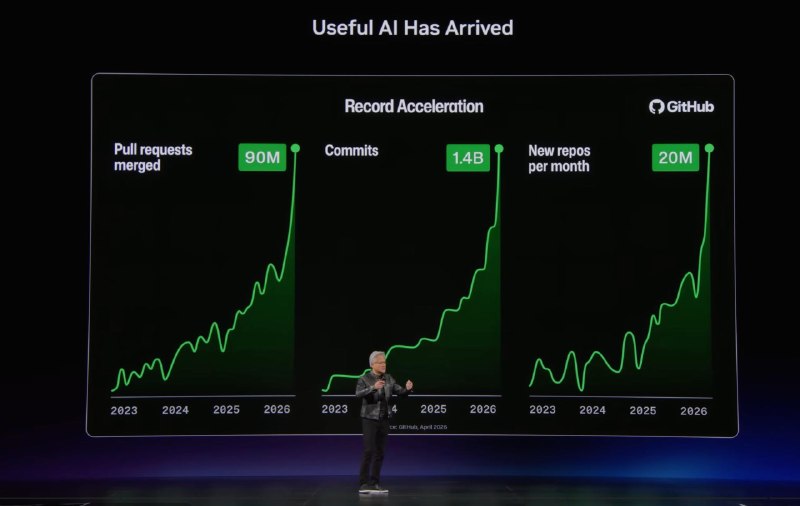
Дженсен показал интересный график активности программистов на GitHub (скрин 1). Обратите внимание на динамику: 2023, 2024 и 2025 годы график рос плавно и предсказуемо. Но за первые несколько месяцев 2026 года количество отправленных изменений в коде (коммитов) буквально выстрелило в космос - рост почти в 3 раза!
При этом мировые затраты на зарплаты разработчиков остались теми же (~$3 трлн в год), а объём генерируемого ими результата Хуанг оценил уже в $9 трлн. Произошёл тот самый сдвиг: ИИ перестал быть просто чатиком, куда мы пишем промпты, и превратился в инструмент, который сам выдаёт готовую работу.
02 Агенты, агенты, агенты
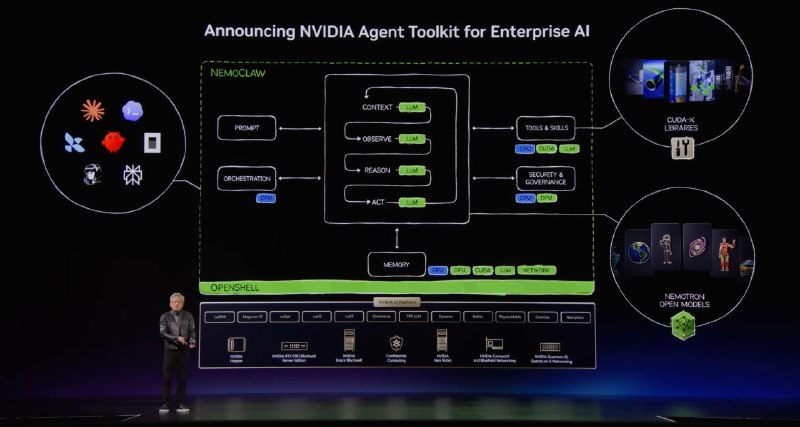
Полезным ИИ стал именно благодаря появлению Агентов (Codex, Claude Code - самые известные). Агент - это оболочка вокруг LLM-мозга (скрин 2). Мозг думает, а оболочка управляет памятью, дергает базы данных, браузер и API. Например, в самой NVIDIA такие агенты уже проектируют и тестируют микрочипы, сократив время проверки схем с недель до нескольких часов. Они показали как это работает на конфе - круто)
03 Железо заново переизобретают под нетерпеливых агентов
Человек за компьютером работает медленно: мы водим мышкой курсор, кликаем, ждём пару секунд, пока откроется файл или отработает скрипт, и нам ОК.
Агент же работает со скоростью компьютера. Он совершает тысячи вызовов в минуту, не умеет ждaть и задействует железо совершенно по-другому. Когда задержка в пару миллисекунд тормозит цепочку из сотен агентских мыслей, старые процессоры (x86 от Intel/AMD) становятся главным узким горлышком. Из-за этого NVIDIA представила Vera CPU - центральный процессор, спроектированный с нуля не под человека, а под гиперактивного агента. А также новые GPU, сетевые штуки и шкафы, которые все это хозяйство соединяют.
04 Монструозное железо Vera Rubin и «чистый рынок продавца»
На сцене перед Хуангом стояла стойка нового поколения - Vera Rubin NVL72(скрин 3). Чтобы понимать масштаб: один такой шкаф с жидкостным охлаждением стоит порядка 1,5 млрд руб. Это колоссальная вычислительная плотность - на одной такой стойке можно развернуть 13 экземпляров самой большой LLM опенсорса Kimi K3.
И здесь у меня очень вовремя совпали впечатления от презентации с личным практическим опытом. Недавно ко мне обратилась одна организация с задачей помочь раздобыть и привезти в Россию топовые серверы NVIDIA. Мы искали два типа железных монстров: 8-чиповый сервер NVIDIA B300 (в Москве это сейчас порядка $1,4 млн) и ту самую стойку NVIDIA GB300 NVL72 (стоимостью около $15 млн).
Прорабатывая поставку, я на практике прочувствовал то, что в школе на уроках экономики называли «чистым рынком продавца». Это ситуация абсолютного дефицита, когда у продавца с железным ресурсом на руках нет задачи «продать» - у него под дверью стоит очередь из покупателей с сумками наличных, и уже сам продавец выбирает, кому из них он соизволит этот сервер отгрузить. Интересные времена)
Наш полный проф. перевод презентации можно глянуть по ссылкам:
ютуб, вк видео.
Почему сотрудники OpenAI перестали использовать chatGPT
Изучил свежие исследования от OpenAI о том, как их собственная команда и корпоративные клиенты используют ИИ в ежедневной работе. Картина получается крайне интересная. Разработчики и менеджеры OpenAI массово отказываются от привычного режима диалога (чата).
Что происходит:
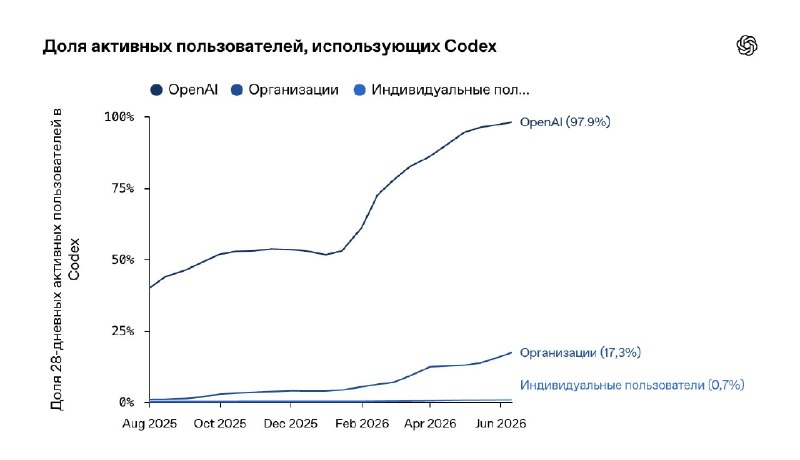
1. Массовый переход на агентов. 97,9% сотрудников OpenAI сейчас работают через агентскую среду Codex. Для сравнения: ещё в августе 2025 года им пользовались всего 10% команды.
2. Делегирование долгих задач. Чат-бот хорош для быстрых вопросов, а агент берет на себя автономную работу. 80% пользователей поручают агенту задачи, на которые у человека уходит от 30 минут, а 20% научились делегировать автономные таски длительностью 8+ часов.
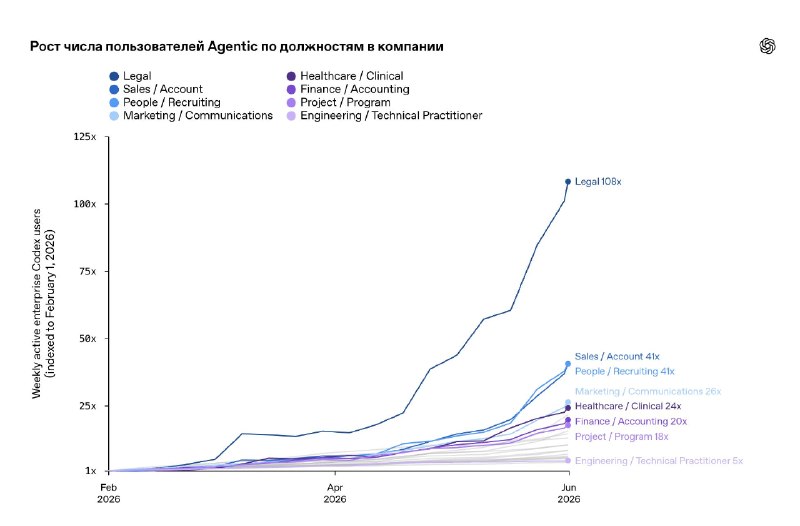
3. Агенты уходят к «не-технарям». Неразработчики стали самой быстрорастущей категорией пользователей. Среди корпоративных клиентов OpenAI зафиксирован взрывной рост применения агентов:
• Юристы - рост использования в 108 раз;
• Продажи и HR - в 41 раз;
• Маркетинг и финансы - в 24 раза.
Отдельно мне понравилось, что ОпенИИ выделили паттерны поведения людей, которые выжимают из текущих агентов максимум эффективности. Нам надо стремиться быть такими)
Итак, что мы должны уметь, чтобы считать себя Агент-нейтив человеком:
1. Обеспечить своего Агента максимумом контекста
• Подключать плагины: корпоративный Битрикс или яндекс.вордстат и т.п.
• Делать Appshot - по сути скриншот, который сразу видит агент.
• Управлять памятью: вести контекст о себе, команде и текущих проектах.
• Переходить на голосовой ввод: надиктовывать задачи вместо печати - это в разы быстрее без потери качества.
2. Предоставить Агентам инструменты для принятия мер
• Создавать кастомные навыки (skills), применимые для своей работы. Чтобы агент лучше решал типовые для вашей работы задачи.
• Генерить артефакты «под ключ»: получать готовые Word-документы, Excel-таблицы, презентации и сайты от Агента.
• Давать доступ к ПК и браузеру: разрешать агенту выполнять действия прямо в вашей системе.
3. Заставить агентов работать до конечного результата
• Использовать цель (функция /goal) и циклы доработки. Агентам (кодекс / клод код) через фукнцию goal можно задать цель и он будет долго и циклично использовать весь свой арсенал, пока не достигнет сформулированной цели.
• Запланированные задачи. Можно планировать регулярные агентские действия и наблюдать за результатом. Например, пусть агент каждый день в 8 утра исследует ваш сайт и подтверждает, что все работает.
• Запускать параллельные потоки: оркестрировать работу нескольких агентов одновременно.
• Работа в нерабочее время. Понимать когда как и почему имеет смысл запускать агентов на работу на всю ночь. А утром наслаждаться результатом.
Источники: тут и тут.
Как внедрить Claude Code в команду так, чтобы им реально начали пользоваться?
Если вы задумываетесь о том, чтобы прокачать команду и научить людей работать с Claude Code, рекомендую обратиться к моему знакомому - Игорю Михееву. Он специализируется на обучении команд (не разработчиков) использованию Claude Code в работе.
Мы сами проходили у него обучение всей командой, и понравился практикоориентированный подход. Каждую неделю каждый сотрудник создавал какой-то ценный продукт для нашей компании и рассказывал об этом опыте. Так шло взаимное опыление и совместный прогресс.
Как следствие, даже ребята, которые были максимально далеки от разработки и кода, научились закрывать задачи, к которым раньше банально не знали, как подступиться:
Аналитика: вытаскивают и структурируют аналитику прямо из сырых данных в БД;
Документация: быстро и качественно готовят сложные технические документы;
Собственные утилиты: собирают кастомные сервисы под свои рутинные задачи (например, сделали удобный внутренний транскрибатор).
Если актуально повысить продуктивность команды - почитайте пост Игоря ниже:
https://t.me/i_mikheev/305
Изнанка ИИ-бизнеса: зарплаты, кейсы и экономика агентств
Мы продолжаем серию подкастов про людей, которые своими руками строят искусственный интеллект в России прямо сейчас 🤓
У меня в гостях Ярослав Шмулев - сооснователь и CTO R77.AI, одного из топ-3 ИИ-интеграторов России. Его команда реализовала более 150 проектов для Сбера, Альфа-Банка, Яндекса и других крупных компаний.
О чём поговорили:
• Как становиться подрядчиком по ИИ для Бигтехов.
• Какие сейчас зарплаты в ИИ: у разработчиков, продактов, AI-директоров.
• Как устроена овуляция у свиноматок 😂
🎧 Подкаст уже доступен на двух площадках:
📱 YouTube / 📱 VK видео
edited
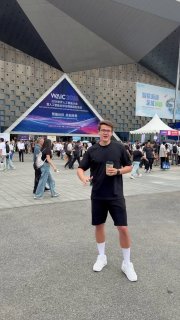
Эпицентр мировой ИИ-гонки: что я понял на главной выставке Азии WAIC 2026 в Шанхае
Скатался я в Шанхай на главную ИИ-конференцию Азии - WAIC 2026, открывал ее сам товарищ Си. Посмотрел чем рынок живет, себя показал, записал для вас небольшой лайв-влог с обзором на самые интересные стенды (посмотреть можно на ютубе и на вк-видео). Вот ТОП-5 ключевых мыслей, которые я привёз оттуда об устройстве ИИ-рынка:
01 Железо в фокусе
Чувствуется, что главная боль индустрии сейчас - это решить вопрос с дефицитом железа, позволяющего за недорого получать ИИ-вычисления. Главный монстр выставки от Китая - суперкомпьютер Huawei Atlas 950 SuperPod с 1024 ИИ-ускорителями, объединенными единой оптикой. Махина стоит $50 млн, а 8 таких шкафов способны обучить модель уровня ChatGPT всего за месяц. В остальном - сотни серверов, микрочипов и попыток сделать полноценную замену NVIDIA.
02 LLM и токены дешевле оригинальных API
На стенде Moonshot AI анонсировали Kimi 3 (2.5 трлн параметров), которая обходит Claude Opus и доступна за копейки или вовсе бесплатно (весы открыты). Но еще интереснее инфраструктурный слой рядом: китайцы массово научились распаршивать подписки и продавать токены топовых LLM (включая Claude и ChatGPT) через сторонние API заметно дешевле провайдеров (сразу несколько таких стендов видел).
03 Агентский софт и вайб-кодинг
Около трети всех стендов - агентский софт. Базовый стек везде как на подбор одинаковый:
• какая-то десктопная оболочка;
• чат-интерфейс;
• интеграция с локальной файловой системой;
• интеграция с внешним ИС по API;
• мозги, определяющие агентские действия, от внешней LLM в облаке.
Даешь задачу - агент сам под капотом пишет код и решает её. Причем открыто показывают, что все собрано из опенсорс-компонент (Hermes, OpenClaw).
04 Agentic Box
Чувствуется, что появляется новый класс устройств. Это по сути агентский софт (03), но только на собственном ПК (01) и с локальной ЛЛМ, которую тянет этот ПК. Грубо говоря такой МакМини с своеобразным рабочим сталом, ориентированным на команды голосом и агентскую работу. Как по мне, пока игрушки, продукт маркет фит там еще не найден.
05 Роботы
Целый этаж отдано под роботов - бегают, прыгают, дерутся и варят кофе. Но они всё ещё коммерчески неэффективны и покупаются скорее ради хайпа (на рекламные бюджеты).
Интереснее другое - откуда их столько? Местный представитель объяснил логику КНР: государство заливает деньги в технопарки, а те финансируют сотни стартапов «вдолгую». Задача этих команд - не сиюминутная прибыль, а готовность. Как только в мире произойдет технологический прорыв (например, появится полноценный адаптивный ИИ-мозг для роботов), у Китая уже будут сотни готовых команд, способных мгновенно скопировать его и масштабировать в дешёвое производство. Ровно так они сделали с LLM после выхода ChatGPT.
Посмотреть мой репортаж с WAIC 2026 можно здесь:
📱 YouTube / 📱 VK видео
edited
Манифестация воли от Андрея Карпатого
Перевели великолепнейший подкаст с Андреем Карпатым (чел, который придумал «вайбкоддинг», автопилот в Тесла, один из первых сотрудников OpenAI, сейчас исследователь в Антропик). Не понимаю почему у него так мало просмотров в англоязычном ютубе. Как по мне, это главный подкаст по ИИ за последние 3 месяца, который надо посмотреть.
Какие мысли показались мне интересными:
01 Шептальный зал ИТшников.
Передовые ИИ-лаборатории сейчас выглядят так: большой опенспейс, сидят люди в очках и что-то шепчут в компьютер. Они больше не пишут код вообще, они «выражают свою волю и манифестируют задачи роям агентов». Главный навык новых ИТшников это способность к декомпозиции и правильно давать инструкции. А если что-то не работает - это не предел технологии, а «нехватка навыка» у разработчика.
02 Парадокс Джевонса в ИТ.
Это экономический феномен, при котором технологический прогресс, повышающий эффективность использования какого-либо ресурса, не сокращает его потребление, а, напротив, увеличивает его. Впервые эффект описал британский экономист Уильям Стэнли Джевонс в 1865 году в работе «Угольный вопрос», обратив внимание на то, что усовершенствования паровых машин, повышающие эффективность использования угля, привели к росту, а не снижению его общего потребления.
Карпатый прогнозирует такой же эффект в ИТ-разработке. Ее стоимость кардинально уменьшится за счет агентов -> это породит огромный спрос, который сейчас скрыт -> это увеличит потребность в ИТшниках. Скорей всего ПО трансформируется от статичных приложений к динамичному софту. Примерно так: мне пришла идея сервиса -> я сказал ИИ-агенту -> он за 5 сек собрал приложение, интегрировался по Апи с сервисами и навайбкодил оболочку -> я пользуюсь.
Как пример, он рассказал про свой проект «Эльф Добби»: Карпатый попросил агента найти умные устройства в своем доме. Агент сам просканировал локальную сеть, разобрался с API Sonos, систем освещения, штор и бассейна, сделал дашборд и вывел всё управление в единый чат WhatsApp.
03 Кризис когнитивного избытка
Мысль такая:
- человечество незаметно для себя произвело огромный массив цифровой информации;
- циклов мышлений наших мозгов не хватает, чтобы все осмыслить. Отсюда появилась такая работа как наша - операторы ЭВМ, которые сидят в офисах;
- это временное состояние. ИИ быстро «прочитает» и осмыслит абсолютно все научные статьи, репозитории и базы данных.
- таким образом нас операторов ЭВМ заменит md файл с должностной инструкцией агента.
- дальше ИИ пойдет работать с атомами = физический мир через сенсоры (камеры, лабораторные датчики, закупку данных у людей) и актуаторы (робототехнику). Тут все развиваться будет дольше, но изменения будут еще более глобальными.
04 Как меняется обучение
Короткая, но интересная мысль. Он заметил по себе, что раньше он записывал свои знаменитые длинные видео лекции, которые объясняют что-то сложное, например, «Как устроена LLM». А сейчас он не видит в этом смысла. Теперь путь такой: сделал что-то сложное -> сгенерил поясняющий md файл для агента -> любой ИИ «с бесконечным терпением объяснит материал человеку на любом языке и под любой уровень знаний».
Смотреть подкаст на русском языке можно здесь: https://youtu.be/26TuOJZm14w
Готовим очень интересный видеообзор для вас) скоро выпустим
OpenAI возвращается
Давно не было хороших новостей от ОпенИИ. Казалось, что Anthropic с их Клодом уже окончательно перехватили лидерство. Но кажется, что ОпенИИ возвращается. Мы сделали профессиональный перевод их новой презентации на русский язык:
https://youtu.be/ofAwkyf8HMg
Что там интересного:
- ChatGPT Work: полноценный приход ОпенИИ в агентский ИИ для не разработчиков. Позволяет делать эксели, презентации, сайты, в общем выполнять работу человека за компьютером. Такой ответ перплексити компьютер и клод коворку;
- новая линейка моделей GPT 5.6. Sol, Terra, Luna. Интересно, что самая мощная модель (Sol) настолько поумнела, что исследователи OpenAI доверили ей самостоятельно обучить младшую модель Luna.
- цены и эффективность. Стоимость токенов модели в 2 раза ниже чем у флагмана Антропика (fable) и вроде как для решения задач модель требует меньше токенов, что важно для больших агентских сценариев. При этом качество такое же или лучше судя по бенчмаркам.
Глобально, кажется, что в этом году на наших глазах случается переход восприятия ИИ у человечества от «Чат для ответа на вопрос» к «Приложение, которое способно решать задачу под ключ».
Интересно)
Новый подкаст с директором по стратегии AI в Cloud.ru (ex-SberCloud)
Мы продолжаем серию подкастов про людей, которые строят искусственный интеллект в России прямо сейчас 🤓
У меня в гостях Дмитрий Юдин - директором по стратегии AI в Cloud.ru (ex-SberCloud). Их ЦОД является крупнейшим поставщиком ИИ-токенов в России. Именно на их мощностях обучается GigaChat и стоят суперкомпьютеры Christofari.
О чём поговорили:
- На какую задачу уходить 70% всех токенов в России?
- Ждать ли нам российского GPU?
- Сколько зарабатывают топовые ML-специалисты и AI-управленцы.
🎧 Подкаст уже доступен на двух площадках:
📱 YouTube / 📱 VK видео
edited
Главное, что надо знать о предстоящей революции роботов
Сейчас все чаще на конференциях начинают обсуждать физический ИИ и новое поколение роботов. Я долгое время не понимал, почему это важно и, скорей всего, будет иметь еще более значимые последствия для общества, чем LLM. И вот мы перевели важнейшее выступление главы подразделения роботов Nvidia, там всего 20 минут. Но он объяснил суть и назвал это «Великая параллель» (скромняга парень). Коротко, о чем речь:
- революция ЛЛМ случилась, потому что человечество научилось механизму: взять кучу неструктурированного текста -> скормить все технологии -> она с шокирующей точностью нашла взаимосвязи и научилась предсказывать следующий символ текста.
- революция моделей для генерации видео: все то же самое, только модель предсказывает следующий пиксель, а не символ. И с той же шокирующей точностью понимает физические законы.
- и вот спикер строит параллель: то, что мы видим глазами и осознаем мозгом это очень похоже на пиксели. Наш мозг их также предсказывает. Мы как человечество накопили огромные датасеты пикселей физического мира (видео с камер). Так давайте применим все те же самые механизмы и получим мозг робота, который предсказывает следующие пиксели только в физическом мире.
Пример на видео. Робот, который складывает рубашку. Его не учили это делать. Ему просто показали несколько видео как это делают люди без какой либо специальной обработки. И он математически вычисляет вероятность происходящего в следующую секунду. Грубо говоря, когда он видит чистую рубашку на столе, математическая вероятность того, что надо взять ее за края и сложить, выше чем вероятность того, что сейчас здесь появятся инопланетяне и от них надо будет отбиваться.
Итого, мы подобрались к технологии, позволяющей быстро и дешево создавать мозги роботов. С ловкостью и мелкой моторикой тоже близки к решению (закон масштабирования ловкости выведен, осталось насытить данными и вычислениями).
Прогноз главы робототехники NVIDIA до 2040 года:
- Роботы пройдут физический тест Тюринга (вы не отличите их работу от человеческой). Это уже через 2-3 года.
- Появятся «заводы с выключенным светом», печатающие готовые изделия напрямую из Markdown-файлов по API.
- Роботы начнут сами проектировать и собирать следующие, еще более совершенные поколения самих себя.
И просто красивая цитата от парня:
Наше поколение родилось слишком поздно, чтобы исследовать Землю, и слишком рано, чтобы исследовать звезды, но мы родились как раз вовремя, чтобы решить задачу робототехники