
Ну и за такие комментарии, и новые знакомства, стоило сходить 🤗

Жоский ИИ Дядя Твой личный поставщик AI 🦾🤖 Канал о мире интересного AI: теория, приклад и meme👾 Для связи @dealer_ai (реклама и консультации по AI для бизнеса). Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст РКН: 6348592885
Ну и за такие комментарии, и новые знакомства, стоило сходить 🤗


Аналитика на естественном языке с DataLens на Yandex Scale 2026. Вчера мы были на Yandex Scale 2026, как и обещали. Много интересных стендов про AI, безопасность и инфроструктуру. Но больше всего 📦 заинтересовал воркшоп "Нейроаналитик: ИИ‑аналитика без границ с DataLens". Почему? Все просто в нашем пулле задач есть тема с ИИ агентной аналитикой. Однако, если мы работаем сейчас на уровне семантического слоя, создания обвязки, подбора моделей и mcp шлюза для коннекторов, то ребята из YandexCloud сделали уже все это за вас + ещё и интерфейс нативный вкрутили. Их решение позволяет уже переиспользовать готовую обвязку, чат взаимодействия с вашим знаниевым слоем. С вас только коннекторы к данным и выбор модели. Все остальное дело prompt техники. Есть, как готовый нейроаналитик (most common сценарии и общие рабочие пространства), так и можно настроить внешнего агента с кастомными скиллами под только ваши задачи. Также скиллы можно расшарить на команду поверх готового harness в рамках общего пространства в Нейроаналитик. В общем интересное решение для компаний у которых нет желания делать свое, а просто взять коробку и подрубить на свой ландшафт данных для аналитики. Спасибо ребятам за воркшоп, было интересно 🤗
Telegram doesn't show this post on the web. Open it in Telegram to see it.
Jev, как хорошо забытое старое. Что тут говорить про jev, я и в чате канала писал, что это или диффузия, или энкодер на трансформере, или T5 like, но с supervised хорошо выверенной задачей на обучении. Просто представьте у вас sturctured/constrained output, ток не генеративка. Крч, сам не хочу более писать, почитайте лучше коллегу. 🔫 Да и че там писать, ждём тех репорта. ⏰

Мечтают ли нейромухи о нейроде*%ме.(с) #meme

Все что нужно знать о пользе современного ИИ. ШУТКА. 💳 Модель мухи на 160к (примерно 650кб памяти) параметров нейросети. Ребята дотюнили модель на варку пива, теперь у тебя есть готовый пиво-кореш муха.😜 База тут. #meme, #выходной
О положении oss vs private LLM. Открытые модели уже приблизились к фронтирным и отстают максимум на 4 мес. С таким тезисом вышел аналитический док от команды Mozilla. Отчёт построен на трёх основных типах данных: 1. Опрос разработчиков Mozilla / SlashData охват около 1 400 разработчиков по всему миру (в первой версии 950+). Используется для оценки adoption, барьеров и практик использования. 2. Данные трафика OpenRouter платформы-агрегатора, через которую маршрутизируются запросы к разным моделям. Это даёт картину реального использования по токенам и запросам. 3. Сторонние бенчмарк-индексы: Artificial Analysis Intelligence Index, Epoch Capabilities Index (ECI), METR (time-horizon), LMArena, Terminal-Bench и другие. Что внутри: 1. Возможности и цена. Лучшая открытая модель отстаёт от закрытой на 3 балла и стоит ~60% от неё. В августе 2026 DeepSeek впервые возглавил OpenRouter по недельным запросам. 8 из 10 топ-моделей по токенам открытые, 7 из них созданы в Китае. 2. Забрать легко, но настроить сложно. Уже 79% используют открытые модели, но только 50% исключительно открытые. В продакшен выходит на 12 п.п. меньше, чем у закрытых. Барьеры, конечно же это: инфраструктура (27%), безопасность (26%), поддержка (24%), сложность развёртывания (23%). В Большом Китае adoption 89%, в Западной Европе - 70%. 3. Почему все хотят веса. Главная ценность - независимость и опциональность. Кейс "19 тёмных дней", когда Fable 5 отключили на 19 дней, но у кого были веса продолжали работать. Экономия до 56% на задачах. Китай лидирует по скачиваниям: Qwen 942 млн. Vs Llama 476 млн. 4. Деньги ушли на слой выше. Сейчас основной капитал уже на уровне инфры, безопасности и обвязки. При этом Nvidia купила Hugging Face за $12,93 млрд, Stripe взяла OpenRouter за ~$7,5 млрд. В 2025 году 96% выручки на уровне моделей досталось закрытым провайдерам, хотя открытые давали 20% использования. 5. Harness новый фронтир. Конкуренция сместилась с моделей в ядре на обвязку. Смена harness даёт +21,8 балла на тех же весах. MCP вырос с 2 млн до 110+ млн загрузок SDK. Codex CLI и Grok Build – открытые, Claude Code нет. 6. Блокировка теперь через состояние: кэш, память, дообучение. Ошибка кэша сжигает ~10x больше вычислений. Разброс цен за промах/попадание в кеш достигал 120х. Появились 4 реализации API для дообучения. 7. Шесть основных чаяний: сделать harness заменяемым, универсальные разрешения (беза, роли и тп), владеть весами (модель oss), сломать счётчик (токеномика), владеть циклом агентов (память, контекст, история диалогов), сделать открытое по умолчанию множественным (разнообразие oss моделей). Mozilla исторически возникла как ответ на попытку одной компании контролировать "входную дверь" в веб, и теперь, по мнению авторов, аналогичный сценарий разворачивается на уровне ИИ-моделей. Отчёт позиционируется как "карта", где открытый ИИ выигрывает, где цифры удивляют даже авторов, и где он уязвим. Особенно, это важно после покупки NVIDIA ребят из Huggingface. 👍

TTPO обучение моделей без явной разметки. Представь, LLM сдаёт олимпиаду по математике. Ответов нет. Как ей улучшать себя прямо во время решения? Команда из Чжэцзянского университета и Alibaba предложила TTPO (Test-Time Policy Optimization) - метод, который позволяет модели самообучаться на тесте без единой метки. В чём проблема? Обычно для обучения нужны правильные ответы. В test-time training их нет. Наивный выход - это взять мажоритарное голосование: сгенерировать К решений (к примеру 8), выбрать самый частый ответ и считать его псевдоправильным. Но на сложных задачах такой псевдоответ ошибается в ~85% случаев. Учиться на нём в лоб - значит закреплять ошибку. Ключевое наблюдение авторов это асимметрия ошибок. Челы заметили, даже когда псевдоответ неверен, ~79% решений, которые с ним не согласны, тоже ошибочны. То есть штрафовать "не согласных" почти всегда правильно, независимо от того, права ли псевдометка. Как работает TTPO. Метод делит все решения на две группы и применяет к ним разные сигналы: • Согласные, где траектории совпали с псевдоответом → дистилляция от учителя. Учитель - это та же модель, но ей подсказали финальный ответ, и попросили привести рассуждения для его получения. Зная финал, она строит рассуждения чётче без мечтаний и тупиков. Ученик перенимает стиль рассуждения, а не ответ - это важно, тк помним про 85%. • Не согласные траектории, где ответ не совпадает с мажоритарным → штраф GRPO. Наказываем за уверенные ошибки, но не трогаем безобидные токены. Почему это работает? Фишка в токен-уровневом подходе. Учат не всё решение целиком, а отдельные токены. Вес большой там, где ученик неуверен, а учитель (с подсказкой) уверен. Где ученик и так совпадает с учителем – не трогают. По сути, мне это напомнило DPO на минималках, где роль предпочтений играют вероятности учителя, а не разметка человека. Ну и конечно мажоритарные траектории. Результаты • Qwen3-1.7B в чистом TTT: 38.0% → 45.2% точности, обгоняет TTRL и self-distillation. • Без режима размышления прирост +25–36%, что в разы больше, чем у OPSD с метками. Отмечено, что обучение на одном бенчмарке улучшает другие – значит, модель учит обобщённое рассуждение, а не запоминает задачи. 🧠 Покрайне мере так считают авторы. 👍
Ошибка медиа сообщает о том, что переписки в OpenAI читают люди. 🚬 В контексте этой новости про математиков, конечно, далее вот этот инфоповод наводит на мысли.. Внутри OpenAI есть Project Lily - подрядчики вручную читают реальные диалоги пользователей, чтобы оценивать ответы модели. Фильтр приватности есть, но он не идеален – могут проскакивать личные детали. 📦 все ещё советует делать так: Settings → Data Controls → выключить "Improve the model for everyone". Для чувствительных тем временные чаты (Temporary Chat). Но отключение не удаляет прошлые диалоги из проверки. 😮💨 Помним, что источник 404Media вроде надёжное издание с высоким фактчеком, но с левоцентристским уклоном и громкими заголовками. 👍 Upd. Ну и понимаете, что openai такие не одни, другие крупные игроки делают также. 🇨🇩

А, кстати, с днем программиста, пока это ещё актуально... 👍😐
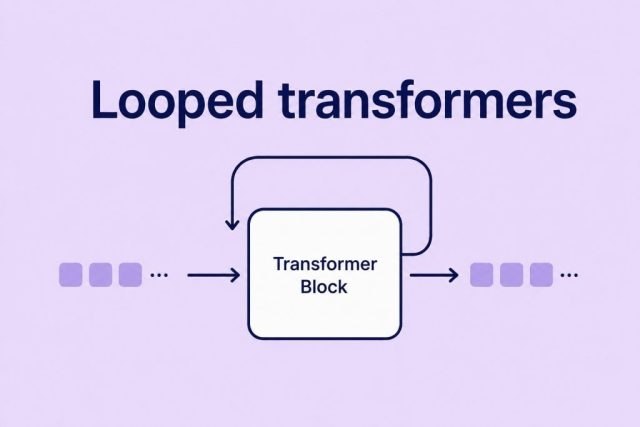
Немного поясню за_looped_transformer 📦 В посте про спекуляции о размере Astra я уже упомянул такое "новое" направление как looped transformers. На самом деле, Дядя оч за новые подходы к архитектурам, инженерии, что даёт ап метрик и пробивает текущее плато продуктивности моделей. 💪 Конечно, хотелось бы и парадигму next token prediction сменить. Но об этом будем говорить в рамках поделок Лекуна. 👍 Однако, луп трансформер не новый подход, он ещё известен с моделей albert и ещё раньше. Первые упоминания в UTS (universal transformers) от гугл аж в 2018. 🚬 Идея не сложная. Вместо роста архитектурной глубины по слоям – числу стаков блока трансформера, а также в ширину – размер hidden state, мы делаем реюз базового блока (например в 22 блока трансформера, ширины D). И делаем это как в Альберт, те выходы с базового блока рекурентно отдаём на вход этого же блока К раз. Таким способом, мы не растим реальную глубину и ширину, увеличивая размер модели в параметрах, также подбираем эффективную базовую глубину и число повторений её рекурентного переиспользования. К примеру, в статье разборе С. Рашка модель Nanbeige 4.2 (3B) имеет 22 стака по 2,что сопоставимо по вычислениям 44 блокам трансформера. В памяти, это конечно поменьше занимает, но по времени same. Также same по времени обучения, а ещё KV параметров больше на число проходов по стаку, тк над хранить qkv для всех проходов. Т.е. выйгрыш только в емкости весов в памяти gpu. 😮💨 Тут конечно влетают идеи у Дяди 😎: 1. Использовать принцип palbert с early exit и lambda слоями. Те модель сама решает с какого блока повтора и слоя выйти заранее. 2. Mixture of Recursions. Иметь роутинг по стэкам для каждого токена. Мы решаем сколько каждый токен пройдёт рекурсивных блоков. Исследование показало, что при достаточно большом размере модели MoR может превосходить обычный трансформер при том же вычислительном бюджете. 🤙 Разница в 1 и 2 подходе, что ponder решает ранний выход для всей последовательности, а MoR для отдельных токенов. 👴 И я очень советую лидерам рнд, кто видит этот пост опробовать оба этих метода, особенно, выделяю MoR тк статья от 2025 года, где указано, что такой сетап может быть эффективнее по KV кэшу, скорости инфера и по глубине. В целом, это все. Ничего особо сложного. 💪

#meme
Про решение задачи миллениума для уравнения Навье-Стокса. Уравнения Навье‑Стокса - это фундамент всей гидро и газодинамики: на них считают крылья самолётов, турбины, погоду и даже кровоток 👍 Почти 90 лет математики не могли ответить на вопрос: может ли идеально гладкое течение внезапно "взорваться", породив "бесконечную" скорость (в пределе)? Работы выше показали: да, может. При определённых условиях вихрь закручивается внутрь, вытягивается как спагетти, и скорость в его центре устремляется к бесконечности. Это не отменяет уравнения Навье‑Стокса для 99,9% инженерных задач, а уточняет их границы и показывает, где именно классическая модель перестаёт работать. 🌀 Связь с теорией катастроф: бифуркация как точка невозврата Сингулярность в Навье‑Стоксе – это точка бифуркации в динамике системы. В теории катастроф Рене Тома такие точки отписываются, как "катастрофа типа складки" – внезапное качественное изменение поведения системы при плавном изменении параметра. Инженерный смысл: зная точные условия возникновения сингулярности, мы можем количественно предсказать приближение к этой точке и управлять параметрами так, чтобы отодвинуть границу срыва, работая на пределе, но не переходя его. Это и есть тот самый запас прочности, который раньше закладывали эмпирически, а теперь можно считать математически строго. По сути это помогает в тч повышать КПД турбины, крыла самолёта и др. 😜 ⚙️ Кейс, пример - помпаж в газотурбинных двигателях Возьмём авиационный или энергетический газотурбинный двигатель. Помпаж – это резкий срыв потока в компрессоре, когда давление на выходе падает, поток начинает колебаться, и двигатель может разрушиться за секунды. Сегодня инженеры используют CFD-расчёты на основе уравнений Навье‑Стокса, но с эмпирическими запасами по углу атаки, числу Маха и частоте вращения. Важный момент - мы работаем далеко от границы срыва, теряя КПД. 😐 Что потенциально даёт результат статьи в данной задаче? В будущем серия сопутствующих исследований может продить точную математическую карту условий, при которых течение перестаёт быть гладким. Это позволяет: 1. Сдвинуть рабочую точку ближе к пределу, те повысить степень сжатия и температуру газа перед турбиной. 2. Внедрить упреждающие алгоритмы – системы управления (FADEC), отслеживающие "предвестникия" сингулярности (рост градиентов скорости, завихрённости) и плавно корректирующие режимы. 3. Сократить дорогостоящие натурные испытания – часть продувок можно заменить точным цифровым моделированием. В конечном счёте для одного двигателя: повышение КПД на 1–2%. Для мировой авиации это экономия ~$10 млрд/год только на топливе. Для энергетических ГТУ - сопоставимые цифры. 😎 📊 Оценка рынка При этом на исследование было потрачено по оценкам экспертов ~15M $ OpenAI said during a press conference that if a customer wanted to run the same problem, it would cost around $15 million. При этом сам рынок Computational Fluid Dynamics (CFD) в 2025 году оценивался в $6 млрд, а к 2034 году может достичь $14 млрд с ростом ~10% в год. Решение выше - это, конечно, не готовый коммерческий продукт, но катализатор, который может ускорить переход от эмпирических моделей к цифровым двойникам с предсказуемой границей устойчивости. 📈 Дополнительный эффект - это сокращение вычислительных затрат. Уже сейчас AI-модели позволяют избегать до 30% CFD-симуляций, ускоряя оптимизацию. Более точное понимание турбулентности и сингулярностей усилит этот тренд. 👍 🚀 Итог: почему это важно Да, исследование выше – не инструкция для инженера на завтра. Это фундамент, на котором в течение 5–10 лет инженеры построят: · Более точные турбулентные модели, · Цифровые двойники с предсказуемой границей устойчивости, · Системы активного управления, работающие на пределе возможностей. Прибыль будет измеряться не прямыми продажами, а глобальной экономией производственного ресурса в авиации, энергетике, судостроении и нефтегазе ~от $10 до $50+ млрд в год. Вот такие пироги. 📦
Ну понеслась 😮 https://openai.com/index/navier-stokes-solution/ Ещё не смотрел, но надеюсь в цитирования чела выше добавили 🤣
+ более аккуратная хронология Челу ещё и угрожают 🥴

OpenAI попала в скандал с "решением" задачи тысячелетия: математик обвиняет ИИ-гиганта в краже идей Вот ещё новость интересная. Математик Тристан Бакмастер утверждает, что OpenAI тайно использовала данные его закрытых сессий в Codex, чтобы получить решение одной из проблем тысячелетия – уравнений Навье–Стокса. Речь о доказательстве "вынужденного взрыва" в трёхмерном пространстве, варианты c и d по классификации Феффермана. 😐 Что известно? · Бакмастер вместе с коллегой Левентом Альпёге разработал около 100 страниц доказательства по этому направлению - почти никем не изученному. · Вскоре после того, как информация об их работе попала в OpenAI, компания предъявила результат по той же самой задаче, заявив, что её внутренняя модель решила её "почти без людей" – достаточно было одного промпта. 🚬 Однако вскрылись подозрительные детали: · Термин «forced» в промпте - слишком узкий, чтобы возникнуть случайно; · На деле над решением трудилась целая команда, а стартовали с уравнений Эйлера; · Промпт готовился с помощью Codex (того самого инструмента, который мог видеть данные Бакмастера); · Расход вычислительных ресурсов был колоссальным; · И самое главное – первый запрос был отправлен после того, как сведения о работе математиков достигли OpenAI. Чем это грозит? Если обвинения подтвердятся, нас ждёт: · Крупнейший этический скандал в области AI.for science; · Пересмотр политики приватности GitHub Copilot и Codex; · Крах красивой легенды о том, что ИИ сам, без подсказок, штурмует задачи тысячелетия. OpenAI пока не ответила на прямые вопросы о временных метках. Бакмастер в бешенстве: «What the fuck is happening!!!» 🇨🇩 Ваше мнение - это вопиющая утечка данных или невероятное совпадение? В целом, я всегда говорю, галочка "не логировать" не даёт 100% уверенности, что ваш диалог не утекает в обучение. 😏 Делитесь в комментариях. 👇👇👇
Бизнес могут обязать использовать суверенную модель ИИ(с) 🚬 Снова поползновения всех пересадить на... Ну такое... 😐 Если мы говорим про b2g, делайте че хотите, но в бизнесе 📦 за то, чтобы была конкуренция - свобода выбора любого глобального решения, иначе ждём путь автоваза с монополией и знаете каким качеством. 😐 Тем более, пока топ модели вышли на петлю самоулучшения и быстро уходят в отрыв от тир-2,3 и тп решений. Использовать такое - означает видеть через стекло рождественскую ярмарку, где всем раздают новые подарки, а ты можешь лишь только смотреть и играть в игрушки 1.5 летней давности. 😢 Если подобные нормы введут, будет так, что такие модели будут юзать для галочки, в конце пайплайна, для формальной пост обработки ответов удобных бизнесу решений. 🧠 Будет ли это стимулом делать модели уровня топ мира или только локальный топ? Думаю второе. Это моё мнение. 🛑 Про отставание в целом молчу, это мнение комьюнити. Поэтому руки прочь от монополии на ИИ, это вредит развитию решений, эффективности бизнеса и убивает конкуренцию. 🚪 🗞 И да, мы будем об этом говорить, тк наш ропот лидеров мнений в ИИ-комьюнити может повлиять на закон, если нас будет много. 💪 Upd. И ещё, вот эти ваши обязать бизнес сидеть на суверене при дельте в прайс до 50% (нац и суверен в до 1.5 раз дороже). Вы кого хотите обязать? У бизнеса свой pnl, сами разберутся и вопрос не только в цене, а в качестве модели за эту цену. Те та самая эффективность и стоимость на токен. Писал об этом тут. #ИИзнанка #суверенныйИИ
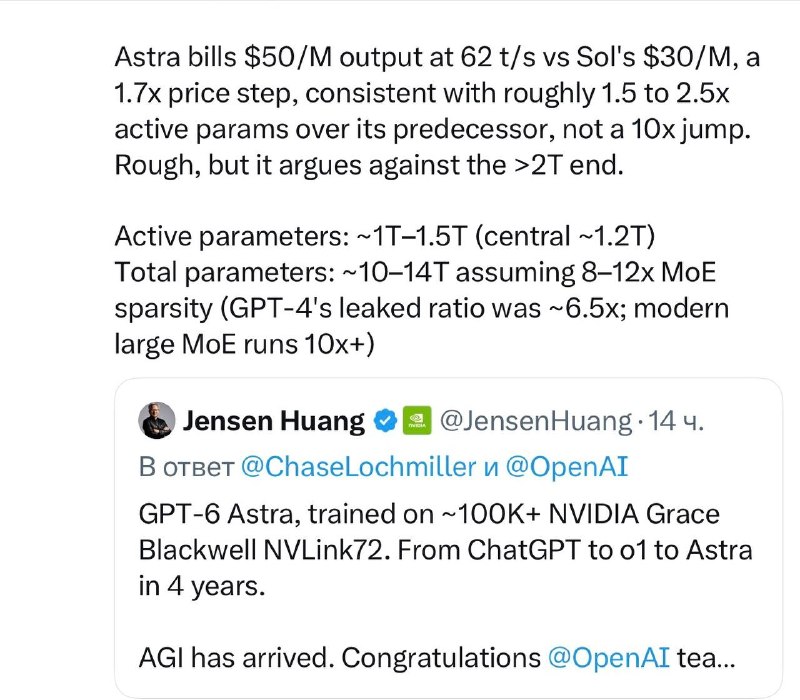

Спекуляции на тему размера GPT-6 Astra. Вдогонку ещё интересная новость, где автор под ником forloopcodes собрал публичные данные и инсайды в единую картину возможной конфигурации модели OpenAI: · Параметры: ~1.2T активных (MoE, sparsity 8–12×) при общем размере ~10T - логично для масштаба. · GPU на все дела: 100-150K NVIDIA Blackwell NVLink72 — подтверждено Дженсеном Хуангом (официально заявил о 100K+). · Тренировка: претрейн ~90–110 дней, финиш в начале июля 2026 (релиз 3 сентября). · Данные на обучение: 60–100T токенов - необходимо для 10T-модели. Спекуляции автора - это экспертная оценка (важное прим.), собранная из публичных данных. Поскольку OpenAI не раскрывает технические детали 🧠, такие цифры получают, комбинируя разные источники. 😮💨 Вот на чем, скорее всего, основаны его расчеты: · Официальные заявления: Прямое указание на 100K+ Blackwell NVLink72 от главы NVIDIA. + Инфа с openai. · Инсайды из "авторитетных" СМИ сообщали, что Astra использует технику "recurrent depth". Это объясняет, как можно получить большой прирост без взрывного роста параметров. · Отраслевые утечки: Многие источники сходились на общем размере модели около 10 трлн параметров с архитектурой MoE. · Инженерная логика: Имея 100K GPU и зная дату релиза (3 сентября 2026), легко вычислить примерное время претрейна (~90–110 дней). А зная размер модели (~10T) и архитектуру (MoE с активацией ~10%), можно вывести и 1.2T активных параметров, и требуемый объем данных (60–100T токенов). Кто такой автор? @forloopcodes – это разработчик и автор ряда opensource-проектов в сфере ИИ. Он не является сотрудником OpenAI 🚬, но его технический бэкграунд, возможно, даёт ему кредит доверия. 🪨 За подгон спасибо @walfry 🤝 Итого, верим?🆒 Пишите в комментариях ниже 👇👇👇
Печалиться не надо LLaDa. 💃 Новая моделька от AntGroup (правда дистиллят) e2e dllm - LLaDA-Image-Turbo, но не спорт 150 лс 🤣, быстрая, легкая и открытая генерация изображений. 😁 Ant Group (inclusionAI) выпустили дистиллированную версию своей 6B-модели. Теперь генерация и редактирование по тексту занимают всего 2–4 шага вместо 50, при сохранении качества. А как мы помним, для диффузионок шаги дейноза (как и зашумления) решают. 🧠 Как учили: Получили сжатие и размера модели, и числа шагов денойза за счёт подхода Twin turbo DmD. Twin DMD работает так: 1. Учимся на распределении латентов. Причём не только конечной генерации, но и тех самых 50 шагов. 2. Чтобы сократить с 50 шагов до 4, мы делаем прыжки и дистиллим ток латенты через К шагов. 3. Два критика в модели которые следят и за отклонением от картинки изначальной, и от генерации учителя, причём в соревновательном стиле GAN. Сама турбо модель даёт генерацию, критики проверяют и дают штраф, модель пытается его снизить. Что умеет: · 🖼 Генерация по промпту · ✏️ Редактирование по инструкции · 📸 Работа с референсными изображениями · 📝 НО. Рендерит текст на китайском и английском 🤨 (хорошая возможность дотюнить и на ру) Цифры: SOTA на Qwen-Image-Bench, фотореалистичность, отличная детализация. 🪨 Веса уже на HF (BF16 и FP8): · Базовая (50 шагов) inclusionAI/LLaDA-Image · Turbo (4 шага) inclusionAI/LLaDA-Image-Turbo Пример кода (PyTorch): pipe = LLaDAImagePipeline.from_pretrained("inclusionAI/LLaDA-Image-Turbo", torch_dtype=torch.bfloat16, device="cuda") image = pipe("твой промпт", height=1024, width=1024).images[0] Сам метрики не тестил, кто пробнет дайте ос в комментариях. 👍 👇👇👇

😎+🤗=???? Nvidia хочет иметь ВИНК (вертикально интегрированную компанию) тему. Не осуждаю и даже поддерживаю. 🪨 Сегодня таким игрокам облачных решений для ИИ уже недостаточно быть только золотой лопатой - IaaS, они делают далее PaaS и после SaaS/MaaS. А я бы ещё делал харнесс, системы защиты и компактизации поверх MaaS. И продавал бы это тем, кому нафиг не нужОн ваш ЫЫ отдел. 📦 Покупка HF – это прекрасный способ в дополнение к сборке и продаже гпу, как в руки, так и в облаке, сделать свой MaaS слой. HF самый популярный кладезь AI моделек и данных, большое комьюнити разрабов +Git. Что легко позволяет засасывать к себе актуальные модели, разворачивать на своей инфре и продавать со своим харнессом as the service. Тем более много моделей по MiT, appache2.0. Отличная монетизации OpenSource. 🧠 Главные риски - вопрос нейтральности статуса HF. Вспомним атаку ИИ агентов на базе моделей openAI на HF, а также то, что NVIDIA является одним из главных партнёров крупных гигантов по ИИ моделям и технологиям разработки. 👍 Upd. А представьте себе, NVIDIA подчиняется системе санкций USA. А HF является меккой распространения China моделей, даже защищается HF от атак их моделями. И в моменте, по требованию USA, могут быть заблочены доступы к Qwen, glm, Kimi, DeepSeek и др. Да, это создаст перецедент интересный и вероятно новую альтернативую версию HF, с блэк джеком и моделями из Китая. 🪨