
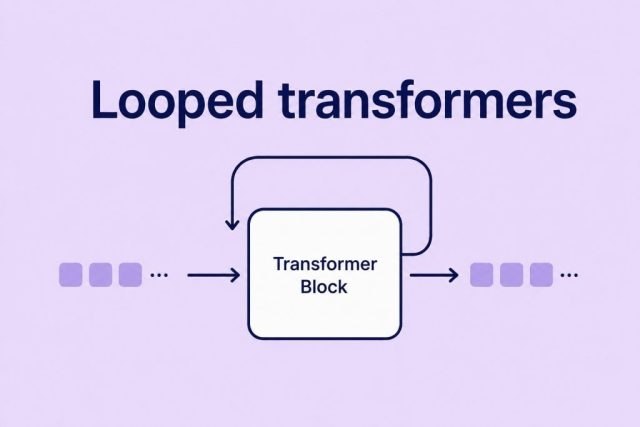
Немного поясню за_looped_transformer 📦 В посте про спекуляции о размере Astra я уже упомянул такое "новое" направление как looped transformers. На самом деле, Дядя оч за новые подходы к архитектурам, инженерии, что даёт ап метрик и пробивает текущее плато продуктивности моделей. 💪 Конечно, хотелось бы и парадигму next token prediction сменить. Но об этом будем говорить в рамках поделок Лекуна. 👍 Однако, луп трансформер не новый подход, он ещё известен с моделей albert и ещё раньше. Первые упоминания в UTS (universal transformers) от гугл аж в 2018. 🚬 Идея не сложная. Вместо роста архитектурной глубины по слоям – числу стаков блока трансформера, а также в ширину – размер hidden state, мы делаем реюз базового блока (например в 22 блока трансформера, ширины D). И делаем это как в Альберт, те выходы с базового блока рекурентно отдаём на вход этого же блока К раз. Таким способом, мы не растим реальную глубину и ширину, увеличивая размер модели в параметрах, также подбираем эффективную базовую глубину и число повторений её рекурентного переиспользования. К примеру, в статье разборе С. Рашка модель Nanbeige 4.2 (3B) имеет 22 стака по 2,что сопоставимо по вычислениям 44 блокам трансформера. В памяти, это конечно поменьше занимает, но по времени same. Также same по времени обучения, а ещё KV параметров больше на число проходов по стаку, тк над хранить qkv для всех проходов. Т.е. выйгрыш только в емкости весов в памяти gpu. 😮💨 Тут конечно влетают идеи у Дяди 😎: 1. Использовать принцип palbert с early exit и lambda слоями. Те модель сама решает с какого блока повтора и слоя выйти заранее. 2. Mixture of Recursions. Иметь роутинг по стэкам для каждого токена. Мы решаем сколько каждый токен пройдёт рекурсивных блоков. Исследование показало, что при достаточно большом размере модели MoR может превосходить обычный трансформер при том же вычислительном бюджете. 🤙 Разница в 1 и 2 подходе, что ponder решает ранний выход для всей последовательности, а MoR для отдельных токенов. 👴 И я очень советую лидерам рнд, кто видит этот пост опробовать оба этих метода, особенно, выделяю MoR тк статья от 2025 года, где указано, что такой сетап может быть эффективнее по KV кэшу, скорости инфера и по глубине. В целом, это все. Ничего особо сложного. 💪