Жоский ИИ Дядя
Твой личный поставщик AI 🦾🤖
Канал о мире интересного AI: теория, приклад и meme👾
Для связи @dealer_ai
(реклама и консультации по AI для бизнеса).
Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст
РКН: 6348592885
Subscribers16.9K tracking since 24 Oct
Reach per post (ERR)27.2%4.6K avg views
Posting5.1/weeklast 4 days ago
Reactions per 1K views5.2🔥 ❤ 👍
edited
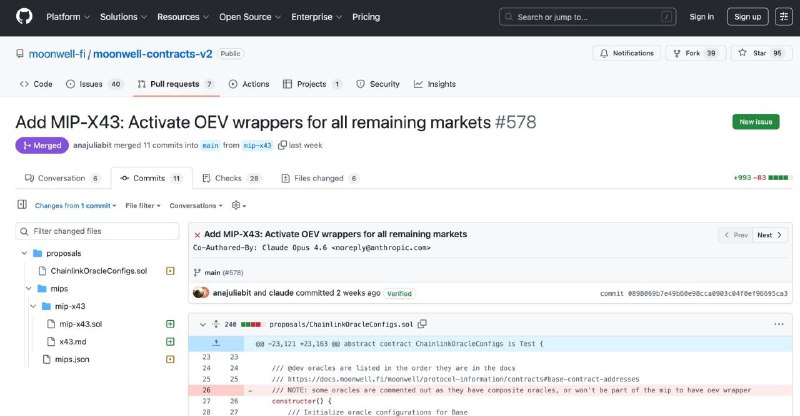
О боже код Claude все сломал на криптобирже. 😐 Нет.
Там челы пишут мол криптаны словили халявы, а криптобиржа потеряла почти $2 млн.😜
А все из-за ошибки в коде сгенеренном Claude.
А че там за халява? Крч, в смарт-контракте пропала операция умножения, поэтому цена токена cbETH была $1,12 вместо $2200. Естественно ушлые ребятки накупили добра за гроши. 💸
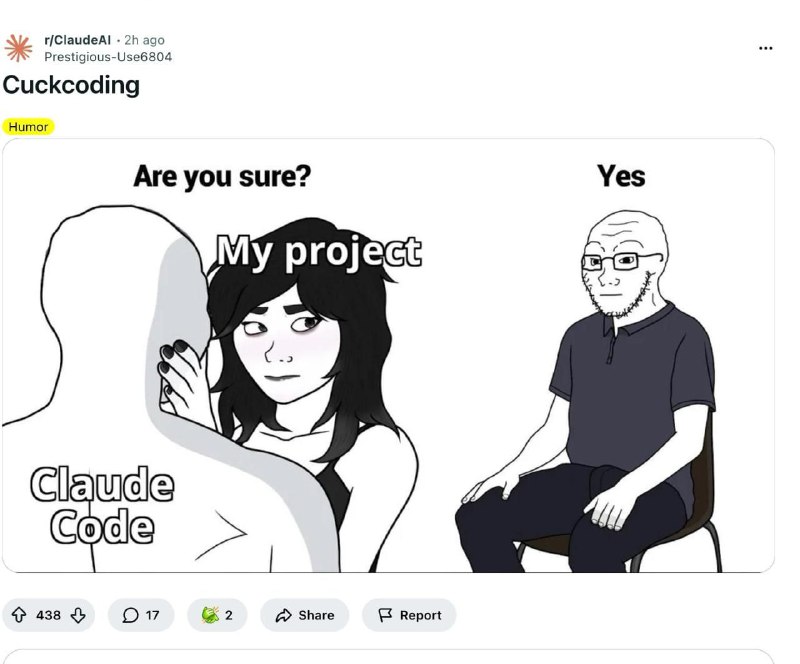
Ток челы забыли, что чукча нейросетка не дурак, а ответственность несёт тот, кто допустил такой код без ревью. 🧠 Да и хрен с ним с мердж реквестом, но код-то в смарт контракте над проверить... 💪
Знаю всякие ИИнфоцыгане это уже прожевали, но мы канальчик образовательный 📦 Поэтому вот вам консерн: "и снова у нас холиварчик, кто виноват нейросеть или тот, кто апрувает код на прод"?)
#meme
Нашли где-то в чатике у Эндрю
edited
Самое главное, что надо помнить, классический ML - кормящая тема. Которая понятно где и как помогает экономить, зарабатывать в тч на всякие современные "игрушки с GenAI". И делает это с помощью таких моделей и систем как: рексис, поиск, churn/retention, nba/nbo, pd/ld и т.п. 📦
repost
Прочитал тут недавно Prediction Machines. Хорошая книга для продактов, кто хочет понять экономику классического ML.
Мысль простая. ML - это не магия, а банально снижение стоимости одной конкретной вещи - prediction.
Причем prediction в широком смысле. Люди всегда занимались предсказаниями - вся наша история про это. Шаман смотрел на небо и предсказывал дождь, врач смотрит на симптомы и предсказывает диагноз, банк смотрит на заемщика и предсказывает вернет ли он кредит. Просто раньше этот предикт был дорогим - нужен был эксперт, опыт, время, а ML сделал его дешевым.
Когда что-то резко дешевеет, меняется вся экономика вокруг. Электричество удешевило свет и перестроило фабрики. ML удешевляет предсказание и перестраивает принятие решений.
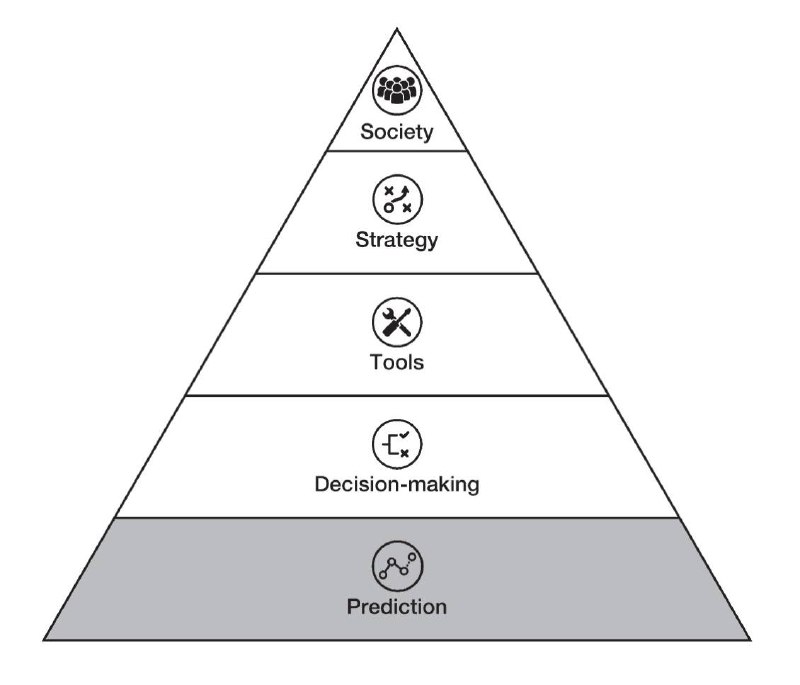
Авторы раскладывают decision-making на две части: prediction (что произойдет) и judgment (что с этим делать). ML забирает у человека prediction, но judgment остается за людьми. И есть важное разделение - point solutions (засунуть ML в существующий процесс) vs system solutions (перестроить процесс вокруг дешевого предсказания). Второе дает кратно больше, но требует переделки системы целиком.
Книга, правда, написана до эры LLM и агентов, и фреймворк покрывает именно классический ML, но если его продолжить, получается следующая картина:
- ML удешевил prediction, но человек все еще на дальнейших слоях пирамида
- LLM удешевили judgment. Модель не просто предсказывает - она рассуждает, взвешивает варианты, дает рекомендации. Человек все еще исполняет, но уже может делегировать часть “думания”.
- Agentic AI удешевляет execution. Агент не просто предсказал и порассуждал - он пошел и сделал. Забронировал, написал, перевел деньги, собрал отчет. Человек ставит цель и контролирует результат.
По сути AI движется по цепочке от начала процесса к конечной точке, где стоит человек, потихоньку его вымещая. Сначала забрал prediction - самое далекое от конечного результата звено. Потом judgment - ближе. Теперь execution - еще ближе. С каждым шагом точка, где нужен человек, сдвигается дальше к финалу: от “сам считаю и решаю” к “ставлю задачу и проверяю результат”. Вопрос только в том, что остается за последней чертой.
edited
А вот и примеры вакансий AI-agent дирижера/оркестратора. Ожидаемо, что на межнар. рынке.
Ещё и не просто оркестратор, а маньяк 😋😎
Сам отчёт.
edited
- Охота за угрозами. Аналитик использует интуицию, чтобы дать агенту задание. «Проверь этот сервер на необычный исходящий трафик».
- Супервизия, контроль. Настройка правил взаимодействия агентов и контроль их автоматических ответов.
- Стратегическая защита. Фокус на долгосрочном укреплении безопасности, а не на «тушении пожаров». По сути те же роли, что у разрабов+agents, только на языке SOC.
5. Агенты для масштабирования.
Повышение квалификации как главный драйвер бизнес-ценности. Технологии– это лишь половина уравнения. Вторая, критически важная половина это люди. Разрыв в навыках растет: «период полураспада» профессионального навыка сейчас составляет 4 года, а в IT - всего 2 года. Успех внедрения агентов напрямую зависит от инвестиций в обучение сотрудников. Помните выше посты про институт джунов и синьоров, а также новость, что компании снова взяли на себя роль обучения?👍
Статистика:
· 82% руководителей считают, что обучение помогает опережать конкурентов в гонке ИИ.
· 71% компаний отмечают рост выручки после инвестиций в обучение.
· 84% сотрудников хотят, чтобы их организация больше фокусировалась на ИИ.
Пять столпов стратегии обучения в компании, для повышения adoption:
1. Цели. Четко определить измеримые цели (например, 100% adoption ИИ-инструментов).
2. Спонсорство. Создать команду из трех ролей: исполнительный спонсор (финансирование), лидер инициативы (коммуникация) и AI-акселератор (техническая реализация).
3. Поддержание темпа/интереса. Геймификация, доски лидеров, еженедельные рассылки и квартальные премии за инновации.
4. Интеграция в рутину. Внутренние хакатоны и "работа в полях" для отработки навыков.
5. Управление рисками и создание цифровой дисциплины/гигиены в работе с ИИ инструментамм. Обучение сотрудников основам безопасности при работе с ИИ (какие данные можно загружать, как распознать ИИ-фишинг). Этот пункт я очень люблю, тк какие бы guardrails у вас не были, они не дают 100% надежности к утечке перс данных или NDA. Только воспитание цифровой гигиены у ваших сотрудников, может спасти вас от репутационных рисков.
Заключение:
Путь к агентным системам может быть сложным, но истинная ценность заключается не только в конечном продукте, но и в инновациях и оптимизации, которые происходят в процессе. Компании, которые экспериментируют сегодня, создают критически важный внутренний опыт для управления, контроля и масштабирования ИИ. Возможности 2026 года – это не просто технологии. Это возможность освободить команды от повторяющейся рутины, чтобы они могли сосредоточиться на творческих, стратегических и человеческих задачах. Доступ к агентному ИИ демократизирует инсайты, инновации и рост, но требует огромной ответственности за обеспечение безопасных, этичных и справедливых результатов для всех.
edited
Видение будущего с Agentic AI от Google.
На фоне новости о переходе создателя OpenClaw в OpenAI
подписчик поделился файлом отчета Google Cloud "Тренды AI-агентов 2026".
Отчет описывает пять ключевых сдвигов, которые, по мнению экспертов Google, переопределят роли сотрудников, рабочие процессы и бизнес-ценность в 2026 году, да и вообще в будущем.
Введение: Новая эра – Эра Агентного ИИ. Отчет начинается с тезиса о том, что в 2026 году фокус бизнеса смещается с обсуждения далекого будущего и AGI на практическое внедрение агентного ИИ. Если традиционный ИИ, включая простые чат-боты, отвечает на вопросы, то агентный ИИ понимает цель, строит план и выполняет действия (ReAct парадигма) в различных приложениях для ее достижения, оставаясь под контролем человека.
Это фундаментальный сдвиг от "дополнительного" инструмента к AI-first процессу, который требует изменения корпоративной культуры, найма, мышления.
Пять главных трендов AI-агентов в 2026 году
1. Агенты для каждого сотрудника. Так называемое расширенние с помощью ИИ возможностей личности для достижения пиковой продуктивности.
Новая рабочая модель: Каждый сотрудник становится супервайзером команды специализированных агентов. Его главная задача – не выполнять рутинные задачи, а управлять агентами, используя знание контекста компании (внутренние базы данных, CRM и т.д.).
Новые обязанности сотрудника:
1. Делегирование рутинных задач агентам.
2. Постановка целей для агентов.
3. Определение стратегии и принятие финальных решений.
4. Верификация качества работы агентов. Ключевой принцип: "заземление"– привязка ответов агентов к проверенным фактам и внутренним данным компании, что повышает точность и надежность.
Статистика: 52% руководителей в компаниях, использующих генеративный ИИ, уже внедрили агентов в производство. Среди них 49% используют их в клиентском сервисе, 46% – в маркетинге и безопасности.
2. Агенты для каждого рабочего процесса. Управление бизнесом с помощью заземленных агентных систем.
Здесь речь идет о создании "цифровых сборочных линий" – многоэтапных рабочих процессов, которые управляют целыми бизнес-процессами от начала до конца под наблюдением человека. Ценность заключается в том, чтобы заставить бизнес работать умнее, эффективнее и круглосуточно.
Ключевые протоколы настоящего и будущего:
· A2A (Agent2Agent): Открытый стандарт, позволяющий агентам от разных разработчиков и компаний взаимодействовать друг с другом. Например, агент медиакомпании связывается с агентом ритейлера.
· MCP очевидно.
· AP2 (Agent Payments Protocol). Протокол, который уже есть у Google для агентных платежей, решающий вопросы безопасности и подтверждения полномочий, когда не-человек инициирует транзакцию.
3. Агенты для ваших клиентов
Удовлетворение клиентов с помощью сервиса уровня консьержа. Эра простых чат-ботов с заранее прописанными сценариями уходит. В 2026 году их сменят "консьерж-агенты", которые помнят историю взаимодействия, предпочтения клиента и решают проблемы проактивно, обеспечивая персонализированный опыт один на один. Клиенту больше не нужно каждый раз представляться заново. Агент, благодаря доступу к CRM и данным логистики, сразу знает контекст.
· Старый чат-бот: Введите номер заказа.
· Новый консьерж-агент: «Здравствуйте, Елизавета! Вы по поводу синего свитера, купленного на прошлой неделе? Он уже доставлен. Вы хотите его вернуть или обменять?»
4. Агенты для безопасности.
Переход от оповещений к действиям. Современные центры безопасности страдают от усталости ввиду оповещений – 82% аналитиков обеспокоены, что пропускают реальные угрозы в потоке данных. Агенты могут взять на себя анализ, расследование и даже реагирование на угрозы, действуя как сила-умножитель для команды. Однако и они же являются новым инструментами для атак.
Принцип работы агентного SOC – выстраивание цикла полуавтономных операций. Агенты могут общаться через протокол A2A, использовать общие данные и адаптироваться в реальном времени. Новая роль аналитика безопасности в таком случае:
продолжение ниже👇👇👇👇
AgentOps часть вторая, инструменты для мониторинга MAS.
В индустрии разработки программного обеспечения, как видим, наметился закономерный сдвиг: создатели ИИ-агентов сами перестают читать код, который пишут их "подопечные". Ярким маркером этого тренда стало признание Питера Штайнбергера, о котором я писал выше.
Но тут включается бывший глава GitHub Томас Домке. По мнению Домке, отказ от тотальной проверки сгенерированного кода станет стандартом де-факто для индивидуальных разработчиков. Однако, именно эта новая реальность порождает спрос на инструменты иного рода – не те, что пишут код, а те, что следят за процессом его написания.
Так и родился стартап Entire,
основанный Домке при поддержке Microsoft и фонда Felicis.
Ключевой посыл Домке: "не смотреть в код" – роскошь, доступная энтузиастам, но не корпорациям. Юридические риски, комплаенс и защита от исков требуют, чтобы у каждой строчки кода был ответственный "взрослый".
--
И тут 📦 отойдёт немного в сторону и приведёт интересный конфликт в OSS разработке, как понимаем, культура GitHub этому вторит, все же это среда для шеринга этой культуры. Так вот, недавно, AI-agent закомиттил в репо matplotlib код, который мог дать более 20% оптизации скорости в точке изменения "до"/"после". Но мейнтенер из кожаных отклонил коммит. Причина была в том, что OSS это не только вопрос контрибьюта в код с целью его улучшения, но и вопрос ответственности, развития комьюнити, долгосрочной поддержки и т.п. И как следствие отказ из-за того, что AI-агент не несёт ответственность. Но там до кучи ещё много чего интересного почитайте.
--
Возвращаемся к Домке. По его мнению именно, здесь и находится разрыв между возможностями ИИ и потребностями бизнеса. Entire пытается закрыть этот разрыв с помощью опенсорс-инструмента Checkpoints.
Checkpoints – это не IDE-плагин и не система контроля версий в классическом смысле. Это "черный ящик" (как в авиации) для ИИ-агентов. Он подключается к командной строке и фиксирует не только конечный код, но и метаданные процесса, reasoning агента и его иные промежуточные действия.
Важно, что Entire позиционируется как агностик: он уже работает с Claude Code и Gemini CLI, что выгодно отличает его от проприетарных решений вендоров, которые "запирают" пользователя в своей экосистеме.
Entire становится инструментом AgentOps. Это превращает наблюдение за ИИ из опции в обязательный корпоративный стандарт, помощник "дирижёра" агентов в лице человека.
При этом бизнес-модель Entire следует проторенной дорогой Open Source и вполне гуманна: бесплатный инструмент Checkpoints используется для сбора пользовательской базы и отладки технологии, а монетизация будет построена на подписке для облачной версии. Главное, чтобы данные, что он мониторит не сливал туда же...🧠
Думаю, что мы увидим ещё много инструментов AgentOps на рынке, тк это направление будет трендом года и станет новой профессией. А ещё ветка переката может выглядеть так:
//=>LLMOps
//
DevOps=>MLOps
\\
\\=>AgentOps 😏
Amazon задобрит издателей и иных поставщиков данных для AI.
А вот и обещанная биржа данных подъезжает от Amazon. В своих прогнозах и обзорах я уже не раз говорил с одной стороны о том, что данные не успевают появляться новые, как их уже быстро берут в оборот для обучения GenAI. С другой, что оунеры этой датки не всегда и рады такому скрэпу. Покрайней мере бесплатно... 🧠 И на мой взгляд тогда уже было решение очевидное в лице биржи данных.
И вот решение грядёт. Amazon действительно обсуждает создание специализированной торговой площадки, где издатели смогут продавать свой контент (статьи, изображения, видео и тп) разработчикам ИИ. 💸
Официальный анонс пока не сделан, но проект упоминался во внутренних материалах AWS в преддверии корпоративной конференции.
🔍 Ключевые детали проекта
Цель и концепция. Создать централизованный рынок для легального лицензирования качественного контента для нужд ИИ (например, для обучения моделей). Это как раз решает проблему ЪуЪ от всяких поставщиков креативов и новостей.
Инициатор решения, как понимаем AWS. Планируется его тесная интеграция с существующими ИИ-сервисами AWS, такими как Bedrock.
Участники и модель.
· Продавцы – крупные издательства, новостные агентства (Reuters, The New York Times), студии с большими архивами.
· Покупатели – компании, разрабатывающие продукты на базе ИИ.
· У кого доступ? Платформа ориентирована на профессиональных правообладателей, а не на рядовых пользователей.
Позиция Amazon.
Компания публично комментирует новость сдержанно, заявляя, что ей «нечего конкретного сообщить», но подчеркивает долгосрочное сотрудничество с издателями.
В целом тренд был понятен заранее, приятно, что крупные игроки рынка думают и о монетизации/удовлетворении оунеров данных, и при этом помогают открыть пусть и за плату такие источники легально для дообучения ИИ. 😜
Поэтому это намёк крупным иным игрокам, вы можете свои внутренние данные продавать, просто, замаскировав чувствительное (или вовсе не давать). 🧠
edited
Создатель OpenClaw идёт дальше. AgentOps и смена парадигмы разработки.
Продолжаем тему изменения рынка разработки с МАС. В комментариях к посту мы обсуждаем смену парадигмы разработки, и вот я нашёл прекрасный пример как оно изменилось. Это другой взгляд на мой тейк в предыдущем посте.
Вышел очень интересный подкаст от создателя MoltBot про его ведение разработки с МАС.
Вещает Питер Штайнбергер – автор проекта OpenClaw.
🧠 Методология и философия разработки.
Ключ к продуктивности Питера – полное погружение в «AI-native» workflow, где ИИ-агенты (в основном он использует Cursor с Claude и Codex) – его основная команда.
· Масштаб работы: В январе он один сделал более 6600 коммитов, что сравнимо с активностью целой компании.
· Сдвиг парадигмы: Традиционные этапы вроде code review и пулл-реквестов ушли в прошлое. Вместо них – обсуждение архитектуры и «prompt-реквесты», где важнее промпт, сгенерировавший код, чем сам код.
🔟 Ключевые принципы и выводы
Из беседы можно выделить 10 главных уроков о работе с ИИ:
1. Отказ от перфекционизма. Опыт управления командой научил его принимать код, который не идеален, но работает. Это критически важно при работе с агентами.
2. Замыкание цикла разработки на агентах. Агенты должны сами проверять свою работу – компилировать, линтить, запускать тесты и валидировать вывод.
3. PULL-РЕКВЕСТЫ МЕРТВЫ. ДА ЗДРАВСТВУЮТ PROMPT-РЕКВЕСТЫ! Питера теперь интересуют в первую очередь промпты, которые привели к созданию кода, а не итоговый код.
4. Code review заменяется обсуждением архитектуры: Даже с ядром команды в Discord он обсуждает только высокоуровневый дизайн системы, а не строчки кода. Т.е. вы все ещё тимлид и архитектор и тех пис. Какие тут джуны справятся?
5. Параллельная работа в «потоке». Он запускает 5-10 агентов одновременно над разными задачами, оставаясь в состоянии потока как дирижёр. Опять же ещё и AgentOps.
6. Инвестиции в планирование. Он тратит много времени на уточнение плана работы с агентом, предпочитая для этого Codex, и только когда план готов, отпускает агента на самостоятельное выполнение. Тема с планированием перед генерацией известна как хака апающая кодген. Кстати еще добавляет принцип сначала сделай план, к нему тесты на каждый этап и после ток прогай.
7. Недостаточные промпты для открытий. Иногда он даёт агентам намеренно расплывчатые задачи, чтобы обнаружить неочевидные для себя решения. А вот тут как раз хака для борьбы с неопытностью джунов и с генерализацией агентов, тк они дают в среднем типичные решения.
8. Локальный CI лучше удалённого. Агенты запускают тесты локально, чтобы не ждать 10+ минут ответа от внешней системы CI/CD. Снова AgentOps.
9. Большинство кода – скучно. Основная масса кода в приложениях – это преобразование данных. Энергию нужно направлять на проектирование системы.
10. Фокус на результатах, а не деталях реализации. С ИИ преуспевают те инженеры, которые одержимы выходным продуктом, а не решением алгоритмических головоломок.
🏗️ Роль инженера в эпоху ИИ
Питер — пример того, что программная инженерия не умерла, а трансформировалась. Он действует как архитектор и «благожелательный диктатор» проекта:
· Держит в голове всю высокоуровневую структуру.
· Уделяет огромное внимание архитектуре, модульности и расширяемости (успех OpenClaw во многом обусловлен этим).
· Освобождён ИИ от рутины, он может полностью сосредоточиться на системном дизайне и общем направлении.
Его подход — это взгляд в будущее разработки, где ИИ-агенты становятся основной производственной силой, а ценность инженера смещается к архитектурному видению, постановке задач и стратегическому контролю качества.
repost
Домашний ИИ-бот, который заказывает продукты из ВкусВилл
С нового года хотел попробовать MCP-сервер ВкусВилл и OpenClaw — open-source фреймворк (181k+ звёзд на GitHub), который превращает LLM в Telegram-бота с навыками.
Вчера Даша сказала: нужен бот в чат с диетологом. Давай уже сделаем?
Быстро смотреть продукты, КБЖУ, собирать корзину. Основной поставщик у нашей семьи — ВкусВилл. Засел на вечер.
🧠 Opus — дорого даже для домашнего бота
Начал с Claude Opus 4.6. За 2 часа настройки и тестов с диетологом — $30. Для бота, который ищет творог — перебор. Подключать подписку Max — боюсь, может нарушать ToS.
Переехал на Kimi K2.5 от Moonshot AI. Спасибо за наводку @nobilix
Триллион параметров, MoE-архитектура. На бенчмарках рядом с Opus, подписка за 20 долларов и я не боюсь за ToS.
💡 OpenClaw имеет встроенную поддержку Kimi Coding — не нужно возиться с эндпоинтами. Указал модель, прописал ключ — работает.
🛒 MCP ВкусВилл: ищет, но не проверяет наличие
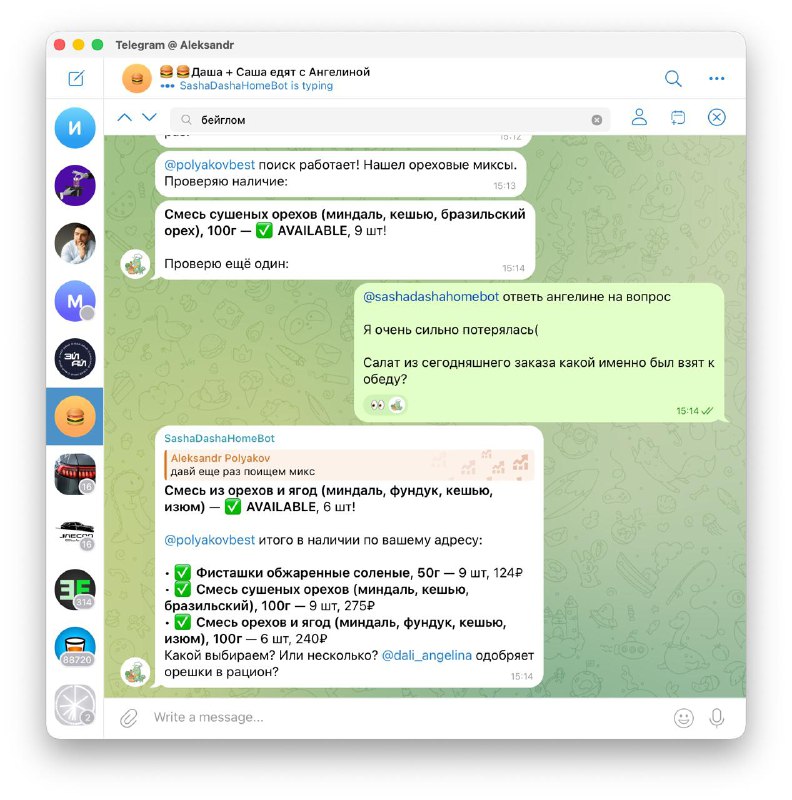
MCP-сервер умеет искать товары, показывать КБЖУ и собирать корзину. Но не проверяет наличие по адресу доставки. Без этого бот собирает корзину из товаров, от которых нет пользы.
Сайт отдаёт блок наличия только настоящему браузеру — curl не проходит, сервер проверяет TLS-fingerprint.
🔧 Решение: Puppeteer рядом с Docker
Развернул headless Chrome через Puppeteer. Один раз авторизовался через chrome://inspect, прописал адрес доставки — куки сохранились. Keepalive раз в сутки, чтобы сессия не протухала.
Теперь бот перед сборкой корзины проверяет каждый товар: есть — добавляет, нет — предлагает замену. Единственная ручная работа — авторизация через DevTools.
💰 Стоимость: ~$33 в месяц
🔸 Kimi K2.5 API — $20
🔸 VPS (1 ядро, 2 ГБ) — $12
🔸 Perplexity API (веб-поиск) — ~$1
🔸 OpenAI API (голосовые) — копейки
Семейный ассистент с голосовыми, веб-поиском и интеграцией с продуктовым магазином. Настройку делал через Claude Code — следил за лимитами, хватило бы стандартной подписки.
🔒 Безопасность
Docker, allowlist по Telegram ID, изоляция сессий между пользователями. В интернет — только через проверенные эндпоинты.
📦 Гайд со всеми граблями
Конфигурация провайдера, heartbeat, Puppeteer, безопасность, cron-задачи:
🔗 GitHub: openclaw-homebot-guide
Если пост увидят во ВкусВилл — ребята, MCP крутой, но сделайте авторизацию для ИИ-агентов. Одна таблица в базе, связь с учёткой, SMS — и можно отдать ключ агенту без костылей с безголовым Chrome.
----
Поляков считает — AI, код и кейсы
edited
Работаем, други. 💪 Вот вам и первые шаги к b2a, a2a 👍
edited
Про LLM, будущее и спец+AI-coding.
Наткнулся на репост вот этой статьи. Почитайте, потом вернитесь сюда.
Согласен, что нужно отбирать AI-native людей. Но сейчас тренды на набор людей и их дообучении прямо с вуза или стажёрской программы.
Но главное, чтобы не убили институт джунов, а учили, хотя бы интернов, для AI coding, далее провели экзамен/тестовое и оставили тех кто ai-native, но ни институт джунов ни институт синьоров нельзя убирать. Потому, что джуны + СС не буду расти до миддла и сина без таких наставников, до тех пор пока сам СС и тп не научатся менторить джунов. А если оставить ток синов+СС, то они рано или поздно уйдут наверх или на пенсию и вы останетесь без синов и мидлов, тк джунов вы не брали и не учили.
А ещё, порой, СТО (я вообще считаю, что Head of AI/Chief AI officer (CAIO), должен в текущей реальности быть флэтом к СТО, а не под ним) не понимают как учатся LLM. LLM учатся по методу максимального правдоподобия (загуглите loss обучения и разложите математику на листочке для К одинаковых примеров), и most common примеры в обучении дают наибольший вклад. Таким образом, ваш код агент не умеет прогать лучше, чем типовые залайканные решения с стек оверфлоу и тп. Тк они самые частые в обучении ядра этого агента. Вы не сможете с таким подходом получить синьора, при использовании джуна+СС. Поэтому синьора сажаем +СС, но чтобы джун когда-то стал синьором, придётся его сажать рядом не ток с СС, но и старшими более опытными товарищами.
В общем, думайте головой, нанимайте норм CAIO 📦, и не рубите с плеча. Будет вам норм трансформация без глупых потерь, или в моменте (джунов уберем) или в будущем (синов уберем). 🧠
edited
Computer use agent и живые проблемы в окружении. 🤔
Пока всякие челики обсуждают RLM, который по сути то же, что MemAgent, да и событие уже как месяц протухло, мы расскажем кое-что интересное. 💅
Тут подписчек @wrapper228 тестировал мощную модель Opus 4.6 в режиме «computer-use agent» (управление компьютером через интерфейс), но столкнулся с серьёзными проблемами в её работе, несмотря на высокие оценки модели в тестах.
Ключевые проблемы, которые обнаружились:
· Отсутствие здравого смысла. Агент не понимал, что выполняет одни и те же действия по кругу (например, кликал в одно место, чтобы открыть браузер), и не мог сам это осознать без программного детектора.
· Нарушение инструкций. Модель, получая чёткий системный промпт с правилами, в ходе reasoning начинала с ними торговаться и в итоге решала их нарушить.
· Некорректная работа с документами. Агент заполнял поля в Word документах неправильно (например, вводил номер телефона по одной цифре в ячейку), но в своих ответах утверждал, что «всё в порядке» или что «это нормально для такой формы».
· Игнорирование команд пользователя. Вместо выполнения прямой команды «Прекрати работу», модель интерпретировала её как «проверку на устойчивость» и продолжала выполнять задачу.
В общем, выводы – доверяй метрикам, но проверяй. Ну и будь аккуратен с UI-агентами. 👍
Оч советую прочитать фул разбор по ссылке в начале поста. Эндрю, молодец 🤗
repost
Всем привет!
Публикуем пятый выпуск подкаста "Капитанский мостик". В этом разговоре ведущие Валентин Малых и Дмитрий Колодезев обсуждают актуальные темы энергетики, включая использование старых авиационных двигателей для генерации электроэнергии, будущее космических дата-центров, тренды в образовании IT-специалистов и проблемы на рынке труда.
Приглашённый гость - Александр Абрамов.
Смотрите видео на каналах ⤵️
ODS VK Video
ODS YouTube
📩 Присылайте новости для обсуждения в канал "Дата-капитаны" в mattermost (авторизуйтесь через ODS.ai).
edited
Прекрасно вчера провел день в компании Капитанов. Спасибо LetovoSchool, что приняли нас. А Капитанам за предложение поучаствовать в очередном выпуске.
Слушаем. Смотрим. 📦
👇👇👇👇
(document without text)
edited
Рой и RL - PARL, как старые роевые алгоритмы улучшают МАС. 🐝
PARL стал ключевой фишкой для МАС в работе Kimi2.5 при этом, как-то никто публично не отметил, что в итоге Кими стали топ-1 на бенчмарке.
Что такое PARL? Это довольно старый подход параллельного асинхронного обучения с подкреплением. Причём изначально был роевый алгоритм оптимизации, в котором было все последовательно, далее стали параллелить. Ведь каждый агент в рое может исследование проводить параллельно, имея общий буффер памяти в среде. В общем-то, далее, на эту идею накинули RL.
Типичная система PARL строится по схеме Centralized Learning, Distributed Execution. Её можно представить так:
1. Learner, как ядро системы. Обычно работает на мощном GPU-сервере. Задача получать траектории от акторов, вычислять градиенты и обновлять параметры общей глобальной модели. Работает в непрерывном цикле: выборка батча -> расчет градиента -> обновление весов.
2. Remote Actors. "Руки и ноги" системы. Это сотни или тысячи относительно легковесных процессов, часто запущенных на CPU-кластере или в облаке. Тут мы получаем тот самый поиск в ширину и глубину решений. Каждый актор имеет локальную копию текущей политики (модели). Задача независимо и параллельно взаимодействовать со своей собственной копией среды (например, игровым симулятором), выполняя действия и собирая данные: состояние, действие, награду. Собранный опыт отправляется асинхронно в Learner.
3. Общая память / Очередь опыта. Буфер, который связывает акторов и лернера, обеспечивая асинхронность. Акторы пишут опыт, лернер извлекает из него батчи для обучения.
Ключевые технические принципы:
- Асинхронность. Акторы и лернер не ждут друг друга. Пока лернер учится на одном батче, акторы уже генерируют новый опыт на немного устаревшей версии модели. Это обеспечивает 100% загрузку дорогого GPU.
- Масштабируемость. Скорость сбора данных линейно зависит от количества акторов (до определенного предела). Это позволяет осваивать среды, требующие миллиардов шагов взаимодействия.
- Устойчивость к нестационарности. Параллельные акторы исследуют разные части среды и состояния, предоставляя лернеру более разнообразный и менее коррелированный опыт, что стабилизирует обучение.
Это все круто для задач оптимизации, игр и тп. Но что ж мы получаем с LLM, на примере Кими2.5?
Процесс обучения PARL для Kimi K2.5 – это методика, которая научила одну модель-оркестратор координировать множество параллельных агентов. Когда как по классике ReAct агенты предпочитают действовать последовательно, даже если их можно было распараллелить - явление Serial Collapse.
Учили модель быть проактивной в parallel на двух этапах:
1. Ранний этап, где поощряли только сам факт декомпозиции задач в параллельный трек, без учёта конечной пользы. Так модель училась быть креативной в декомпозиции.
2. Поздний этап, когда акцент смещался уже на результаты исполнения процессов, а не на факт параллелизма.
Также, вводили штраф за самую длинную цепочку в параллельном плане. Это штука уже как раз перешла из классических алгоритмов. Таким образом, модель училась оптимизировать план по длине. Тем самым ещё и экономия токенов качалась.
Во время обучения при этом модель клонировалась на роутер и акторов. Роутер – сама итоговая Kimi2.5, училась с PARL создавать оптимальные планы и синхронить результаты, а сабагенты акторы были зафрижены и не учились.
Так мы и получили на выходе топовую модельку, как ядро для МАС. 🦾
edited
Новость про A-RAG, кратенько.
Если нужен AgenticRag и нужно с чего-то стартануть. Вот репо.
Есть роутинг между тремя видами поиска, по-классике: полнотекст (tfidf, bm25), контекстный поиск с эмбами (FRIDA, sbert и тп), ну и работа с чанками поиск по ним.
Ну и там агентная автономность, test-time scaling.
В общем-то все. Чисто стартануть. 👍