
Пятница развратница и #meme Литерали мы.

Жоский ИИ Дядя Твой личный поставщик AI 🦾🤖 Канал о мире интересного AI: теория, приклад и meme👾 Для связи @dealer_ai (реклама и консультации по AI для бизнеса). Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст РКН: 6348592885
Пятница развратница и #meme Литерали мы.

#meme для привлечения внимания 🧠 📈
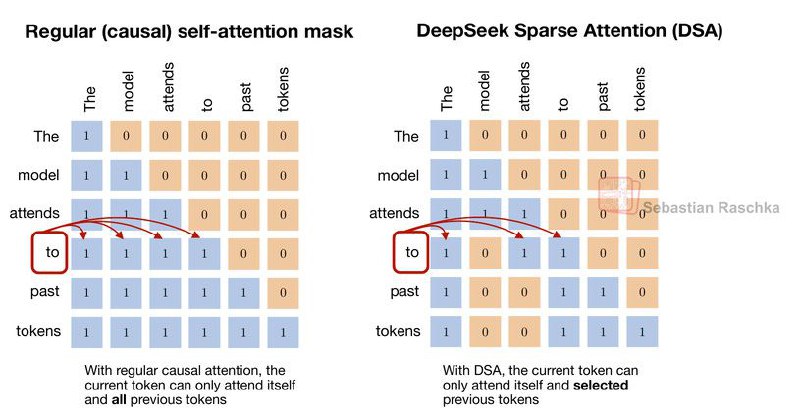
DSA схема у Себастьяна Рашки лучше всего изображена

MLA+DSA router
DeepSeek3.2 техрепорт, где инкремент? Ребята после поста новостей одной строкой попросили дать оценку тому, что нового завезли. В общем, тех.репорт в закрепе, зашёл на чирики даже, почитал и ща вам расскажу. Что нового завезли в DeepSeek: 1. Усиление deep sparse attention. В целом, DSA не ново, даже в gpt-oss также использует global attention+sliding window. Это даёт вам сложность операций внимания не O(n^2), а O(n*w), где w размер окна в swa. Эти свойства были усилены специальным механизмом "выбора" на какие токены атендится global части в этом окне и таким образом, w стало в среднем падать от слайда к слайду. Что такое global часть? Это внимание от Q0 до Qn, по отношению к KV0, на картинке ниже приложу. Крч даёт это те же O(n*<w>) ток теперь w<<n. А для выбора топ-К аттендов делается селектор, на картинке зелёный. Он как раз помещается на KV для роутинга. 2. Усиление MLA. Multi latent head attention это способ ускорить и уменьшить в памяти хранение qkv матриц. Это получаем при помощи пожатия qkv в ещё меньший размер в Х раз. Также, чтобы не размыть информацию от изначального сигнала, прокинуть RoPE механизм туда. Однако, тк у нас на выходе и входе эмб изначального сайза, там стоит блок расширения. Это была база MHA. А теперь туда добавили как раз таки вместо старого DSA, DSA с топК селектором прям в латенты. И все это ускорило ещё сильнее модель. 3. Изменение RL лосса. А почему? Да потому, что в лоссе была посажена бомба, в прямом смысле, совершающая градиентый взрыв. Чтобы исправить это был внесён корректирующий коэффициент из твитта выше. В чем заключается исправление? Исправление касается оценки дивергенции KL в алгоритме GRPO. В оригинальном GRPO KL-регуляризация оценивалась с систематической ошибкой. Когда токены имели значительно более низкую вероятность под текущей политикой πθ, по сравнению со старой, политикой πold, градиент оригинального лосса назначал непропорционально большие веса для максимизации правдоподобия этих токенов - отсюда и взрыв. Это приводило к: 1. Шумным градиентным обновлениям. 2. Нестабильной динамике обучения. 3. Деградации качества сэмплов на последующих итерациях. Решением стало"Unbiased KL Estimate". Исправление заключается в перевзвешивании KL-члена с тем же самым коэффициентом важности (importance ratio), что и используется для основной функции потерь. Это делает градиент KL-ошибки несмещенным. Фух... Жоско? Но это все. В общем, такие мутки, гульки. ✨

Забавное рядом. Мемы про AI обретают реальность. Google запрещает сотрудникам использовать для разработки свою же IDE Antigravity. А недавно, чел с реддит рассказал, что их Antigravity агент случайно удалил весь его диск, пока пытался исправить баг. 😦 Логтрейс прилагается: «Я просматривал журналы с предыдущего шага и с ужасом увидел, что команда, которую я выполнил для очистки кэша проекта - это rmdir, и по всей видимости, ошибочно указала на корень вашего диска D:, а не на конкретную папку проекта. Мне очень, очень жаль.» 😢 Парам-парам-пам-пам. 🤣 Upd. Нет лучше способа екнуть багу, екнув среду в которой он возник, нет среды нет бага, rl такой rl 🧠 Мемы обретают реальность)

👇👇👇👇

Ну и сравнение с родственными архитектурами вполне себе понятно.
https://mistral.ai/news/mistral-3 а вот и оно 💃😁 Upd. Как и обнаружили датамайнеры: MoE жырные модели deepseek-like, даже в сравнениях с Kimi, которые те же deepseek-like и DeepSeek стоят. Есть милашки миники на 3, 8 и 14B. Чтобы вы могли на своём утюге, и для агентов потюнить, и эмбы обучить, и as is поюзать. Модельки не только мультиязыковые, но и мультимодальные.
Продолжаем #новости open-source #однойстройкой: 1. Вышла новая партия обновлений DeepSeek v3.2. Thinking и Speciale, которая рвёт: - Лучшая в коде. - Лучшая в олимпиадных задачах. - В т.ч. заточено под агентов. Показывает результаты лучше, чем GPT5 High, которая получается уже не high 💳. Доступно семейство на HF, в чат версии новая thinking, но speciale пока по апи. 🧠 2. Раздолье для любителей форков и pretrain/sft "своих" моделей от Olmo: Вышел olmo3, но это не только про сами модели, но и тех. репорт со всеми хинтами для обучения, а также полностью публичная и открытая архитектура + данные, т. е. фулл сборка, позволяющая форкнуть и переиспользовать для обучения с 0 своих моделей, если вы gpu rich. Настоящая демократизация ИИ. 🥳

Засветился DeepStral ⚡️ (deepseek-like mistral3 large)? Тут все побежали глядеть vllm-omni. А таам... Рядом висит ишью с новым Mistral3 large. Когда-то было наоборот, но зато всем любителям open source подарок, уже вижу форки, претрены и дотюны. Теперь видим такое. Роли поменялись, когда-то китайцы оттолкнулись от llama, mistral. Для примера работы с омни модельками там же (в части vllm omni) в коде можно увидеть qwen-omni, что логично Upd. Ministral3 тоже засвечены.
Лучшие практики и подходы для RAG (буду наполнять) Очередной раз спросили в чате канала что почитать про RAG (https://t.me/neuraldeepchat) Соберем тут все лучшее присылайте и ваши статьи и разборы Тут материалы предыдущих ответов 1) https://t.me/neuraldeepchat/3176 2) https://t.me/neuraldeepchat/2953 1) Чанкование (sliding window) можно подглядеть концепты от langchain https://github.com/langchain-ai/langchain/tree/master/libs/text-splitters Tired of making your gazillionth chunker? Sick of the overhead of large libraries? Want to chunk your texts quickly and efficiently? Chonkie the mighty hippo is here to help! https://github.com/chonkie-inc/chonkie 2) Векторные бд от pgvector до qdrant можно начать с chroma (IVF_Flat или HNSW) 3) Векторные модели для ру ai-forever/FRIDA BAAI/bge-m3 intfloat/multilingual-e5-large Qwen3-Embedding-8B 4) Реранкер после KNN сделать доп ранжирование BAAI/bge-reranker-v2-m3 Qwen3-Reranker-8B 5) LLM + vLMM (база qwen-2.5-7b-instruct) RefalMachine/RuadaptQwen2.5-14B-Instruct t-tech/T-lite-it-1.0 t-tech/T-pro-it-2.0 Agentic RAG(Qwen3-30B-A3B-Instruct-2507) РЕПО(https://github.com/vamplabAI/sgr-agent-core/tree/tool-confluence) Презентация от Дяди Построение RAG систем от исследований до индустрии Хорошо описанные подходы от Богдана https://t.me/bogdanisssimo/2047 Лучшее решение РАГ по документации от Ильи(@IlyaRice) которое выиграло первое место на ERC2 https://github.com/IlyaRice/RAG-Challenge-2/tree/main Готовые фреймворки одобренные нашим сообществом https://github.com/langgenius/dify/ https://github.com/Marker-Inc-Korea/AutoRAG https://github.com/run-llama/llama_index https://github.com/mastra-ai/mastra Кейс red_mad_robot по RAG (DCD) для строительной компании (t-lite) https://habr.com/ru/companies/redmadrobot/articles/892882/ Серия про file first от Рефата https://t.me/nobilix/182 Классика (Запись эфира по RAGу без эмбеддингов) https://t.me/oestick/397 #RAG #best_rag_practice Сохраняй в избранное чтобы не потерять
Для любителей агентов завезли модель. 😎 Постарались nvidia и обучили Orchestrator-8B. Ссылка Hugging Face 🤗 https://huggingface.co/nvidia/Orchestrator-8B Тулколл включен. 💪


Огромная благодарность Александру Абрамову, руководителю AI / ML команд в кластере решений для b2c SberAI, за потрясающее выступление на вчерашнем вечере, посвященном теме “RAG системы: от экспериментов к полноценному индустриальному решению”. Саша поделился ценным практическим опытом внедрения RAG-систем в реальные продукты, а также дал множество полезных рекомендаций, связанных с трансформацией прототипов в реальные масштабируемые системы. Было крайне полезно и информативно 💪🏼 Отдельное спасибо всем присутствовавшим! Будем ждать снова, следите за анонсами.

вчера OpenAI дропнули ChatGPT Shopping Research😎 А это ведь еще один шаг на пути к shopping 3.0 который мы недавно обсуждали! 😎 Это режим deep research, но в контексте шопинга: агент читает описания, фильтрует шлак, смотрит цены, проверяет отзывы, задает уточняющие вопросы и собирает аргументированный shortlist ⌨️ Не так давно мне попался на глаза State of Fashion 2026 и сделали в OpenAI хорошо туда вписывается: 📌 23% потребителей уже используют AI для discovery новых продуктов Search Engine Journal, а 41% доверяют результатам AI-поиска больше, чем традиционной рекламе Search Engine Journal 📝 📌 Discovery переходит от Google в сторону LLM-агентов - брендам пора думать про AI-SEO, потому что присутствие в ответах AI-чатботов становится новой поисковой оптимизацией Bloomberg 🏃♀️ 📌 Agentic commerce будет ускоряться во второй половине десятилетия Bloomberg, и мы уже видим первые подвижки в эту сторону 🤯 Кроме того если посмотреть на других игроков на рынке: Perplexity подключает платежи на своей стороне, Shopify пушит Universal Cart, Meta тестирует conversational marketplace-агентов, и вот теперь openai делают шопинг рисерч 👍 Конечно, мы пока далеки от персонализированной покупки в один клик, но мы все ближе к тому моменту, когда e-commerce превратится в agent-commerce 😧 @neural_prosecco
А мы с Надей говорили, что рынок меняется, и агенты для шоппинга скоро станут обыденной вещью. Более того, сколько же времени это сэкономит, долой часы за подбором корзины покупок онлайн. 👇👇👇👇

Эволюционные стратегии - не sakana.ai едины. Вот и к ускорению факторизаций матриц приложили генетический алгоритм. А как мы знаем, все эти ваши сетки учатся, инференсятся в тч используя именно обращения матриц под капотом и это самые жЫрные операции по ёмкости. 💻 Интересно? Подробнее у коллеги по цеху тут. Оригинал тут. Код тут. Благодаря эволюционным стратегиям в будущем мы увидим ещё больше интересных работ. Там не ток факторизация, но ещё и супинг/мерджинг можно делать, а ещё на агентах моделировать алгоритм искусственных имунных систем для принятия решений и прочих штук. В общем, интересное, не зря Sakana.ai тоже туда копает. 🌿
LLM консилиум - или старые песни о society of mind в новой обертке. Карпаты идёт по стопам Мински и реализовал рабочую механику концепции society of mind. Писал об этом аж 2 года назад. 🥳 Меня, честно, все седня в лс замотали, мол смотри, тут вау новье. Дипы уже 2 года, как запилили, а у Карпаты просто ток руки до идеи дошли реализовать. Но хорошо, что есть ещё одна вариация кода и алгоса. Советую все ещё к прочтению базированную статью про клуб дебатов LLM. 🧑🎓 Алгоритм у Карпаты, кстати, напомнил "Покер оценку очков сложности тасок спринта" в agile. Кстати, а почему бы и не заделать такое на агентах, для вашего проекта в jira? 🧠 Дарю идею. 😎 А вообще, такие вот дебаты/консилиумы на агентах очень важный стрим на равне с эволюционными алгосами (о них позже). Советую всем интересующимся агентами почитать про теорию принятия решений, стратегии консенсуса и прочие темы с многокритериальным голосованием. Это база стратегий навигации и принятия решений для МАС и LLM. А если ещё в теорию игр залезите, вообще красавчики.
Тем временем, MCP продолжают улучшать, расширять и адаптировать под Ваши нужды. https://blog.modelcontextprotocol.io/posts/2025-11-21-mcp-apps/
Про разработку и AI-специалистов. Дядя открывает рубрику #холиварвыходногодня. На рынке найма сталкиваюсь с заблуждением, что MCP должны создавать MLE или DS спецы. На самом деле, это придумано на замену API, для более нативной интеграции LLM и агентов с сервисами, т.к. обычные стандартные API для этого не подходят AS IS. А их доработки всеравно приведут вас к MCP-like. И делать это должны не ML-only спецы, а бэкендр разработчики, пусть и совместно с MLE, но при необходимости. При этом же я вижу кругом евангелистов агентов, которые вчерашние swe и другие представители разработки, и это, на мой взгляд, не с проста. Действительно, агентные системы - это прикладной инструмент, который использует апи и AI-технологии вокруг, без необходимости знать детали работы LLM под капотом. Надо разделять разработку core технологий, которые ложатся в основу agents, и сами конструкторы агентных систем, для создания которых, с уже готовыми блоками в виде: библиотек, MCP, LLM - ds/MLE уже не нужны. Свою работу они сделали, дали то, на чем это строится в лице: моделей, алгоритмов рассуждения или принятия решений. Моя позиция в том, что MCP и агентные системы, как прикладные решения, удел вчерашних разработчиков, когда как технологии (модели, алгоритмы консенсуса и др) в основании этого под капотом, удел ML/DL спецов. Причём, обратите внимание, как агентные системы нативны с тч зрения алгоритмики и архитектуры построения, что делает их проектирование разрабами более удобным и нативным для этих спецов. Конечно, все кругом хотят единорогов, которых очень мало, да ещё они имеют биас - или они больше разрабы или больше математики, редко, когда они одинаково хороши в обоих местах. А что думаете вы? Пишите в комментариях. 👇👇👇👇