Жоский ИИ Дядя
Твой личный поставщик AI 🦾🤖
Канал о мире интересного AI: теория, приклад и meme👾
Для связи @dealer_ai
(реклама и консультации по AI для бизнеса).
Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст
РКН: 6348592885
Subscribers16.9K tracking since 24 Oct
Reach per post (ERR)27.2%4.6K avg views
Posting5.1/weeklast 5 days ago
Reactions per 1K views5.2🔥 ❤ 👍
edited
Мои львиные тигры и тигриные львухи на AIJ2025.
В этом году мы "повзрослели" и выпустили на AIJ соревнование по памяти для LLM.
Также на площадке можно увидеть наш постер на тему глобальной памяти для LLM и поговорить с ведущими разработчиками и исследователями моей команды (фото ребят прилагаю). А завтра будет еще и доклад про наши разработки в этой области.
Помимо этого, наша FRIDA стала эмбеддером для RAG системы проекта BRICS AI casebook platform, который сегодня также анонсировали на AIJ. 🌿😎🦾
Приходите в гости к нам и погружайтесь в мир путешествий с ИИ.
edited
Продолжаем роботему. UBtech robots произвели тысячи андроидов для помощи на производстве крупнейших автогигантов КНР. Видео впечатляет. 🤩
Сразу вспомнился мем (в закрепе).
edited
Мы живем в пору context engineering/management.
Вышел очень интересный обзор об 20-летней трансформации взаимодействия машины и человека для постановки задач.
Кстати полная версия у моего соседа по цеху тут.
Основной поинт, что постановка задачи через использование контекста моделей (по факту окна входа) стремилась к снижению энтропии и упорядочиванию входных данных. 🧠 В то время как, человек получает на вход множество модальностей данных, да еще и в разном качестве, машине мы стараемся передать эти наблюдения в другой форме. К примеру, вы учите бустинг, и обязательно проводите EDA, очистку данных, фиче инжиниринг и кормите итоговые плоские таблички для обучения. Потом появились seq2seq модели, а еще позже GenAI. Чем продвинутее становились архитектуры, тем меньше нужно было снижать энтропию входа. Сейчас мы можем в некотором виде подавать текст в модели или агентные системы, через промпт инжиниринг и контекстный менеджмент. В том числе, мы можем кормить и картинки и аудио и видео, используя дополнительные кодировщики.
Согласен, что это все ещё не данные as is, как видим и осязаем их мы, и энтропия по отношению к этому тоже снижена, но в идеале она будет стремиться к изначальному виду.
Авторы поднимают вопрос такого развития, что ИИ-технологии достигнут уровня сначала человека и смогут принимать окружающую информацию AS IS, воспринимая среду без трансформации, а потом, став еще продвинутее, будут менять среду и ее энтропию, упрощая ее, наоборот уже для человека. Такой вот реально большой оберегающий брат. Или не оберегающий. 🧠 Очень интересный взгляд.
А сейчас, по мнению авторов, мы живем в эру контекст менеджмента и инжиниринга. Если вам интересно об этом почитать, советую вот это репо. И действительно, все работы и решения основаны сейчас на том, чтобы наполнять контекст модели, ограниченый max token lens только нужной информацией, и не помещать или удалять от туда ненужную информацию. Отсюда, кстати, и концепция внешней памяти, и RAG темы, и FC/TC, присыпанные доп. инженерией очистки/умных ножниц ✂️ и сжатия/саммаризации только полезной информации для контекста 📊. Примером таких операций может быть:
1. Удаление рассуждений из видимого контекста модели после данного на их основе ответа.
2. Вырезка из контекста подсказок из RAG, memory и прочих данных, которые могут спутать модель, если их там оставить. Ведь никто не исключал протухания данных.
3. Написание функций сжатия и саммаризации, а также улучшения экстрактивных механизмов моделей для этого.
И многое другое...
Остается один момент, это вопрос того, что контекст инженерия снижает энтропию вспомогательно, а если путь к AGI - то нужны новые решения, которые не требуют инженерии вокруг или сводят ее к минимуму. Зачастую вопрос повышения энтропии входа коррелировал вообще с уровнем развития вычислительных технологий. Бывает так, что методология в теории есть, но техника не позволяла ее эффективно реализовать, а когда позволяет происходит переход на новый уровень развития. Но что это должно быть и будет? Поживем, увидим, у меня нет ответа на этот вопрос.
edited
- А ты точно настоящий?
- Да точно, зуб ногу даю! 😎
Ребятки из Xpeng motors показали, что их робот настоящий, срезав по колено обшивку ноги робота.
Тем временем, idol закрывали шторкой...
repost
Как прошёл Вайб Цех 😍
Ловите топовый клип про то как прошел наш митап!
+ Фото
+ Запись стрима!
Семь топовых спикеров из бигтеха, более 50 гостей в Цехе и 1600+ зрителей онлайн.
Подготовили для вас записи докладов в ВК и на YouTube (в самом конце фрагмент, который видели только гости офлайн площадки!)
Скачивайте презентации про то, как вайбкодинг меняет индустрию разработки🔗
Заполняйте форму обратной связи, чтобы мы становились лучше, а также ищите себя на фотографиях с митапа и погружайтесь в цеховую атмосферу в отчётном ролике.
Будем ждать вас на следующих митапах 😊
edited
Мое участие в митапе VibeЦех от red mad robot!
А вот и оно👇👇👇👇
editedad
Реклама, Perplexity, Amazon и ненависть.
Продолжаем тему монетизации рекламы в мире ИИ-агентов. Perplexity попал под каток Amazon из-за своих агентов, которые помогают покупать товары без посещения сайта самим юзером. Амазон в резкой форме обвиняет ребяток в том, что они нарушают правила платформы и используют агентов для совершения сделок от имени пользователя. 🛑
В ответ Perplexity направили иск об кибербуллинге. 🍿
А всему виной лишь то, что ecom гигант недополучает деньги с просмотров рекламы. Ну и до кучи поиск их мол не эффективно юзают и рекомендации. 🤣
Тем временем, сами ответчики в лице Perplexity заявляют, что мол ведь всем лучше от ии-агентов за покупками, тк число сделок и их скорость растет, а значит все в плюсе. А Дядя считает, что могли бы и бабки с Амазон за фиды брать. 🧠
edited
GigaMemory соревнование на AIJ contest 2025 завершилось.
Приватный лидерборд доступен. Поздравляем призеров и победителей и ждем всех Вас на AIJ2025. 📱
Нам было очень приятно и интересно готовить для Вас данный трек, увидимся в следующих сезонах. 👋
edited
Что, если вы попробовали BM25 и SPLADE – FM index+Infini-gram.
Эта статья стала best paper EMNLP2025.
Статья "Infini-gram mini: Exact n-gram Search at the Internet Scale with FM-Index" представляет собой исследование по созданию системы для точного поиска n-грамм в сверхбольших текстовых корпусах. Что такое n-граммный поиск? Это подход аля tfidf основанный на поиске совпадения в строках путем сравнение общих n-грамм токенов или символов. Статья может быть потенциально интересной для тех, кто строит RAG системы с учетом bm25 индексов и иных (аля SPLADE).
🎯 Постановка задачи
Языковые модели обучаются на огромных объемах текстовых данных из интернета, и важно понимать эти данные. Точный поиск по таким корпусам позволяет подсчитывать вхождения строк и находить исходные документы, но существующие системы не справляются с большими масштабами данных из-за высоких требований к хранилищу. Авторы ставят задачу создать эффективную и масштабируемую систему, которая сделает петабайтные текстовые корпуса доступными для поиска.
💡 Идея алгоритма
Основная идея алгоритма — использование FM-Index (Full Text Minute Index). Этот метод, созданный Феррагиной и Манзини, одновременно индексирует и сжимает текст. Алгоритм дает пользователю:
1. Эффективность: Infini-gram mini значительно улучшает существующие реализации FM-Index. Система создает индекс, размер которого составляет всего 44% от исходного корпуса.
2. Производительность:
- Скорость индексации повышается в 18 раз.
- Использование памяти в процессе индексации сокращается в 3.2 раза.
- Потребление памяти при выполнении запросов снижается до незначительного уровня.
Про Infini-gram, он работает принципиально иначе, чем традиционные языковые модели n-грамм. Вместо заранее вычисленных таблиц частот, он использует структуру данных суффиксный массив, что позволяет обрабатывать n-граммы практически неограниченной длины с низкой задержкой .
Ключевая инновация Infini-gram — это отказ от классических таблиц n-грамм в пользу суффиксного массива всего корпуса текстов.
В чем проблема традиционных n-грамм? Для больших n длин последовательности таблицы частот становятся астрономически большими. Например, для корпуса в 1.4 триллиона токенов 5-граммная таблица заняла бы около 28 ТБ, что делает модели с большим n невозможными.
Итого, зачем оно все нам? Недавно, мы видели, как можно использовать поиск встроенный в файловую систему для эффективной работы rag и памяти. Подход с Infiniti gram+fm index может быть полезен для агентных систем с памятью в качестве альтернативы поиска по большим массивам данных. Да, и все это помимо прямой задачи - фильтрации больших сетов.
edited
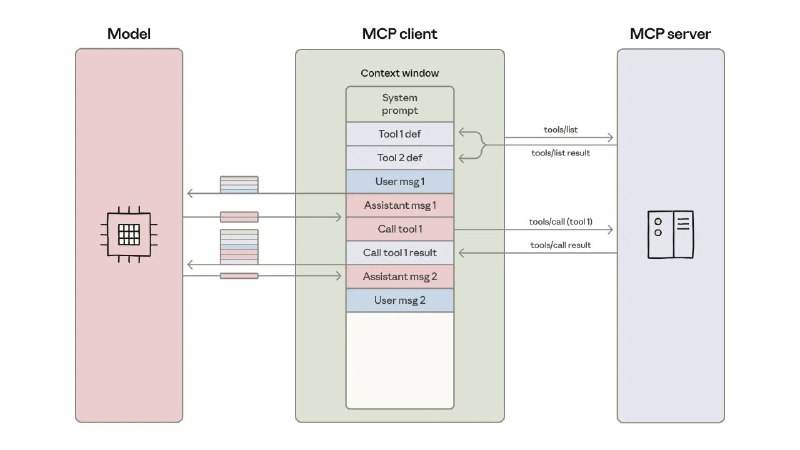
Code Exec with MCP, когда контекста мало всем.
У anthropic вышел небольшой такой постик про MCP и контекстный менеджмент для LLM. Сначала, думаю, из каждого утюга вон об этом пишут, не интересно. Но приходится дать свою точку зрения.
Итак, вся идея статьи, строится на фундаментальной проблеме - контекст LLM конечен. И к сожалению, не было бы это MCP, вы в любом ином месте живете и боритесь с этим. И не MCP такой плохой, хотя не без проблем, а именно костылим мы контекст. Да автор поднимает вопрос перехода от тонкого клиента, к части функционала на стороне mcp по удобному хранению и обработке данных, необходимых для исполнения задач. LLM принимает теперь функцию не моста по передаче/хранению данных+ризонера/планировщика, а только последнее. Таким образом, мы костылим ограничение контекста, переносом функций хранения в нем информации на клиент MCP. А могли бы, будь это не MCP, а условно memoryOS на файловую систему вашей ОС переложить или еще как удобно. Все.
При этом, автор статьи подчеркивает, что он поднимает проблематику и свое видение ее решения, но как это будет осуществленно формально, лежит на самих разработчиках, готовых рецептов нет. Не mcp плох, не антропики дурачки, а проблема базы над которой живут агенты и пр. - LLM и ее контекст. И туда же все ваши SO/constrained output, SGR и прочие изощрения.
Поэтому, дальше Вы сами.
repost
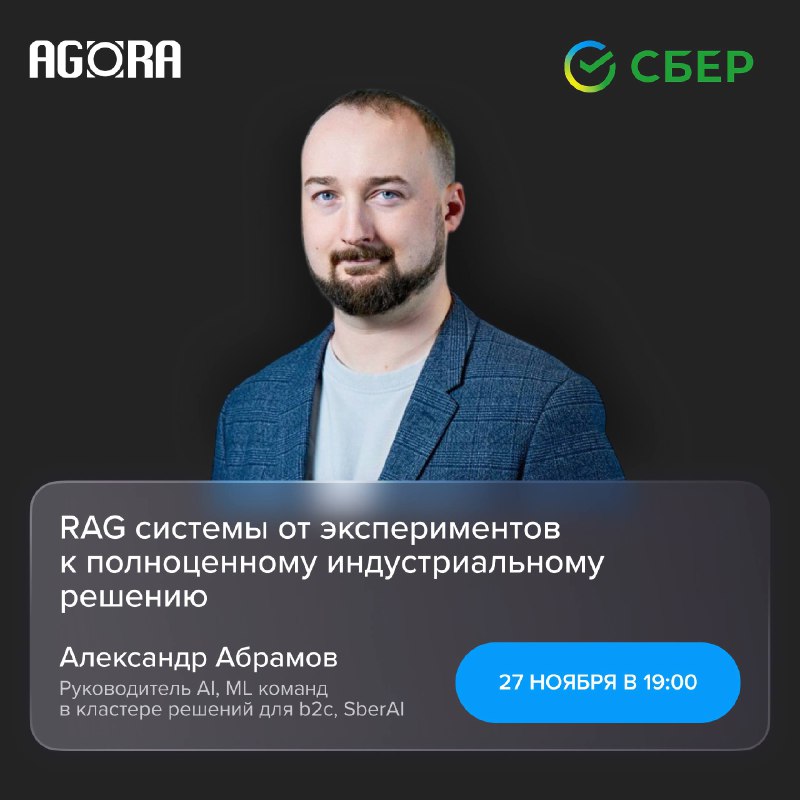
❗️Анонс. Приглашаем принять участие в эксклюзивном мероприятии на тему “RAG системы от экспериментов к полноценному индустриальному решению”, которое состоится 27 ноября в Москве.
Спикер: Александр Абрамов, руководитель AI / ML команд в кластере решений для b2c, SberAI.
С позиции одного из ведущих экспертов рынка в области AI Александр поделится ценным практическим опытом построения RAG-систем в реальных продуктах. Поговорим о базовых архитектурных решениях, метриках и тонких местах. Затронем тему оптимизации производительности и качества ответов, а также разберем, как превратить прототип в масштабируемую систему.
Детали события:
Дата: 27 ноября 2025
Время: 19:20 (сбор гостей начинается в 19:00)
Локация: ул. Рочдельская д. 15 с. 16 (Трехгорная мануфактура, пространство Геолофт).
📆 Добавить в календарь
🗺️ Схема проезда
edited
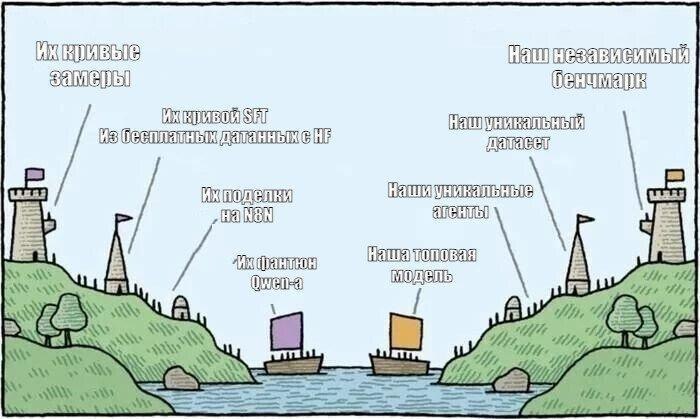
Так и живем
#meme от соседей по цеху
edited
Очень приятно, что Дядина прозорливость и видение потенциального применения mem-atents не только, как память для код ассистента, но и для диалогов в обычной жизни, сработала. Кого-то удалось заразить методологией, кто-то реализовал идею в жизни.
Ребята молодцы:
1. https://t.me/evilfreelancer/1452
2. https://t.me/neuraldeep/1710
Продолжаем посты, cookbooks для чтения на выходных.
У Microsoft вышел классный курс по малым моделям на конечных устройствах. Подписчики рекомендуют.
В целом, знаю много любителей моделек on-device, в свое время было очень популярно делать tflite формат + устройство, туда же потом влетел onnx и прочее.
В общем, приятного чтения. 😁
edited
Дорогие друзья, очень признателен Вам за помощь и поддержку. К сожалению, голосование было продлено до 5.11 и было бы кощунством Вас просить все также голосовать активно в эти длинные выходные.
Однако, для меня уже большое признание, что Вы поддержали меня: подписчики, товарищи и друзья из комьюнити ИИ-блогеров, такого единения давно не было. Спасибо Вам огромное, постараюсь не подвести Вас. ☺️😏
edited
Сэкономил – считай заработал. TOON форматы.
Мы в последнее время с памятью для LLM на fc/tc столкнулись с жёстким переполнением контекста. Начали резать описания, а тут подвернулась работа. Обещают срезать 40/60% объема.
Остаётся вопрос, насколько нативно оно работает as is на текущих LLM, и как следствие нужно ли доп.дотюнить под такое (скорее всего да)?
Кто-то уже пробовал? Пишите мысли в комментариях. 👇
edited
Cookbook от HF, как построить world level LLM.
А пока орги продлили голосовуху и всю эту суету 🥲до 5.11, почитаем cookbook от Huggingface 🤗. Как построить LLM мирового уровня, небольшой гайдик:
- Если ты не в курсе с чего начать, а оно вообще тебе надо?
- А в каком порядке идет pretrain, rl, sft, annealing?
- Что такое kv caching?
- А curriculum learning он зочем?
- Какие стратегии скейлинга по датке и gpu.
И многое другое, ты найдешь в данном небольшом руководстве на 200+ страниц 🤣, с формулами, картинками и графиками. Версия на сайте. Будет, что почитать на выходных. 🧑🎓
edited
Память или кошелек. Слухи о монетизации с чатами OpenAI.
Говорят, что OpenAI будет таргетировать контекстную рекламу на основе вашей истории переписок. Если вам оно не надо, ну будете жить без памяти чатов, всего-то. Для меня это ожидаемо, об этом я писал в серии постов: тут и тут. 💸