Навайбкодил новый плакатный конструктор.
В этот раз взял за основу приём Typographic Echo — многократное повторение типографики или изображения со смещением, масштабированием и другими геометрическими трансформациями.
Забавно звучит, но выбор идеи — это реально 50% работы. Почему? Потому что мало просто выбрать понравившийся визуальный стиль. Нужно понять, можно ли его масштабировать, получится ли сформулировать понятные не только тебе правила создания, какие параметры можно менять, а какие должны оставаться постоянными.
Всё как в классическом дизайне: работа начинается задолго до того, как вы открываете Figma.
Теперь немного о самом процессе.
1. Выбираем эффект.
Находим интересный визуальный приём и пытаемся понять, за счёт чего он работает, из каких элементов состоит и можно ли превратить его в систему, которая будет давать разнообразные, но предсказуемые результаты.
2. Вайбкодим.
Тут всё относительно просто. В ChatGPT теперь можно создавать интерактивные инструменты, не выходя из привычного интерфейса. Описываешь задачу, получаешь рабочий прототип и сразу видишь результат в окне превью. Не нужно самостоятельно писать код или разворачивать среду разработки.
Это самый долгий этап. Обычно требуется много правок и уточнений — как по мелочам, так и концептуальных. Проверяешь разные сценарии, находишь ограничения, меняешь логику работы.
Например, уже в процессе я понял, что этот эффект может круто работать не только с типографикой, но и с изображениями и видео. Так появилась дополнительная функциональность, которой изначально не было в планах.
3. Публикуем.
Когда всё готово, публикуем инструмент, проверяем, как он работает по публичной ссылке, и делимся с другими.
Вот, собственно, и весь процесс.
Дайте, пожалуйста, фидбек. Как вам сам конструктор? И главное, насколько интересными получаются результаты?
Ок, кажется большинство всё же за то чтобы такие задачки появлялись тут в канале.
В любом случае обещаю не кидать всё подряд, все задачки сам просматриваю на адекватность.
Этот клиент по NDA, но это кто-то из крупняков.
Задача на ИИ-ролик, хотят сделать одним кадром без ката. Тайминг хотят 30–60 секунд, но это кажется взято с потолка. Максимум что сейчас можно сделать одним кадром это 30 секунд которые позволяют делать Seedance и Kling 4.
В любом случае всё обсуждаемо.
По самой задаче, мне показалось, что всё вполне реализуемо.
Если заинтересовались пишите напрямую @kseniku или @anton_filonov
Telegram doesn't show this post on the web. Open it in Telegram to see it.
Всем привет!
Ко мне довольно часто приходят с задачками по ИИ для разных брендов, иногда довольно крупных, типа Сбера или Яндекса. Обычно, если я не беру заказ сам, я закидываю задачу в чаты моих прошедших курсов и воркшопов. Их сейчас около 15. И, конечно же, не все из них уже активны, кто-то давно отключил уведомления, кто-то просто вышел из чата.
Почему я не кидаю запрос в основной канал?
Как вы заметили, у меня на канале нет рекламы, хотя ко мне довольно часто приходят с запросом на рекламу. Но я понимаю, что каких-то заметных денег я на этом не заработаю, а раздражать свою аудиторию я не хочу.
Так вот, пару раз я закидывал вакансии от друзей, и, кажется, многие решили, что это реклама. Пошли отписки, эмодзи с какашками.
Так вот, есть вопрос.
Нужно ли сюда кидать такие задачки? Или сделать под них отдельный канал?
Сейчас работаю над большим проектом по брендингу и, конечно, изучаю рынок. Смотрю, что нового, какие приёмы набирают популярность. И трудно не заметить, что чуть ли не в каждом втором кейсе есть веб-конструктор элементов фирменного стиля.
По сути, это инструмент, который делают под конкретную айдентику или даже под один приём внутри неё.
Вот несколько примеров, которые мне понравились.
— Suprematika сделала для Numira генератор калейдоскопов. Просто и стильно. Кейс Numira
— CLEVER°FRANKE разработало инструмент для создания фирменных паттернов. Кейс большой, сам инструмент ищите в разделе The Tool. Кейс ADC
— Yufan Wang тоже сделал генератор паттернов для бренда Electric Twin. Кейс Electric Twin
Это три примера из моей презы для клиента. Всего их там больше пятнадцати. Кому интересно, могу ещё накидать.
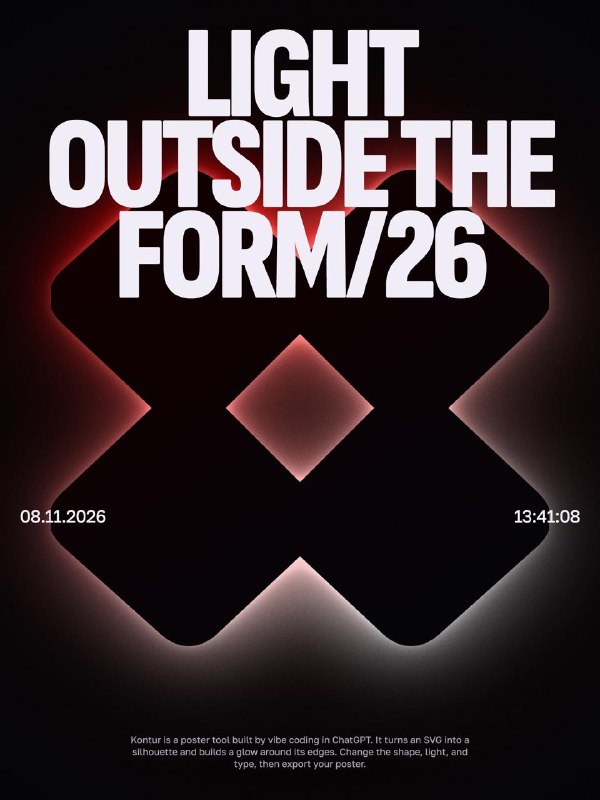
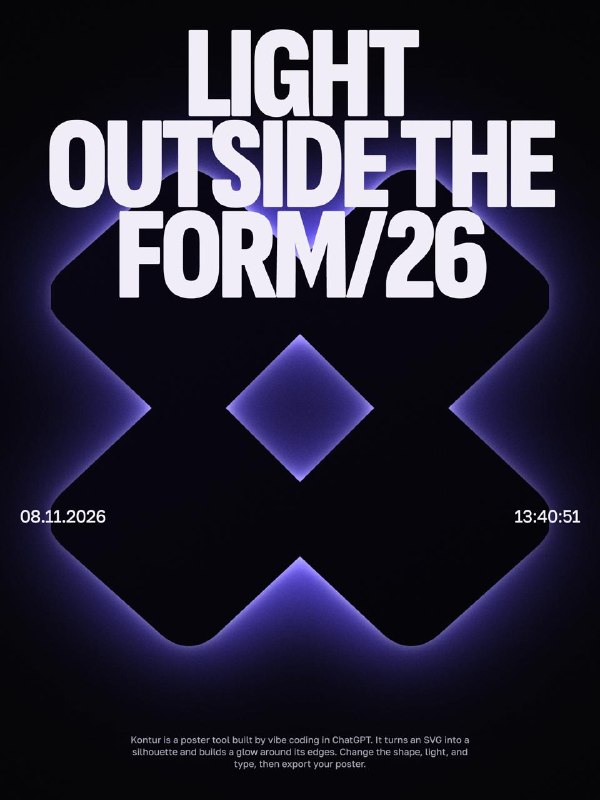
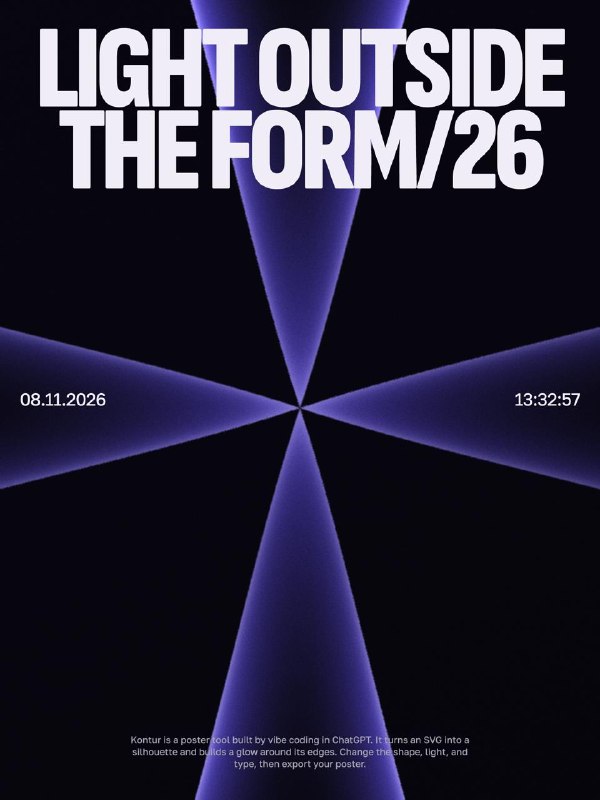
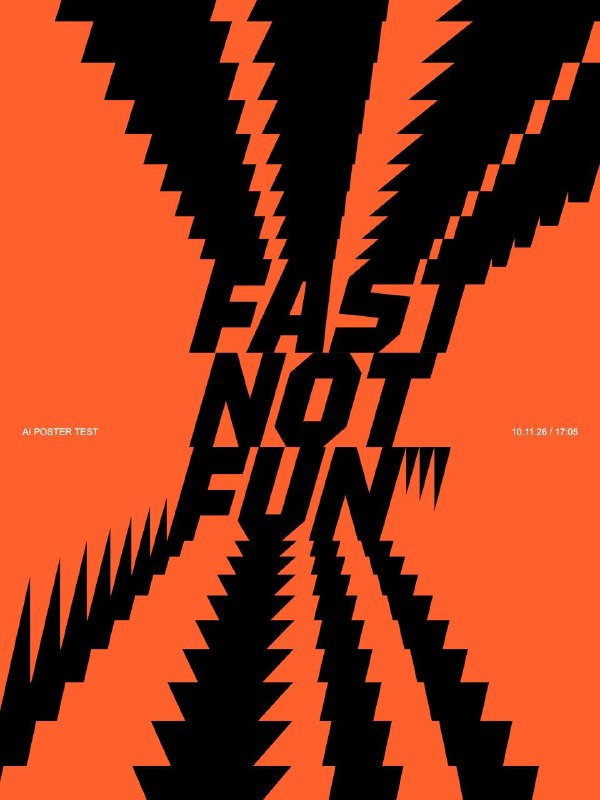
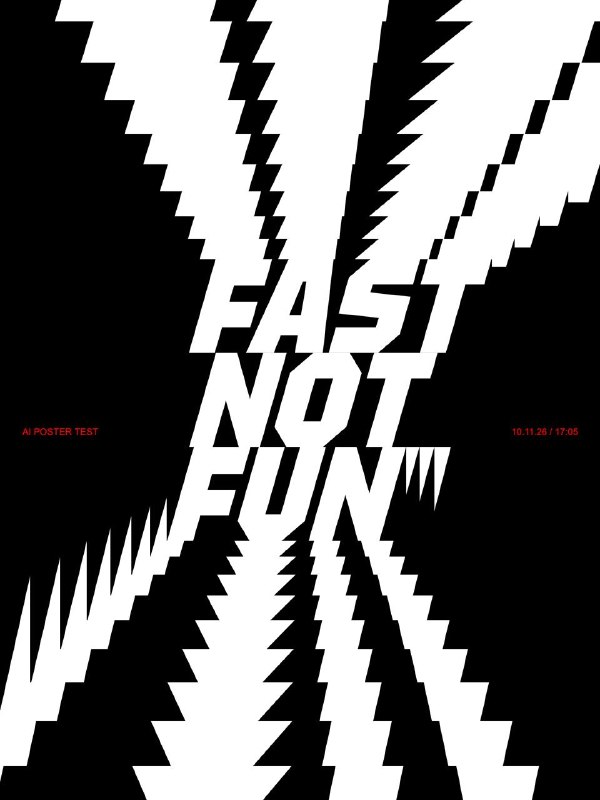
Я давно хочу попробовать такую штуку в коммерческом проекте. Пока он на ранней стадии, решил потренироваться и навайбкодить что-нибудь простое. Получился конструктор плакатов со своим стилем и набором правил. Собрал его буквально за вечер.
Можно поиграться тут → Kontur Poster Studio
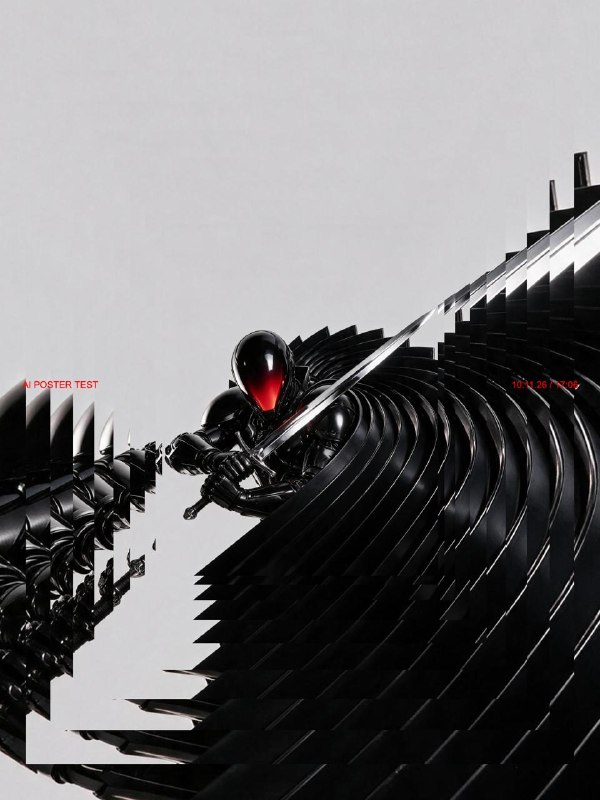
Внутри есть шаблоны, но можно загрузить и свой SVG, поменять текст. К посту прикрепил несколько плакатов, которые собрал в конструкторе.
Как делать такие штуки
1. Придумываем статичный плакат.
Для начала лучше взять простую композицию и один визуальный приём.
2. Показываем макет GPT и описываем правила.
Я бы написал примерно так. «Сделай веб-конструктор на основе этого плаката. Сохрани композицию и типографику. Дай возможность менять текст и загружать свой SVG».
3. Пробуем первую версию и правим по ходу.
Просим GPT что-то добавить, убрать или поправить, потом снова пробуем. Этот этап занимает больше всего времени. Итераций правок может быть прям много. Просто пишем их в том чате и просим переопубликовать проект. По моему опыту, лучше держать функционал простым и не нагружать его кучей функций.
Ещё несколько лет назад такие штуки были территорией довольно нишевого креативного кодинга. Сейчас рабочий инструмент можно собрать за вечер.
Я уже писал про питерский бренд Bat Norton, который очень грамотно использует ИИ.
Но захотелось узнать, кто стоит за этими визуалами.
Сейчас я готовлю материал про качественное использование ИИ брендами и дизайн-студиями.
В процессе нашёл Полину Киктеву — судя по её портфолио, она играет заметную роль в создании визуального контента Bat Norton, в том числе с использованием нейросетей.
Не уверен, что всё, что мы видим у бренда, — её работа. Но в портфолио достаточно проектов, чтобы оценить её подход.
У Полины незаслуженно маленькая аудитория. Мне кажется, нужно поддерживать крутых профессионалов, которые не множат слоп, а осмысленно встраивают ИИ в профессиональные процессы.
Поэтому делюсь ее аккаунтами:
— Instagram
— Behance
Посмотреть её работы точно стоит.
Повторю мысль, которую уже миллион раз везде проговаривал.
Нейросети дают невероятные возможности для реализации ваших идей, но сами по себе они идеи не придумывают.
А если вы попросите любую LLM что-то придумать, скорее всего, вы не обрадуетесь результату.
Тут на самом деле таится главная проблема очень многих так называемых ИИ-креаторов, ИИ-дизайнеров. Они в своей работе ставят ИИ на первое место, но это в корне неверно. На первом месте должен стоять дизайн, должен стоять креатив.
Ладно, к чему я это всё.
Искал, что посмотреть в ютубе под обед, и наткнулся на выпуск «Рефодушки» с Матвеем Медведевым — арт-директором «Сирены».
Топовейший контент про суть работы с графикой. Суперкомпактно, и всё по делу. Матвею дикий респект.
Всем, кто работает с визуалом, очень советую посмотреть.
https://www.youtube.com/watch?v=IC6i2I85-Mg
Несколько месяцев назад закончил интересный проект для Точка Банка, но из-за NDA не мог о нём рассказать.
Теперь разрешение получено, можно показывать.
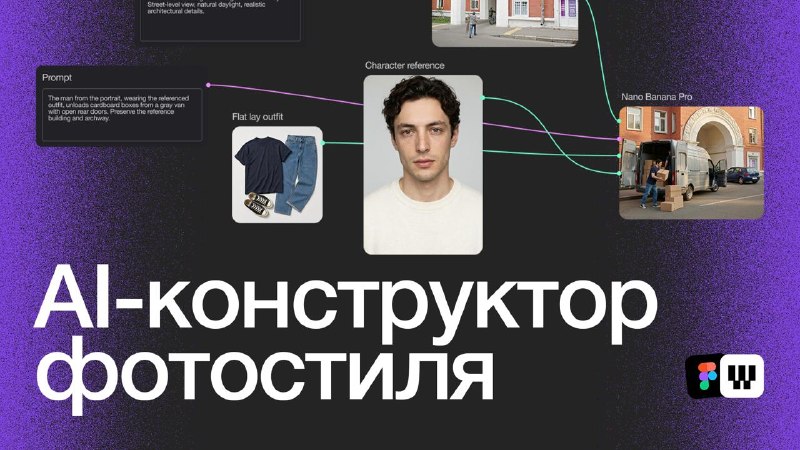
В середине лета ко мне обратился Юра Ветров, директор по дизайну Точка Банка, с запросом на создание ИИ-конструктора фотостиля. В своём посте Юра подробно рассказал о задаче в целом — почитать можно здесь. Я же хочу рассказать про свою часть: как собирал сам конструктор.
Задача была в том, чтобы дизайнеры могли менять отдельные элементы и получать новые изображения в рамках фотостиля банка. Помимо самого конструктора нужно было подготовить пакет изображений и записать обучающее видео для команды.
В качестве инструмента мы выбрали Figma Weave. Определили пять сюжетов на тему малого и среднего бизнеса: архитектурное бюро, маркетплейсы, перевозка грузов, недвижимость и ИТ-компания. Для каждого нужно было собрать свой пайплайн.
В Weave, помимо самих ИИ-моделей, есть много инструментов для работы с изображениями и текстом. И основная сложность была в том, чтобы найти оптимальную связку нод: достаточно гибкую для разных сюжетов и при этом понятную дизайнеру, который впервые откроет этот пайплайн.
То есть мало самому разобраться, как получить нужный результат. Нужно ещё сделать так, чтобы человек без твоего участия понял, где поменять одежду, где описать персонажа, а где задать сюжет.
К итоговой структуре пришли не с первого раза. Юра несколько раз уточнял запрос, мы пробовали разные связки и постепенно упрощали конструкцию. В итоге решение получилось довольно консервативным: разбили пайплайн на понятные группы, внутри которых каждая нода отвечает за свою часть работы.
Сами модели вполне привычные: Nano Banana Pro и GPT Image для генерации изображений, GPT — для написания промптов. Самое интересное здесь как раз в том, как они связаны между собой.
В общем, словами всё это объяснять довольно неудобно, поэтому я записал видео: показываю конструктор, рассказываю, что за что отвечает и как всё работает.
Буду рад вашему фидбэку. Если собираете что-то подобное для своих задач, тоже поделитесь — с удовольствием посмотрю.
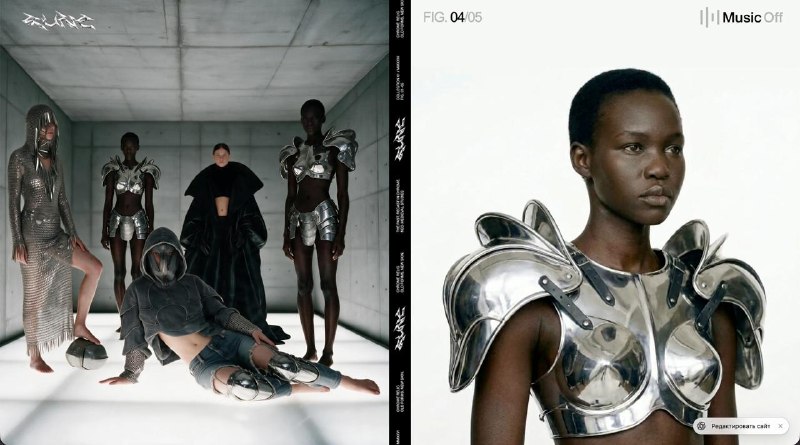
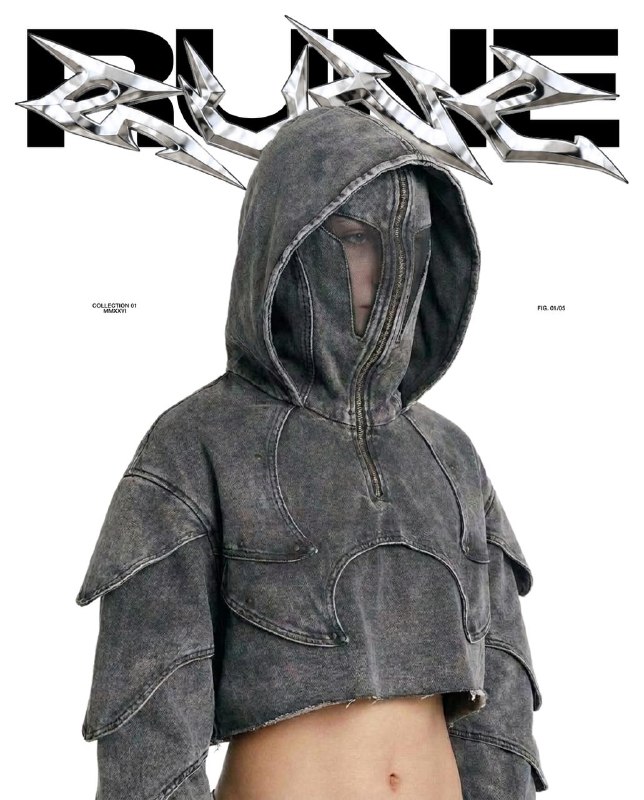
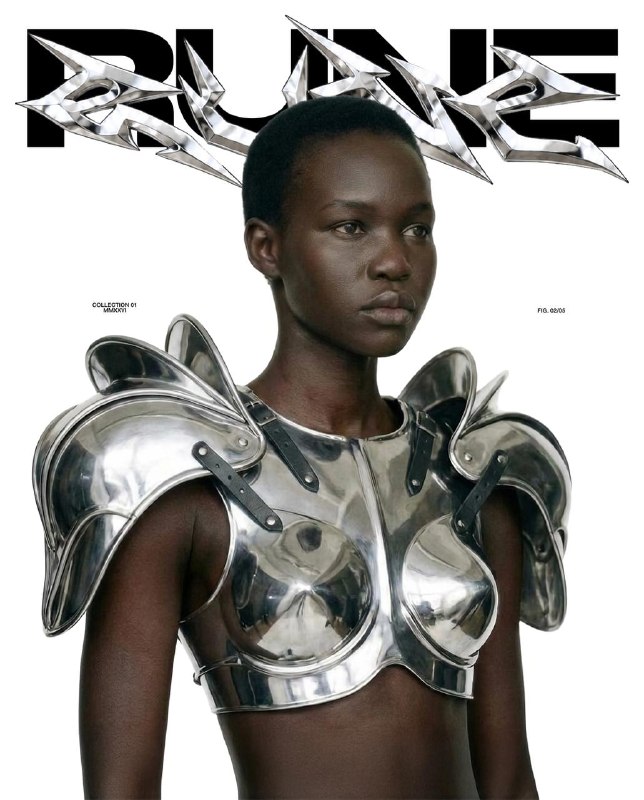
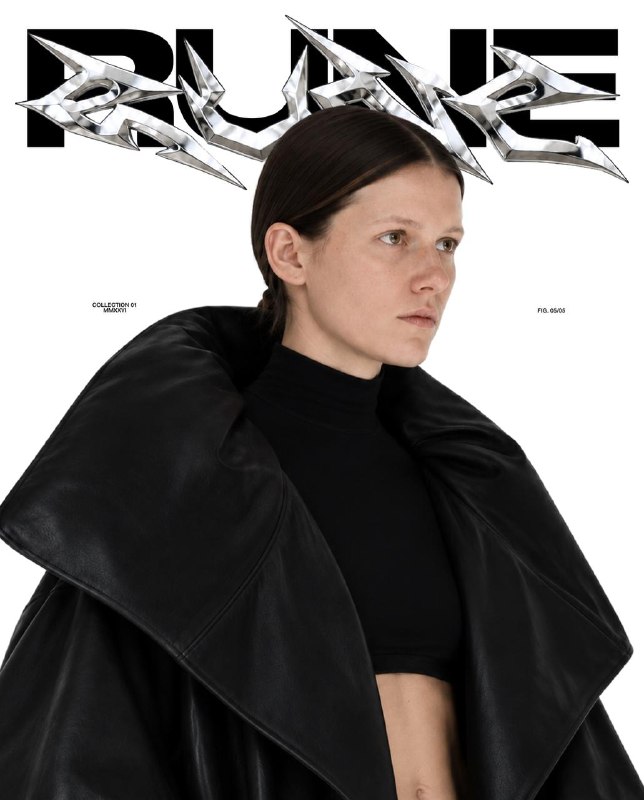
Хромированные доспехи, фэшн и экран выбора персонажа. Собрал всё это в работающий веб-интерфейс — с помощью нейросетей и вайбкодинга.
Посмотреть можно тут👇
https://rune-chrome-relic.malevanik.chatgpt.site/
Проект называется RUNE. Я начал его на втором потоке воркшопа «Метод источника», где мы исследовали эстетику Future Medieval. Как и всегда, работал вместе со студентами, а себе заранее поставил задачу: пройти путь от визуального концепта до интерфейса, с которым можно взаимодействовать.
По задумке это экран выбора персонажа для условного фэшн-проекта. Хотелось сохранить узнаваемые элементы Средневековья, но поместить их в непривычную среду. Деликатно, без слишком прямолинейных отсылок.
Графики добавил немного. Типографику хотелось сделать нарочито панковской и грубой — отсюда наложение слоёв в плакатах и хромированный леттеринг. Даже логотип RUNE сгенерирован.
Интерфейс собирал с помощью Codex от OpenAI. Честно говоря, удивился, насколько доступным оказался сам процесс. Доработок при этом было достаточно: около 30 итераций за три дня. Занимался этим в промежутках между основными задачами: запускал генерацию, переключался на другую работу, возвращался к результату и вносил правки.
Интерфейс получился простым, но мне нравится, как он выглядит и работает. Получился и тот визуальный образ, к которому я стремился. Для меня было важно соединить в одном проекте разработку концепта, генерацию изображений и видео и вайбкодинг.
Конечно, мы уже много раз слышали, как ИИ меняет профессию, как расширяются границы мультидисциплинарности и как один человек теперь может заменить целую команду. У последнего тезиса хватает обоснованной критики, с которой я, кстати, согласен.
Но когда сам проходишь весь этот путь, даже в рамках личного сайд-проекта, масштаб перемен ощущается совсем иначе. Ты своими руками делаешь то, для чего раньше пришлось бы искать людей с разными навыками. И понимаешь: мир уже изменился. Спорить с этим просто глупо.
Kling 4.0 жёстко меня подставил.
Ещё с начала лета я готовлю гайд по нейросетям. Вернее, небольшой учебник по основам работы с существующими ИИ и моему подходу к ним.
Часть про статику давно готова, а раздел про создание видео был готов наполовину. Собственно, это была часть про Kling.
Но представьте моё разочарование, когда я зашёл посмотреть обновление Kling 4.0 и увидел, что логика работы с сервисом полностью поменялась. Kling пошёл в сторону Seedance: единое окно ввода с полем для промпта и референсами. Никаких больше первого и последнего кадра — просто закидываешь картинки и в промпте указываешь, что и где должно работать.
На самом деле это понятный эволюционный шаг. Но для меня он означает полную пересборку этой части гайда.
Ну ок. Зато контент будет максимально актуальным и свежим.
Что касается самой новой модели, я пока не увидел ничего принципиально нового. Качество картинки как будто осталось прежним. Интерфейс стал проще — да. Длительность видео увеличилась до 30 секунд, но это как будто уже индустриальный стандарт. Рядом с разрешением 4K пока написано Coming soon. Это, конечно, плюс. Но, по моим ощущениям, сейчас 80% всего, что генерируется с помощью ИИ, создаётся для соцсетей, где такое разрешение не нужно. А для других задач всегда есть апскейлеры.
Но посмотрим. Может, я пока чего-то не увидел. Ещё потестирую.
Кто-то уже покрутил Kling 4.0?
Как вам?
edited
Через год мы не узнаем свою профессию?
Пару месяцев назад записывал несколько лекций по ИИ для Школы дизайна ВШЭ. Вместе с образовательным контентом мы сделали такой быстрый блиц.
Отвечая тогда на вопросы, я достаточно дежурно сказал, что нейросети меняют профессию, но пока непонятно, куда это приведёт, посмотрим и всё такое.Прошло всего два месяца, и я всё отчётливее вижу изменения вокруг себя.
Все команды, с которыми я работаю или просто общаюсь, сейчас в процессе адаптации и перехода на ИИ — частично или полностью.Общаюсь со многими дизайн-командами и слышу о проектах с использованием ИИ, которые пока находятся в разработке и ещё не представлены публично. Многие знакомые рассказывают и об изменениях в составе команд: людей увольняют, сокращают, часть их работы передают ИИ.
Я по-прежнему не знаю, куда нас это всё приведёт. Но я точно вижу, что от гипотетической ИИ-трансформации мы уже перешли к активному внедрению инструментов и агентов ИИ.Кажется, через год мы просто не узнаем нашу профессию.
Как у вас дела с ИИ? Что происходит в ваших командах? Поделитесь.
26 человек из 54 поговорили с ИИ по видеосвязи и решили, что на другом конце живой человек.
Вот от такой новости мне уже немного не по себе.
Посмотрите видео на сайте, очень рекомендую.
Компания Tavus представила Griffin — модель, которая видит и слышит собеседника, отвечает голосом и генерирует свою внешность и движения в реальном времени. Пока ты говоришь, она может кивать, вставлять «угу», реагировать на то, что ты показываешь в камеру. Если перебить — остановится. Всё это складывается в ощущение живого разговора.
Tavus провела эксперимент: участникам сказали, что они будут разговаривать с другим человеком, а на деле их собеседником была Griffin-Lite. Звонок длился всего минуту, после чего их спросили, считают ли они собеседника человеком. 26 человек из 54 сказали, что да, это был человек.
Я в принципе давно в шоке от голосовой модели GPT, особенно в сравнении с Алисой от Яндекса. Но тут не голосовая модель, тут полностью интерактивный собеседник и, главное, видео, реагирующее на всё, что происходит вокруг, в реальном времени!!
Мы привыкли, что видеозвонок помогает проверить собеседника: вот лицо, вот голос, человек слышит меня и отвечает на мои вопросы. Кажется, скоро этот способ не будет гарантировать ничего.
И у меня, конечно, много опасений, связанных с этой технологией. В первую очередь в отношении пожилых людей, детей, да и просто тех, кто не особо в теме. Сколько мошенничества можно на этом построить?
Мне как дизайнеру, конечно, интересно наблюдать за развитием всего этого. Но при этом мне реально жутковато.
Griffin пока доступна только выбранным тестировщикам.
Готовлюсь к воркшопу и пытаюсь ответить себе и студентам на суперактуальный вопрос:
что делать с видео при такой дикой стоимости Seedance 2.5?
Чем пользоваться?
Перепробовал кучу видеомоделей на одном и том же сюжете. И в итоге пришёл к тому, что лучший компромисс — это по-прежнему Kling 3.0. Вот так вот банально. Kling по-прежнему справляется, хотя по сравнению с другими моделями несколько мылит картинку. Но физика движения и даже фреймрейт вполне приемлемые.
Второй вариант — новый для меня Seedance 2.0 mini. Не юзал его раньше. Выдаёт только 720p и ролики на 15 секунд, но зато стоит более чем в два раза дешевле обычного 2.0. Если получается ок, потом можно просто апскейлить до 1080p.
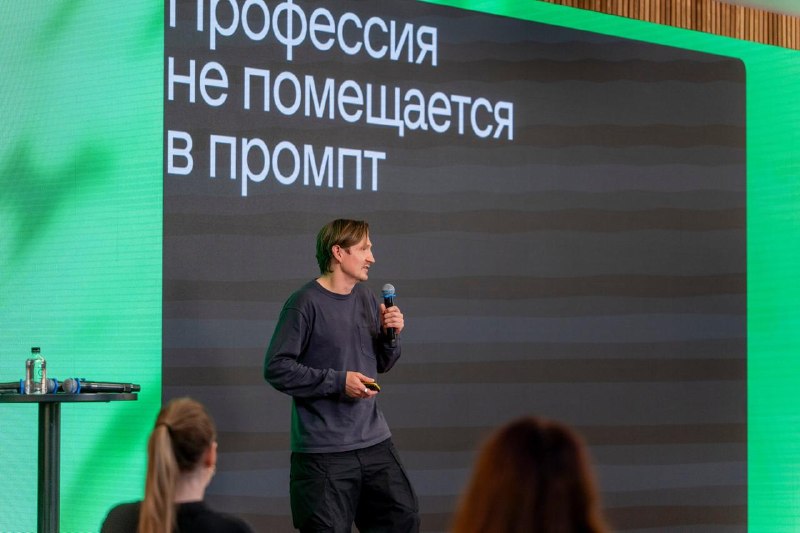
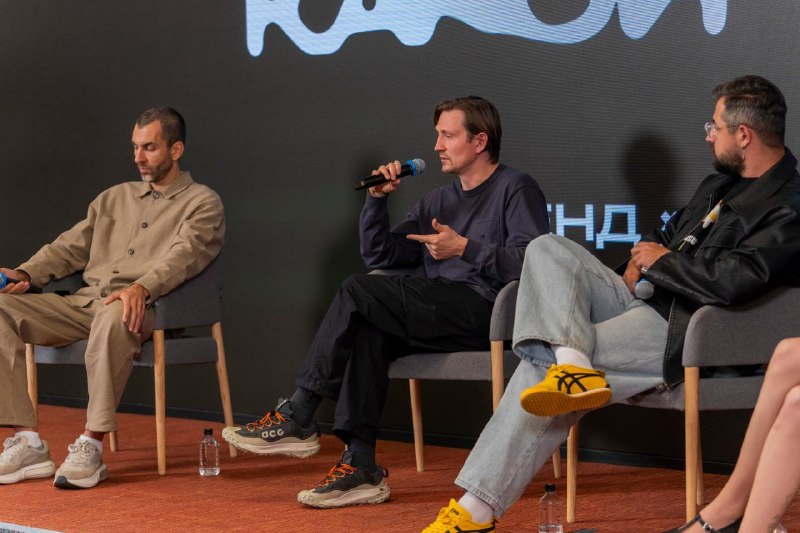
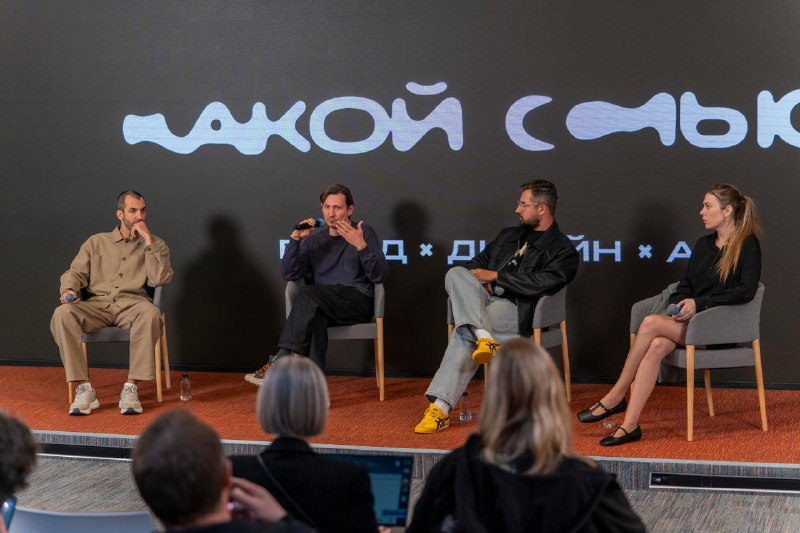
На этой неделе залетел на конфу «Какой смысл» от Сбера.
Конфа про дизайн, брендинг и, конечно, ИИ.
Здорово было высунуть нос из онлайна, посмотреть на живых людей и послушать спикеров.
Сам я рассказал про свой взгляд на перемены в профессии дизайнера и страхи по поводу того, что ИИ нас заменит. Показал пару своих кейсов.
Запись можно посмотреть здесь.
Но самое ценное для меня было — обсудить с коллегами за круглым столом тему влияния ИИ на профессию. Убедился, что смотрю на эти вещи правильно и многие разделяют мою точку зрения. ИИ не заменяет дизайнера, ИИ меняет профессию дизайнера. И учить работе с ИИ нужно через практические дизайн-кейсы, где ИИ не становится самоцелью, а становится важной частью процесса.
Именно это мы и делаем на воркшопе «Метод источника», который стартует уже в понедельник.
Места ещё есть, присоединиться можно вплоть до старта → https://aifordesign.ru/
edited
Запись вчерашнего вебинара-анонса
https://disk.yandex.ru/i/T470C3UdoB7qBQ
и ссылка на оплату и доступ к воркшопу.
https://aifordesign.ru/
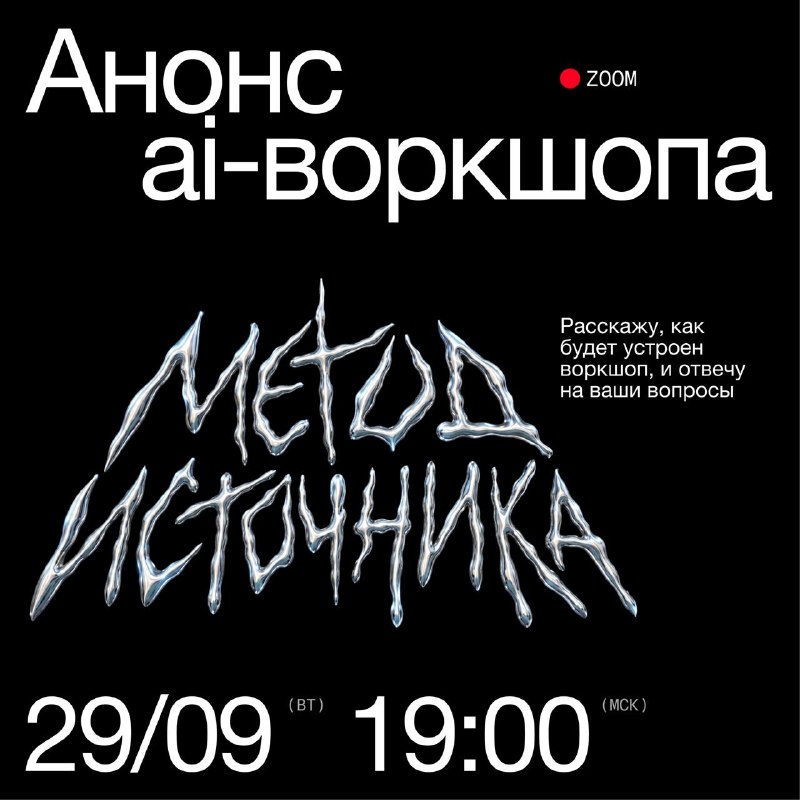
Через 10 мин стартуем. Анонс воркшопа «метод источника»
edited
Сcылка на сегодняшний вебинар в 19:00.
Андрей Малеваник приглашает вас на запланированную конференцию: Zoom.
Тема: Анонс второго потока воркшопа «метод источника» 05—16.10
Время: 29 сент. 2026 07:00 PM Москва
Присоединиться к конференции Zoom
https://us06web.zoom.us/j/88327850536?pwd=nzjmBObqvM5ssftuyQg31myoDnt9Ps.1
Подключиться (с заметками)
https://us06web.zoom.us/j/88327850536?pwd=nzjmBObqvM5ssftuyQg31myoDnt9Ps.1&mynotes=on
Ссылка на чат конференции
https://us06web.zoom.us/launch/jc/88327850536
Идентификатор конференции: 883 2785 0536
Код доступа: 539805
---
Одно касание на мобильном телефоне
+13092053325,,88327850536#,,,,*539805# Соединенные Штаты Америки
+13126266799,,88327850536#,,,,*539805# Соединенные Штаты Америки (Chicago)
---
Подключитесь через SIP
• 88327850536@zoomcrc.com
Инструкции по подключению
https://us06web.zoom.us/meetings/88327850536/invitations?signature=vpAu2a6_m2Pnf-5jWI-d_2NMDowQQa-3Etrl87mOW-E
Всем привет!
Напоминаю про завтрашний вебинар в 19:00.
Расскажу про предстоящий воркшоп: что будем делать, как всё устроено и кому это может быть полезно.
Сам воркшоп пройдёт 5, 9 и 16 октября.
Приходите — покажу примеры, расскажу детали и отвечу на вопросы.
Ссылка на Zoom появится завтра тут, в канале.
Месяц тестировал Seedance 2.5. Вот что получилось.
Я гонял модель в Krea, Dreamina и Figma Weave. По моим тестам, возможности, качество генераций и стоимость везде примерно одинаковые. Больше всего времени провёл в Krea: после оплаты годового тарифа там дали месяц бесплатных генераций Seedance 2.5. Очередей не было, результат обычно приходил за 5–10 минут.
Krea по-прежнему у меня в топе. Честный, качественный сервис, а не помойка типа Higgsfield.
Пробовал генерировать с референсами и без, делал ролики в разных жанрах. С референсами результат заметно лучше. Сильнее всего модель проявила себя (предсказуемо)
в фотореализме и кинематографичных сценах
Плюсы:
1. 30 секунд за одну генерацию. Это правда большое преимущество. Если сцене нужно развиваться, больше не приходится обрывать её каждые 10–15 секунд и собирать продолжение из отдельных кусков. Можно дать камере время на движение, а действию — на развитие.
2. Работа с референсами. Через @ можно указать, какая именно картинка относится к конкретной части промпта. Допустим, у вас десять изображений для разных этапов ролика. Можно прямо расписать, какое изображение использовать в каждой сцене, а не надеяться, что модель разберётся сама. Всего Seedance 2.5 поддерживает до 50 референсов: 30 изображений, 10 видео и 10 аудиофайлов.
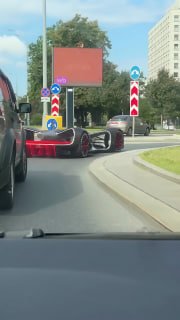
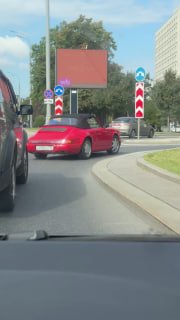
3. Редактирование готового видео. Можно попросить заменить конкретный объект, сохранив остальную сцену. По ощущению, это что-то вроде Nano Banana для видео. К посту прикрепил два примера: в исходной съёмке стоит Porsche 911, а в генерации на его месте появляется концепт Robocar дизайнера Дэниела Саймона. Камера, окружение и движение остаются без изменений.
4. Умение достраивать сцену. Даже если для какой-то части эпизода нет отдельного референса, модель часто справляется сама. При смене ракурса лицо персонажа и другие детали не разваливаются при первой же возможности. Не всегда, конечно, но результат уже вполне рабочий.
5. ИИ-рендер. Делаем простую 3D-анимацию: объекты могут быть буквально кубиками и шариками. Затем объясняем в промпте, что есть что, и просим модель отрендерить сцену. Пример с кораблёмё приложил к посту.
6. Саунд-дизайн. Его стоит пробовать генерировать сразу вместе с видео. Seedance делает это неплохо, а ручная озвучка каждого движения, удара и фонового шума всегда съедает очень много времени на постпродакшене.
Минусы:
1. Цена. В Krea генерация одного 30-секундного фрагмента стоит 12 600 токенов — примерно $22. При том что месячная подписка стоит $35. Это как бы жесть, потому что вероятность получить нужный результат с первой попытки крайне мала. По моему опыту, на одну сцену уходит 3–5 генераций. То есть уже $66–110 за фрагмент, который вы в итоге используете. Это к вопросу о том, сколько должна стоить ИИ-анимация в 2026 году.
2. Ошибки в сложных сценах. Физика по прежнему может вести себя странно, а модель — придумывать детали, которых не было в исходниках и которые никто не просил добавлять в промпте. По моим тестам, это работает заметно лучше, чем в условном Kling, но до контроля реальной съёмки или 3D-анимации ещё далеко. Если критично сохранить каждый объект и точную геометрию сцены, придется погенерить много раз, уточняя в промпте проблемые места.
3. Мультипликация. Из жанров, которые я пробовал, здесь результат понравился мне меньше всего. Фотореализм и кинематографичные сцены у модели получаются гораздо увереннее.
4. Музыка. Seedance может сгенерировать её вместе с видео, но до уровня Suno ей далеко. Мне проще подобрать трек потом и положить его на монтаже. Со звуковыми эффектами ситуация обратная: их я как раз стал чаще генерировать сразу.
Что делать с ценой?
1. Не генерировать всё по 30 секунд. Тут зависит от сюжета. Иногда можно сделать несколько коротких фрагментов и собрать их на монтаже. Сам факт, что модель умеет выдавать 30 секунд, ещё не значит, что каждый раз нужно платить за полную длину.
2. Использовать Seedance 2.0. Она тоже норм. Максимум — 15 секунд, зато обходится значительно дешевле. Для части задач этого вполне достаточно.
Продолжение в коментариях 👇
Анонс!
С 5 по 16 октября пройдёт второй поток воркшопа «Метод источника».
Первый поток прошёл в июле, и я очень доволен результатами. О том, что получилось у участников, можно почитать здесь и здесь.
Как и в первый раз, я буду работать вместе со студентами. Мы будем показывать и обсуждать промежуточные результаты друг друга.
У каждого потока своя тема. Если в июле мы исследовали стиль Y2K, то теперь будем работать с Future Medieval — футуристическим Средневековьем.
В этот раз я хочу уделить чуть больше внимания визуальному исследованию в начале работы. Я всё больше убеждаюсь, что при работе с ИИ идея и концепция — самое главное.
Конечно, будут и технические навыки. Помимо стандартного набора, я расширю блоки по работе с Midjourney и Seedance 2.5. Но в основе воркшопа по-прежнему лежит метод источника, которым я сам постоянно пользуюсь.
Это не воркшоп по нейросетям в чистом виде. Мне хочется сделать мастерскую и дизайн-лабораторию, где мы будем создавать концепции в рамках заданной темы.
Будет много графического дизайна, моушна, саунд-дизайна, браузерных инструментов, постпродакшена и моего арт-дирекшена. Покажу свои рабочие файлы и поделюсь приёмами, которые использую сам.
Воркшоп состоит из трёх встреч: 5, 9 и 16 октября.
Приходите на вебинар 29 сентября, во вторник, в 19:00 — я подробно всё расскажу.
Ссылку опубликую позже здесь, в канале.
Для тех, кто уже готов присоединиться — вот ссылка на оплату.


 +6