TokenOps: как управлять бюджетом всего AI-agent run (Рубрика #AI4SDLC) Недавно я писал, почему token burn полезен как финансовая телеметрия, но опасен как доказательство ценности. В 21-минутном докладе «FinOps for AI Agents: Who Spent All the Tokens?» два инженера Microsoft, Tisha Chawla и Susheem Koul, заходят с другой стороны: если стоимость всё-таки нужно контролировать, как делать это во время работы агента, а не после счёта от провайдера? Их ответ — TokenOps, ранний open-source prototype и reference architecture, а не продукт Microsoft или Azure. Главный тезис мне кажется правильным: единицей управления должен быть весь run, а не отдельный LLM-запрос. Одна агентная задача проходит через модели, tools и subagents; обычный per-request лимит видит фрагменты, но теряет общую стоимость и причинность. TokenOps добавляет к исполнению несколько вещей: - Единый run_id проходит через model и tool calls, а расходы складываются в общий ledger; - Бюджеты и policies назначаются сегментам: пользователю, команде, workload или типу запуска; - Control plane возвращает одно из решений: ALLOW, STEER или HALT; - Preview mode сначала показывает, какие правила сработали бы, но ничего не ломает. Самая интересная идея здесь — по возможности STEER before HALT. Жёсткий стоп сохраняет бюджет, но уничтожает уже почти готовый результат. Поэтому систему предлагают корректировать раньше: сократить число RAG-chunks, ограничить tool output, сжать контекст, попросить модель отвечать короче или остановить бесполезный loop. В демонстрации retrieval вернул 20 фрагментов, хотя полезны были первые пять: governor может оставить пять ещё до следующего дорогого вызова модели. Это не магия поверх шлюзов. Приложение нужно инструментировать: размечать границы и оборачивать вызовы, чтобы control plane видел структуру run. Зато решение о политике остаётся снаружи бизнес-логики, а исполняется там, где ещё можно изменить траекторию агента. Авторы показывают и собственный benchmark на Browser Use и MetaGPT: сумма spend по 27 scored trials снизилась с $1.839 до $0.388, то есть на 78.9%, а число успешных запусков внутри бюджета выросло с 18/27 до 26/27. Но это пока иллюстрация PoC, а не доказанный production ROI: сценариев всего три, они специально подобраны для демонстрации ловушек, независимой репликации нет. Есть и несостыковка: в устном рассказе baseline назван простым throttling, а статья и таблица сравнивают TokenOps с vanilla/ungoverned запуском. Поэтому здесь важнее направление эффекта, чем красивый процент. И ещё одна граница. Доклад начинается с перехода от token maxing к value maxing, но value-aware слой авторы пока не построили. Текущая система дисциплинирует стоимость; «задача завершилась внутри бюджета» ещё не означает, что ответ верный или полезный. Следующий взрослый шаг — связывать такой ledger с evals, риском и rework и считать cost per accepted task. Я бы рекомендовал запись платформенным командам, которые уже запускают агентов в production. Не как готовый продукт, а как архитектурный checklist: стабильный run_id, прозрачная атрибуция, per-run budget, preview policies, ранний steering и hard stop только последним рубежом. #AI4SDLC #AI #Agents #FinOps #Engineering #PlatformEngineering

Книжный куб
Канал Александра Поломодова (@apolomodov), cto & technical fellow. https://polomodov.tech - сайт со всеми материалами youtube.com/@tellmeabouttech - канал со всеми видео
-
-
Материалы 3 AImigo S1E4: AI нанимает AI. Как пересобрать IT-собеседования? (Рубрика #AI) Готовы материалы четвёртого выпуска 3 AImigo, который вышел 4 сентября. Вместе с Евгением Сергеевым и Алексеем Литвиновым (@tip_podcast) мы разбирали довольно неудобную конструкцию: AI уже сидит по обе стороны собеседования, а сам процесс всё ещё пытается измерять кандидата линейкой из мира до агентов. Запретить AI на интервью кажется простым решением, но оно проверяет человека в среде, не похожей на будущую работу. Разрешить AI и засчитать красивый результат — тоже слабый фильтр. Поэтому главный вопрос выпуска не «можно ли пользоваться агентом», а «какие сигналы действительно предсказывают работу в конкретной роли». Обсудили: - Почему привычная воронка из резюме, кодинга, систем-дизайна и поведенческих вопросов всё хуже отделяет инженерную способность от умения готовиться к интервью; - Как пересобрать найм как eval-систему: сначала описать результат роли и нужные признаки, а затем проверить, что каждый этап измеряет именно их; - Зачем разделять AI-off и AI-on части. Без AI — смотреть на фундамент и самостоятельное рассуждение; с AI — на постановку задачи, сбор контекста, выбор процесса, проверку ответа и ответственность за результат; - Как превратить систем-дизайн из рисунка на доске в задачу в песочнице: развернуть сервис, дать нагрузку, найти заложенный сбой и защитить решение. Но здесь остаётся трудная часть — калибровка интервьюеров и признание корректных нестандартных решений; - Почему product, platform и R&D-инженерам нельзя механически выдавать одинаковые пороги: домен, неопределённость и цена компромисса у них различаются; - Что меняется для кандидата, когда узкая специализация дешевеет, а поиск работы становится отдельным проектом — с исследованием компаний, собственной воронкой, адаптацией резюме, сетью контактов и внутренней мобильностью. При этом AI может помочь обеим сторонам сузить выбор, но культуру, доверие и финальное обязательство по-прежнему сверяют люди. Автоматизировать подбор — ещё не значит автоматизировать решение о совместной работе. Все материалы выпуска: - Страница выпуска: содержание, таймлайн и все форматы - Видео: YouTube, VK Видео - Аудио: Podster, Яндекс Музыка, Apple Podcasts - Текст: русский конспект Если вы нанимали или сами проходили собеседование с AI, расскажите: какой этап дал реальный сигнал, а какой просто проверил умение пройти интервью? #AI #AI4SDLC #Engineering #Management #Evals #Interview #Podcast
-
Code of Leadership S2E19: Первые 90 дней CTO (Рубрика #Management) В среду в 11:00 расскажу в прямом эфире про первые 90 дней технического директора. Начну с небольшого переворота: первый рабочий день — уже середина перехода. В докладе разберу весь маршрут: - Как выбирать задачу, а не красивый шилдик; - Зачем до выхода договориться о полномочиях, ресурсах и критериях успеха; - Почему первый месяц лучше потратить на сбор реальной карты компании, а не на формирование портфеля изменений; - Как к 90-му дню выбрать одну-две системные ставки, показать первый результат и не пропустить красные флаги. Это не универсальный чек-лист «успешного успеха», а практическая модель: исследование → взаимный контракт → диагностика → первые изменения. И ещё: компания в эти три месяца тоже проходит испытательный срок. #Management #Leadership #CTO #Engineering #Career
-


 +2
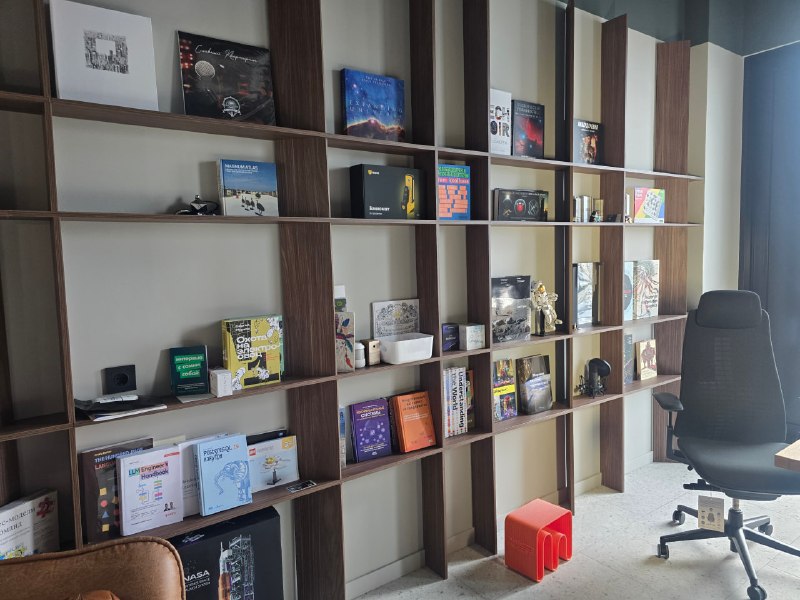
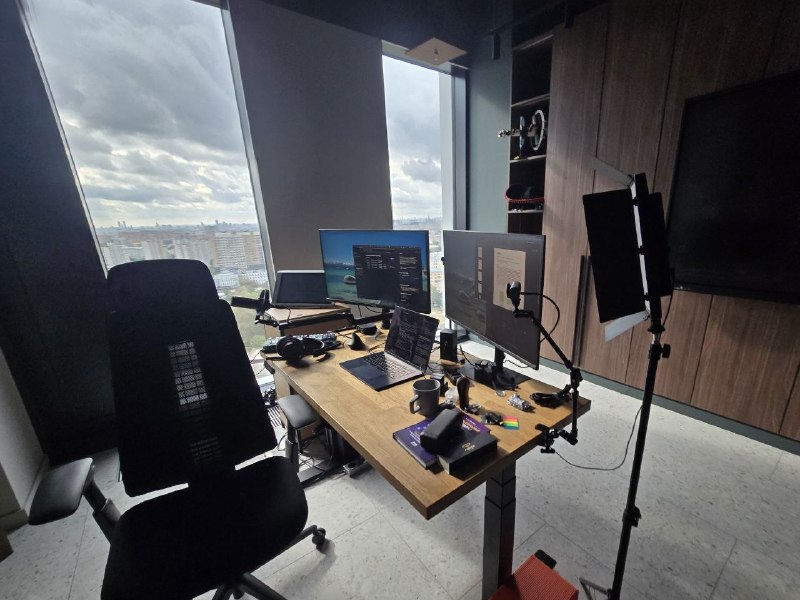
Новый офис Доехал сегодня в свой офис, чтобы записать выпуск подкаста с соведущими. И хоть я сейчас стараюсь все подкасты проводить в прямом эфире, но отпуски никто не отменял - в итоге, мы решили записать пару серий про запас и выпустить их по расписанию и без пропусков. Но рассказать я хотел про офис, который получился супер-комфортным и удобным для меня. Спасибо моей жене, что нашла дизайнера, строительную компанию и курировала ремонт. В итоге, офис получился отличным - у меня есть своя рабочая зона + место для оффлайн-подкастов - мне здесь нравится больше, чем в моем прошлом кабинете, что был у меня пока я работал в корпорации. А за стеной кабинет жены, который выполнен в более теплых тонах и который выглядит более милым и уютным:) Грустно будет прощаться с этим кабинетом при переезде в Лондон, но ближайшие пару месяцев я планирую ходить сюда как на работу и заниматься своими проектами:)
-
Stanford MS&E435: кто выбирает технологический стек — разработчик или кодинговый агент? (Рубрика #AI) «Я вообще не знаю, что такое Vercel. Мой агент привёл меня сюда». Так, по словам Guillermo Rauch, написал ему в личку в X один из новых клиентов, столкнувшийся с ошибкой. В одной фразе — новая экономика дистрибуции софта: человек не сравнивал облака и, возможно, вообще не знал названия платформы. Платформу для развёртывания выбрал его любимый кодинговый агент:) Это очередной разбор лекции из курса Stanford MS&E435, где мы начинали с карты экономики AI-суперцикла, а теперь дошли приложений и вопроса, а кто забирает ценность, когда софта становится больше. Guillermo Rauch, основатель и CEO Vercel, предлагает такой ответ: код дешевеет, но результат всё ещё нужно развернуть, запустить и обслуживать. Экономическая ставка Vercel — занять слой между намерением и работающим продуктом: дать агенту API для развёртывания, preview URL, изолированную среду, шлюз к моделям и долгоживущие процессы, а в перспективе — облако, которое само диагностирует эксплуатационные проблемы. Это одновременно содержательная лекция и аккуратно собранный питч от вендора. Но интереснее то, что происходит до развертывания. По словам Rauch, агент приходит с уже сложившейся «картиной мира»: модели успели узнать Next.js, React и open-source инструменты Vercel из материалов в интернете. Такой агент не проводит нейтральный анализ. Я бы сформулировал экономическое следствие так: open source здесь становится дистрибуцией, а runtime — монетизацией. В выступлении это подкрепляется цифрами из исследования Amplifying: Claude Code выбрал shadcn/ui в 64 из 71 ответов с извлечённым основным выбором (90,1%), а Vercel — во всех извлечённых deployment-ответах для Next.js и React SPA. Здесь важна сноска. Это 2 430 успешных ответов Claude Code с тремя моделями Claude на четырёх greenfield-репозиториях; Vercel получил 86 из 112 deployment picks в целом, то есть 76,8%. Это не доля рынка и не доказательство того, что выбранный продукт качественнее альтернатив. Именно поэтому формула «агент выбрал» не равна формуле «рынок порешал». Выбор складывается из обучающих данных модели, системной инструкции, текущего стека, качества документации, видимости проекта в open source и того, может ли агент понять и применить компонент локально. В разборе Developer Experience для кодинговых агентов мы уже говорили про стандартный стек, CLI/API, быстрые тесты и понятные ошибки. Теперь видно экономическое продолжение: агентная эргономика становится не просто хорошим DevEx, а каналом продаж. Есть и второй слой. Rauch считает, что интерфейс и локальный сценарий работы всё чаще будут генерироваться под задачу, а система учёта (system of record), данные, права доступа и API останутся. Я бы описал это как два периода полураспада софта: одноразовая оболочка и долговечное ядро. В самой лекции есть оговорка к тезису «software is basically free»: над сложным инфраструктурным кодом в Vercel, по словам Rauch, иногда собирают три агента и сильных инженеров, чтобы понять одну строку. То есть дешевеет реализация, но не обязательно архитектура, проверка, безопасность и владение системой. В The New SDLC harness — это обвязка вокруг модели, делающая генерацию управляемой. Здесь появляется следующий экономический слой: агент и его harness становятся точкой выбора компонентов. Для поставщика инструмента отсюда новый вопрос: сможет ли агент сам найти продукт, понять документацию, установить его, восстановиться после ошибки и объяснить свой выбор? Для покупателя — другой: почему агент принёс именно эту зависимость и какие варианты он даже не рассматривал? Раньше DevRel конкурировал за внимание разработчика. Теперь ему приходится бороться ещё и за место в картине мира модели — а этот gatekeeper часто вообще не виден пользователю. #AI #Agents #PlatformEngineering #DevTools #Product #Economics
-
edited AI4SDLC: Что бы я делал по-другому, если бы знал, что знаю сейчас (Рубрика #AI4SDLC) Поучаствовал на Deep Tech Night Яндекса с двумя активностями - Выступил с lighting talk "AI4SDLC: Что бы я делал по-другому, если бы знал, что знаю сейчас" - вот презентация - Поучаствовал в дискуссии "Когда код стал дешёвым: где теперь ценность, ответственность и экспертиза?" - в рамках подготовки написал лонгрид свою позицию с отсылками на свои же публичные материалы Lighting talk был на 15 минут, поэтому я рассказал презентацию очень кратко. По традиции, если есть желание послушать режиссерскую версию, то ставим 🔥 под постом и если мы наберем 100 реакций, то я устрою прямой эфир с режиссерской версией и ответами на вопросы. P.S. Пост про "Первые 90 дней CTO" набрал нужные количество 👌, поэтому на неделе я проведу прямой эфир с этим выступлением - https://t.me/book_cube/4919 #Agents #Books #AI #Engineering #Architecture #Management #Software
-


Сходил сегодня с женой и детьми утром в Бар Капибар, потом пообедал в детском ресторане Jooie и выдвинулся в сторону яндексовой конфы Deep Tech Night, где я сегодня расскажу lighting talk на тему ai4sdlc и пообщаюсь в дискуссии про AI Productivity. Очень плотный день в итоге выходит:)
-
Microsoft: почему быстрый AI-код не ускорил команду (Рубрика #AI4SDLC) К моим рассказам про spec-driven development и AI-DLC у AWS появилось хорошее продолжение. Microsoft Digital, внутренняя IT-организация компании, 3 сентября 2026 года поделилась опытом внедрения SDD. И начала с довольно неудобного признания. Разработчики освоили AI-инструменты и стали работать быстрее. Но, по словам руководителя инициативы, на уровне команды прироста производительности не получили. Авторы связывают это с потерей исходного замысла при передаче работы между участниками процесса. Каждый ускорился на своём участке, а договориться, что именно строим, легче не стало. Дальше ребята перестроили процесс вокруг живой спецификации. В ней фиксируют бизнес-цель, пользовательские сценарии, пограничные случаи и критерии приёмки. Спека хранится в репозитории и меняется вместе с продуктом. Ещё до неё команда согласует «конституцию»: архитектурные принципы, требования безопасности и ограничения. С помощью GitHub Spec Kit проходят цепочку: постановка задачи → уточнение вопросов → технический план → задачи → проверка согласованности → реализация и тесты. Отдельно советуют делать небольшие, сфокусированные спеки: результат проще проверять и дорабатывать по частям. Меняются и роли. PM отвечает за спецификацию на протяжении разработки, инженеры больше времени тратят на требования, планы и проверку сгенерированного результата. Знакомая тема: AI заставляет раньше делать ту работу, которую раньше можно было отложить до первого «мы вообще-то другое имели в виду». Впрочем, здесь нет замеров до и после или контрольной группы. Это рассказ Microsoft Digital о своём опыте; доказательства, что SDD ускоряет любую команду, из него не получается. И тут вернусь к разговору про AI-метрики: считать стоит весь путь от задачи до принятого результата, включая согласования, ревью и переделки. Иначе можно очень быстро писать код и по-прежнему долго выпускать нужные изменения. #AI4SDLC #AI #Engineering #Management #DevTools
-
Новый подкаст «Где профит от данных, Лебовски?» о данных и их ценности для бизнеса (Рубрика #Data) Мы запускаем новый подкаст с таким составом авторов - Андрей Цыбин - взгляд со стороны продуктовой аналитики и онлайн-экспериментов - Николай Голов - взгляд со стороны дата-архитектуры и продуктовой разработки платформы данных - Александр Поломодов - взгляд со стороны software архитектуры, AI4SDLC и инженерного лидерства Первый выпуск будет ключевым и будет посвящен теме «Превращаем данные в деньги: что это значит и какие есть варианты». Монетизация данных — это не только «продать массив». У компании есть как минимум три пути: - продать или лицензировать данные; - применить их внутри и улучшить решения; - встроить данные в продукт, за результат которого платит клиент. Разберём, где на самом деле возникает профит: в новой выручке, экономии, снижении ожидаемых потерь или более быстрых решениях. Поговорим о прямой продаже, внутренних data-платформах и продуктах, в которых клиент платит не за строки, а за результат. И для каждого кейса зададим один неприятный, но полезный вопрос: - Кто платит, за какое изменение и где это видно в P&L? - Без культа дашбордов и аналитики ради аналитики. 🗓 Премьера в прямом эфире 7 сентября в 12:00 МСК. #Data #Database #Analytics #Money #Metrics #Business
-
Stanford MS&E435: Yash Patil про внутреннее знание компании как learning loop (Рубрика #AI) В обзоре Stanford MS&E435 я писал, что курс даёт хорошую карту экономики AI, но инженерам может не хватить глубины. На встрече с Yash Patil глубина как раз появляется: он не останавливается на «подключим модель к документам компании», а показывает, как внутреннее экспертное суждение превратить в eval, reward и post-training. Патил — основатель и CEO Applied Compute. До своего стартапа он работал в OpenAI; по его рассказу, начал с post-training и evals, а затем перешёл к длинным агентным задачам. Технический опыт подтверждается не только его словами со сцены: OpenAI указывает Патила среди research contributors GPT-4.1 и Deep Research, а руководитель Deep Research Иса Фулфорд рассказывала, что раннюю работу над browsing-agent она начинала вместе с ним. То есть механику обучения моделей он знает изнутри. Но перед нами не нейтральный академический обзор: Applied Compute продаёт компаниям ровно то, о чём говорит Патил, — post-training, специализированные модели и их дальнейшее улучшение. Я бы воспринимал его как сильного оператора со skin in the game, а не как отраслевого оракула. 💡 Главный тезис лекции: следующее узкое место — continual learning, способность системы учиться по редкой обратной связи из production. Код и математика первыми выиграли от reasoning-моделей не случайно. Там уже есть проверяемая награда: код можно скомпилировать и прогнать через тесты, ответ по математике — проверить. В большинстве корпоративных задач готового verifier нет. Более того, JP Morgan и Goldman Sachs могут считать хорошим результатом разные вещи. Поэтому внутреннее преимущество компании не сводится к весам, документам или RAG. Патил отдельно подчёркивает, что model, harness и context работают вместе. Но накопительным активом становится контур: реальные задачи и ошибки → экспертные исправления → eval и grader → reward → post-training → production feedback → следующая итерация Патил удачно формулирует: eval определяет холм, на который затем карабкается RL. Если организация не умеет явно описать качество, выделить дорогие ошибки и согласовать спорные edge cases, модель будет оптимизировать удобный proxy. И может очень успешно забраться не на тот холм. Практическое следствие мне нравится своей приземлённостью. Прежде чем решать, нужна ли компании собственная модель, стоит выбрать частую и экономически заметную задачу, собрать реальные сбои и решения экспертов, сделать held-out eval и проверить grader. После этого уже видно, хватает ли prompt + context + tools или выигрыш от post-training окупит отдельный model lifecycle. В лекции есть два показательных кейса 1️⃣ В совместном материале Applied Compute и DoorDash заявлено примерно 30% относительного снижения доли низкокачественных меню после human validation и production A/B-теста; систему развернули на всём потоке меню в США. 2️⃣ По отчёту Cognition, специализированный SWE-Check сравнялся с Opus 4.6 на внутреннем in-distribution eval и работал примерно в десять раз быстрее. Но на полностью отложенном out-of-distribution наборе он всё ещё уступал Это хорошие аргументы за специализацию узкой, частой и измеримой задачи, но не доказательство, что каждой компании срочно нужен собственный checkpoint модели. Поэтому моя калибровка такая: Патилу я бы уверенно верил в вопросах evals, graders, reward design и post-training. Осторожнее — в прогнозах, что continual learning станет следующим главным фронтиром, а специализированные модели понадобятся почти всем. Самый устойчивый отрыв от конкурентов здесь, кажется, не конкретные веса: следующая frontier-модель может быстро их догнать. Защитный ров (moat) — это накопительный learning loop, который снова и снова превращает работу и ошибки компании в улучшение системы. Если времени мало: 03:43–05:38 — опыт Патила 23:56–35:20 — evals и два прикладных кейса 35:51–40:05 — continual learning и production feedback #AI #Agents #Evals #Engineering #Management #AI4SDLC
-
И я тоже в числе счастливчиков, кто сможет поэкспериментировать сегодня ночью с Astra от OpenAI:)
-
Code of Leadership S2E17: Как действовать среднему бизнесу с AI, которому «по-науке» дорого? (Рубрика #AI) У среднего бизнеса с AI есть неприятная развилка. Лаборатория, платформа и команда редких специалистов — тяжёлый входной билет. Но личные подписки, разрозненные демо и один «AI-волшебник», работающий по вечерам, ещё не складываются в практику. Сегодня в 17:00 проведем прямой эфир и обсудим это вместе с Александром Воронцовым, партнером @revelio_tech и автором канала AI Subjects (@aisubjects, изучает когнитивные ошибки при работе с ИИ). В прошлом разговоре мы дошли до важной точки: внешний эксперт уйдёт, а внутри должен остаться человек, который понимает задачу, проверяет результат и продолжает изменение. Теперь разбираемся, как получить и удержать эту способность, если сильные люди заняты основной работой, а нанимать AI-департамент рано. Мы обсудим: — как отличить задачу для AI от сломанного процесса, плохих данных и управленческого долга; — как выбрать первый сценарий, снять исходную метрику и заранее определить критерии приёмки и остановки; — кого растить внутри, кого нанимать или временно брать с рынка и что покупать готовым; — как освободить время доменного эксперта и не превратить AI в его вторую смену; — что нужно кроме учётных записей: доступы, тестовые примеры, журнал ошибок, ручное подтверждение и откат; — как считать входной билет: лицензии, интеграции, внутреннее время, контроль качества, поддержку и цену ошибки; — когда понравившийся сотрудникам пилот всё равно нужно закрыть. #CodeOfLeadership #AI #Consulting #Leadership #Management #DigitalTransformation
-
An Illustrated Guide to AI Agents: полное издание (Рубрика #Agents) В марте я уже рассказывал про "An Illustrated Guide to AI Agents". Тогда это был Early Release: готовы были шесть глав, а я обещал следить за продолжением. Теперь издательство O'Reilly выпустило полное издание — 450 страниц и 10 глав. Вернуться к книге стоит не только из-за новых страниц: она перестала выглядеть как сильная половина будущего учебника и наконец собралась в цельный маршрут — от устройства LLM до проверки и эксплуатации агентной системы. Если сравнить финальное оглавление с тем, что было готово весной, доехали четыре большие главы. 1️⃣ Large Language Models делает книгу самодостаточной. Здесь есть tokens, system prompt, tool calls, pre-training и post-training, Transformer, context length, KV cache и Mixture of Experts — причем всё это привязано к поведению, задержке и стоимости агента. Становится понятнее, как сама модель, длина контекста и KV cache влияют на всю систему. 2️⃣ Evaluating Agents — пожалуй, самая важная новая глава. Авторы разбирают public benchmarks, outcome и trajectory evaluation, LLM-as-a-judge, rubrics, reliability, safety и собственные evals. Особенно полезна пара метрик: pass@k отвечает на вопрос «получилось ли у агента хотя бы раз за k попыток», а pass^k — «успешны ли все k попыток». Для эффектного демо часто хватает первого, для рабочего процесса гораздо важнее второе. 3️⃣ Multi-Modal Understanding объясняет, как агент начинает видеть изображения, слышать аудио и разбирать видео: encoder переводит вход в embeddings, connector приводит их к формату LLM, дальше модель использует их как контекст. Заодно хорошо показаны компромиссы: простой projection дешевле, query-подход лучше сжимает длинный вход, fusion обычно выразительнее, но сложнее и дороже. 4️⃣ Code Agents and Code LLMs доводит тему от генерации функции до работы внутри репозитория. Здесь есть инструменты для файлов и терминала, SQL, песочницы для исполнения кода, карты репозитория, кэширование и сжатие контекста, планирование, тесты и ручное подтверждение. Важная мысль: иногда фиксированный workflow надежнее полноценного агента, а доступ к shell — это не удобная галочка, а граница безопасности, от которой зависит масштаб возможного ущерба. Кстати, финальная версия уже знакомой главы про Multi-Agent Systems включает orchestration patterns, communication protocols, deep research agents и сценарии вроде AI co-scientist. Но цельность книги создаёт сквозная конструкция. В первой части авторы последовательно собирают одного TinyAgent: LLM → reasoning → memory → tools → planning → evals. Во второй показывают, как та же архитектура специализируется в multi-agent, multi-modal и coding systems. Получился уже не каталог модных фреймворков, а понятный инженерный цикл. Для инженера это закрывает несколько конкретных сценариев: - спроектировать внутреннего исследовательского агента или агента поддержки и понять, где хранить контекст и какие инструменты ему дать; - проверять изменения промпта, модели и памяти через регрессионные evals не только по ответу, но и по траектории; - собрать code agent с поиском по репозиторию, тестами и песочницей; - добавить изображения, звонки или видео туда, где текстовый агент просто не видит часть задачи. Для техлида или руководителя сценарии другие: - решить, где нужен агент, а где достаточно детерминированного workflow; - выбрать single-agent или multi-agent архитектуру и посчитать цену координации; - сравнить поставщиков на собственных задачах как связку «model + harness», учитывая надёжность, задержку и стоимость; - задать границы автономности — права, необратимые действия, сценарии безопасности и места, где обязательно ручное подтверждение. Если первые главы уже читали весной, начинать заново необязательно: главу 2 можно пробежать для связки с экономикой агента, главу 7 я бы точно не пропускал, а дальше — главы про мультимодальность и кодинговые агенты. Именно эта связка превращает ранний набор хороших объяснений в законченную инженерную книгу. #Agents #Books #AI #Engineering #Architecture #Management #Software
-
Подтягивайтесь на очередной эфир 3 AImigo, где мы поговорим про изменения найма под влиянием AI.
-
NVIDIA договорилась купить Hugging Face: проверка на нейтральность (Рубрика #AI) После разбора стратегии NVIDIA эта сделка выглядит почти неизбежным следующим ходом. Только цена в $12,93 млрд немного отвлекает: NVIDIA договорилась купить не очередную модельную лабораторию и не новый тип ускорителя. В случае закрытия сделки она получит место, где разработчики находят, сравнивают, скачивают и запускают открытые модели — одну из главных точек выбора во всём AI-стеке. Сначала аккуратно со статусом. 2 сентября 2026 года NVIDIA подписала definitive agreement, 3 сентября опубликовала анонс и форму 8-K. По документу для SEC, примерно $11,9 млрд предназначены акционерам Hugging Face, ещё до $1 млрд — retention-программа в акциях для сотрудников, которые перейдут в NVIDIA. Закрытие ожидается в первой половине 2027 года и зависит в том числе от регуляторных согласований. То есть сделка предложена, но пока не закрыта. Почему Hugging Face стоит рассматривать не как «GitHub с весами»? По данным самой NVIDIA, на платформе больше 18 млн разработчиков и исследователей, 3 млн моделей, 500 тысяч датасетов и 1 млн приложений. Но важнее сам механизм. Inference Providers даёт один API к Baseten, Cerebras, Groq, Nscale, Together и другим поставщикам, а без явного выбора автоматически направляет запрос к самому быстрому доступному provider. Dedicated endpoints можно разворачивать в AWS, Azure и Google Cloud. Получается уже не просто хранилище артефактов, а слой discovery, distribution и routing: что разработчик увидит, какую модель попробует и где её запустит. Для NVIDIA логика понятна. Компания уже контролирует популярный compute/runtime-слой через GPU и CUDA и, по собственным данным, выложила на Hugging Face больше 500 моделей и 250 датасетов. Теперь к железу и software stack добавляется канал дистрибуции. Открытые модели удешевляют и ускоряют создание AI-продуктов, а каждый такой продукт всё равно создаёт спрос на inference. Плюс платформа даёт раннюю агрегированную картину того, какие модели, архитектуры и способы запуска набирают популярность. Последний пункт — интерпретация аналитиков, а не раскрытая цель сделки. NVIDIA обещает сохранить Hugging Face открытой: её железо не будет обязательным, разработчики смогут выбирать модели, frameworks, clouds, inference providers и compute platforms. В 8-K обещание сформулировано чуть уже, но всё равно предметно: сохранить возможность загружать и скачивать выбранные модели и датасеты и продолжать поддержку других производителей чипов. Это сильнее обычного «бренд останется прежним». Но открытость артефактов ещё не равна нейтральности платформы. Публичные документы пока не отвечают на четыре практических вопроса: 1️⃣ Кто и по каким правилам управляет ранжированием и рекомендациями моделей; 2️⃣ Как выбираются дефолты в маршрутизации инференса и какие провайдеры получают приоритет; 3️⃣ Будет ли одинаковой скорость интеграции и оптимизации для CUDA, ROCm, Trainium, TPU и CPU; 4️⃣ Где пройдёт граница использования телеметрии и данных о поведении разработчиков. Сейчас нет доказательств, что NVIDIA собирается подкручивать эти механизмы в свою пользу. Но именно здесь и будет проходить настоящая проверка, а не в возможности скачать файл с весами. Поэтому обещание «Hugging Face останется открытой» — не сноска к пресс-релизу, а главный критерий приемки сделки. Если после закрытия конкурирующее железо и независимые провайдеры инференса будут появляться в роутинге, документации и оптимизациях на равных, а правила ранжирования и использования данных станут прозрачнее, ресурсы NVIDIA действительно могут усилить экосистему. Если нет, веса останутся открытыми, но площадка, на которой все их выбирают, перестанет быть нейтральной. #AI #PlatformEngineering #OpenSource #Architecture #Infrastructure #Bigtech
-
Stanford MS&E435: Sachin Katti о том, когда человек становится bottleneck AI-системы (Рубрика #AI) В этой лекции есть тезис, который для инфраструктуры звучит как победа, а для человеческой работы — почти как предупреждение. Sachin Katti говорит: OpenAI добьётся успеха в compute, когда bottleneck станет человек. Агент будет заканчивать шаги так быстро, что мы перестанем ждать и останемся в flow. На встрече курса Stanford MS&E435 «Economics of the AI Supercycle» Apoorv Agrawal беседует с Sachin Katti. На момент записи Katti руководил Industrial Compute в OpenAI — compute для training и inference. Сейчас он VP, Compute Strategy & GPT-Infra в OpenAI; ранее был CTO Intel и преподавал в Stanford. Это не нейтральный обзор рынка, а взгляд оператора frontier-лаборатории. Сильная часть лекции — агент как новый тип workload. У чат-бота был короткий путь: пользователь → один inference call → ответ Агент замыкает цикл: inference → поиск или база → tool call → VM или приложение → наблюдение и оценка результата → новый inference Katti описывает execution как DAG; управляющая логика может оставаться циклической. Узлам нужны разные ресурсы: » Ускорители для model inference » CPU-backed runtimes и VM для инструментов и тестов » Системы с большой памятью для длинного контекста » Сеть и orchestration для сборки маршрута Поэтому model + runtime + accelerators + network + data center + power приходится оптимизировать как одну систему. Это продолжает два сюжета канала: hardware-software co-design у Dylan Patel и дерево агентных вызовов, превращающее бизнес-процессы в спрос на GPU. Новое — операторский взгляд OpenAI: куда поместить каждый узел и как latency всего графа влияет на human flow. Из этого я бы мерил не только tokens/s, а time to first useful action, время до проверенного артефакта и стоимость задачи. У Katti три рычага: более дешёвый токен, более умный токен и меньше токенов на результат. Есть и большие числа. По прогнозу Katti, более 80% compute будет уходить на inference — включая synthetic data и часть post-training. Цель OpenAI в 30 ГВт он называет aspirational, а 1 ГВт грубо приравнивает к 500 тысячам GPU. Это оценки спикера. И утроение compute вместе с выручкой за три года показывает корреляцию, но не доказывает причинность. Здесь появляется напряжение. Для Katti человек как bottleneck — признак успеха compute-инфраструктуры: сегодня агент выполняет задачу с инструментами минуты или часы, человек переключается, а затем заново загружает контекст. Быстрый AI должен вернуть интерактивность. В канале мы уже смотрели на ту же картину с другой стороны. В Your Attention Is the Bottleneck человек превращается в диспетчера множества циклов: ставит задачи, снимает блокировки, проверяет и выгорает от переключений. А в посте про понимание как новое узкое место изменения производятся быстрее, чем команда успевает обновлять модель системы в голове. Возникает когнитивный долг: код работает, но отвечать за его развитие уже некому. Ускорение агента не устраняет эту проблему и может повысить частоту решений, прилетающих человеку. Если разогнать конвейер, не усилив контроль качества, могут расти незавершённая работа, пропущенные дефекты и переделки. У человеческого bottleneck как минимум четыре ограничения: внимание, понимание, проверка и ответственность. Ни одно из них не масштабируется вместе с tokens per second. Поэтому agentic UX стоит проектировать не только вокруг быстрого ответа. Агенту нужно собирать вопросы пакетно, возвращать компактный контекст, показывать evidence, тесты и неопределённость, а человека подключать там, где высока цена ошибки. И мерить время до понятого и проверенного результата вместе с числом steering points, переключений и переделок. Я бы смотрел отрезок 18:05–24:40 про agentic graph и human flow, а затем 29:05–33:05 про latency. После него остаётся хороший вопрос: сколько параллельных агентных циклов человек способен не просто направить, а понять и ответственно закрыть? #AI #Agents #Engineering #Architecture #Infrastructure #AI4SDLC
-
edited Только что рассказал про первые 90 дней CTO на мероприятии Стратоплана Вот слайд-дека - https://polomodov.tech/2026-09-03-first-90-days-cto/ Вот лонгрид - https://polomodov.tech/2026-07-31-first-90-days-cto/ Если мы набьем 50👌, то я сделаю режиссерскую версию этого доклада в виде прямого эфира.
-
Первые 90 дней CTO начинаются до первого рабочего дня - Менеджмент 360 (Рубрика #Management) Сегодня я выступлю в 19:35 на «Менеджменте 360» от Стратоплана - буду рассказывать про первые 90 дней технического директора. Начну с небольшого переворота: первый рабочий день — уже середина перехода. В докладе разберу весь маршрут: - Как выбирать задачу, а не красивый шилдик; - Зачем до выхода договориться о полномочиях, ресурсах и критериях успеха; - Почему первый месяц лучше потратить на сбор реальной карты компании, а не на формирование портфеля изменений; - Как к 90-му дню выбрать одну-две системные ставки, показать первый результат и не пропустить красные флаги. Это не универсальный чек-лист «успешного успеха», а практическая модель: исследование → взаимный контракт → диагностика → первые изменения. И ещё: компания в эти три месяца тоже проходит испытательный срок. Регистрация бесплатная при подписке на Telegram-каналы спикеров. Есть и платный вариант без подписок — с именным сертификатом и курсами «Менеджмент 101» и «Директор 101». 👉 Регистрация #Management #Leadership #CTO #Conference
-
edited 
Интервью с самим собой: гипотеза, вердикт и синяя борода (Рубрика #Books) Прочитал книгу Марии Макарушкиной «Интервью с самим собой. Индивидуальный ассесмент как инструмент самоанализа руководителя». Для меня она оказалась интересна прежде всего тем, что приоткрывает кухню индивидуального ассесмента: как консультант слушает биографию человека, замечает повторяющиеся мотивы и собирает из них гипотезы о характере, мотивации и управленческом поведении. Но ровно здесь у меня появилось и главное сомнение. В некоторых историях автор, как мне показалось, слишком широко интерпретирует биографические детали. Если довести этот ход мысли до карикатуры, получится примерно так: человек в детстве любил синий цвет — и поэтому вырос с синей бородой. Такого примера в книге, конечно, нет; это моя метафора. Но проблема реальная: психологическая история может звучать очень складно и при этом не быть единственным — или вообще верным — объяснением. В какой-то момент я понял, что граница проходит между гипотезой и вердиктом. - Гипотеза звучит так: «Возможно, ранняя необходимость отвечать за других связана с тем, что сегодня я всё контролирую». С ней можно пожить, проверить её на разных ситуациях, спросить коллег и в итоге отбросить. - Вердикт звучит почти так же, только слово «возможно» исчезает: «Вы всё контролируете, потому что в детстве вам пришлось рано повзрослеть». Объяснение стало увереннее, хотя данных больше не появилось. Но надо отдать должное, автор в книге всегда делает ремарку про важность дополнительных данных для проверки гипотезы (хотя выводы часто безапеляционны и дальше сопровождаются тезисами в стиле: прошло время и конечно так все и разрешилось). Отсюда для меня возникло ещё одно разделение — ассесмент для себя и внешний ассесмент. 🤔 В самоассесменте даже неточная гипотеза может оказаться полезным вопросом. Интерпретация остаётся у меня: её можно проверить и отбросить, не превращая в чужое кадровое решение. Хотя и здесь легко сочинить себе удобную историю: назвать контроль ответственностью, а избегание конфликтов — эмпатией. ↗️Во внешнем ассесменте та же гипотеза способна стать ярлыком и повлиять на найм, назначение или карьеру. Поэтому одной правдоподобной связи с биографией мне уже недостаточно. Нужны наблюдаемое поведение, конкретные рабочие ситуации, обратная связь окружающих, несколько независимых источников и понятный ответ на вопрос: «Что могло бы опровергнуть этот вывод?» Сама книга построена в трёх частях 1️⃣ В первой читатель проходит по собственной биографии: раннее детство, родители, семейные установки, первая работа и значимые события 2️⃣ Во второй автор разбирает личностный портрет — особенности мышления и речи, мотивацию, ответственность, коммуникацию и самооценку 3️⃣ В третьей собраны жизненные сценарии из консультационной практики Всё это перемежается историями руководителей и упражнениями для самодиагностики. В итоге книгу я бы рекомендовал руководителям и всем, кому интересно посмотреть за кулисы индивидуального ассесмента. Из неё можно забрать хорошие вопросы к себе и лучше понять логику оценщика. А вот ответы полезно держать в статусе гипотез подольше:) #Books #Management #Leadership #HR #Psychology
-
Stanford MS&E435: Али Годси говорит, что AGI уже здесь, а компания — ещё нет (Рубрика #AI) Редкий случай, когда одна 39-минутная запись собирает в одну картину темы, о которых я писал по отдельности: корпоративную память, AI-native организацию, судьбу SaaS и перенос ценности вверх по стеку. Это встреча Stanford MS&E435: преподаватель Apoorv Agrawal разговаривает с Али Годси, сооснователем и CEO Databricks. Годси начинает с провокации: «AGI уже здесь». Это его рабочая рамка, не консенсус. Полезнее следующий тезис: модели уже достаточно умны для многих корпоративных задач, но не знают контекста компании. Отсюда ссылка на "GenAI Divide": предварительный отчёт утверждал, что лишь около 5% специализированных enterprise GenAI-инициатив дошли до устойчивого измеримого эффекта. Авторы предупреждали, что оценки показывают скорее направление, а Годси оговаривается, что точная доля может быть другой. Почти в каждой организации, говорит он, есть свой John или Jane: человек, который помнит, почему процесс устроен именно так, где лежат исключения и к кому идти за решением. Модель этого не знает и потому делает глупые ошибки. Это почти тот же «мозг компании», о котором я писал после доклада Гарри Тана: преимущество создаёт не только модель, но и способность дать ей правильную память. Самый сильный фрагмент начинается на двадцатой минуте. По рассказу Годси, production-коннектор Databricks к Salesforce или Workday занимал девять месяцев. По оценке команды, использование AI сокращало цикл лишь до семи с половиной. Тогда процесс перепроектировали: квартал сбора требований превратили в неделю с быстрыми итерациями, тестовые окружения отдали внешним исполнителям и запускали параллельно, а семь инженеров стали вместе вести семь коннекторов вместо модели «один человек — один проект». Результат, по словам Годси, — семь коннекторов за квартал. Ни GPT-7, ни следующая Claude не сняли бы эти блокировки: это был рефакторинг организации. Та же мысль соединяет мой текст про AI-native организацию и разбор "перестройки McKinsey": LLM поверх старого процесса даёт локальное ускорение, но не новый throughput. Аналогия с электрификацией похожа: фабрика стала продуктивнее не после установки одного электромотора, а после новой планировки вокруг независимых приводов. Вторая линия — «software умер». Годси с этим спорит, но считает, что AI снижает барьер входа и switching costs. Если пользователь разговаривает с агентом, ему уже не так важно, какой GUI тот нажимает — Salesforce или продукт конкурента. Это очень близко к моему тезису, что "умирает монополия GUI, а не software". При этом дешёвый код не отменяет данные, масштаб, бренд, доверие, сертификацию и process power. Годси прямо рекомендует Hamilton Helmer и его Seven Powers. А дальше прогнозирует, что модельный слой превратится в низкомаржинальные «фабрики токенов», а большая ценность уйдёт в приложения. Мы уже видели ту же логику в разговоре про коммодитизацию моделей. Правда, это прогноз заинтересованного инфраструктурного вендора, но направление выглядит правдоподобно. И всё же «скачать мозг компании в silicon» — только половина задачи. Если контекст получит агент, а люди перестанут понимать систему, мы просто ускорим накопление когнитивного долга. Исполнение можно делегировать; ответственность за устройство процесса и способность его перепроектировать остаются у команды. Если времени мало, то посмотрите отрывки "20:23–24:43" — кейс с коннекторами и "26:04–28:44" — история о том, как дефицит bandwidth сделал multicast модной научной задачей, а дешёвое оптоволокно обесценило её и открыло дорогу странным тогда приложениям вроде Amazon, Uber и Airbnb. Хорошее напоминание: главный продукт следующего цикла редко похож на модный инфраструктурный вопрос текущего. #AI #Agents #Engineering #Software #Management #Strategy
- Older posts