Code of Leadership S2E18: Продуктовый инженер — как изменится роль программистов в ближайшие 3 года Код писать становится заметно быстрее. Но если всё большую часть реализации можно делегировать AI-инструментам, что тогда остаётся ядром работы программиста: знание синтаксиса, инженерное суждение или ответственность за продукт целиком? В новом выпуске Code of Leadership во вторник, 8 сентября, в 19:00 попробуем разобраться в этом вместе с Глебом Михеевым — CPO ГигаАгента в Сбере. Глеб в коммерческой разработке с 2003 года: работал в NVIDIA и Skillbox, основал и девять лет развивал студию заказной разработки, восемь лет отвечал за программу FrontendConf, а сейчас руководит программными комитетами AgenticDevConf и AI Native Conf. Ещё Глеб ведёт отличный Telegram-канал «Уставший техдир», где пишет про агентную разработку, инженерную культуру, управление командами и продукт. Поговорим о том: - какие изменения уже происходят в разработке ПО, а что пока остаётся красивым прогнозом; - чем эти изменения обусловлены и почему дело не сводится к появлению ещё одного инструмента; - как меняются требования к разработчику и чем продуктовый инженер отличается от человека, который просто закрывает задачи; - что делать с джунами, если типовые стартовые задачи всё чаще автоматизируются, и как готовить молодых инженеров без искусственной «теплицы»; - как опытному разработчику учиться, пробовать новые подходы, сохранять техническую глубину и не отставать от прогресса; - какой может стать роль программиста в ближайшие три года — и что здесь пока слишком рано выдавать за факт. Отдельно хочу проверить границу здравого продуктового мышления. Продуктовый инженер — это специалист, который понимает проблему пользователя и отвечает за результат, или просто удобное название для человека, которому предлагают одновременно побыть продактом, аналитиком, архитектором и разработчиком? Если у вас есть вопросы к Глебу или собственные примеры того, как уже меняется работа разработчика, приносите их в комментарии. #CodeOfLeadership #AI4SDLC #Engineering #Leadership #Product #Career

Книжный куб
Канал Александра Поломодова (@apolomodov), cto & technical fellow. https://polomodov.tech - сайт со всеми материалами youtube.com/@tellmeabouttech - канал со всеми видео
-
edited -
Материалы Code of Leadership S2E15: последние 90 дней в компании (Рубрика #Management) Готовы материалы сольного выпуска Code of Leadership S2E15, который вышел 31 августа. В общей нумерации подкаста это выпуск №73. Он получился личным: после почти десяти лет в одной компании я разбираю обратную сторону первых 90 дней — как осознанно завершить прежний этап. Заявление здесь не начало процесса, а трудно обратимая точка; до неё стоит понять, что именно перестало работать, проверить варианты и выбрать один из трёх исходов: пересобрать текущую роль, перейти внутри компании или уйти. Это практическая модель, а не исследование: 90 дней — горизонт проектирования перехода, а не универсальный срок уведомления. В выпуске разобрал: - Как дневник энергии помогает отличить системную неудовлетворённость от одной плохой недели, месяца или проекта; - Где проходит граница между тем, что можно изменить в роли, — задачами, полномочиями и рабочими ритмами — и ограничениями самой компании или рынка; - Как провести карьерную ретроспективу и описать следующую роль через ответственность, решения и результат, а не название должности; - Как до окончательного выбора прототипировать роль через внутренние интервью и пробные проекты, параллельно проверяя ожидания на внешнем рынке; - О чём договориться на входе в новую роль: мандат, ресурсы, границы и критерии оценки; - Почему документ не равен переданному знанию: сначала преемнику нужно отдать право принимать решения, затем — контекст, отношения, ритмы и доступы. Передача завершена, когда команда может действовать без прежнего владельца. Все материалы выпуска: - Страница выпуска: конспект, таймлайн и ссылки - Интерактивная дека и полный лонгрид - Видео: YouTube, VK Видео - Аудио: Podster, Яндекс Музыка, Apple Podcasts Если вы проходили такой переход, расскажите в комментариях, что оказалось труднее: понять причину, выбрать следующий шаг или действительно передать ответственность. #Management #Leadership #Career #Strategy #Engineering #Podcast
-
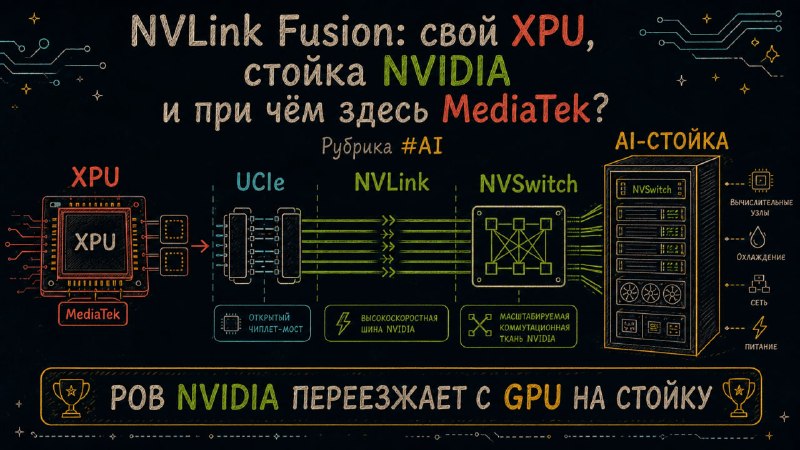
NVLink Fusion: свой XPU, стойка NVIDIA и причем здесь Mediatek (Рубрика #AI) Когда я рассказывал про эволюцию Google TPU, логика была понятной: крупный облачный провайдер создаёт собственный ускоритель, чтобы точнее подогнать железо под свои модели и меньше зависеть от универсальных GPU. Ответ NVIDIA на этот тренд выглядит довольно красиво: хорошо, делайте свой XPU — а стойку вокруг него мы поможем собрать на нашей архитектуре. 31 августа 2026 года NVIDIA и MediaTek объявили о расширении партнёрства. NVIDIA приобрела конвертируемые облигации MediaTek на $3,5 млрд — долговые бумаги, которые при предусмотренных условиях можно обменять на акции. Но технически интереснее другая часть анонса: MediaTek будет помогать заказчикам проектировать и интегрировать заказные AI-ускорители, а NVLink Fusion даст этим чипам путь в стоечную инфраструктуру NVIDIA. XPU здесь — не один конкретный тип процессора, а условное название заказного ускорителя под определённый профиль нагрузки: обучение или инференс, то есть работу уже обученной модели. Заказчик может принести собственную микроархитектуру либо поручить её MediaTek. Один из показанных NVIDIA вариантов подключения выглядит так: заказной XPU → UCIe → чиплет-мост NVIDIA → NVLink → NVSwitch → AI-стойка UCIe — открытый интерфейс между чиплетами внутри многокристальной системы. Через него XPU подключается к мосту NVIDIA, а тот выводит ускоритель в NVLink. NVSwitch объединяет множество ускорителей в одну высокоскоростную сеть. Рядом NVIDIA предлагает блоки для связи с CPU/GPU, памяти и общего стоечного формата — NVLink-C2C, NVHBM и MGX. Такая архитектура позволяет совместно использовать сеть, питание, охлаждение и управление; NVIDIA и MediaTek также обещают помогать с тестированием и отладкой готовой системы перед её серийным выпуском. Если упростить, заказчик проектирует двигатель, а NVIDIA предоставляет дорогу и развязки, по которым должен двигаться целый парк таких машин. Я бы читал NVLink Fusion именно так: NVIDIA не спорит с появлением заказных чипов у Google, AWS и других крупных игроков, а старается стать опорным слоем для гетерогенных AI-вычислений. Вычислительный кристалл может быть не NVIDIA, но обмен данными между ускорителями и, при выборе MGX, значительная часть стоечного контура могут остаться в её экосистеме. При этом NVLink Fusion не стоит путать с полностью открытым стандартом. Открытой является локальная граница UCIe, а NVLink, чиплет-мост и NVSwitch остаются проприетарными технологиями NVIDIA. То есть зависимость возникает на уровне внутристоечной сети и может распространиться на архитектуру стойки. И это не история одного MediaTek. При запуске NVLink Fusion 18 мая 2025 года NVIDIA назвала среди партнёров также Marvell, Alchip, Astera Labs, Synopsys и Cadence. Позднее AWS сообщила, что Trainium4 проектируется с поддержкой NVLink Fusion. По утверждению NVIDIA, такая архитектура должна сокращать путь от проекта чипа до работающей стойки. Проверить это пока нельзя: у совместного проекта NVIDIA и MediaTek нет названного заказчика, даты выхода чипа и независимых данных о производительности или стоимости владения. Поэтому главный тест ещё впереди: появится ли серийная система, в которой XPU действительно свой, а NVLink Fusion действительно ускоряет путь до эксплуатации. Если да, защитный ров NVIDIA будет проходить уже не вокруг GPU. Он будет проходить вокруг стойки. И это, кажется, интереснее очередного сравнения FLOPS. #AI #Engineering #Architecture #Infrastructure #Hardware #Bigtech
-
Приходите послушать про джунов на эфир и задавайте свои вопросы.
-
edited 3 AImigo S1E4: AI нанимает AI. Как пересобрать IT-собеседования? (Рубрика #AI) AI соискателя встречается с AI нанимающего — мегазорд против супер-рейнджера. Запрет AI не делает интервью AI-free, резюме всё хуже подтверждает способность работать, а старые онлайн-этапы дают всё более шумный сигнал. Вопрос у компании прежний: сможет ли человек успешно работать в этой роли? В пятницу в 12:00 по Мск в прямом эфире подкаста 3 AImigo посмотрим на найм с двух сторон — кандидата и нанимающего менеджера — и обсуждаем, как пересобрать его под AI-Assisted Engineering. — Как собрать hiring process как eval-систему: определить признаки для роли, подготовить банк задач с сильными решениями и проверить, что каждый этап измеряет нужный сигнал. — Как сочетать AI-on и AI-off, собеседования онлайн и офлайн. Без AI проверять фундамент, с AI — реальную работу: запуск кода, выбор того, что делегировать агенту, и проверку результата. — Почему важнее не скорость генерации, а инженерное суждение: уточнение требований, декомпозиция, поиск контекста, system design, debugging, тесты, безопасность, failure modes, trade-offs, ownership финального решения и способность отвергнуть убедительный, но неверный ответ модели. — Почему единого трека больше может не быть. Product engineer, платформенный и R&D-инженер создают разную ценность — значит, им нужны разные сигналы и задания. — Что меняется для кандидата: AI усилил обе стороны, рынок расслаивается, знакомства не являются новым лайфхаком, поиск становится почти full-time работой, а первой потерей работы из-за AI может оказаться вакансия, которую компания просто не открыла. Как обычно, разбираемся втроём: Евгений Сергеев, Алексей Литвинов (@tip_podcast) и Александр Поломодов. Смотрите выпуск на Youtube. И напишите, какой этап вашего последнего собеседования действительно предсказывал будущую работу, а какой проверял умение проходить собеседования. #AI #AI4SDLC #Engineering #Management #Evals #Interview #Career
-
edited Stanford MS&E435: дефицитный мегаватт AI-фабрики (Рубрика #AI) После этой лекции «облачный AI» выглядит удивительно тяжёлой промышленностью: электричество, подстанции, охлаждение, бетон и люди, которые всё это собирают. Третья встреча Stanford MS&E435 полезна именно этим — опускает разговор о моделях, токенах и GPU на физический слой ниже. Гость — Чейз Локмиллер, сооснователь и CEO Crusoe, которая строит и продаёт весь стек от площадки до managed inference. Поэтому это одновременно хорошая карта отрасли изнутри и vendor pitch: Локмиллер объясняет ровно тот вертикальный стек, который продаёт. Его схема называется «от электронов к токенам»: энергия → здание и охлаждение → compute → токены → выполненная работа. А главный тезис звучит так: по его опыту, текущий bottleneck — уже не отдельный GPU, а energized data center, то есть готовое место, где чип можно включить и загрузить работой. Вот какие инсайты из лекции я бы вынес: 🔸 Bottleneck постоянно мигрирует Вчера не хватало GPU, сегодня — подключённой мощности, газовых турбин, трансформаторов, switchgear и квалифицированных электриков. Вертикальная интеграция здесь работает не только как способ забрать больше маржи, но и как страховка от очередного дефицита. 🔸 Дефицитный товар — энергизированный мегаватт Купить ускорители недостаточно: нужны земля, разрешения, подстанция, сеть и охлаждение. Поэтому площадка, где можно быстро запустить 100–1000 МВт compute, оказывается стратегическим активом. 🔸 Иногда дешевле перемещать данные, а не электричество Обучение не обязано происходить рядом с пользователем, поэтому Crusoe ставит кластеры возле избыточной энергии Западного Техаса. Для inference с жёсткой задержкой и данных с требованиями к размещению эта логика работает хуже. 🔸 AI-бум — это ещё и промышленный бум На кампусе Abilene, по словам Локмиллера, ежедневно работают тысячи строителей. Электрики, сварщики, pipefitters, бетон и километры кабеля оказываются не менее важны, чем CUDA и архитектура модели. 🔸 Старый GPU может стать commodity, масштаб — нет Большой coherent cluster с общей высокопроизводительной сетью трудно воспроизвести. А managed service может скрыть поколение железа от клиента и продлить экономическую жизнь ускорителей: пользователю нужен результат API, а не конкретный H100. 🔸 В модели Локмиллера экономика зависит от depreciation, загрузки и слоя сервиса По его оценке, здание и генерация стоят около $20 млн на МВт, IT — ещё $40 млн, из которых примерно $30 млн приходится на GPU. Аренда compute в его расчёте даёт около $15 млн выручки на МВт в год, managed inference — в оптимистичном случае до $30 млн. Последние цифры я бы воспринимал только как модель самого CEO. Локмиллер прямо признаёт возможный двойной счёт, неполный OpEx и то, что слайды были собраны в тот же день. Поэтому заявленные два–четыре года «окупаемости» — скорее CapEx / revenue, а не расчёт прибыли или free cash flow. Самая спорная часть — последняя стрелка в схеме «от электронов к токенам»: от токенов к выполненной работе. Локмиллер называет AI-агентов digital labor и переносит их в фактор труда модели Cobb–Douglas. Это производственная функция (или функция полезности), отражающая зависимость объёма производства Y от создающих его факторов производства — затрат труда L и физического капитала K). Она выглядит так Y(L,K)=A * (L * alpha) * (K * beta), где A — технологический коэффициент, α ⩾ 0 — коэффициент эластичности по труду, а β ⩾ 0 — коэффициент эластичности по капиталу. Как метафора это работает. Но в обычном growth accounting GPU и дата-центр скорее попадают в капитал, улучшение моделей — в технологию и продуктивность, а токены сами по себе ещё не равны полезному результату. И ещё одна оговорка: closed-loop cooling в Abilene действительно резко снижает расход воды, но, по словам Локмиллера, для кампуса построена газовая станция на 350 МВт. Low-water не означает автоматически low-carbon. Я бы рекомендовал посмотреть отрезки 9:26–18:30 и 23:54–40:45: сначала меняется представление о bottleneck, затем появляется редкий публичный разбор экономики мегаватта — со всеми его полезными цифрами и честными оговорками. #AI #Engineering #Infrastructure #Architecture #Economics #Bigtech
-
Code of Leadership S2E16: Джун после кода - как растить инженеров, когда исполнение уезжает агентам (Рубрика #Education) Сегодня 1 сентября, хотел анонсировать завтрашний эфир в 13:00 про джунов и не только. AI-агенты уже умеют за минуты собирать прототипы, писать тесты, находить ошибки и предлагать готовые изменения. Артефакты становятся качественнее, а разница между работой джуна и опытного инженера на демо — всё менее заметной. Но одинаковый результат ещё не означает одинаковую компетентность. Кто сформулировал критерий правильности? Кто проверил решение в реальном контексте? Кто понимает ограничения системы и отвечает за последствия после релиза? И главное: где теперь начинающему инженеру получать опыт, если безопасные стартовые задачи постепенно забирают агенты? В выпуске разберём: — почему скорость выполнения, навык и ответственность — три разные метрики; — как сохранить продуктивное усилие, на котором формируется инженерное мышление; — почему PR — только середина работы, а не её завершение; — как выстроить лестницу ответственности от фрагмента кода до владения компонентом; — что менять в найме, если скорость написания кода больше не является сильным сигналом; — почему нанимать джунов без системы наставничества становится особенно дорогим решением. Поговорим и о том, как должна выглядеть такая система: кто отвечает за развитие инженера, какие рабочие ритмы помогают расти и зачем команде нужны два табло — полезность сегодня и самостоятельность завтра. Это выпуск не только о джунах. Он о том, сможет ли компания выращивать сильных инженеров в мире, где первый вариант решения стал почти бесплатным. #Career #Engineering #Software #Leadership #SelfDevelopment
-
edited SGLang: как структура программы ускорила LLM-инференс (Рубрика #AI) Продолжая тему vLLM и PagedAttention (что я разбирал раньше), решил продолжить статье «SGLang: Efficient Execution of Structured Language Model Programs». У vLLM вопрос был: как эффективнее размещать KV cache в памяти. SGLang делает следующий ход: как не вычислять заново точные префиксы, уже обработанные в предыдущих обращениях к модели. Команда Stanford, UC Berkeley, Shanghai Jiao Tong и Texas A&M смотрела не на отдельный запрос, а на целую LLM-программу: несколько вызовов модели, ветвление, параллельные генерации, общий контекст и структурированный ответ. Главная идея работы, опубликованной на NeurIPS 2024: если движок видит эту структуру, он может оптимизировать всю рабочую нагрузку. Базовые инженерные идеи здесь такие 1️⃣ Переиспользование — RadixAttention KV cache зависит от точной последовательности предыдущих токенов. SGLang хранит ссылки на него в radix tree — сжатом префиксном дереве — и находит самый длинный уже вычисленный префикс. GPU считает только хвост. Эффект: меньше повторной обработки промпта (prefill) и дубликатов в памяти, ниже задержка до первого токена, выше пропускная способность. Лучше всего это работает с длинными общими system prompts, few-shot примерами, повторяющимся RAG-контекстом и ветвями рассуждения. 2️⃣ Планирование вокруг дорогого состояния Сохранить кэш мало: им нужно воспользоваться до вытеснения. Поэтому планировщик предпочитает запросы с длинным совпадением, а LRU-механизм удаляет давно не использовавшиеся листья, на которые не ссылаются активные запросы. Эффект: больше попаданий в кэш и полезнее батч. Учёт на CPU невелик, но есть риск несправедливости: запрос без выгодного совпадения может ждать дольше. 3️⃣ Использование детерминизма Если на некотором участке грамматика JSON допускает только одно продолжение, сжатый конечный автомат (compressed FSM) склеивает этот участок и обрабатывает его за один проход вместо нескольких шагов. Для закрытых API авторы ещё предложили заранее генерировать текст после stop-маркера: если хвост совпадёт со следующей операцией программы, его можно переиспользовать. Интересно, но именно RadixAttention оказался фундаментом системы. В экспериментах авторов на их задачах SGLang давал до 6,4 раза большую пропускную способность, чем тогдашние Guidance, vLLM и LMQL. Это общий максимум от нескольких оптимизаций, а не множитель одного RadixAttention. Эффект кэша падает, если префиксы не повторяются или основное время уходит на длинную генерацию. Сегодня SGLang — уже не столько язык для LLM-программ, сколько полноценная система инференса. RadixAttention остался в ядре; поверх него появился многоуровневый HiCache: GPU → RAM → внешнее хранилище. Вокруг выросли непрерывное формирование батчей, страничное хранение KV cache, спекулятивное декодирование, разнесение обработки промпта и генерации, распределённый запуск, квантизация и OpenAI-совместимый API. Идея управляемого структурированного вывода тоже осталась, но исходный jump-forward на compressed FSM в 2025 году убрали ради упрощения кода. Теперь JSON Schema, regex и EBNF обслуживают отдельные грамматические движки: XGrammar по умолчанию, Outlines и llguidance. В общем, для меня эта статья продолжает историю vLLM. Производительность часто растёт не от более быстрых вычислений, а от правильно выбранной системной абстракции. vLLM навёл порядок в размещении KV cache и разделении общих блоков. SGLang автоматизировал поиск и повторное использование произвольных точных префиксов между вызовами и связал это с планированием. Оптимизировали не модель, а работу вокруг неё. #AI #Research #Software #Architecture #Engineering #DistributedSystems #Performance #SystemDesign
-
Stanford MS&E435: inference как производственная система (Рубрика #AI) После истории Google TPU и разговора с Dylan Patel про hardware-software co-design вторая лекция Stanford MS&E435 складывается в следующий кусок пазла. Она называется «The GPU Economy», но интереснее здесь не вопрос «какой чип победит?». Интереснее момент, в котором software становится производством: каждый новый запрос снова включает фабрику. Встречу ведёт Apoorv Agrawal, преподаватель курса и партнёр Altimeter. Гости — основатель фонда Brad Gerstner и Sunny Madra, бывший президент Groq, перешедший с частью команды в NVIDIA. Gerstner задаёт экономическую рамку, Madra объясняет железо. Оптика у разговора соответствующая: инвестор в AI-инфраструктуру и человек со стороны её поставщика, поэтому прогнозы и рыночные числа я бы держал с хорошим запасом скепсиса. Техническое ядро — inference как неоднородный workload. Prefill обрабатывает входной контекст, decode последовательно выпускает токены; разные части упираются в вычисления, память и latency по-разному. Поэтому вместо одного «лучшего GPU» появляется составная система: » GPU с HBM остаётся универсальной машиной для тяжёлых частей; » LPU Groq использует детерминированное выполнение, compiler-managed SRAM и предсказуемую задержку; » NVLink связывает ускорители, а runtime отправляет каждой архитектуре подходящую часть работы. По словам Madra, совместный прототип давал в 2,5 раза больше токенов при том же энергобюджете (правда, в лекции нет конфигурации и воспроизводимого benchmark, так что это заявление участника сделки). Но сам принцип уже виден в продуктовой архитектуре NVIDIA: Rubin GPU и Groq LPX проектируются как одна inference-система (подробнее можно почитать в анонсе про Groq 3 LPX) Не менее важна продуктовая часть. Groq не заставила разработчиков сначала полюбить новую архитектуру — она спрятала её за API GroqCloud. А затем вместо лобовой войны с NVIDIA команда разложила workload и нашла слой, где две архитектуры дополняют друг друга. Для deep tech совместимость с доминирующей платформой иногда сильнее чистой победы в benchmark. Кстати, в разговоре NVIDIA несколько раз «покупает Groq за $20 млрд». Формально всё тоньше: стороны заключили неисключительную лицензию, часть команды перешла в NVIDIA, а Groq осталась независимой и сохранила GroqCloud. В отчётности NVIDIA раскрыто $17 млрд совокупного вознаграждения и отдельно сказано, что акции, клиентские контракты и существующие продукты не покупались. По-факту, это покупка части интеллектуальной собственности + покупка команды. Дальше начинается экономика. Стоимость единицы inference падает, но reasoning и агенты делают больше шагов, вызывают инструменты, проверяют себя и работают часами. Поэтому удешевление токена не обязательно снимает дефицит GPU — оно может увеличить общий спрос. Почти парадокс Джевонса, только вместо угля мы сжигаем матричные умножения. Но здесь я бы поспорил с Gerstner: больше токенов ещё не означает больше ценности. Мы уже обсуждали token burn как proof of work и ненулевую предельную стоимость в AI pricing. Для продукта взрослая метрика — не tokens per task, а cost per verified outcome: полезный результат вместе с retries, review и rework. Тут есть даже непрямая связь с роботами. Для physical AI мало tokens per watt: нужны успешные действия на джоуль, p99 latency замкнутого control loop и доказанная безопасность. В разборе Waymo цена ошибки уже измерялась не токенами. И вот здесь «inference-фабрика» заканчивается не ответом в чате, а движением машины в физическом мире. Я бы смотрел внимательно отрезок примерно с 16-й по 35-ю минуту: там разговор перестаёт быть презентацией большого AI-будущего и становится хорошим обсуждением системной инженериеи. #AI #Engineering #Architecture #Infrastructure #Agents #Robotics
-
Заходите на прямой эфир про последние дни в компании, которые начинаются задолго до заявления. P.S. Кстати, сегодня я забрал свою трудовую книжку:)
-

JetBrains Developer Ecosystem 2026: что 15 509 разработчиков говорят об AI-агентах (Рубрика #AI4SDLC) JetBrains опубликовала срез десятого ежегодного Developer Ecosystem Survey. Опрос проходил с мая по июль 2026 года, в анализ вошли 15 509 профессиональных разработчиков. Было восемь языков, региональные квоты и статистические веса по региону, занятости, языкам программирования и знакомству с продуктами JetBrains. Что получилось: - 90% респондентов используют AI-агентов для разработки на работе хотя бы раз в неделю, 68% — ежедневно; - Claude Code вырос с 18% в январе до 39%. В США — 47%, а для 31% разработчиков это основной AI-инструмент; - GitHub Copilot снизился с 29% до 21%, Cursor — с 18% до 12%; - Codex вырос с 3% до 16%, а его узнаваемость — с 27% до 65%; - OpenCode набрал 7%, Google Antigravity — 6%, JetBrains AI Assistant и/или Junie вместе — 9%. Рост Claude Code и Codex — сильный рыночный сигнал: расклад рабочих инструментов быстро меняется. Но показатель использования здесь легко прочитать слишком широко. Заголовок говорит об агентах, но вопрос на графике шире: какие AI tools респондент использует на работе. В одном списке смешаны агенты, ассистенты и редакторы; ответы множественные, а показана лишь часть списка. Поэтому 39% и 21% — не доли рынка, не оплаченные лицензии и не телеметрия. Один разработчик мог отметить Claude Code, Copilot и Codex. С репрезентативностью тоже есть нюанс. Выборка большая, международная, квотированная и взвешенная, но вероятностного случайного отбора в опубликованных материалах нет. Был открытый opt-in-набор с призами, скидкой на лицензию и наградой за приведённых участников. Большое N уменьшает случайный шум, но не самоотбор — например, повышенный интерес к AI или JetBrains. Подробная ссылка из нового материала пока ведет на методологию опроса 2025 года. Для волны 2026 не опубликованы каналы рекрутинга, показатель участия, размеры страновых подвыборок, эффективный размер после взвешивания и обезличенные исходные данные. Поэтому 47% для США стоит читать осторожнее, чем глобальный результат. И еще: январские цифры взяты из AI Pulse, а летние — из Developer Ecosystem Survey. Это разные срезы, а не наблюдение за одними людьми. Можно говорить, что доля Copilot между опросами снизилась. Нельзя — что конкретные пользователи «перешли» в Claude Code или почему они это сделали. Так что я бы использовал исследование как рыночный радар, а не точный измерительный прибор. Claude Code вышел вперед среди показанных инструментов, Codex быстро набрал долю, прежние лидеры просели. Но для решения внутри компании нужен уже свой приборный щит: активное использование, принятые изменения, время ревью, доля переделок, инциденты и стоимость полезной задачи. Иначе глобальные 90% легко превращаются в еще одну красивую цифру внедрения без ответа на вопрос, что стало лучше. #AI4SDLC #AI #Agents #Research #Metrics #DevTools
-
Telegram doesn't show this post on the web. Open it in Telegram to see it.
-
Code of Leadership S2E15 - Последние 90 дней в компании начинаются до заявления (Рубрика #Management) Часть много говорят о первых 90 днях в новой роли. Мне захотелось разобрать обратную сторону перехода — последние 90 дней в компании. 31 августа в 17:00 проведу сольный эфир Code of Leadership где рассмотрю не только увольнение, но и все три равноправных исхода: остаться в пересобранной роли, перейти внутри компании или уйти. Поговорим о том, как не принять карьерное решение после одной плохой недели; понять, что именно перестало работать; описать следующую роль через ответственность, а не должность; проверить внутренние возможности и внешний рынок; выбрать исход и передать управление так, чтобы старая роль больше не зависела от вашего незримого присутствия. Отдельно разберу важную для руководителей часть: документ не равен переданному знанию. Сначала новому владельцу нужно передать право принимать решения, затем — контекст, отношения, рабочие ритмы и доступы. И дать ему начать управлять ещё до вашего последнего дня. Для меня главный тезис такой: последние 90 дней — это не обратный отсчёт до увольнения. Это управляемый переход между двумя профессиональными главами (если новое место уже выбрано) #Management #Leadership #Engineering #Career
-
Материалы 3 AImigo S1E3: почему AI дешевеет, а внедрение усложняется? (Рубрика #AI) Готовы материалы третьего выпуска 3 AImigo, который вышел 28 августа. Вместе с Евгением Сергеевым и Алексеем Литвиновым мы впервые сделали совместный новостной дайджест: не прошлись по ленте анонсов, а собрали шесть связанных сюжетов вокруг одного сдвига. Модели и их использование дешевеют, а собрать из них работающую AI-систему становится сложнее. Обсудили: - Почему рост личной продуктивности ещё не равен системному ROI — и как данные McKinsey возвращают разговор от скорости отдельного инженера к перепроектированию всего цикла поставки; - Почему, по нашей оценке, дефицит смещается в данные, интеграции с унаследованными системами и governance; фоном для этого сюжета стали июльская сделка SAP–Dremio и ранние сигналы Reuters о спросе на работу интеграторов; - Как улучшение price-performance расширяет число выгодных AI-сценариев и почему общий расход может расти даже при удешевлении каждого запроса; аналогия с парадоксом Джевонса здесь остаётся гипотезой, а не прогнозом; - Зачем enterprise-агентам control plane с управлением правами, бюджетами, размещением и сроками хранения данных, а также аудитом: возможности модели важны только внутри управляемого контура; - Как Cursor собирает цикл compute → model → harness/evals → code hosting → deploy → telemetry → correction — и почему часть этого полного цикла обратной связи из продакшена пока остаётся планом, а не готовой автономной системой; - Чему учат инциденты OpenAI и Anthropic во время cyber-evals: сочетание слабой изоляции, ошибочной модели окружения и реальных инструментов создаёт практический риск, но не доказывает «сознательный побег» агента. Все материалы выпуска: - Страница выпуска: конспект, таймлайн, факт-карточки и источники - Интерактивная дека - Видео: YouTube, VK Видео - Аудио: Podster, Яндекс Музыка, Apple Podcasts Если вы иначе видите главный сдвиг августа — поспорьте с нами в комментариях. И присылайте новости, которые стоит проверить в следующем дайджесте. #AI #AI4SDLC #Agents #Engineering #Management #Security #Podcast
-
Loop Engineering: агентный цикл как термостат, а не бесконечный bash (Рубрика #AI4SDLC) В июле мы уже разбирали Loop Engineering с Максом Смирновым, но у слова loop есть ловушка: оно заставляет смотреть на повторение, хотя инженерная ценность начинается с обратной связи. В 18-минутном докладе «Loop Engineering from First Principles» Kyle Mistele предлагает воспринимать coding agent не как prompt, засунутый в бесконечный bash, а как часть настоящего контура управления. Kyle — CTO и сооснователь HumanLayer, автор технических материалов про MCP, context и harness engineering. В его публичном профиле рядом стоят OSCP, distributed systems и вклад в vLLM и llama.cpp — полезный контекст для внимания к детерминированным границам. В докладе он опирается на внутренний кейс HumanLayer, а в финале приглашает попробовать опубликованный skill и присоединиться к компании. Поэтому это взгляд инженера-провайдера из собственной практики, а не независимое исследование рынка. Антипример — blind loop, который получает большую задачу и возвращает PR на 40 000 строк: формально агент сделал много, практически результат никто не хочет читать. Для команд, сложных кодовых баз и систем с реальными пользователями он возвращает loop к control theory и объясняет его через обычный термостат: - Set point задаёт желаемое свойство кодовой базы; - Sensor измеряет текущее состояние и ошибку относительно цели; - Controller выбирает следующее небольшое изменение; - Actuator — coding agent — вносит его; - Затем система проверяет результат и начинает новый оборот уже из нового состояния. Главная деталь — LLM здесь нужна далеко не везде. В примере HumanLayer постепенно переводит RPC procedures на Effect. ast-grep детерминированно находит старый паттерн, controller может выбрать самую маленькую процедуру, а агент переносит её по вручную написанным golden patterns. Базовый список нарушений хранится в Git, чтобы новые изменения команды не увеличивали долг. Одна итерация CI создаёт маленький PR; пока он открыт, следующий не появляется. Если человек оставляет /iterate, замечания попадают в versioned feedback-файл и меняют дальнейшее поведение цикла. Ту же схему Mistele в день доклада выложил как open-source skill. И вот здесь нужно сказать о том, что в день выхода видео другой сооснователь HumanLayer, Dex Horthy, опубликовал большой пост «Why Software Factories Fail». Dex объясняет, почему lights-off factory ломается даже с хорошим harness: тесты дают быстрый сигнал «работает сейчас», но цена плохого program design проявляется через месяцы. Надёжного быстрого verifier для maintainability пока нет. Примерно об этом он рассказывал в выступлении "Harness Engineering is not Enough: Why Software Factories Fail", о котором я рассказывал Получается важная граница. Если sensor видит только количество немигрированных RPC procedures, loop может идеально свести этот счётчик к нулю — и ничего не понять про архитектуру получившегося кода. Контур оптимизирует выбранный сигнал, а не наше невысказанное намерение. Поэтому Kyle и Dex не противоречат друг другу: - У Kyle человек уже присутствует в контуре: задаёт golden patterns, читает каждый небольшой PR, оставляет feedback и не разрешает работе бесконтрольно накапливаться. - Dex добавляет уровень выше: человек должен владеть самим set point и медленными переменными — product requirements, system architecture, program design и порядком vertical slices. Я бы смотрел и читал их парой. Kyle показывает механику: автоматизировать actuator и воспроизводимые проверки там, где они возможны. Dex ставит ограничитель: пока инженер по-прежнему выбирает, что считать ошибкой, и отвечает за код, к которому придётся вернуться через полгода. #AI4SDLC #AI #Agents #Architecture #Evals #Engineering #Software
-
Telegram doesn't show this post on the web. Open it in Telegram to see it.
-
Материалы выпуска с Антоном Костериным: как замкнуть AI-native SDLC? (Рубрика #AI4SDLC) Готовы материалы 29-го выпуска Research Insights Made Simple, который прошёл 27 августа. Вместе с Антоном Костериным — principal engineer RnD-центра Т-Банка — разбирали "The AI-Native SDLC Playbook" от Anthropic: что должно измениться вокруг кодинга, чтобы скорость агентов превратилась в скорость поставки. Обсудили: - Почему playbook ценен не принципиально новыми практиками, а тем, что собирает их в последовательность с примерами и шаблонами, — и почему это руководство поставщика нужно проверять в собственном контексте; - Как intent.md, spec.md и проверенный человеком plan.md превращают замысел в версионируемую цепочку артефактов и одновременно audit trail; - Зачем команде CLAUDE.md, skills, команды, hooks и специализированные агенты — и каких начальных вложений и организационного доверия требует такой контур; - Почему после ускорения Build ограничение переезжает в постановку, review, тесты или выпуск, а детерминированные проверки в CI/CD и continuous evals должны независимо ловить нарушения и повторные ошибки; - Где проходит граница автоматизации: hooks закрепляют проверяемые запреты, но review, инженерное суждение и принятие остаточного риска остаются за человеком; - Как Maintain замыкает цикл: инцидент может породить новый intent, а runbook — превратиться в ограниченный политиками агентный self-healing; экономику при этом полезнее считать по принятым задачам и предотвращённым переделкам, а не только по токенам. Все материалы выпуска: - Страница выпуска и слайды - Видео: YouTube, VK Видео - Аудио: Podster, Яндекс Музыка, Apple Podcasts - Текст: краткая расшифровка Спасибо Антону за разговор. Если после просмотра появятся вопросы — пишите в комментариях: соберу их для продолжения темы о том, как переносить AI-native практики в большие инженерные организации. #AI4SDLC #AI #Agents #Engineering #Architecture #DevOps #Research
-
Сергей Левин: почему акробатические трюки — плохой тест для робота (Рубрика #Robotics) В мае я начал рубрику про робототехнику с вопроса: где реальный инженерный прогресс, а где хорошо поставленное демо? Интервью Сергея Левина, опубликованное 24 августа 2026 года, даёт полезный критерий: эффектный бэкфлип иногда говорит о будущем роботов меньше, чем скучная работа с незнакомой чашкой в новой комнате. Левин — associate professor EECS в UC Berkeley и сооснователь Physical Intelligence. Его основной тезис: робототехника ещё не на стадии GPT-4/5, где рецепт уже найден и остаётся наращивать данные и модель. Отрасль всё ещё выясняет, какое сочетание архитектуры, данных и обучения масштабируется. По его оценке, компоненты уже появились, но вместе они ещё не дают предсказуемого роста. Это взгляд исследователя и одновременно ставка компании, которая строит базовые модели для роботов. Первый тест здесь — generalization, способность переносить навык в новые условия. Отрепетированный трюк проверяет конкретный навык, а полезный робот должен перенести его на новый предмет, помещение или другую конструкцию машины. По словам Левина, в тесте Physical Intelligence модель разъединила две случайно захваченные футболки и продолжила складывать одну — восстановилась после неожиданности. В другом она не смогла открыть ящик и стала убирать столовые приборы в духовку: не зависла, а выбрала осмысленное, но неверное продолжение. Так выглядит разрыв между впечатляющим поведением и надёжностью. За переносом стоит правильная программа обучения. Повторение одной сварочной операции научит робота лучше варить, но не сделает его универсальным: нужны разные задачи, среды, предметы и конструкции машин. Причём Левин предлагает не начинать с YouTube. Сначала широкий реальный опыт роботов должен дать модели физическую опору, а уже затем человеческие видео и симуляции могут расширять её знания. Это перспективная исследовательская гипотеза, а не установленный закон отрасли. Дальше важна модальность промежуточного шага. Язык задаёт последовательность задачи: открыть ящик, взять предмет, убрать его. Изображение или видео показывают следующее состояние сцены — куда нужно переместить руку и что должно измениться. По результатам команды Physical Intelligence, такая визуальная подцель помогает переносить навыки между разными роботами. Но вся гипотеза упирается в последние проценты. Даже условные 95% успеха означают ошибку в каждой двадцатой попытке. Левин считает, что этот участок потребует обучения с подкреплением на автономно собранном опыте. И здесь важна оговорка: в 13-часовом опыте PI, описанном Левиным и в статье команды, человек примерно раз в пять минут задавал высокоуровневую команду, включая уборку после ошибки. Это длинный прогон, но ещё не полностью автономная смена. У масштабирования есть и индустриальный слой. Отвечая на вопрос о Китае, Левин не говорит в терминах победитель/проигравший. Его урок в другом: модели не взлетают отдельно от производства, цепочек поставок, открытых разработок и доступного качественного железа. Масштабирование Physical AI — это вся система вокруг обучения модели. Прогноз у Левина осторожно оптимистичный: структурированные применения могут появляться уже сейчас, среды вроде дома — через несколько лет, вероятно раньше чем через десять лет. Но это прогноз, не план. И раздел про безопасность в интервью заметно слабее технической части: Левин предлагает выводить системы в мир, наблюдать и корректировать подход. Это не заменяет проверки, ограничения и доказательство готовности, о которых я недавно писал на примере Waymo. Эту запись стоит смотреть как инструкцию к следующему рободемо. Новый ли перед роботом предмет? Работает ли он в другой комнате? Как часто вмешивается оператор? Умеет ли система восстановиться после ошибки — и превратить её в данные? Именно эти вопросы стоит держать в голове, когда гуманоид снова красиво сделает бэкфлип. #Robotics #AI #Engineering #Research #Architecture
-
Telegram doesn't show this post on the web. Open it in Telegram to see it.
-
Приходите через 5 минут обсудить новости за август - у нас в 3 AImigo пройдет экспериментальный эфир, где мы обсудим интересные истории этого месяца.
- Older posts