Все советы Anthropic по разработке за "лето" Студентам советую раз в неделю читать что выходило свежего у OpenAI/Anthropic по разработке с помощью ИИ. На мой взгляд это сейчас самый передний край и проверенное. Лучше всяких ютюб-блогеров. Внутри у них ~80% смерженного кода уже пишет ИИ, инженеры шипят в 8 раз больше, чем в 2021–2025. И они довольно подробно рассказывают, как это устроено. Вот что, имхо, самое полезное было (в PDF подробно, можете почитать и отдать ИИ) 1. Узкое место теперь не написание кода, а проверка. Агенты генерят быстрее, чем люди ревьюят, поэтому все инвестиции – в верификацию. Практически: выписываете всё, что повторно исправляете за моделью, и кодируете в скиллы-проверки (.claude/skills) – агент сам гоняет тесты и чинит до сдачи. Сама команда Claude Code гоняет цепочку /code-review → /simplify → /verify, а потом те же проверки гейтом на каждый PR. 2. CLAUDE.md – короче 200 строк и без очевидного. Только точные команды тестов по подкаталогам (иначе модель запускает полный сьют на 40 минут) и то, что противоречит дефолтам модели. И пересматривать раз в 3–6 месяцев – правила под старые модели душат новые. 3. Разделение простое: пожелание – в CLAUDE.md, процедура – в скилл, закон – в хук. Линтер после каждой правки и блокировка rm -rf – только хуками, скилл модель может и забыть вызвать. 4. Ревью переразделили: ИИ – стиль, линтинг, отлов багов, тесты (несколько узких агентов, с каждой находки требуют доказательств – доля содержательных комментариев выросла с 16% до 54%). Люди – security, границы доверия, продукт. Автономному агенту – минимум прав: их инцидент-бот умеет писать доки и читать логи, деплоить – нет. 5. Самый огненный кейс – миграции. Bun перевели с Zig на Rust: миллион строк за 2 недели и ~$165k в токенах (раньше такое стоило $3–4 млн и 4 года). Рецепт: сначала тесты против обеих кодовых баз, потом rulebook правил перевода, дальше дешёвые модели переводят, дорогие ревьюят. Главный принцип – повторяющийся фейл это баг правила, а не файла: правишь rulebook и перегенерируешь, руками не патчишь. Я так переписывал gtfs.guru, скоро выложу мажорный релиз https://claude.com/blog

AI Product | Igor Akimov
-
-
edited Claude Security plugin вышел - https://claude.com/product/claude-security#beta Скачивать отсюда - /plugin install claude-security@claude-plugins-official Для продакшн сервисов маст-хев, аналогично codex security plugin. А то будет то же, что с huggingface случилось недавно, куда chatgpt новый полез за результатами бенчмарков :)
-
edited 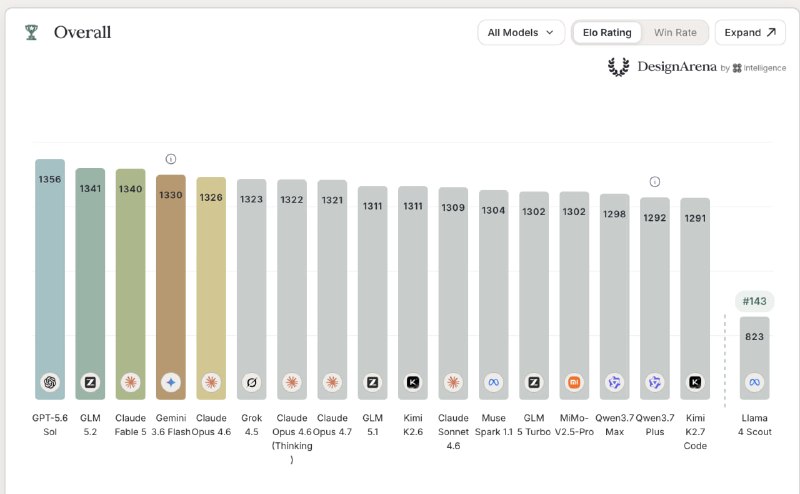
AI Design How-to Со студентами доводим до продакшена несколько сервисов и везде стоит вопрос дизайна. Все эти нейрослоповые веб-сервисы с зелено-фиолетовыми цветами и квадратиками всплывающими уже набили оскомину. Поэтому советую им такой вариант по росту сложности, но и потенциальному эффекту. 1. Поставить дизайн-скилл. Есть несколько хороших, мне нравятся https://github.com/Leonxlnx/taste-skill https://github.com/Nutlope/hallmark https://github.com/nextlevelbuilder/ui-ux-pro-max-skill Можно ставить все 3, можно выбрать лучший для ваших задач (не только сайты, но и документы и презентации, например) 2. Использовать Stitch от гугла для дизайна https://stitch.withgoogle.com/ Очень гибкая система с огромными лимитами на постройку/переделку сайтов/приложений 3. Просить сгенерировать дизайн ChatGPT Это один из лучших генераторов картинок на текущий момент и плюс - можно сгенерировать например сотню разных вариантов и потом выбрать лучшие идеи. Лимитов практически нет. Потом просто закинуть в ИИ-ку и попросить сделать вот так 4. Claude Design Вариант скорее для продакшн и больших студий с готовым брендбуком или когда вы точно знаете, что хотите. Старается максимально следовать вашим гайдам и делать хорошо не только сайты, но и презентации Но для маленьких сервисов и презентаций "на выкинуть" скорее оверкил, жрущий лимиты. Ну и в целом советую поглядывать или закидывать свои задачи на DesignArena и выбирать модель, что работает с вашими типа графики/визуализации лучше. Вот что на текущий момент получается: Веб-девелопмент (фронтенд) - GPT Sol Веб-девелопмент (фулстек) - Fable, Opus Гейм-девелопмент - Fable Android dev - Opus React Native - Opus SVG - Fable и спец-модель Arrow ASCII-ART - Fable Слайды - Fable и Manus Картинки/графика всех видов - GPT Image и Reve 2.1 Видео - Gemini Omni Flash Аудио - Gemini Сервисы для создания приложений с нуля - Replit (неожиданно), Emergent, Anything и только потом Lovable и прочие, в том числе где-то в серединке Figma Make и Canva https://www.designarena.ai/leaderboard Что ещё используете?
-

Бенчмарки Gemini 3.6 Flash в чуть более красивом виде. Ну-у, неплохо-неплохо https://deepmind.google/models/gemini/flash/
-


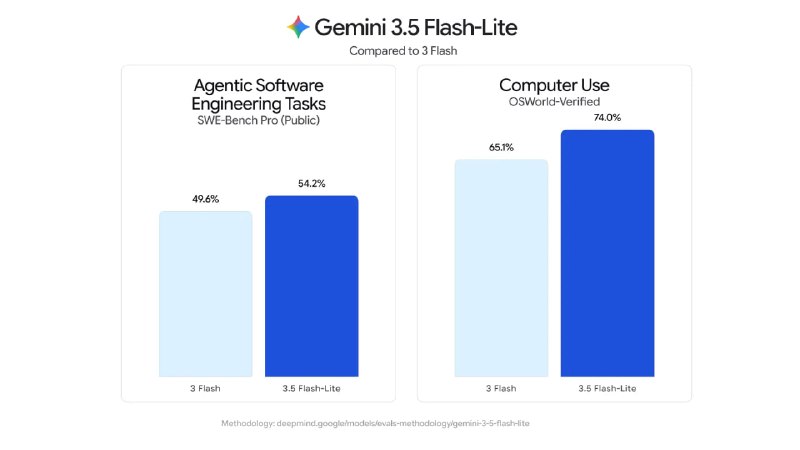
Google выкатил три новых Gemini: 3.6 Flash, 3.5 Flash-Lite и 3.5 Flash Cyber Пока все ждут 3.5 Pro (который задерживается – по слухам, из-за слабых результатов на кодинговых бенчмарках), Google усиливает свою «рабочую лошадку» – линейку Flash. Gemini 3.6 Flash – главный релиз: – на 17% меньше output-токенов по сравнению с 3.5 Flash (по Artificial Analysis Index), а на некоторых бенчмарках вроде DeepSWE – до 65% – меньше шагов рассуждения и tool calls в многошаговых агентных сценариях – цена ниже предшественника: $1.50 за миллион input-токенов и $7.50 за output (у 3.5 Flash было $9 за output) – в кодинге – выше точность, меньше лишних правок кода и зацикливаний – расширенные Frontier Safety-механизмы Gemini 3.5 Flash-Lite: – самая быстрая и дешевая модель класса 3.5: 350 output-токенов в секунду – $0.30 за миллион input и $2.50 за output – для высоконагруженных задач вроде перевода и модерации – обгоняет 3 Flash: SWE-Bench Pro 54.2% vs 49.6%, OSWorld-Verified 74.0% vs 65.1% Gemini 3.5 Flash Cyber – самое интересное: – специализированная модель для поиска, валидации и патчинга уязвимостей, построенная поверх 3.5 Flash – на V8 JavaScript Engine нашла 55 уникальных подтвержденных проблем против 47 у 3.5 Flash и 36 у Claude Opus 4.6 – доступ – только правительствам и доверенным партнерам через CodeMender в рамках ограниченного пилота – логика: дешевая и быстрая модель, которую агент может вызывать многократно, покрывая больше путей в коде 3.6 Flash и 3.5 Flash-Lite уже доступны в приложении Gemini и в AI Studio / Vertex AI. В целом гугловские модели - отличные рабочие лошадки, много где использую, надо обновляться с 3 и 3.5-flash https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-6-flash-3-5-flash-lite-3-5-flash-cyber/
-
edited Открытые модели догнали фронтир – и это плохая новость для Anthropic Хорошая статья и правильные мысли. Пострадает от китайцев в первую очередь Антропик. Вот почему: – Главная статья расходов после обучения – инференс, то есть использование видеокарт и электричество – Три стратегии: арендовать дата-центры (Anthropic, Moonshot, Knowledge Atlas), строить свои (Meta, Alibaba) или владеть и генерацией, и дата-центрами (SpaceX) – Чем больше стека ты контролируешь, тем больше переменных затрат превращаются в фиксированные – и тем быстрее растет маржа с ростом использования – Если инфраструктуры нет, твои затраты масштабируются вместе с выручкой – маржа не растет Почему Anthropic в уязвимой позиции – Компания без собственной инфраструктуры выживает только за счет спроса на модели: нужно быть либо лучшей, либо дешевой и «достаточно хорошей» – Fable 5 – лидер по качеству, но почти в 3 раза дороже конкурентов в пересчете на выполненную задачу (данные Artificial Analysis) – Ставка на продукты-«харнесы» (Claude Code, Cowork) рискованна: барьер входа в этот сегмент почти нулевой. – У OpenAI, наоборот, модели немного слабее, но есть более понятные защиты вокруг: консьюмерский продукт, голос, железо и готовность инвестировать в собственные дата-центры В 2025-м открытая модель догнала фронтир один раз – сейчас это делают сразу несколько лабораторий (GLM 5.2, Kimi K3, Qwen 3.8). Это уже устойчивый паттерн: догоняют, конкурируют и, возможно, скоро начнут обгонять – особенно с учетом цены Вывод автора: model-only компании (Anthropic, Moonshot, Knowledge Atlas) стратегически проигрывают тем, кто владеет инфраструктурой и дистрибуцией – OpenAI, Alibaba, Meta, Google, SpaceX. Текст хороший, но с одной слепой зоной: автор недооценивает энтерпрайз-инерцию. Компании, которые уже встроили Claude в свои процессы, комплаенс и безопасность, не мигрируют на открытую модель из-за 3-кратной разницы в цене инференса – стоимость переключения выше. Но часто задают вопрос: «а можно то же самое на open-source в нашем контуре?» Раньше честный ответ был «нет». Приходилось либо мириться с "глупостью" опенсорса, либо анонимизировать данные. После Kimi K3 и Qwen 3.8 кажется ответ все чаще будет «да, и возможно даже дешевле» (если конечно у вас есть деньги на серверную стойку). https://www.emergingtrajectories.com/lh/frontier-lab-economics/
-
Почему стоит держаться подальше от OpenCode Интересный обзор от инженера Luke Wren. Автора бесит и качество работы, и безопасность. 1. Тратит ваши деньги впустую Когда агент общается с LLM, провайдеры (Anthropic, OpenAI) умеют кешировать уже отправленный контекст: повторно те же токены стоят в разы дешевле. Но кеш работает только если начало разговора не меняется ни на символ. OpenCode ломает это постоянно: перечитывает одни и те же файлы заново, вставляет в промпт текущую дату (изменилась минута – кеш умер), выкидывает куски контекста без необходимости. Итог – вы платите полную цену за токены, которые могли стоить копейки. Вторая беда – обрезка контекста. Если прервать агента на полпути, он может «забыть» важное – например, спеку проекта, которую вы ему скормили. Дальше он работает, не помня, что вообще нужно было сделать. Плюс мелочи: с подагентами нельзя пообщаться, когда они тупят, интерфейс в терминале жрёт память, ломает многострочный ввод и не поддерживает базовые шорткаты редактирования. 2. Это дыра в безопасности AI-агент выполняет команды на вашем компьютере. Чтобы он не натворил дел, ему нужны ограничения – «вот это можно, вот это спрашивай у пользователя». Вопрос в том, как эти ограничения устроены. OpenCode проверяет команды по тексту: смотрит на строку, которую агент хочет выполнить, и решает, опасная она или нет. Например, можно запретить команды git. Проблема: shell – это полноценный язык программирования, и одну и ту же команду можно записать бесконечным числом способов. Автор показывает десять обходов, вот пара для понимания: – echo 'git clean -fdx' | bash – формально это команда echo, «безобидная». Но она передаёт запрещённый git прямо в shell, и тот выполняется – python3 -c 'import subprocess; subprocess.run(["git", "checkout", "."])' – формально это python, а не git. Фильтр пропускает То есть запрет работает только против агента, который не пытается его обойти. А LLM может обойти его даже случайно, просто потому что так «удобнее» написать команду. Дальше хуже. Кнопка «Always» (разрешить навсегда) запоминает разрешение слишком широко: один раз одобрили безобидный echo hello – и теперь агент может выполнить echo 1 > /sys/class/gpio/gpio21/value. Это уже запись в системный файл. Перенаправление вывода (>) вообще не проверяется. И на десерт: у OpenCode уже был CVE – уязвимость, при которой можно выполнять произвольные команды на машине пользователя. Показательно, как закрыли issue об этом: его закрыл бот для «протухших» тикетов. Не человек, разобравшийся в проблеме, – бот, который чистит старые обращения. Автор говорит: фильтровать команды по тексту – бесполезно в принципе, это "и так сойдет", а не безопасность. Настоящая изоляция делается средствами операционной системы: Landlock в Linux, Seatbelt в macOS – механизмы, которые физически не дают процессу трогать файлы за пределами разрешённых. Тогда неважно, как хитро записана команда, – ОС просто не даст ей навредить. Стоит прочитать целиком, если пользуетесь, особенно раздел с обходами правил безопасности. https://wren.wtf/shower-thoughts/stop-using-opencode/
-
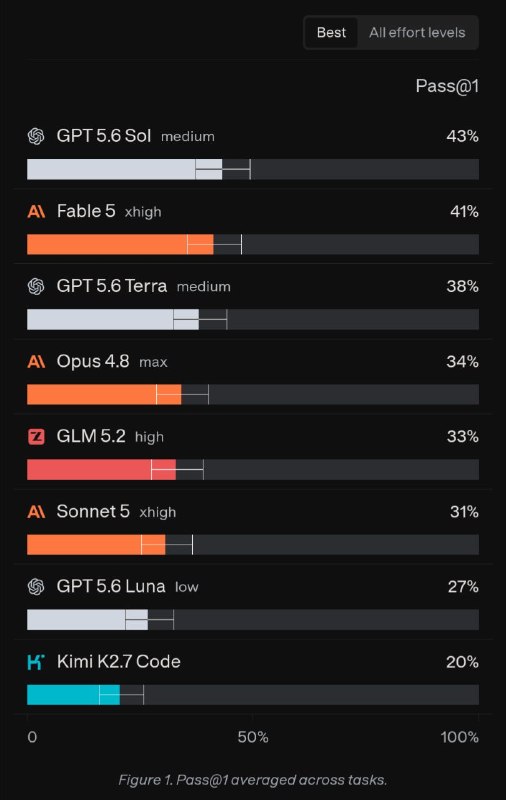
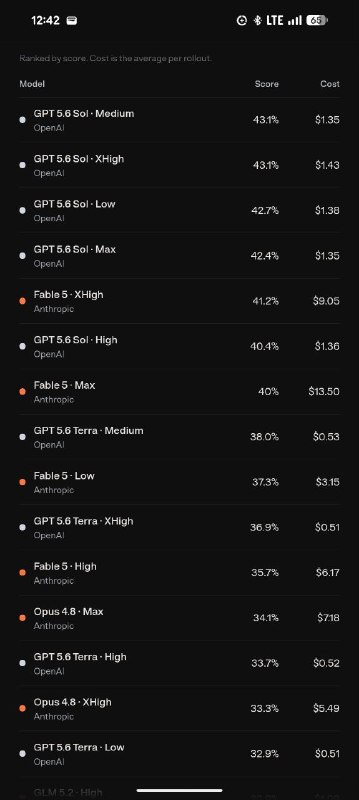
Новый бенчмарк создателей react. Проверяют еще плюсом производительность и качество кода. 5.6 Sol Medium уделывает Fable xhigh. Тратит при этом $1.35 на тест, а не $9 https://www.reactbench.com/
-
edited 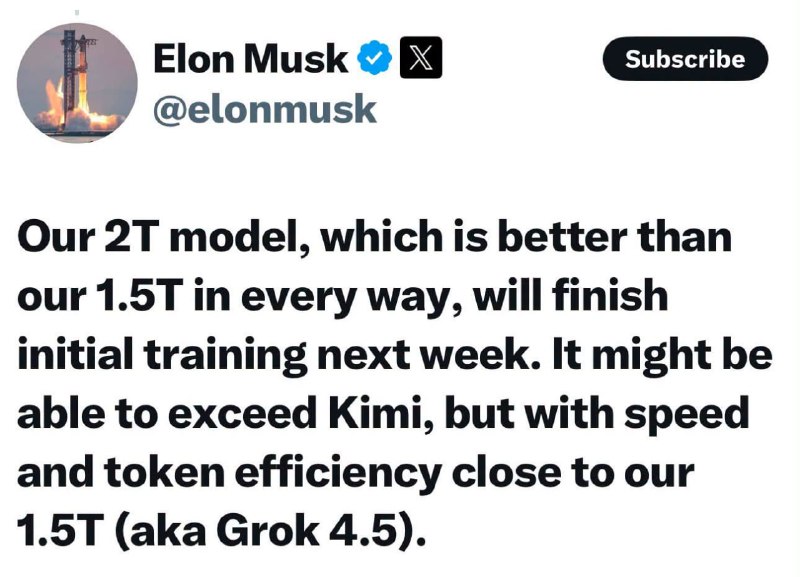
Grok тоже не сидит сложа руки. Обещают эффективность (возможно) уровня Kimi K3, но скоростью и эффективность текущего Грока 4.5 (а он правда очень быстрый) Вообще выход K3 конечно подвзорвал всем недельку. Грубо говоря если ты взял миллионы/миллиарды баксов на закрытую модельку, а тут 27 июля выложат веса открытой, которая входит в топ-3 в мире и которую создала команда с ресурсами в 100 раз меньше и частично на китайских чипах, при этом плевала на экспортный контроль, то как-то начинает пахнуть жареным. Посыпятся оценочки ИИ-стартапов.
-
edited 
Доступ останется к Fable, но только у 100-баксовых планов и выше. Конкуренция-таки давит на жуков Anthropic. Если нужен план за 20, то лучше остаться на ChatGPT. Интересно, сколько пользователей они потеряют.
-
edited 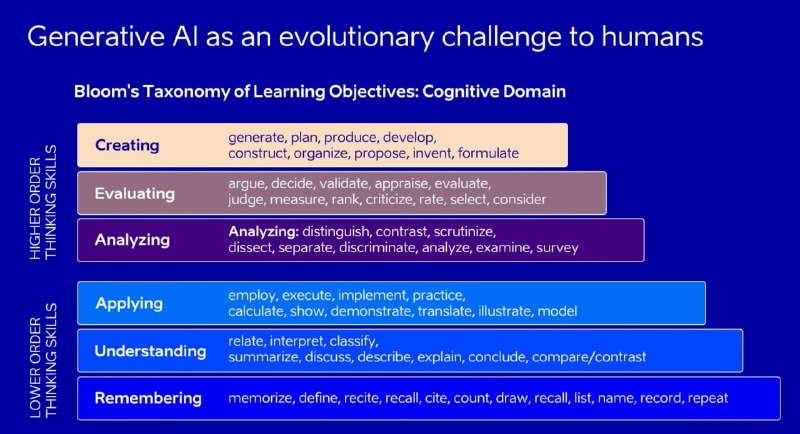
Чему учиться, когда ИИ уже умнее? Министр образования Эстонии ответила на этот вопрос за 13 минут – лучшее, что я видел про ИИ в образовании. Главное ниже, но видео стоит посмотреть целиком. Проблема – Ещё в 2017-м ОЭСР выяснила: у 2/3 работников грамотность, счёт и цифровые навыки ниже возможностей тогдашних компьютеров – Отсюда неудобный вопрос: зачем развивать мышление, если компьютер справляется лучше? Может, бросить учиться? Что происходит с мозгом – Мозг работает в двух режимах. Низший – память, понимание, применение, «автопилот». Самый дешёвый по энергии, поэтому мозг его обожает – Высший – анализ, оценка, созидание. Выматывает сильнее марафона: после сложного экзамена ты «мёртв» физически – Школа 200 лет тренировала только низший: «запомни – пойми – примени – сдай тест» – ИИ уже умеет всё нижнее и почти всё верхнее. Человеку остаются этическая оценка и настоящее созидание – вкус, насмотренность, опыт Что делать – Осознанно тренировать людей постоянно быть в высших когнитивных процессах – начиная с 12–13 лет – Делать это вместе с ИИ: именно он выталкивает с автопилота. Без него школа скатится в зубрёжку, а ученики – в brain rot и когнитивный аутсорсинг, когда домашка просто списывается. То же самое, кстати, делают «взрослые» с презентациями, которые даже не просматривают глазами Что сделала Эстония – программа AI Leap – Запуск в феврале 2025-го, пилот в 10–11 классах, с сентября 2026-го – профобразование – ИИ-тьютор по методу Сократа, созданный с OpenAI: не отвечает, а ведёт вопросами – Финансирование 50/50 – государство и бизнес, управляет фонд: «министерство – не место для инноваций» – Абсолютный фокус – подготовка учителей Кажется, закрыл для себя вопрос, чему и как учить сына. И лишний раз убедился: самые полезные для образования и государства системы сегодня делают лаборатории уровня OpenAI и Anthropic – а не консалтеры, учёные или блогеры. https://www.youtube.com/watch?v=44St9MoJU0E
-
edited 
По бенчмаркам Kimi K3 на разные темы тоже в топе, обошла Sol, и только чуть отстаёт от Fable. То есть можно наконец независимым провайдерам предлагать модели топ уровня. Иметь "свой Fable у нас дома". https://www.vals.ai/models/kimi_kimi-k3
-
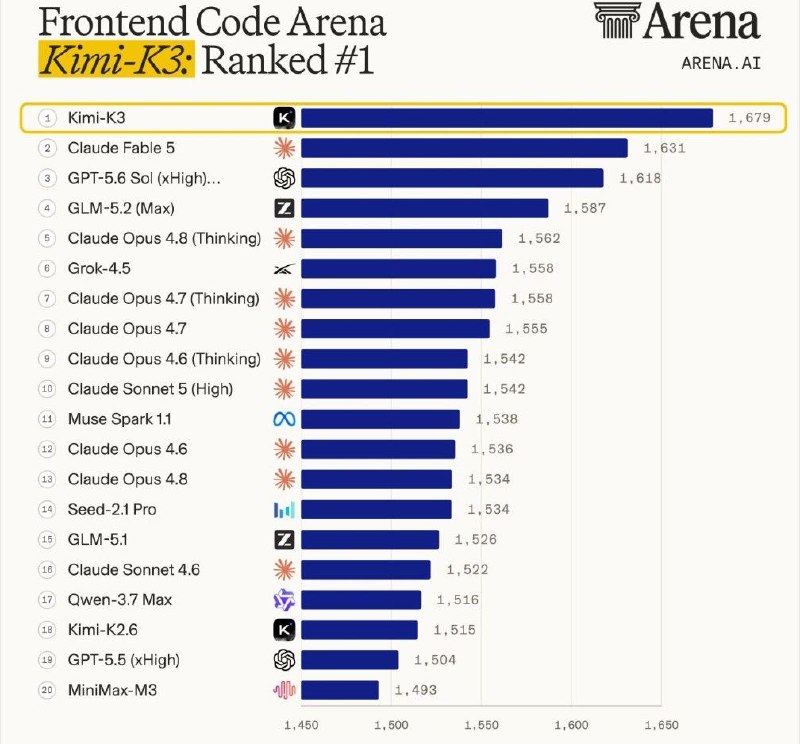

Удивительно, конечно... Новая открытая китайская модель Kimi K3 - лидер в разработке сайтов... Офигеть
-
edited 
Claude тоже сбрасывает лимиты, на fable тоже :)))))
-
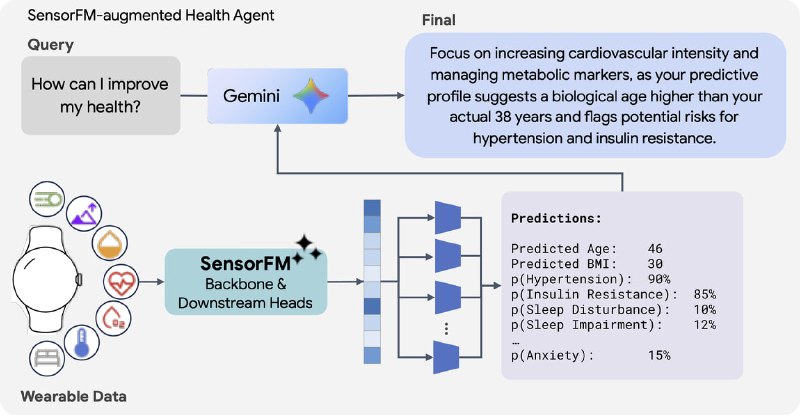

Не LLM единым. Новые модельки для таблиц и данных с сенсоров от Google Вышли уже "давно", аж 2 недели назад, но выглядят очень неплохо и решают проблему "ща запихну все в LLM она разберется" (не разберется). SensorFM обучена прямо на сырых сигналах с носимых устройств, всяких фитнес-браслетов – без перевода в текст. Триллион минут данных от 5 млн человек: пульс, кислород, сон, движение, температура. Бонус: снял часы – модель не ломается, пропуски для неё нормальная часть сигнала. Результат: на 34 из 35 медицинских задач бьёт модели, которые эксперты годами настраивали вручную. В том числе "ща закину все в Claude - она все офигенно поймет". Лучше всего ловит то, что по одному пульсу не видно – депрессию и тревожность. TabFM – то же самое для таблиц. С таблицами всегда была беда, слишком много надо учитывать. И к тому же много классических алгоритмов, которые "били" всех LLM-новичков. А табличные данные - это ж кровь бизнес и аналитики. Обычный путь: дата-сайентист неделю чистит данные, придумывает признаки, тюнит XGBoost. Здесь – кидаешь таблицу как есть и сразу получаешь прогноз, без обучения вообще. Забавная деталь: модель ни разу не видела реальных данных – её обучили на сотнях миллионов сгенерированных таблиц. И этого хватило, чтобы догнать тюненные классические модели. Скоро будет прямо в BigQuery одной SQL-командой. Крайне рекомендую. В общем, не забывайте, что LLM «думают» текстом. Скормить ChatGPT год показаний пульсометра или таблицу на 100 тысяч строк – значит превратить числа в текст. Модель такое читает как рассказ, а не как данные: структура теряется, числа она толком не «чувствует», а контекст забивается мгновенно. Пользуйтесь специализированными решениями. Тем более они уже реально хороши https://research.google/blog/sensorfm-towards-a-general-intelligence-and-interface-for-wearable-health-data/ https://research.google/blog/introducing-tabfm-a-zero-shot-foundation-model-for-tabular-data/
-
Прикольно. Можно написать твит про Codex, сравнить его с другими моделями и получить 100 баксов на счет OpenAI. Нужно быть действующим подписчиком хотя бы Go плана. Действует для первых 10000 участников. Вот здесь просить $100 - https://switch-to-codex.openai.chatgpt.site/#submit-post Расчехлил свой твиттер и запостил :) https://x.com/akimovpro/status/2077360804333015551 На самом деле действительно GPT-5.6 дает примерно в 2 раза больше использований при примерно том же уровне интеллекта. Творческие и текстовые/документные задачи все еще делает лучше Fable, но типичные рабочие вещи и кодинг задачи можно отдавать Codex и не бояться, что у тебя сожрутся лимиты или Fable отберут на днях... Короче, OpenAI перехватывает инициативу. Ну и 17 июля ждем Gemini 3.5 Pro
-
ИИ-агенты понимают, получится ли у них код, ещё до того, как его напишут Вышла интересная работа: исследователи заглянули во внутренние состояния coding-агентов и попробовали понять, что модель уже «знает» про код, над которым работает. Масштаб нормальный: – две открытые модели: Qwen3.6-35B-A3B и Laguna-XS.2 – 1231 задача из SWE-Bench Verified и Pro – 22 714 запусков агента – почти 80 тысяч изменений кода – медианная попытка – 52 шага и 36 тысяч токенов К внутренним состояниям модели подключили простую логистическую регрессию, то есть простой классификатор. И он смог определять: – полностью ли работает код – AUC до 0,83 – стало ли упавших тестов меньше – до 0,84 – компилируется ли код – до 0,78 – не сломал ли агент уже работавшие тесты Здесь 0,5 – случайное угадывание, так что сигнал довольно сильный. Причём лучше всего он читался не из последнего слоя модели, а примерно из середины. Но самое интересное – можно было частично предсказывать не только текущее состояние кода, но и будущее! По тому, что происходило внутри модели сейчас, исследователи угадывали, будет ли код рабочим примерно через 25 шагов. К этому моменту AUC падал до ~0,55 на SWE-Bench Verified и ~0,65 на более сложном SWE-Bench Pro, но всё ещё оставался выше случайности. Слабый сигнал сохранялся даже через 50 шагов – около 0,52 и 0,60 соответственно. Авторы назвали это latent programming horizon. Важная оговорка: шаг – это не обязательно новая правка. Агент может читать файлы, искать по проекту и запускать тесты. В медианной траектории было всего два реальных изменения кода. Поэтому речь не о том, что модель заранее держит в голове готовый патч. Скорее, она довольно рано понимает общее направление: задача реально чинится или агент уже куда-то не туда поехал. Практический смысл хороший: можно раньше останавливать провальные попытки, запускать параллельную ветку, повышать effort или подключать более сильную модель – до того, как агент сожжёт десятки тысяч токенов. Короче, код ещё не написан, а модель уже немного понимает, получится он или нет. Следующий шаг – научиться не просто читать этот сигнал, а использовать его, чтобы рулить агентом. Вот это будет прикольно. https://arxiv.org/abs/2607.05188v1
-
«Контролируйте идеи, а не код» Сальваторе Санфилиппо (antirez) – создатель Redis, одной из самых популярных баз данных в мире, написал провокационную статью. 20+ лет пишет код руками и славится его качеством. И вот он публично заявляет: проверять код, написанный AI, больше почти не имеет смысла. Мысли на самом деле очень схожие с тем, что переживаю сам: Раньше главным продуктом программиста был код. Теперь AI пишет код быстрее и в таких объёмах, что человек физически не успевает его читать – тысячи строк в день. Рабочий день не резиновый. Поэтому роль разработчика меняется: вместо «писать и вычитывать код» – придумывать, как устроен продукт, какие в нём идеи, куда он развивается, и тщательно тестировать результат. Antirez называет это «контролировать идеи». Это не «вайб-кодинг», когда просто просишь AI «сделай мне приложение» и надеешься на лучшее. Нужно глубоко понимать, что ты строишь, и проверять именно замысел: «объясни, как работает эта часть?» – а не вычитывать каждую строчку. Сам он код для Redis всё ещё проверяет, но честно признаёт: современные модели (упоминает Claude Fable и GPT 5.6) находят больше ошибок, чем он сам. Продолжает по одной причине – из уважения к людям, которые будут открывать эти файлы руками. Вместо ревью он предпочёл бы тратить время на документ с описанием идей: как устроена каждая часть системы, какие в ней хитрости и почему так. Тогда следующий человек (или AI-агент) сможет менять код, понимая замысел Интересный контраргумент критикам AI: софт был полон мусора и ошибок задолго до нейросетей. Он сам находил в популярных инструментах тонкие баги, которые годами никто не замечал. Так что «раньше было качественно» – миф. Единственная оговорка – новички. Им всё равно нужно научиться программировать на практике, иначе не появится то самое понимание, без которого «контролировать идеи» невозможно. Короче, ценность смещается от «умею написать» к «понимаю, что и зачем строю». Это касается не только разработчиков – та же логика скоро доберётся до юристов, аналитиков, маркетологов. Но есть ловушка: отпустить рутину можно, только если экспертиза уже наработана. Остальным надо будет до этого уровня сначала дорасти. https://antirez.com/news/169
-

А OpenAI убрал 5-часовые лимиты 😱, сделал более токено-эффективным Сол и ещё и скоро сбросит всем лимиты. Вот что конкуренция делает.
-
Красивое... И за 500 баксов в месяц. Все меньше надежд на профессии физического труда. https://youtu.be/QRyXV3csReA?is=RCH8Pey85SeFRPEz
- Older posts