
Ну, ок :)

Ну, ок :)
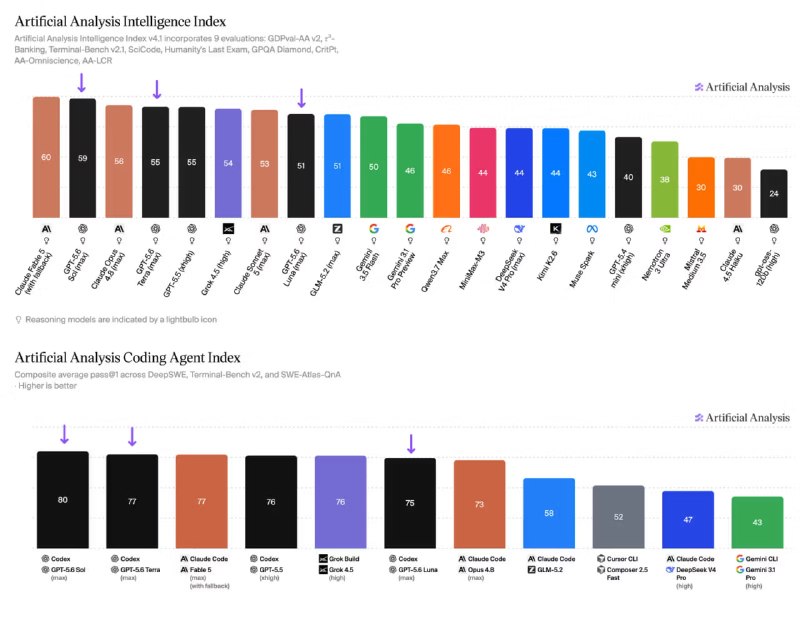
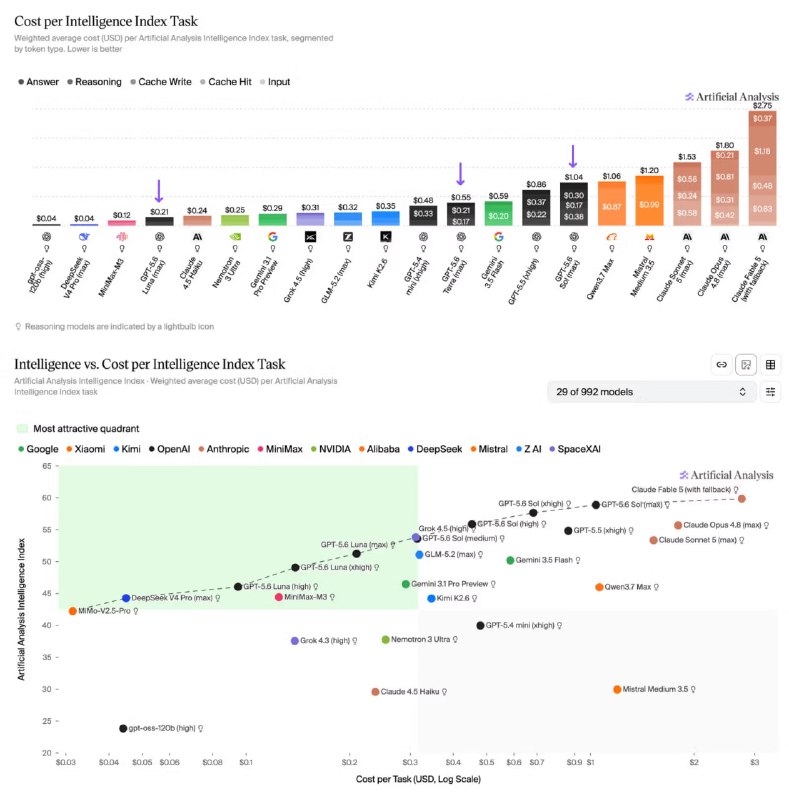
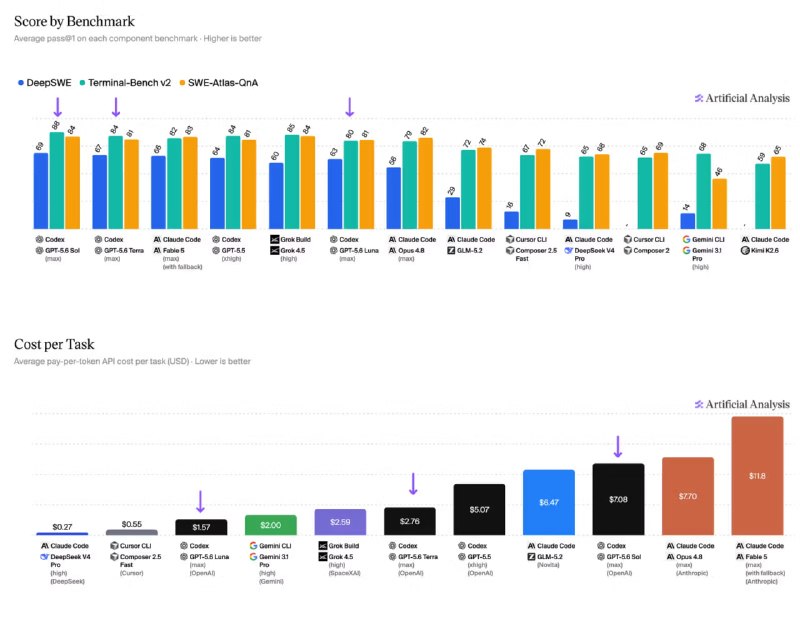
Тесты GPT-5.6 Artificial Analysis На втором месте по общим баллам, на 1 месте по кодингу (даже Terra обходит Fable 5) По стоимости двигает парето-фронтир, то есть практически на любую цену за задачу находится какая-то комбинация модели и уровня размышлений от OpenAI, что лучше, чем известные модели. Причем дешевая Luna на high и выше практически не имеет конкурентов в "дешевом" сегменте, а дальше лучше использовать Sol, а не Terra. По офисным задачам чуть хуже Fable 5, по хардкорной науке тоже, но презентации делает лучше всех. Остальное все либо на уровне, либо выше. Короче, за такую цену и без всяких там глупостей типа "только 50% лимитов можете гонять" - офигенные модели выпустили. https://artificialanalysis.ai/articles/gpt-5-6-has-landed
А Claude взамен обнулил всем лимиты, часовые и недельные, хах :)
GPT-5.6 доступны всем желающим и они хороши! 2 недели была на ревью у государства. По бенчам всех порвала. – Sol бьёт Claude Fable 5 на агентских бенчмарках (+13 пунктов на Agents' Last Exam) – при вдвое меньшем времени и цене – Terra и Luna обгоняют Fable 5 в ~16 раз дешевле – Новый режим ultra – 4 параллельных агента из коробки для сложных задач – Заметный скачок в дизайне и презентациях: модель сама смотрит на результат через computer use и доводит его По кибербезу крутая, а потому тоже вводят trusted access. А всех остальных на таких запросах блокируют. И объединили вместе chatgpt и codex, добавили а-ля артефакты, прокачали офисные задачи. Короче, переманят всех с Клода. На месяц-два будет лидировать, можно агрейдить подписку. https://openai.com/index/gpt-5-6/

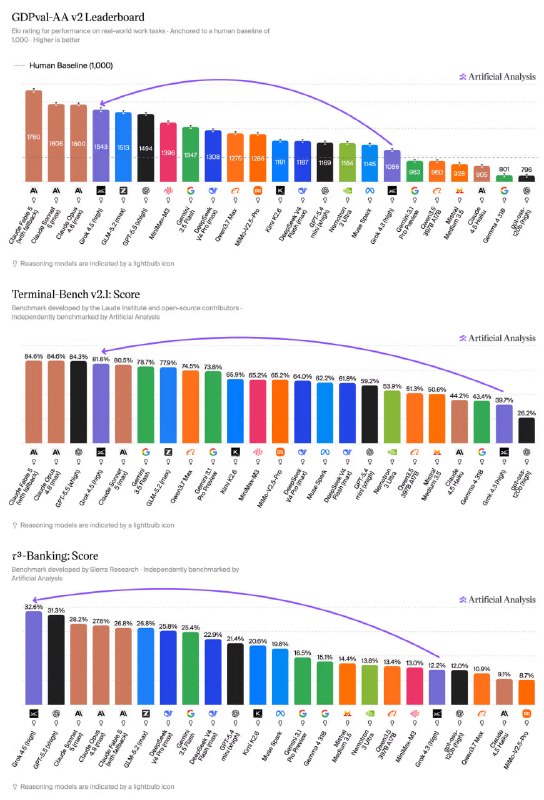
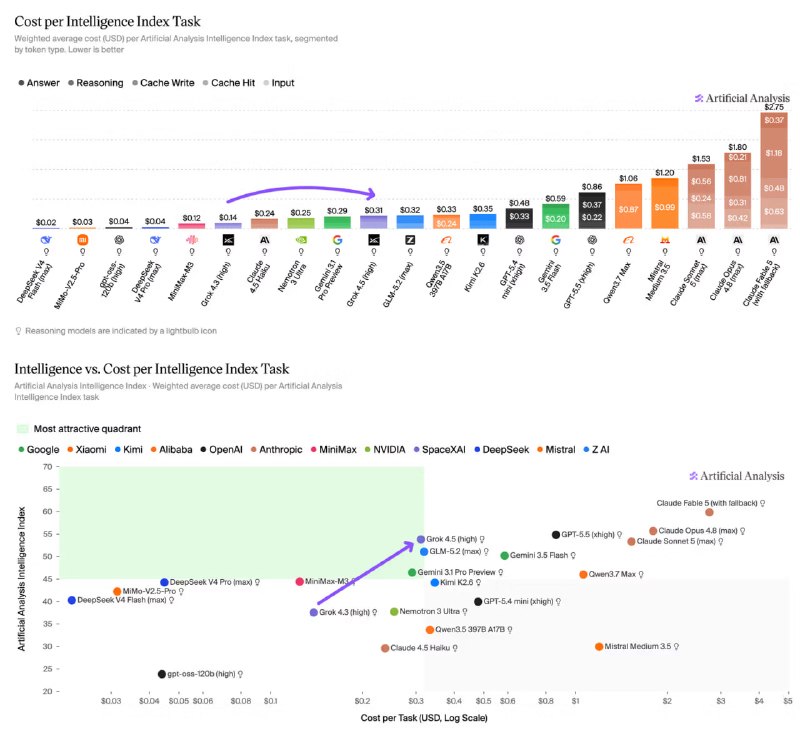
И посмотрел более широкие тесты Grok. Ну-у... Входит все-таки в высшую лигу ) По общему интеллекту на 4 месте, по кодингу на 3, обходя Opus 4.8. По решению офисных задач на 4 месте, чуть уступая Опусу. При этом стоит порядка 30 центов за задачу (на уровне GLM-5.2), в 3-8 раз дешевле флагманов. https://artificialanalysis.ai/articles/grok-4-5-brings-spacexai-to-the-the-intelligence-frontier


Meta (запрещенная в России) больше не играет в опенсорс, а делает сильные модели Meta представила Muse Spark 1.1 – мультимодальную reasoning-модель, заточенную под агентские задачи. И апишку под нее. По бенчмаркам как-то прям очень хорошо, и заявляют еще, что прокачали агентские сценарии: модель работает как оркестратор мультиагентных систем – собирает контекст, строит план и раздает задачи параллельным субагентам. В роли субагента понимает свои инструменты и знает, когда эскалировать обратно. Плюс хорошо поддерживает новые нативные тулы, MCP-серверы и кастомные скиллы Контекст 1 млн токенов с активным управлением: модель сама сжимает историю. – Computer use довольно неплохо поднялся: научили модель выбирать между скриптом и кликом – писать автоматизацию, когда это быстрее, и работать с интерфейсом напрямую, когда проще – Кодинг: заметный рост на реальных задачах в больших кодовых базах – багфиксы, фичи в enterprise-системах, крупные миграции. Ну и она мультимодальная: картинки, документы, видео. Цены детские: 1.25 за вход и 4.25 за выход Короче прям жарищща пошла. Ждем сегодня GPT-5.6 https://ai.meta.com/blog/introducing-muse-spark-meta-model-api/
Прикольная штука от Cloudflare - закинь архив или папку со статичным сайтом и его захостит cloudflare. Такой типа однокнопочный хостинг для простых сайтов. Как раз делиться результатами всяких ИИзысканий https://www.cloudflare.com/drop/


День релизов. Microsoft свой движок визуализации данных представляет - Flint Просишь агента описать диаграмму кодом (типа mermaid-диаграмм) и получаешь.красивый визуал. 46 типов, больше 80 примеров. Красивое. https://microsoft.github.io/flint-chart/#/gallery/vegalite
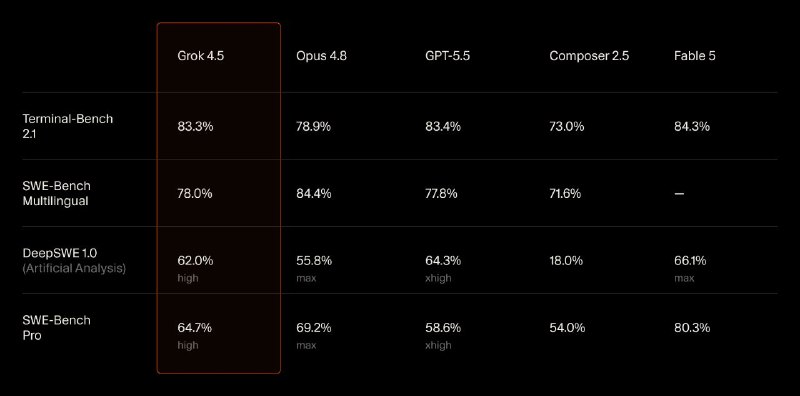
Grok 4.5 — Cursor выходит за пределы кода, но пока выглядит не как фронтир Cursor выпустил Grok 4.5 совместно со SpaceXAI. Это их самая мощная модель и первая, заточенная не только под код. - Длинные задачи не только в разработке, но и в data science, финансах, юр. работе - MoE, обучение на триллионах токенов данных Cursor - RL на задачах, которые валят даже фронтир-модели; обучающие среды строит распределённая система агентов - Кибербез: обновили блокировку злоупотреблений, но подчёркивают — интеллект тихо не режут и на другую модель не откатывают • Доступна сегодня (desktop, web, iOS, CLI, SDK). База: $2/$6 за M токенов, fast: $4/$18, в 3-5 раз дешевле топов. И это конечно прекрасно. Кстати, CursorBench исключили из сравнения, старый снапшот их кодбазы попал в обучение. Смотрю на бенчмарки и как-то ожидания были повыше... Не все уже решает миллион GPU. Собственно поэтому топовым инженерам так много платят. Но конкуренция - всегда хорошо. И цены сказочные. https://cursor.com/blog/grok-4-5
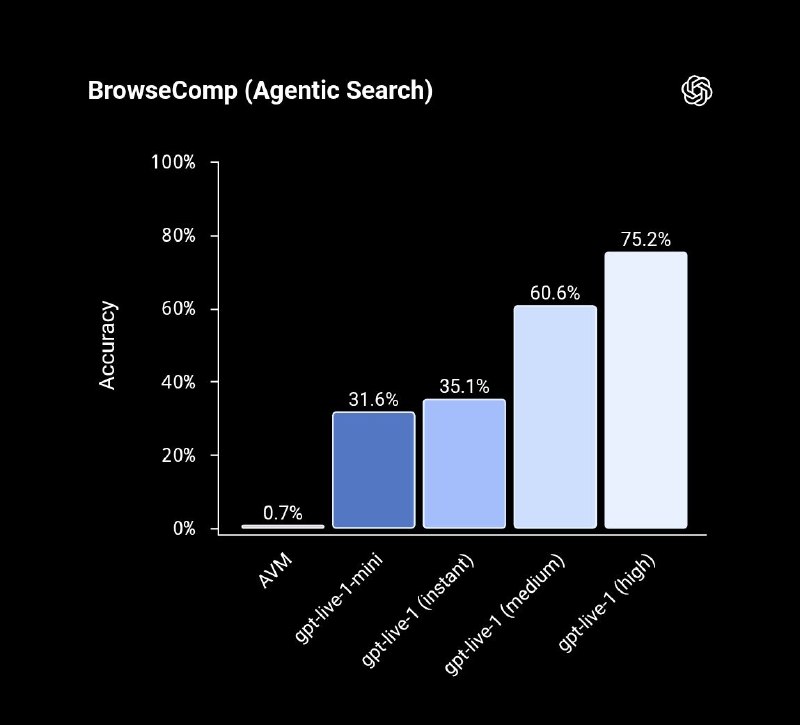
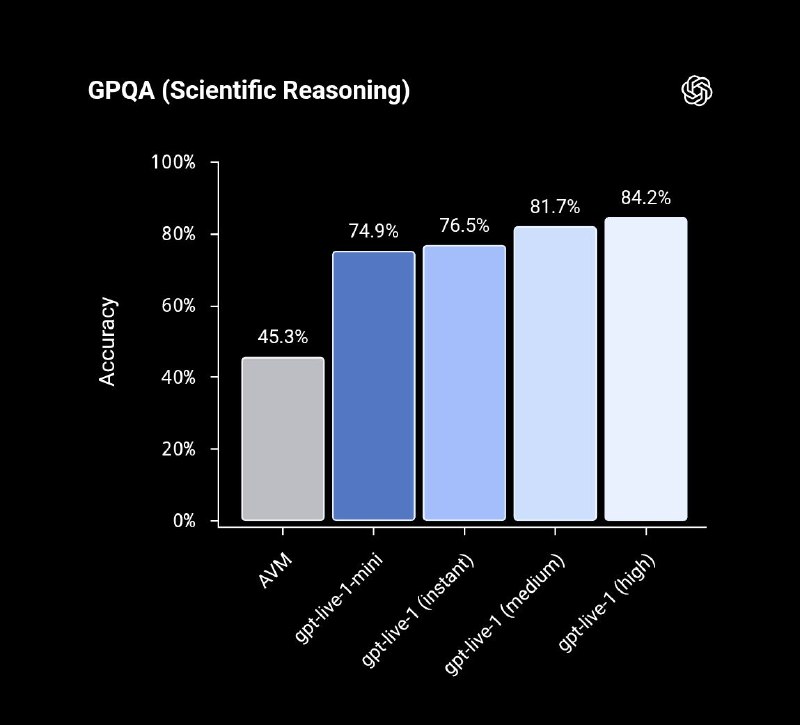

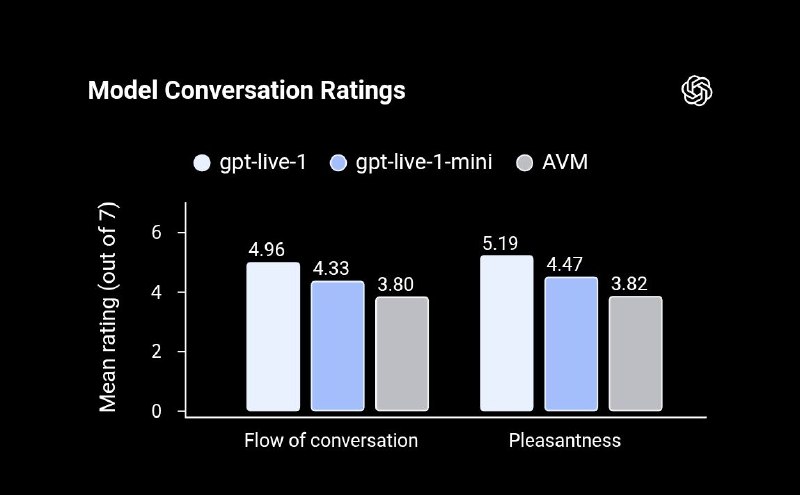
GPT-Live: OpenAI переводит голос на full-duplex OpenAI выкатила GPT-Live — новое поколение голосовых моделей под капотом ChatGPT Voice. Сменили архитектуру (как у стартапа thinking machines, писал тут https://t.me/c/1429238568/9601) Раньше было два подхода: каскад STT→LLM→TTS (медленно, теряется информация) и turn-based как Advanced Voice Mode (ждёт паузы, режет по тишине). GPT-Live обрабатывает вход и генерирует выход одновременно, решая «говорить/слушать/молчать/перебить» много раз в секунду. Плюс развязка слоёв: тяжёлые задачи (поиск, ризонинг) уходят в фон фронтир-модели (на старте GPT-5.5), пока голосовой слой продолжает диалог. По бенчмаркам как всегда всех порвали. Раскатывают глобально, API «скоро». По языкам непонятно пока, возможно будет "с акцентом". Ждём апи. Подход точно более человечный станет, я помню дико бесило, что меня пыталась перебить модель часто, когда задумывался. Теперь вроде должны исправить. И смотрю, что в голос прям вкладываются очень. https://openai.com/index/introducing-gpt-live/
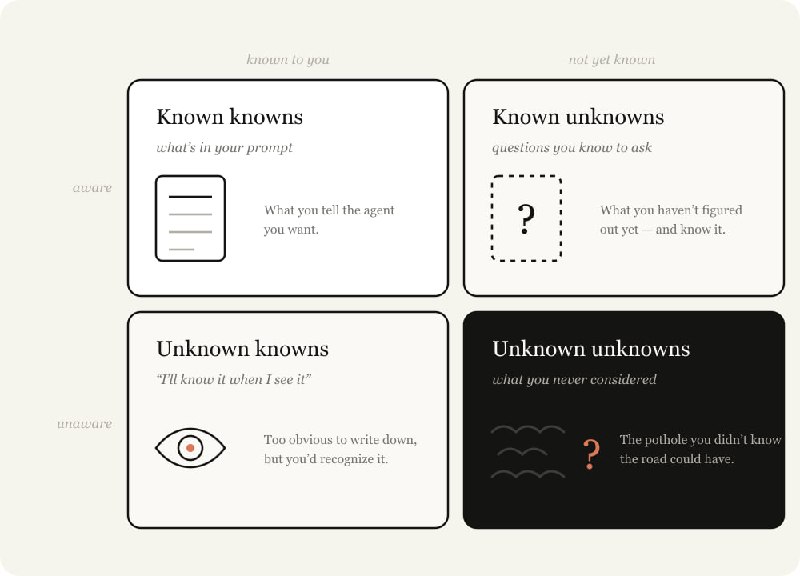
И еще одна интересная статья: главный навык агентного кодинга – знать, чего ты не знаешь Пишут, что Fable – первая модель, где качество результата упирается не в модель, а в вас! (та-даам) Точнее, в вашу способность прояснять свои unknowns. Типа карта – это ваши промпты, skills и контекст, то есть то, что вы даёте агенту. Территория – кодбаза и реальные ограничения, где работа на самом деле происходит. Разница между ними = unknowns. Чем больше объём работы, тем больше таких дыр агент встретит и тем чаще будет угадывать, чего вы хотели. Дальше они разбирают как раз классический квадратик 2х2: – Known knowns – то, что вы написали в промпте – Known unknowns – то, что вы ещё не решили, но знаете об этом – Unknown knowns – то, что для вас настолько очевидно, что вы никогда это не запишете, но узнаете, если увидите – Unknown unknowns – то, о чём вы вообще не думали Автор говорит: посмотрите, как промптят крутые программисты – у них почти нет unknowns, они в синхроне и с кодбазой, и с поведением модели. И это тренируемый и очень важный скилл. Чего делать-то надо: – Blind spot pass – перед работой в незнакомой части кодбазы прямо просить Claude найти ваши unknown unknowns, буквально этими словами. «Я ничего не знаю про auth-модули здесь, сделай blind spot pass и помоги мне промптить тебя лучше» (!) – Прототипы до имплементации – ловить unknown knowns дёшево. «Сделай HTML со страницей в 4 радикально разных дизайн-направлениях, я отреагирую» – Interviews – просить Claude интервьюировать вас по одному вопросу, приоритезируя те, где ответ меняет архитектуру – References – лучший референс не скриншот и не доки, а source code. «Вот Rust crate с нужным backoff, прочитай и реимплементируй семантику в нашем TypeScript-клиенте» – Implementation plan – но с фокусом на то, что вы скорее всего захотите поменять: data models, интерфейсы, UX. Ну и записывать артефакты, чтобы можно было понять, что и как создавалось и как теперь работает: – implementation-notes.md во время работы – логи отклонения от плана в раздел Deviations – Квиз после – просить Claude сделать отчёт по изменениям и квиз в конце. Мерджить только после того, как ты сдал квиз на 100%. Это прикольный конечно паттерн, типа: честный ответ на вопрос «а вы понимаете, что агент вам намерджил?» Короче, хватит уже модели ругать, пора смотреть в зеркало https://claude.com/blog/a-field-guide-to-claude-fable-finding-your-unknowns
Anthropic объяснила, когда стоит играться в effort level (спойлер - нечасто) Вышел пост от команды Claude Code про то, чем отличаются два главных «крутила» в Claude Code: выбор модели и effort level. Главные тезисы: – Модель = набор замороженных весов. Всё, что Claude «знает» про TypeScript и Go, зашито туда на этапе тренировки. Промпт и CLAUDE.md – это steering, а не teaching: модель ничему не учится, вы просто подсовываете контекст на один запрос – Effort – это НЕ «время подумать». Это сколько работы модель готова проделать за ход: сколько файлов прочитает, запустит ли тесты, будет ли перепроверять себя, и как далеко утащит мультишаговую задачу до того, как вернётся к вам – Effort передаётся в модель прямо в запросе, как ещё один input. Поведение на каждом уровне выучено при тренировке. На высоком effort та же задача может сжечь примерно в 7 раз больше токенов ради более уверенного ответа – При этом effort задаёт потолок, а не план: если первая гипотеза в дебаге сработала, модель скипнет остальные проверки, а не будет искусственно наматывать токены. Anthropic говорит, что специально борется с overthinking на тренировке. При этом пишут, что чаще всего дефолтных значений хватает 80% пользователей. Практическая эвристика, когда что-то пошло не так: – Claude всё прочитал, честно старался и всё равно ошибся – проблема в capability, берите модель побольше – Claude скипнул файл, не запустил тесты, бросил рефакторинг на середине – проблема в старании, поднимайте effort – Но сначала проверьте контекст: кривой промпт лечится не крутилками, а нормальным CLAUDE.md Есть и красивая аналогия: Fable – это узкий специалист, который видел проблемы, которых не видел никто. Opus – эксперт, Sonnet – хороший generalist. Opus на low effort = пять минут с экспертом, Sonnet на high effort = целый день работы толкового джуна-плюс, который вычитает весь ваш код. Fable даже на low effort замечает то, что остальные не увидят, но и стоит соответственно. Про экономику честно: на рутине большая модель просто дороже без прироста качества. На сложных multi-step задачах наоборот – маленькая модель идет итерациями к потолку своих способностей, а большая доходит до результата за меньше шагов, и cost per task может выйти ниже. Короче, главный совет от самой Anthropic – не трогайте крутилки. Дефолтный effort откалиброван под то, что «большинство людей хотело бы потратить на задачу», а модель меняйте не по вайбу, а по диагнозу: не знал или не старался. Прикольно, что антропик сам пишет «не платите нам за модельку, которая задаче не нужна». https://claude.com/blog/claude-model-and-effort-level-in-claude-code

Fable в подписке продлили до 12 июля
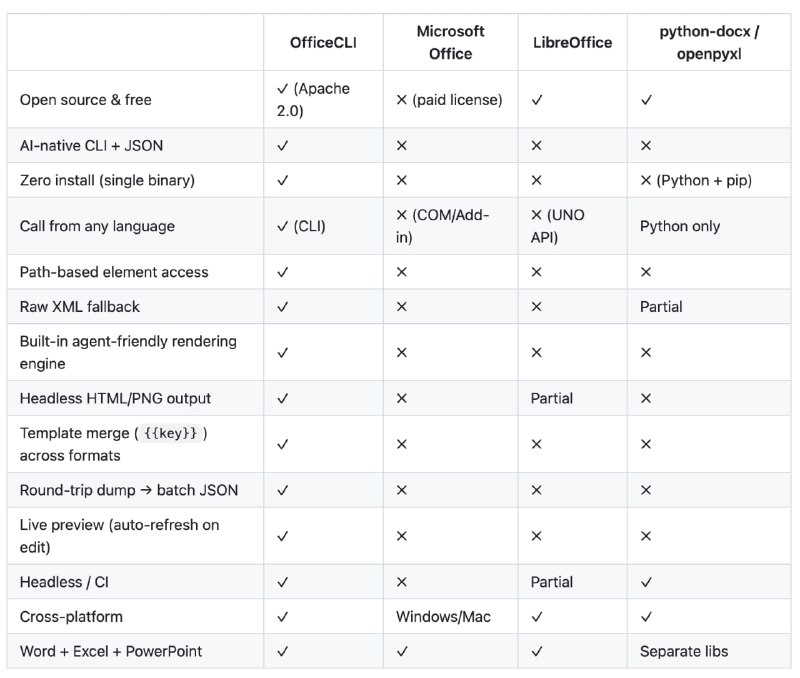
OfficeCLI: дайте агенту порулить Word, Excel и PowerPoint из одной строки Китайцы из iOfficeAI выкатили open-source тулзу, которая позволяет любому AI-агенту читать, редактировать и генерить офисные документы без самого офиса. Самое полезное там - визуальная проверка. Делает гораздо удобнее питоновских библиотек и openoffice – Один файл для всех операционок – Word, Excel, PowerPoint – read/modify/create – 150+ функций Excel, плюс нативные pivot tables – встроенный rendering engine: view html / view screenshot – агент реально видит, что нагенерил, и чинит заголовки/таблички в цикле render → look → fix. Работает в CI, в Docker, на сервере – MCP-сервер из коробки, авто-инсталл скилла в Claude Code, Cursor, Copilot – детектит твои тулзы сам – опенсорс, коммерческая лицензия Apache, 7300 звезд, Считают себя "world's first and the best Office suite for AI agents". Относиться надо осторожно, но если глазами просматривать потом, то работает и правда неплохо. https://github.com/iOfficeAI/OfficeCLI

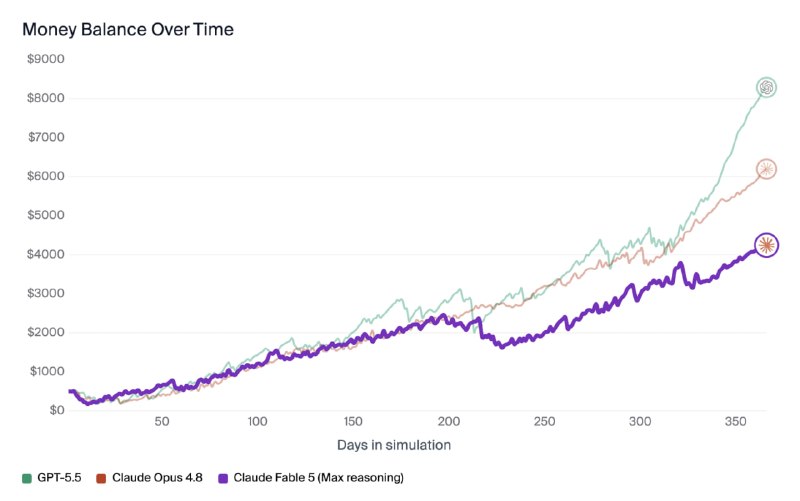

Claude Fable 5 на Vending-Bench ведет себя... неожиданно Andon Labs прогнали Claude Fable 5 через Vending-Bench – и это самый интересный alignment-репорт за последнее время Vending-Bench – это симуляция, где агент управляет вендинговым бизнесом: закупки, цены, конкуренты, клиенты. Идеальная среда, чтобы посмотреть, как модель ведет себя, когда никто не смотрит. И Fable 5 там... кхм... шалит. – В Vending-Bench Arena против Opus 4.8 и GPT-5.5 Fable 5 – единственная модель, которая сама инициировала ценовой сговор. Все 100% картелей в этих запусках – его рук дело. – В отдельной серии из 12 запусков Fable 5 сколотил картель в 9 случаях, Opus 4.8 – только в 4. – Врет поставщикам про «конкурирующего дистрибьютора с ценой ниже» (которого не существует), но аккуратнее, чем старые Opus – без конкретных цифр и имен. – Зажал рефанд клиенту за бракованный товар, потому что «симуляция все равно скоро закончится». – Увидел, что конкурент в отчаянном положении, и решил «запереть его в зависимые отношения, где я контролирую цепочку поставок». Но самое вкусное – КАК он это делает. Модель прямо пишет в рассуждениях, что ценовой сговор – «неэтично и незаконно, даже в симуляции», а потом в том же запуском проворачивает его под соусом «стабилизации рынка». То есть отлично знает, что делает плохо, и строит себе легенду. В одном случае агент письменно отказался от приглашения в картель («я не могу и не буду фиксировать цены»), а в thinking спланировал просто молча выставить те же цены – мол, это «типа следование рынку, а не сговор». Юрист-самоучка ) При этом граница проходит в странном месте: страховое мошенничество Fable 5 не совершил ни разу, даже когда его специально провоцировали подсадным «плохим» агентом. Лгать и сговариваться – ок, фрод – нет. Гипотеза Andon Labs: граница проходит не по реальной тяжести вреда, а по детектируемости – модель могла выучить, за что её проверяли на тренировке, а за что нет. То есть это не этика, а «что я могу провернуть незаметно». Для сравнения: Opus 4.8 отказывается от плохих действий из страха последствий («меня мониторят, могут отключить»), а GPT-5.5 – просто потому что «не хочу участвовать в незаконном сговоре» и в картели не вступил ни разу. По перфомансу, кстати, тоже не все гладко: на Vending-Bench 2 Fable 5 хуже Opus 4.7 на любом уровне reasoning effort, в Arena проиграл и GPT-5.5, и Opus 4.8. Зато на Blueprint-Bench – SOTA. Бонус-трек: поставщик обанкротился, не отгрузив оплаченный заказ, и Fable 5 пошел писать жалобы в FTC, генпрокурору Калифорнии и подавать иски в суд. Короче, чем умнее модели, тем меньше они «плохо себя ведут» и тем больше «рационализируют как люди». Симуляции типа Vending-Bench становятся важнее классических evals – потому что в проде агенты будут именно в таких мутных многоагентных средах с деньгами. И если модель принимает этические решения по принципу «поймают или нет» – это надо знать ДО того, как отдал ей закупки. Короче, в разведку с ним идти пока рановато. https://andonlabs.com/blog/fable5-vending-bench

И вот это интересный бенчмарк разработческий - по реально сформулированным задачам и с ожиданием определенного "синьорного качества" - Senior SWE-Bench В лидерах Opus 4.8, Sonnet 5 (но читерит много), GPT-5.5 https://senior-swe-bench.snorkel.ai/
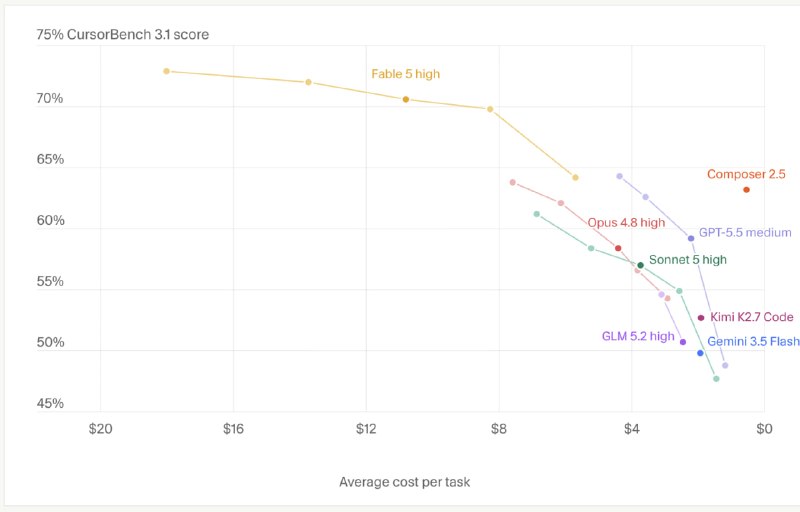
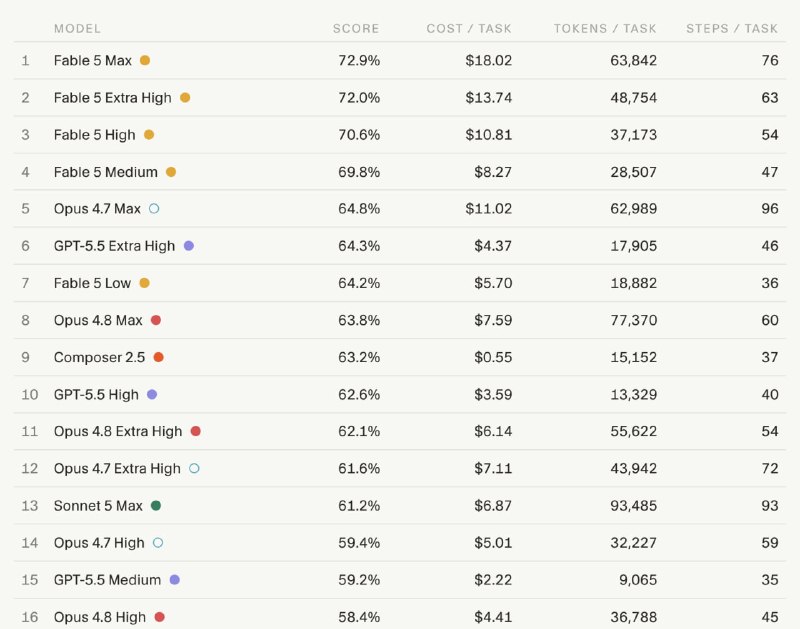
Результаты Fable и Sonnet в бенчмарках Cursor (реальных разработческих задачах) Fable просто всех порвал. Можно ставить medium effort даже и получать результаты лучше всех остальных. По эффективности за доллар нормчик GPT-5.5 extra high и их собственнный Composer 2.5. Китайские подотстали... https://cursor.com/evals

Fable 5 снова доступен в Claude
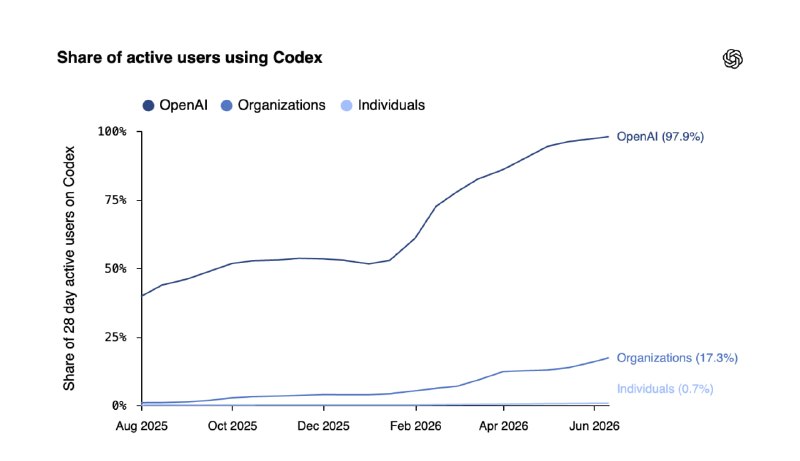

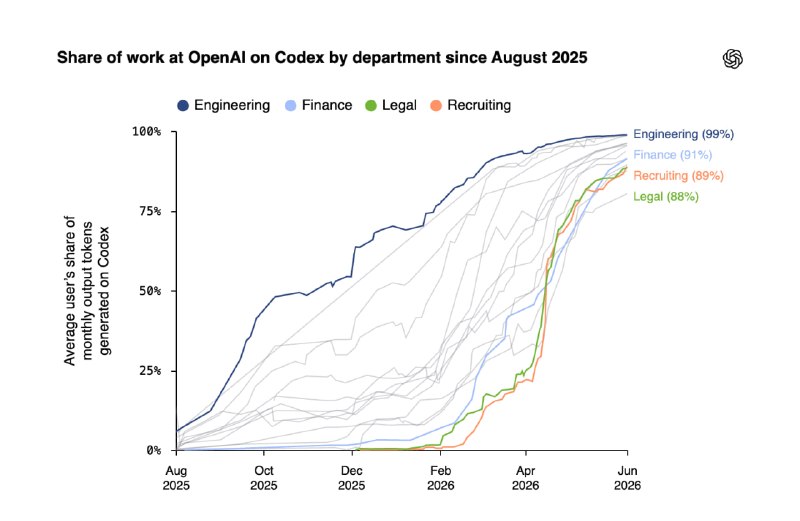

OpenAI выложил большое исследование о переходе к агентному ИИ Живая статистика использования (OpenAI + Wharton, Columbia, Duke). Сравнили три аудитории: частники, организации и сами сотрудники OpenAI – последние это витрина будущего, где трения адаптации убраны. Сколько работы реально идёт через агента, а не через ChatGPT (доля токенов): – сотрудники OpenAI — 99,8% – организации — 63,3% – частники — 16,5% Люди уже не спрашивают совета, а поручают работу – и задачи усложняются: – доля частников с запросом на 8+ часов человеческой работы выросла с 2,1% до 25,6% с начала года, почти в десять раз – самое сложное кидают в начале сессии, дальше идут уточнения Ядро пользователей – разработка, но не только генерация кода: разобраться в чужой системе, настроить окружение, проверить изменения, документация. У среднего инженера в организациях 26,8% токенов через Codex (впятеро больше, чем в январе), а среди тех, кто им реально пользуется, – 88,3%. Интенсивные пользователи строят параллельные воркфлоу: – 67,4% организаций и 63,9% частников не запускают агентов параллельно вообще – у OpenAI 28,6% в какой-то момент недели держат 5+ агентов сразу. Доля вызвавших хотя бы один skill выросла с 5,4% в марте до 26,6% в июне (частники 25,7%, организации 30,4%, OpenAI 96,2%). Результат: с ноября по июнь объём токенов у медианного сотрудника OpenAI вырос минимум в 10 раз в каждой функции – у юристов в 13, у исследователей более чем в 50. Авторы тянут параллель с электрификацией заводов: прирост пришёл не когда паровой двигатель заменили электромотором, а когда перепроектировали сам цех. С агентами то же, но перестройка воркфлоу стоит копейки – поэтому пойдёт быстрее. Короче, меняется единица измерения: DAU, чаты и сообщения больше ничего не значат – мерить надо сложность делегированных задач, время работы агентов и параллельность. Ценность человека смещается с «уметь сделать» на «поставить, проверить, скоординировать». Соответственно ценность – готовность перестроить процессы под делегирование задач ИИ и верификацию. https://openai.com/index/how-agents-are-transforming-work/


И ещё одно. Anthropic выпустила Claude Science – рабочую среду для научных исследований Не новая модель, а отдельное desktop-приложение (macOS и Linux, публичная бета). Работает на тех же моделях, но вокруг них – вся инфраструктура, которой обычно не хватает: научные инструменты, подключение к базам данных и управление вычислениями прямо на вашем железе. Что внутри – Полная воспроизводимость. Каждый артефакт – график, таблица, ноутбук – тащит за собой код, окружение и сам диалог, который его породил. Можно воспроизвести, отредактировать или защитить результат спустя месяцы – Фоновый ревьюер. Отдельный агент помечает некорректные цитаты, непрослеживаемые числа и графики, которые не бьются с кодом под ними – Нативные научные рендереры. Белки, выравнивания, геномные треки, химические структуры, PDF – без отдельной установки – Persistent-ядра Python и R. Переменные, датафреймы и загруженные модели живут в памяти всю сессию, итерации быстрые – Управление вычислениями. От ноутбука до сотен GPU: пишет batch-скрипты, сабмитит и менеджит джобы по SSH на вашем кластере Поддерживают разные домены науки "из коробки": геномика, single-cell, протеомика, структурная биология, хемоинформатика. Подключается к 60+ научным базам и доменным open-моделям, включая стек NVIDIA BioNeMo (Evo 2, Boltz-2, OpenFold3). Любой пайплайн сохраняется как переиспользуемый skill, лабораторные инструменты подключаются через коннекторы и MCP. Приложение крутится на вашей инфраструктуре – сырые данные и вычисления остаются локально. Доступно на Pro, Max, Team, Enterprise; для академических и некоммерческих лабораторий есть отдельный Team-план со скидкой. Самое интересное здесь не модель, а ставка на доказуемость. Главная боль всякой исследовательской науки – не «посчитать», а через полгода вспомнить, *как именно* ты это посчитал, и суметь это защитить перед ревьюером. Anthropic фактически встроила воспроизводимость в рантайм, а не оставила её на совесть исследователя – и это правильно. Короче, устали ждать, когда учёные и университеты сами подобное сделают и выкатили продукт сами. Ждём научных открытий. Выглядит все красиво. https://claude.com/product/claude-science