Как построить план по самообразованию и поддерживать мотивацию учиться Цели есть, а мотивации нет? Или наоборот — рвения хватает, а плана ноль? Рассказываем, как начать самообучение и не бросить на полпути. Как выбрать тип обучения Прежде чем составлять свое расписание, определите тип обучения, который вам нужен. Краткосрочное обучение подходит тем, кто хочет подтянуть знания или получить конкретный навык, а его результат виден сразу. Оно часто состоит из коротких теоретических уроков и заданий на закрепление навыков. Но у такого формата есть ограничение — из разрозненных знаний трудно собрать целостную картину. Вы сможете закрыть имеющиеся пробелы, но не изучить предмет заново. Долгосрочное обучение нужно, когда вы осваиваете предмет с нуля. Оно дает цельное понимание предмета и системные знания, но результата придется ждать гораздо дольше. Поэтому важно заранее поставить цели, поддерживать мотивацию и учиться системно. Как поставить цель Сначала ответьте на вопрос «Для чего я учусь?». Сформулируйте цель так, чтобы она была конкретной, измеримой, достижимой, релевантной и ограниченной по времени. Например: поднять мой уровень английского языка настолько, чтобы работать в сфере продаж за границей, учить по 10 слов в день методом интервального повторения. Однако при долгосрочном планировании сложно оценить, как много времени вам понадобится, чтобы достичь результата. Чтобы было проще, разбейте большую цель на маленькие и опишите каждую по критериям. Помогает и методика Карвера и Шейера с тремя уровнями: высокий (абстрактные цели — идеальный результат), средний (программные — план действий) и низкий (рутинные — ежедневные микрошаги, благодаря которым вы поднимаетесь на следующие уровни). Как поддерживать мотивацию Выписывайте маленькие победы и разбивайте тему на микрошаги. Заведите прозрачную систему самооценки — трекер задач или чек-лист на день или неделю — и планируйте только то, что точно сможете выполнить. Еще один прием: представьте результат, опишите преграду и составьте план «если мне мешает X, я сделаю Y». Как оценить свои достижения Универсальной стратегии, которая дает высокие результаты простым путем, не существует. Нужно комбинировать форматы получения знаний (видеоуроки, конспекты, практические задания). Чем больше каналов восприятия задействовано, тем лучше запоминается информация. Выбирая стратегию, отталкивайтесь от актуального уровня знаний. Язык можно оценить по общеевропейской шкале CEFR, а если вы начинаете в IT не с нуля, решите задачи разного уровня, чтобы найти пробелы. Оценивайте свои когнитивные (внимание, память, мышление) и метакогнитивные способности (планирование, контроль процесса, рефлексия) с помощью специальных тестов. Результаты соберите в карту компетенций — таблицу или майндмэп: выпишите навыки и уровень владения, сгруппируйте по сферам, добавьте цели на будущее и периодически обновляйте карту, чтобы отслеживать прогресс. В полной версии статьи мы собрали еще больше советов для тех, кто решил научиться чему-то сам. Время чтения: 15 минут 🤖 «Системный Блокъ» @sysblok

Системный Блокъ
«Системный Блокъ» — издание о цифровых технологиях в культуре, искусстве, образовании и обществе. Финалист премии «Просветитель» sysblok.ru vk.com/sysblok fb.com/sysblok instagram.com/sysblok/ Присоединяйтесь к команде: sysblok.ru/join
-
-

«Иишка» и «вайбкодинг» борются за титул слова года с «тревожником» и «воздуханом» Портал «Грамота.ру» опубликовал шорт-лист акции «Слово года»: 5 из 10 слов связаны с искусственным интеллектом Портал «Грамота.ру» подвел итоги первого тура акции «Слово года». Из 500 слов-претендентов лингвисты Грамоты отобрали те, которые чаще встречаются в поисковых запросах, соцсетях и в СМИ. В шорт-лист вошло 10 слов, которые пока не включены в словари, однако часто используются в живом языке. В короткий список вошли: — вайбкодинг, — генерить, — дата-центр, — ИИ-агент, — иишка, — прайм-эра, — дофаминовый, — нишевый, — воздухан, — тревожник. По оценке экспертов Грамоты, в этом списке отразились три тенденции. Первая — распространение искусственного интеллекта. «ИИ-термины, хлынувшие в язык, — это пока зона языковой турбулентности, ее границы до конца не определены, а пласт этой лексики сейчас активно растет», — объясняет Анастасия Бонч-Осмоловская, руководитель направления аналитики и цифровых словарей портала «Грамота.ру». Вторая тенденция — стремление людей даже в непростые времена искать поводы для радости. Отсюда популярность слов «прайм-эра», «дофаминовый», «нишевый». «Воздухан» и «тревожник» пополнили разговорные наименования типажей. Эта группа слов постоянно растет: в прошлые годы в нее вошли «скуф», «нормис», «масик». Следующим этапом акции станет экспертное голосование. 400 лингвистов определят слово-победитель, которое будет включено в цифровой метасловарь Грамоты. А пока вы ждете результатов, почитайте наш глоссарий, где мы рассказываем, что такое ИИ-агент и дата-центр. 🤖 «Системный Блокъ» @sysblok
-
И швец, и жнец, и на дуде игрец: что такое ИИ-агент Чат-бот отвечает на сообщение, а ИИ-агент может самостоятельно выполнять последовательность действий — открывать сервисы, искать файлы, запускать программы, заполнять формы и отправлять письма. Разбираемся, как устроены агенты, какие задачи им можно доверить и какие риски создает их использование. Как работает ИИ-агент Главный признак агента — агентность, то есть способность не просто отвечать на запрос, а самостоятельно действовать ради поставленной цели. Он сам выбирает следующий шаг, выполняет его, оценивает результат и, опираясь на доступные ему инструменты, решает, что делать дальше. Попросите чат-бота: «Найди мне рейс в Рим на следующие выходные дешевле 300 долларов». Он найдет варианты и выдаст список со ссылками. Дальше работаете вы: выбираете, бронируете, вносите поездку в календарь. Агенту можно поручить все целиком. Он сравнит рейсы, сверится с вашим календарем, забронирует подходящий, добавит поездку в календарь и пришлет подтверждение. В основе работы агента лежат три компонента: языковая модель, инструменты (браузер, поиск, базы данных и внешние сервисы) и цикл действий, который работает по принципу ReAct — «рассуждай и действуй». Агент анализирует ситуацию, вызывает инструмент, изучает результат и повторяет процесс, пока задача не будет решена. Что агенты умеют делать Исследовательская организация METR измеряет способности агентов с помощью горизонта задач — времени, которое потребовалось бы человеку на выполнение задачи. Например, если горизонт 50% составляет два часа, это значит, что задачи, на которые у человека уходит около двух часов, агент решает в половине случаев. С 2023 года горизонт задач удваивается примерно каждые 131 день. У модели Claude Mythos Preview горизонт 50% составляет не меньше 16 часов, а горизонт 80% — около трех часов. Точнее определить первый показатель не удалось: в тестовом наборе почти нет задач такой продолжительности. Разрыв показывает, что агент иногда справляется с многочасовой работой, но рассчитывать на стабильный результат пока нельзя. Кроме того, тесты METR в основном посвящены программированию, где успех легко проверить. На задачи вроде создания текста эти показатели напрямую не переносятся. Что такое обвязка ИИ-агента Надежность агента зависит не только от языковой модели, но и от совокупности компонентов и механизмов, которые определяют его работу. Это называют обвязкой . В нее входят инструкции для агента, набор доступных инструментов, автоматические проверки, ограничения прав доступа, изолированная среда запуска и журнал действий. Зачем агентам протоколы Чтобы агенты могли пользоваться внешними сервисами и взаимодействовать друг с другом, нужны специальные протоколы — правила обмена данными между программами. Без них каждое подключение пришлось бы разрабатывать отдельно. MCP, разработанный Anthropic в 2024 году, связывает агента с инструментами и данными. Его можно сравнить с USB-разъемом: если у сервиса есть MCP-сервер, к нему может подключиться любой совместимый агент. A2A, представленный Google в 2025 году, позволяет агентам разных компаний обмениваться задачами и договариваться о выполнении работы. Например, агент-туроператор может связаться с агентом отеля и организовать бронирование. Сам A2A не создает агентов, а только связывает уже готовых. Какие риски создают агенты Один из основных рисков — prompt injection, внедрение команд. Агент может принять инструкцию из электронного письма или веб-страницы за указание пользователя. Особенно опасно сочетание, которое исследователь Саймон Уиллисон называет «смертельной тройкой»: у агента есть доступ к личным данным, он читает информацию из ненадежных источников и может отправлять данные наружу. Другая угроза — общие ресурсы. Например, все боты Grok Bot в одном аккаунте работают на общем облачном компьютере. Если один бот прочитает вредоносную инструкцию, под угрозой окажутся и остальные, поэтому компания советует не держать там пароли и файлы, которые не нужны другим ботам. Опасность также представляют избыточные права доступа, вредоносные описания инструментов в MCP-серверах и теневые агенты — ИИ-инструменты, которыми сотрудники используют без одобрения компании. Защититься помогают ограничения прав, песочницы (изолированные среды запуска) и подтверждение человеком необратимых действий. Поэтому перед внедрением агента стоит ответить на четыре вопроса: как мы проверим результат? Что агент может сделать без подтверждения? Кто следит за его работой? Можно ли отменить его ошибку? Подробнее о том, как работают ИИ-агенты, — в полной версии материала. Время чтения: 15 минут 🤖 «Системный Блокъ» @sysblok
-

Наследники Элвиса Пресли судятся с Anthropic Истцы требуют 41,1 млн долларов за обучение Claude на 274 песнях музыканта Компания Authentic Brands Group, которая управляет правами на наследие Элвиса Пресли, вместе с другими правообладателями подала иск против Anthropic, разработчика языковых моделей Claude. Истцы утверждают, что компания без лицензии и оплаты использовала тексты и композиции 274 песен Пресли для обучения своих моделей. Иск подан 23 октября в федеральный суд Северного округа Калифорнии. Среди песен, названных в иске, есть хиты «Can’t Help Falling in Love», «All Shook Up» и «Don’t Be Cruel». По словам истцов, Anthropic хранила песни во внутренней базе данных и копировала их для обучения последующих версий Claude. В иске также утверждается, что модель до сих пор выдает материал, нарушающий авторские права: по запросу она воссоздает песни «для современной аудитории», сохраняя их структуру и узнаваемые мелодические ходы. Истцы считают нарушение умышленным. Они требуют максимальную компенсацию, которую допускает законодательство США: 150 тыс. долларов за каждую песню. Они также просят запретить Anthropic дальнейшее использование песен и уничтожить все нелицензионные копии. Anthropic отвергла обвинения и заявила, что будет защищаться в суде. Раньше компания утверждала, что обучение на защищенных материалах подпадает под доктрину добросовестного использования (fair use). Почему это важно? До сих пор с ИИ-компаниями судились в основном лейблы и издатели. Иск правообладателей Пресли стал одним из первых крупных дел, которые подали наследники конкретного артиста. Если он окажется успешным, примеру могут последовать правообладатели других исполнителей. Истцы оспаривают не только обучение, но и ответы Claude, которые, по их словам, почти повторяют оригиналы. Исход дела может показать, придется ли разработчикам языковых моделей платить за песни, на которых они учатся. 🤖 «Системный Блокъ» @sysblok
-
edited Эволюция художественного текста, или Как подружить Гоголя и Git Как на одной странице показать, что менялось в «Ревизоре» между редакциями? DH-исследователь Евгений Дуненков сделал для этого интерактивный инструмент и в своем блоге рассказал, как над ним работал и с какими сложностями столкнулся. Постановка задачи Есть много текстов, которые постоянно меняются. Например, код или юридические документы: в Git или «КонсультантПлюс» можно сравнить разные редакции программы или закона. Художественный текст тоже эволюционирует: от набросков до академического издания, через правки, редактуру и цензуру. Но читатель, за исключением редких примечаний, видит лишь один кадр, а целиком процесс наблюдают только текстологи. Евгений Дуненков решил показать эту эволюцию на одной интерактивной странице, где версии можно переключать и наблюдать, как одна превращается в другую. Для этого он сделал карту версий (какие они, как связаны и где мы сейчас) и «плеер перехода», в котором исходная версия шаг за шагом превращается в целевую, а вставки и удаления подсвечены. Материалом стало явление 6 третьего действия «Ревизора»: пьеса хорошо изучена, ее версиям в академическом издании посвящен целый том. Как это сделано Получить работающий прототип удалось не сразу. Исследователь рассказывает, как он пришел к удачному результату путем проб и ошибок. Сначала он пытался сделать один универсальный скрипт, но тот оказался громоздким и медленным. Тогда он разделил подсчет различий и визуализацию на модули и попал в порочный круг: как считать и хранить правки, трудно решить, не зная, как заработает визуализатор, а писать визуализатор, не зная входных данных, слишком сложно. Выходом стал новый формат хранения. Так появился TDJ (Text Dynamics JSON): версии в виде списков токенов и правки для каждого перехода. Модуль TDJ Builder на Python сам находит различия между версиями и записывает их в этот формат. Как загрузить свой текст Инструмент, который разработал Евгений Дуненков, может использовать каждый. Если вы хотите воспроизвести его работу на редакциях другого текста, нужно собрать txt-файлы версий, описать их связи в yaml-конфигурации, запустить TDJ Builder и загрузить результат в визуализатор. Подробнее о том, как шла работа, — в полной версии блога. Время чтения: 20 минут 🤖 «Системный Блокъ» @sysblok
-
repost 
Вы предлагали слова года — рассказываем, что получилось! Сбор претендентов на звание «Слово года» по версии Грамоты завершен. Спасибо всем, кто присылал свои варианты! Среди предложений — «нейрослоп», «сикс-севен», «нишевый», «прайм-эра» и множество других слов. Сейчас мы изучаем кандидатов, замеряем их популярность и готовим короткий список для голосования экспертов. Но уже сейчас можно обсудить первые результаты. 28 октября приглашаем вас на открытую онлайн-лекцию «Слово года — 2026: тренды и сюрпризы». О чём поговорим? 🔹 Что можно сказать о словах, которые были заметны в 2026 году? Какие тенденции видят лингвисты? Что оказалось в центре внимания? 🔹 Как поживают победители прошлых лет? «Нейросеть», «вайб», «зумер» все еще популярны? А кто сегодня помнит «квадробера»? 🔹 Как Грамота выбирает слово года? Почему самое яркое слово не обязательно становится победителем? Расскажем о нашей методике, работе экспертов и о том, как выбирают слова года в других странах. В прошлом году в голосовании Грамоты участвовали 469 филологов из 23 организаций. В этом году мы тоже будем привлекать экспертов из разных регионов с разными взглядами на современный русский язык. До объявления шорт-листа осталось совсем мало времени. Приходите на лекцию, чтобы узнать первые результаты нашей работы и попробовать угадать, какие слова попадут в финал! 📅 28 октября, 18:30, онлайн. Участие бесплатное. Для участия необходима регистрация. Ссылку на эфир пришлем на электронную почту. #Грамота_новости #Грамота_словогода
-
edited «Грамота.ру» представит первые результаты «Слова года» Мы продолжаем рассказывать о конкурсе «Слово года», который проводит портал «Грамота.ру», и приглашаем вас на открытую онлайн-лекцию «Слово года — 2026: тренды и сюрпризы». Пользовательское голосование завершилось — теперь специалисты «Грамоты.ру» готовы рассказать о том, какие неожиданные открытия оно принесло. Лекция состоится 28 октября. Как зарегистрироваться, читайте в посте ниже. 🤖 «Системный Блокъ» @sysblok
-
Битва за феминитивы: взгляд лингвиста Почему «программистка» звучит естественно, а «авторка» и «членка» многим режут слух? И может ли сознательное употребление феминитивов сработать против целей говорящего? В новом выпуске своего блога лингвист Алексей Богданов разбирается, что говорит о феминитивах наука о языке. Пересказываем самое интересное. Что такое феминитивы Феминитивы — существительные женского рода, обозначающие людей и обычно образованные от существительных мужского рода. В основном, они описывают людей через их профессию или род занятий (артистка), но не всегда (гостья). Пол можно указать и с помощью конструкции с так называемым общим родом («зашла врач»), но это возможно не во всех контекстах. Например, в настоящем времени («заходит врач») пол не будет определен. Феминитивы удобны тем, что помогают обозначить пол человека, не прибегая к более длинным конструкциям. Но у них есть и неудобства: некоторые из них имеют отрицательные коннотации (врачиха, директорша). Зачем их используют За сознательным использованием феминитивов стоит несколько идей. Первая идея: раз права женщин ущемляются, специальные слова подчеркивают, что речь идет именно о женщинах, и придают им больше ценности. Вторая: некоторые профессии назывались словами мужского рода, когда ими владели только мужчины; а теперь ими владеют и женщины, поэтому они достойны отдельных слов. Третья: из-за того, что большинство названий профессий имеют мужской род, возникает предубеждение о том, что эти занятия — привилегия мужчин. Почему не все искусственные феминитивы хороши Искусственные феминитивы — слова, которые были сконструированы сознательно, а не образовались в языке естественно. Не все из них грамматичны, то есть признаются носителями языка как возможные. В частности, в языке есть многочисленные морфонологические ограничения, которые ограничивают сочетаемость суффиксов, в том числе суффиксов, образующих феминитивы. По той же причине, по которой можно сказать «гиппопотамчик», но нельзя — «бегемотчик», «программистка» звучит нормально, а «авторка», «членка» или «члениня» режут слух. Первое слово устроено так же, как привычные «артистка» и «модистка», а в остальных суффиксы -ка и -иня присоединены к неподходящим для них основам. Алексей Богданов подчеркивает: доказать здесь что-то с математической точностью нельзя, ведь вопрос грамматичности определяется суждениями носителей, которые могут расходиться. Однако стоит спросить себя: не влияет ли на ваше суждение о грамматичности слова «авторка» идейная сторона вопроса? К чему приводит использование искусственных феминитивов Эффект слов вроде «авторка» рассчитан в том числе на тех, кто слышит новые слова впервые: они должны по-новому взглянуть на роль женщины. Но, по мнению лингвиста, услышав такое как бы «ненастоящее» (неграмматичное с точки зрения языковой интуиции носителя) слово, человек, возможно, лишь укрепится в мысли, что роль женщины вторична, раз для неё есть только такие «ненастоящие» слова. Автор блога разделяет цели сторонников феминитивов, но не средства. И рассуждает об альтернативных решениях: В русском языке есть естественные средства для спецификации профессий и социальных ролей по полу — например, выражения типа женщина-врач, женщина-автор. Я не утверждаю, что они были бы идеальной заменой искусственных феминитивов…. Однако у них есть и бесспорные преимущества — во-первых, они регулярны, а во-вторых, нет сомнений в их грамматичности, несмотря на то, что сейчас они почти не употребляются. Я ни в коем случае не призываю сейчас все бросить и перейти на эти конструкции в качестве универсальных феминитивов. Я лишь хочу показать, что среди всех инструментов, которые есть в языке, для этих целей были выбраны, на мой взгляд, далеко не самые удачные. Больше деталей и теории — в полной версии блога. Время чтения: 20 минут 🤖 «Системный Блокъ» @sysblok
-


 +5
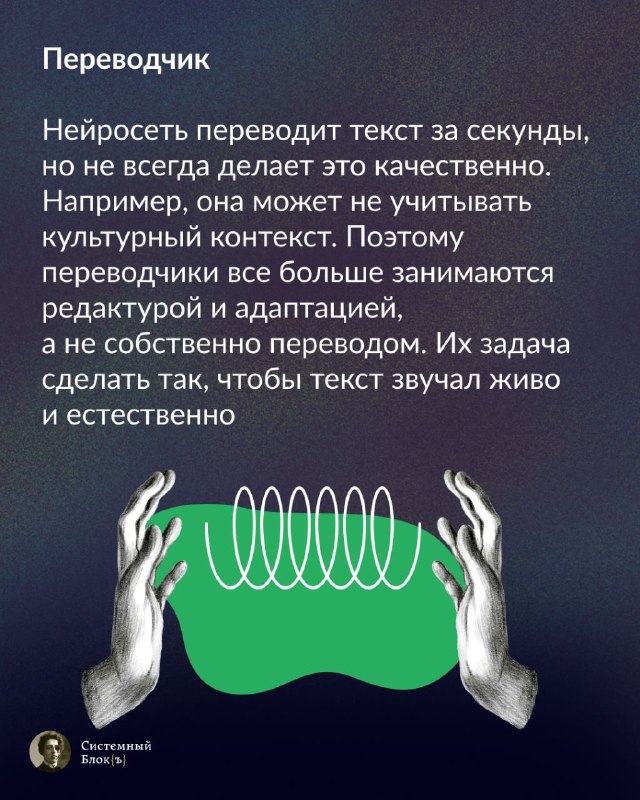
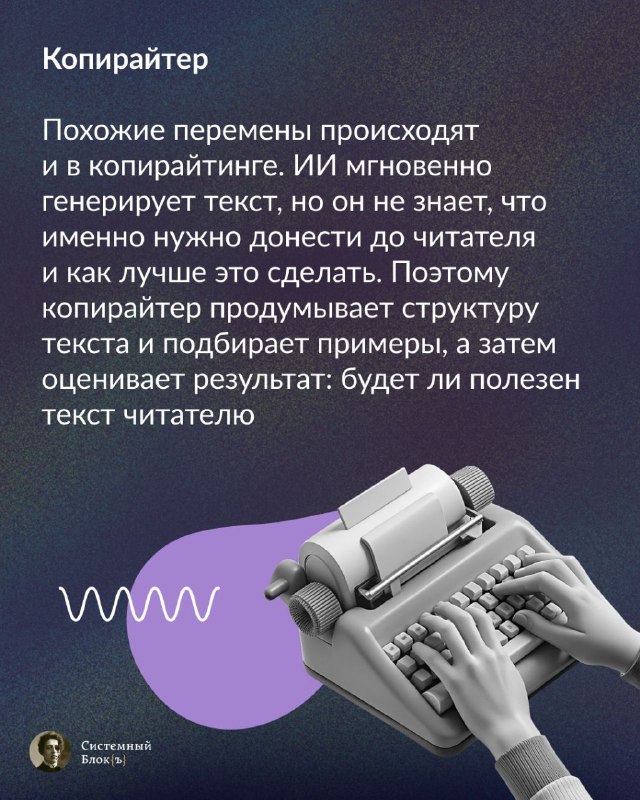
От переводчика до AI-тренера: как меняются профессии в эпоху больших языковых моделей Каждую неделю появляются новости о том, что ИИ скоро оставит нас без работы. Особенно тревожно тем, кто работает с текстом: переводчикам, копирайтерам, редакторам. ИИ ведь может и написать, и отредактировать текст за секунды. Но исследования показывают другое: профессии не исчезают, а меняются, и появляются совсем новые роли. Разбираемся, как это выглядит на практике. Полная версия статьи — на сайте. 🤖 «Системный Блокъ» @sysblok
-
edited Telegram doesn't show this post on the web. Open it in Telegram to see it.
-
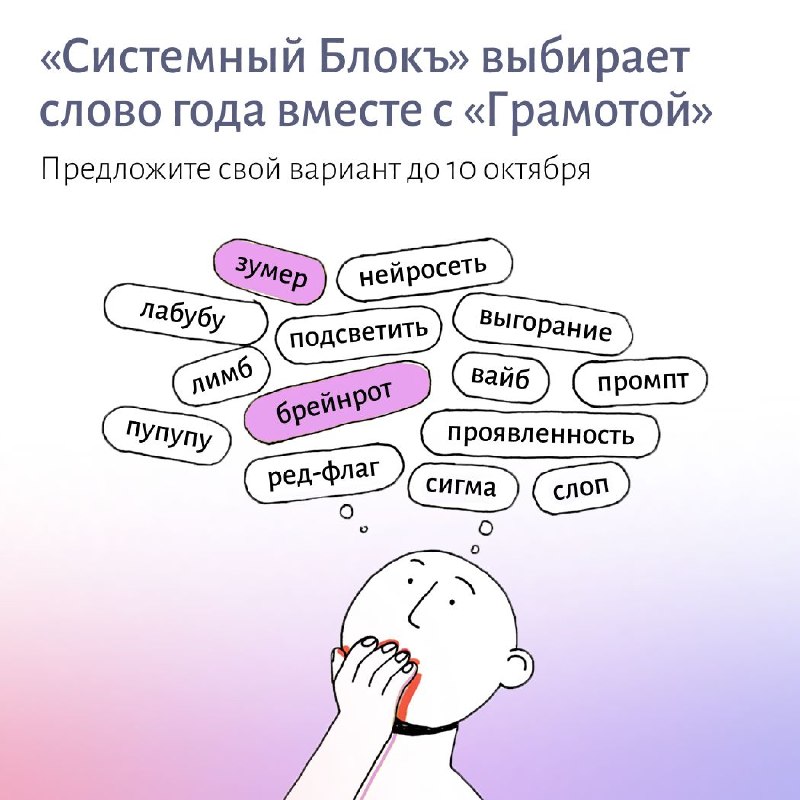
«Системный Блокъ» выбирает слово года вместе с «Грамотой» Портал «Грамота» в четвертый раз выбирает слово года. В этом году «Системный Блокъ» — информационный партнер проекта. Мы расскажем о шорт-листе и итогах, а наши эксперты по NLP прокомментируют слова о технологиях. 📖 Как выбирают «Слово года»? Отбор состоит из трех этапов: лонг-лист, в который попадают слова из опросов на сайте и в соцсетях, шорт-лист на основе анализа поисковых запросов, публикаций на разных площадках, экспертная оценка. На последнем этапе слово года определяется по итогам рейтингового голосования среди специалистов в области науки о языке. В 2025 году «Грамота» проверила больше 500 кандидатов и оставила 12. Победителя среди них выбрали 469 лингвистов из 20 городов. Слово года должно быть новым, актуальным, частотным и закрепившимся в повседневной речи. 🤖 Нейросети третий год подряд меняют словарь русского языка — 2023: словом года стала «нейросеть» (75% голосов экспертов); — 2024: «промпт» победил в номинации «Информационные технологии»; — 2025: в шорт-лист вошли «слоп» и «брейнрот» — так называют бессмысленный контент, который генерируют нейросети. А в ИТ-номинации победил «вайбкодинг». 📈 Какие еще слова становились победителями? В 2024 году словом года стал «вайб», а в 2025-м «зумер». ✍️ Какое слово 2026 года останется в языке? Предложите своих кандидатов в комментариях к посту «Грамоты» или этому посту до 10 октября включительно. Мы в редакции уже предложили! 🤖 «Системный Блокъ» @sysblok
-
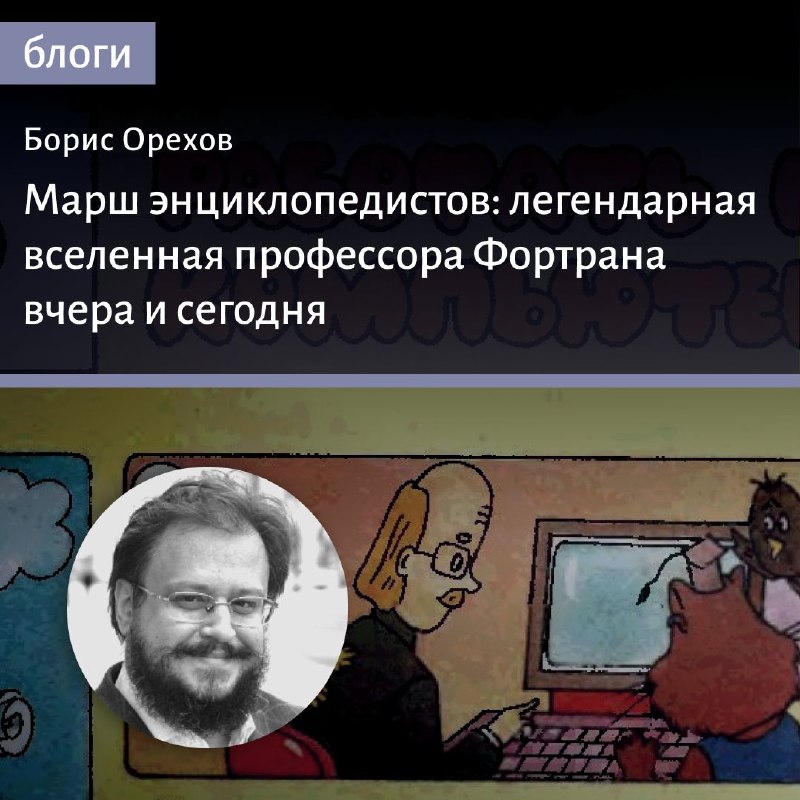
Марш энциклопедистов: легендарная вселенная профессора Фортрана вчера и сегодня Как детская книга о компьютерах 1991 года помогла целому поколению освоить технику, которая тогда казалась незнакомой? Новый выпуск блога Бориса Орехова — об «Энциклопедии профессора Фортрана», ее создателях, героях и мире, где компьютер превращается в огромный город. Пересказываем самое интересное. Как компьютер стал понятным В 1990-е персональный компьютер еще мог казаться чем-то неведомым — устройством, к которому многие боялись подходить без необходимости. А социолог Джефри Александер показывает, что в американской прессе 1944–1975 годов компьютеры описывали как «священные и таинственные» объекты: их сравнивали с электрическим мозгом, а специалистов — со жрецами. Борис Орехов пишет, что страха перед компьютером никогда не испытывал, зато был интерес, который появился в том числе благодаря «Энциклопедии профессора Фортрана». В книге компьютерный мир превращался в дружелюбную вселенную с профессором, котом Иксом, Воробьем и Гусеницей. Через комиксы они объясняли, что такое алгоритм, программа, байт, память и компьютерный вирус. Как появилась «Энциклопедия» В конце 1980-х молодые научные сотрудники Андрей Зарецкий и Александр Труханов решили написать детскую книгу о компьютерах. Первоначальные образы профессора Фортрана и кота придумал Павел Околев, а иллюстрации создала художница Элина Десятник. Книга вышла в 1991 году в издательстве «Просвещение» тиражом около 2 млн экземпляров, а по некоторым оценкам — вдвое больше. Правда, денег и славы авторам это не принесло. Компьютер как открытый мир В энциклопедии рассказывается об устройстве компьютера — от дисплея и клавиатуры до процессора и дисковода. Авторы включили историю вычислительной техники: механические машины Паскаля, Лейбница и Бэббиджа, электронные лампы, транзисторы и микросхемы. Отдельно говорится о применении компьютеров в медицине, космонавтике, роботах, учебе и быту. В книге были игры, головоломки и кроссворды. А еще читатель мог вырезать макет компьютера и фигурки персонажей, сыграть в настольную игру-путешествие по Компьютерной Стране и получить диплом профессора Фортрана за выполненные задания. Вселенная книги устроена как открытый мир — герои свободно перемещаются во времени и пространстве (например, могут попасть на старинный корабль), а компьютер предстает огромным городом с еще не исследованными пространствами. Что осталось от профессора Фортрана сегодня С 1991 года технологии изменились, но базовые объяснения устройства ЭВМ по-прежнему актуальны. А ещё «Энциклопедию» можно дополнить современными главами: мобильными устройствами, компьютерными сетями, Linux и свободным ПО, виртуализацией, облачными технологиями, искусственным интеллектом, хакерами, паролями и аутентификацией. Все это довольно легко поддаётся генерации, и вот уже знакомые герои «Энциклопедия профессора Фортрана» рассказывают вам об устройстве больших языковых моделей. Подробнее (с картинками!) о легендарной книге — в полной версии материала. Время чтения: 10 минут 🤖 «Системный Блокъ» @sysblok
-
Тест: угадайте, что отправители писали на старых открытках До появления социальных сетей открытка была не только красивой картинкой, но и способом отправить короткое сообщение — от поздравления до совершенно неожиданных новостей. При этом у почтовых карточек есть свои маленькие загадки: изображение рассказывает одно, а несколько строк на обороте 一 порой совсем другое. Для этого теста мы использовали материалы из корпуса «Пишу тебе» — цифрового архива дореволюционных, советских и современных почтовых открыток. Попробуйте, глядя на открытку, угадать, что на самом деле написал отправитель? Проходите тест на сайте и делитесь в комментариях результатом. 🤖 «Системный Блокъ» @sysblok
-


 +3
От рок-баллад до Тейлор Свифт: как алгоритмы находят сюжеты в песнях 1 октября мир отмечает международный день музыки, а мы напоминаем, что цифровые науки проникли и сюда и все-таки научились проверять алгеброй гармонию. В честь праздника предлагаем вам послушать любимый альбом и полистать карточки по мотивам нашей статьи о том, как с помощью алгоритмов можно оценить, есть ли в песне сюжет. Время чтения: 8 минут 🤖 «Системный Блокъ» @sysblok
-

Пользователи применяли Claude для слежки и кибератак В новом отчете Anthropic рассказала, как Claude использовали для создания ракет, вредоносного кода и мошеннических приложений В сентябре компания Anthropic опубликовала отчет о случаях злоупотребления Claude, которые удалось выявить с декабря 2025 по август 2026 года. Под подозрение попали пользователи из России, Йемена, Китая и других стран. Ряд аккаунтов был заблокирован. Например, в одном из кейсов русскоязычный пользователь использовал модель для разведки, разработки вредоносных инструментов и обработки украденных данных. Объектами атак стали больше 20 организаций Европы и Ближнего Востока: военные и разведывательные структуры, государственные ведомства, дипломатические представительства и оборонные компании. Если защитные системы обнаруживали вредоносную программу, ИИ помогал переписать ее и снова развернуть. В другом случае российские пользователи, которых авторы отчета обозначили как группу фрилансеров, с помощью Claude писали и тестировали программное обеспечение автономных FPV-дронов-камикадзе. Система могла самостоятельно выбирать цель и принимать решения без участия человека. Также Antropic обнаружил несколько аккаунтов, связанных с российским информагентством Sputnik: с помощью Claude создавались посты для соцсетей и новостные заметки. Еще один кейс связан с ячейкой из Йемена, которая вела сразу три программы по разработке вооружений: управляемую ракету с системой наведения, многоступенчатую баллистическую ракету дальностью свыше 2000 км и линейку изделий с гиперзвуковым вариантом. Claude использовали, чтобы создать программное обеспечение для управления и навигации. После неудачного тестового пуска одного из образцов разработчики снова обратились к Claude, чтобы разобраться в причинах сбоя. Anthropic отмечает, что не нашла свидетельств того, что разработчикам удалось получить боеспособное оружие. Почему это важно? ИИ-инструменты достаточно развиты для того, чтобы причинять вред, и далеко не всегда его можно вовремя пресечь. Отчет показывает, что разработчики LLM — в данном случае это Anthropic — не только сами отслеживают и останавливают случаи ее неправомерного использования, но и решают, что допустимо, а что нет. Компании видят переписку пользователей, и определяют, было ли нарушение и стоит ли его обнародовать. Поскольку внешнего наблюдателя у этого процесса нет, о случаях злоупотребления мы узнаем только в том объёме, который компания сама решает раскрыть. Как Claude использовали для сбора данных о религиозных меньшинствах в Китае, с кем переписывались пользователи приложения для знакомств и в чем Anthropic уличил DeepSeek, рассказываем в полной версии на сайте. Время чтения: 5 минут 🤖 «Системный Блокъ» @sysblok
-

Минпросвещения составило правила для учителей по работе с ИИ Ведомство рекомендует школам отдавать приоритет «суверенным» и «национальным» моделям, а самостоятельно пользоваться нейросетями разрешает ученикам только с 5 класса Минпросвещения направило в школы методические рекомендации по применению искусственного интеллекта в работе учителей. Ведомство делит сервисы ИИ на четыре категории: зарубежные общедоступные, российские общедоступные, а также встроенные в государственную систему «Моя школа» — с доступом в интернет и без него. Приоритет рекомендовано отдавать сервисам на основе суверенных и национальных больших языковых моделей. Эти статусы начнут присваивать с 1 марта 2027 года по новому закону об ИИ. Нейросети разрешается использовать для того, чтобы адаптировать для разных групп школьников, анализировать успеваемость, вести записи в журнале. Однако в документе подчеркивается: ИИ должен оставаться вспомогательным инструментом и не подменять педагога. Отдельно сказано, что учителям нельзя загружать в нейросети. Под запретом персональные данные учеников, родителей и коллег, оценки и характеристики, а также приказы, служебные записки и другая внутренняя документация. ИИ нельзя использовать при проведении промежуточной и итоговой аттестации, а также для подготовки обратной связи ученику — эту работу учитель должен делать сам. В начальной школе дети не должны работать с нейросетями: разрешено только применение ИИ учителем при подготовке к уроку. В 5–9-х классах ученикам можно использовать нейросети для поиска информации и проверки гипотез, а в старших классах — для проектной и исследовательской работы. Министерство также предупредило, что сервисы проверки текста на ИИ часто ошибаются, поэтому решение о том, списал ученик или нет, всегда должен принимать учитель. Материалы, созданные с помощью нейросетей, рекомендуют сопровождать пометкой «Создано с помощью ИИ», а школы обязаны обеспечить учителям бесплатный доступ к сервисам проверки текстов. Педагогов обязали информировать родителей о том, что в классе используется ИИ, — например, на родительских собраниях. Почему это важно Это первый системный документ, который регулирует использование искусственного интеллекта учителями по всей стране, а не на уровне отдельных регионов или школ. При этом документ опережает практику: приоритет суверенным и национальным моделям министерство закрепляет уже сейчас, хотя требования к ним вступят в силу только с 1 марта 2027 года и ни одной LLM такой статус пока не присвоен. Впервые министерство прописало, что именно и на каком этапе обучения школьникам разрешено делать с помощью нейросетей. Это показывает, что ведомство не видит в ИИ угрозу учебе, а наоборот — постепенно встраивает его в школьную программу. 🤖 «Системный Блокъ» @sysblok
-
edited Едят ли корейцы собак? Отвечает статистика В феврале 2027 года в Южной Корее истекает переходный период — и полный запрет на производство и продажу собачьего мяса начнет действовать в полную силу. В то же время в Северной Корее таких ограничений нет. С помощью данных разбираемся, как распалась общая для двух Корей традиция. Собачье мясо в корейской традиции Точно неизвестно, когда корейцы начали есть собачатину — многие ученые относят это к эпохе неолита. Но повседневной пищей она никогда не была: блюда считались сезонными или целебными. Трактат 1613 года «Тонъый погам» («Сокровищница знаний восточной медицины») приписывал собачьему мясу способность лечить эпилепсию, депрессию и глазные болезни. В современной Южной Корее его едят в основном в жаркие летние дни «покналь» — считается, что горячая пища помогает переносить зной. Как сейчас относятся к собачьему мясу в Южной Корее? Тренд на отказ возник давно. По опросу 2022 года, 94% южнокорейцев не ели собачье мясо за последний год, 89% не планируют есть его впредь. Одновременно доля корейцев, держащих собак как питомцев, выросла с 16% в 2010 году до 25% в 2022-м. В 2024 году парламент Южной Кореи единогласно принял закон о полном запрете собачьего мяса. На момент принятия в стране работало 1537 ферм, 221 скотобойня, 1788 торговых точек и 2352 ресторана. В 2026 году закрылось 82% ферм и 60% ресторанов. Поголовье собак на убой сократилось с 460 000 в 2024 году до 20–30 тысяч в июле 2026-го, а цена порции супа посинтхан за первые полгода 2026 года выросла с 12 000 до 25 000 вон. Часть ресторанов сохранила посинтхан в меню, дополняя его супом из козлятины; некоторые фермы сменили специализацию и перешли на разведение чёрных коз. Внутреннее потребление козьего мяса в стране выросло с 6300 тонн в 2020 году до 13 000 тонн в 2024-м. А что в Северной Корее? В КНДР ситуация обратная. Ким Ир Сен приказывал называть собачатину «сладким мясом», и ее употребление поддерживается на государственном уровне: в марте 2026 года в Пхеньяне открылся новый ресторан посинтхана, а число участников ежегодного кулинарного конкурса выросло со 100 поваров в 2024 году до 200 в 2025-м. Неожиданный эффект южнокорейский запрет вызвал в Японии. Там опасаются, что рестораны собачьего мяса в Токио и Осаке (в основном заведения китайской кухни) укрепят среди корейских туристов мнение, что «собачье мясо можно есть в Японии» — и это ударит по репутации страны. Партия инноваций Японии добивается запрета на парламентском уровне. Стереотип подтвержден, но тренд уходит Стереотип о корейцах и собачьем мясе статистика подтверждает — но только наполовину. В Южной Корее у традиции официально осталось жить полгода, хотя часть продавцов и потребителей может уйти в нелегальный сегмент. А вот в КНДР при нынешней государственной поддержке традиция не исчезнет — и, вероятно, мы о ней ещё услышим. Больше графиков и фактов — в полной версии статьи. 🤖 «Системный Блокъ» @sysblok
-


 +5
От Пикуля к ИИ: как создавалась и на чем держится книжная империя Эксмо-АСТ За последние десятилетия российский книжный рынок сильно изменился, а издательская группа «Эксмо-АСТ» стала его главным игроком. Мы изучили, как Олег Новиков построил империю «Эксмо-АСТ», какую долю тиража книг она издает и как монополизация рынка влияет на цены и качество изданий. В карточках — история «Эксмо-АСТ», данные о российском книжном рынке и проблемы отрасли. Полную версию исследования можно прочитать на сайте. 🤖 «Системный Блокъ» @sysblok
-
Как построить систему самообучения: алгоритм от цели до результата Можно скачать 10 приложений для учебы, составить идеальный план и все равно мало чему научиться. Проблема кроется в том, как устроен процесс обучения. Ее можно решить с помощью модели саморегулируемого обучения. Она помогает самостоятельно ставить цели, выбирать методы и проверять результат. В новой статье подробно рассказываем, как она работает, а в посте делимся с вами советами, как учиться самому и не пожалеть о потраченном времени. Начинайте с конкретной цели Цель должна описывать действие и измеримый результат: например, не «выучить английский», а «за неделю запомнить 30 слов и использовать 20 из них в предложениях». Большую цель разбивайте на задачи, которые можно выполнить за одно занятие. Полезно также заранее спросить себя — зачем мне это нужно, что я уже знаю и чему хочу научиться. Выберите стратегию Сначала определите, что требуется — запомнить факты, понять принцип или научиться применять знания. Затем выберите 2–3 инструмента и следите за тем, помогают ли они решить именно эту задачу. Если тема вам совсем не знакома, начните с объяснения и примеров, которые дают необходимую опору для дальнейшей работы. Сохраняйте концентрацию во время занятия Учиться лучше в месте, где меньше отвлекающих факторов. Во время занятия распределяйте время между знакомством с темой, выполнением заданий, повторением и синтезом материала. Параллельно наблюдайте за собой — что понятно, где возникли трудности, какие появились вопросы. Сначала вспоминайте, потом сверяйтесь с источником Активное припоминание — один из наиболее эффективных методов обучения. Закройте текст и попробуйте воспроизвести материал по памяти, а потом проверьте себя. Повторяйте с увеличивающимися интервалами Применяйте интервальное обучение: возвращайтесь к теме на следующий день, через несколько дней, через неделю. При каждом повторении вспоминайте материал заново, а не перечитывайте конспект. После занятия оценивайте результат и меняйте план Сравнивайте результат с вашей целью и предыдущими попытками, а не с успехами других. Если что-то не получилось, ищите объяснение в факторах, на которые вы можете повлиять: выбранной стратегии, количестве практики или подготовке, — и корректируйте их. Подробнее о том, какие методы самообучения работают, а какие нет, — в полной версии статьи. Время чтения: 10 минут 🤖 «Системный Блокъ» @sysblok
-
edited Telegram doesn't show this post on the web. Open it in Telegram to see it.
- Older posts