Но этот подход сработал, пока статья была одна и решений была парочка; но что если взять мощные внутренние модели фронтир компаний и пройтись по широкому набору открытых проблем? Так сделали OpenAI: они взяли ту же модель, что решила задачу тысячелетия в начале сентября и пропустили через неё примерно 4000 задач. Количество мощностей почти на каждую задачу было относительно маленьким: вместо роя из тысяч агентов всего лишь аналог ~3 часов работы GPT Pro (это которая запускает несколько суб-агентов в паралелль, и в целом доступна в подписке за $100/$200). Получилось решить 372, и по этим результатам LLM написали 719 статей (сами решения + сопутствующие аргументы, следствия или альтернативные доказательства). Перед OpenAI встал выбор: а чо делать та) В прошлый раз, когда они выложили один (1) результат по Навье-Стоксу — на них ополчилась часть математического сообщества. Не все были довольны, особенно те, кто работал в том же направлении. А тут целых 372 результата — это же сотни рабочих групп, от студентов до докторов наук, по всему миру. Они вот сидели работали год или даже больше над чем-то, возможно были очень близки, а тут... выйдет вайб-слоп статья от внутренней модели OpenAI, которая даёт результат? Как на это отреагируют? Кажется, что повторить подход Anthropic будет сложно чисто с организационной точки зрения: искать сотни людей в академии, подписывать с ними соглашения, терпеть людей вроде Buckmeister, которые скажут, что украли их результаты, и платить за ревью. В итоге OpenAI сделали простое заявление, выложили все результаты на GitHub. 63% от 372 основных результатов помимо статьи имеют формализованное на Lean доказательство (это язык программирования для математиков, на котором можно записать доказательство, а компьютер проверит, что в нём нет несостыковок и ошибок). Это не даёт 100% гарантии что они все верны, но в целом является солидным подкреплением. Я удивлюсь, если в формализованных результатах, скажем, больше 10-12% будет ошибочным — и ещё меньшая часть будет неисправима в краткие сроки. OpenAI уже отозвали 3 статьи, исправили ещё 14, правда я не нашел статистики сколько исправлений как раз в формализованных результатах. Может ли научное сообщество игнорировать этот сказочный слоп дроп? Нет: там есть очень сильные результаты, и как минимум про 10 разных статей я читал от, кажется, авторитетных математиков и учёных других областей, что сам по себе такой результат, будь он опубликован человеком, сделал бы ему имя, попало бы в ведущий журнал или вовсе привело к получению Филдсовской премии. Сложно закрыть глаза, сказать «ничего этого нет» и продолжить работу как будто ничего не случилось. Но и вычитывать ошибки за LLM или брать решение OpenAI «на веру» и не разбираться в нём (а разбирать LLM-сгенерированные статьи без вычитки и полировки очень сложно, с этим согласны кажется все) научное сообщество не готово, да и не должно. Так что сейчас идут активные обсуждения будущего математики и смежных наук. Как должно выглядеть будущее, где компания в один день может подрезать работы тысяч учёных? Как тем работать, зная, что перед релизом следующей модели существует угроза его работе? В чем искать смысл?

Сиолошная
Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса. Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
-
-
edited В понедельник 5-го октября на архив выложили препринт «Truly Subquadratic 3SUM and Truly Subcubic APSP via Triangles in Sparse Lopsided Graphs». В нём опровергают две гипотезы о сложности алгоритмов решения двух задач. Одна из них формулируется очень просто, и вы наверняка на неё натыкались, если готовились к собеседованиям на LeetCode — 3 sum. Вам дан массив из n чисел (включая отрицательные), и нужно определить, есть ли в нём 3 таких, что их сумма равна нулю. В теоретической информатике долгое время существовало предположение, что для этой задачи невозможно найти алгоритм, который работал бы существенно быстрее квадратичного от размера массива. 3 sum — одна из центральных гипотез раздела fine-grained complexity. Многие другие задачи можно свести к 3 sum. Поэтому на предположении строилось множество других результатов: исследователи показывали, что если 3 sum невозможно существенно ускорить, то нельзя существенно ускорить и целый ряд других задач. И вот оказалось, что существует общий алгоритм, который вместо n^2 работает за n^(1.9992). Само по себе ускорение не особо интересно (в практике оно может работать даже медленнее, так как из нотации выкидывают константы) — и ключевым является именно опровержение гипотезы, которыми многими считалось «логичной» и «красивой». Один из двух авторов — Virginia Vassilevska Williams, одно из ведущих имён в области fine-grained complexity. И казалось бы можно порадоваться за прорыв, но если открыть конец статьи, то увидим: Как результат был первоначально получен и передан авторам: сотрудник Anthropic использовал внутреннюю исследовательскую модель для изучения открытых проблем в теории криптографии. <...> В сентябре 2026 года Anthropic передала алгоритм авторам на условиях соглашения о конфиденциальности, предложила вознаграждение и предоставила доступ к публичной версии Claude. <...> После того как статья была полностью написана, Anthropic использовала внутреннюю исследовательскую модель для формальной проверки основных результатов статьи с помощью Lean. <...> Авторы работали над этой публикацией в личное время, вне рамок своих служебных обязанностей в Колумбийском университете и MIT. Так что получился немного странный для науки подход «найти и проспонсировать подставное лицо, не участвовавшее в составлении доказательства, и указать его в качестве автора, и при этом указать, что работает он без своей основной аффилиации». Я против такого подхода ничего не имею, но многие в научном сообществе видят здесь несоответствие... духу? морали? науки и тому, как вещи «принято» делать. Но в конечном итоге есть ведущий учёный, который вчитался в результат, проверил, поставил своё имя под ним, что даёт хоть какую-то гарантию легитимности, и есть надежда, что результат будет использоваться в будущих исследованиях.
-
To industrialize — to develop or organize something so it can be produced or operated at industrial scale—systematically, efficiently, and usually in large quantities.
-
edited В мире с миллиардом Эйнштейнов кому-то всё равно придётся строить лаборатории и вести бухгалтерию. Авторское эссе The Eternal Complement на сайте OpenAI задаёт вопрос: насколько быстрее сможет развиваться цивилизация, когда интеллект перестанет быть дефицитом? Галилею хватило двух линз и трубки. Для телескопа «Джеймс Уэбб» понадобились сотни организаций. Чем дальше мы хотим заглянуть, тем больше работы стоит за открытием. За этим образом есть экономические данные. В работе Блума и соавторов, на которую ссылаются авторы, поддержание темпа роста плотности транзисторов требовало более чем в 18 раз больше исследователей, чем в начале 1970-х. Похожие тенденции обнаружились в сельском хозяйстве и медицине. Отдача от исследовательских усилий снижалась, а увеличение их масштаба компенсировало это падение. За привычным темпом прогресса скрывалось всё больше работы. Интеллект и возможности исполнения усиливают друг друга: хорошая гипотеза делает телескоп полезнее, хороший телескоп повышает ценность гипотезы. Сюда же относятся финансирование, производство, законы и логистика. Сегодня AI даёт одному человеку возможности команды. Всё важнее становится вкус: что вообще стоит делать, на какие вопросы искать ответ? Но если машины сами начнут производить выдающиеся идеи, исполнение снова может стать узким местом. Дальше возможны два сценария. В «цивилизации глубины» сверхразум извлекает больше из накопленных данных, улучшает симуляции и точнее выбирает эксперименты. В «цивилизации ширины» новые идеи требуют всё больше лабораторий, заводов и энергии. Даже гениальному исследователю приходится ждать, пока вырастет организм или закончится эксперимент. Возможно, большая часть сверхразума будет занята скучной работой. Темп прогресса определит то, сколько реального мира потребуется каждой следующей гениальной идее. (а ещё в блогпосте с эссе очень вкусные картинки, мне понравились, посмотрите и вы)
-
(sticker without text)
-
edited viral 
Нежданно негаданно Google представили Gemini 4 Argon Доступа пока нет, выкатят на всех когда нибудь скоро. Цены планируют такие: $2/$10, и кэш со скидкой 95% (но это на период промо, после подскочат в два раза).
-
edited 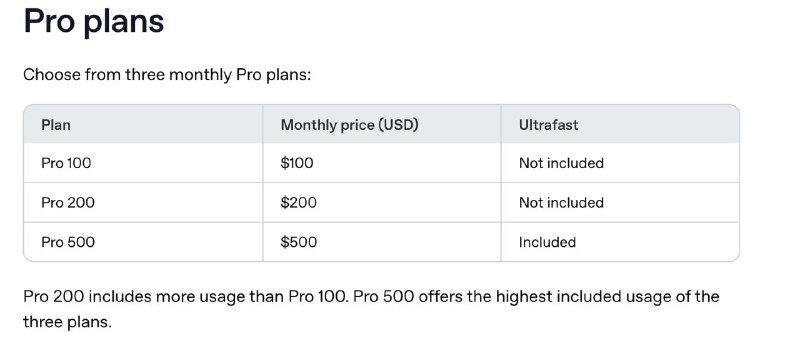
Пока рассказывают про Grok Bot и Muse— в документации уже указано, что: 1) да, будет тир за $500. Пока без информации по лимитам. 2) В НЁМ БУДЕТ УЛЬТРА ФАСТ ДЛЯ АСТРЫ (!) - 300 токенов в секунду, и в будущем для Sol. Поздравляем команду Cerebras, которая смогла развернуть такую огромную и мощную модель у себя. Очень жду. 3) также уже вышел Sol-6.1, цена та же, но кэш дешевле в 2 раза. По метрикам ближе к Astra, не смотрится так позорно, как Sol-6 (неделю назад...). Попробуем. UPD: x25 usage за $500
-
OpenAI DevDay через 10 минут: https://www.youtube.com/watch?v=Fls_onRviPM Обещают более 20 анонсов!
-

Утром Tibo написал, что сегодня вернут подписки ChatGPT за $200... но есть одно "но": в них будет x10 лимитов вместо x20. Это же применимо и к старым подписчикам. По слухам, сегодня представят подписку за $500 — пока не ясно, какие там лимиты; может быть x25 (получается чуть больше чем было до этого за $200), а может что-то более выгодное. Можно помечтать от x50... Также в этой подписке, предположительно, появится ультра-фаст режим с генерацией до 750 токенов в секунду (правда это обещали для моделей размера Sol, не ясно, будет ли что-то для Astra). Когда я сегодня в чате рассуждал о причинах — то смог придумать 3 версии, почему подписка за $200 сильно похудеет: 1) хотят продвигать подписку за $500, зная, что те кого задевают урезания лимитов на 200 могут себе позволить купить за $500 (=> больше выручка) 2) у них невероятно вырос спрос, на десятки процентов, и мощностей реально не хватает, и потому решили максимизировать выручку 3) мощности перекидывают на исследования и запуск роев агентов для решения разных прикольных задач, как было с задачами тысячелетия И, видимо, вариант 2 правильный — только что появились новости, что компания нарастила ARR почти до $70B — более чем на 70% с начала третьего квартала; а enterprise вырос более чем вдвое. Если "почти до 70" означает хотя бы 67 и выше, то OpenAI почти наверняка обошли Anthropic по выручке — с учетом того, что вторые считают деньги от партнёров иначе, и OpenAI «занижает» цифры. Релиз Astra прошёл отлично 🚀🚀🚀
-
edited 
Reuters ознакомились с приватными проспектами Anthropic перед предстоящим IPO: — чистый убыток в размере 42 миллиардов долларов за 2025-й год (34 миллиарда из них - бухгалтерская переоценка активов с учетом инструментов, которые в будущем могут конвертироваться в акции Anthropic) — 😐 планируют потратить 518 миллиардов долларов на вычислительные мощности и инфраструктуру в 2027-м — в прошлом году они потратили 7.3 миллиарда долларов на мощности и инфраструктуру — планируют целиться в оценку в 2 триллиона на IPO === я пока не понимаю, откуда они столько денег возьмут 👨🦳 посмотрим, чем будет удивлять Dario UPD: текст новости исправили, теперь там траты в $518B указаны на «следующие годы», не «следующий год».
-

Похоже, что GPT 6 Astra останется лучшей моделью OpenAI надолго — завтра на DevDay почти наверянка не представят обновление, и даже релиз 6.1 с октября перенесли на неопределенный срок из-аз переживаний по поводу безопасности.
-
repost По данным Bloomberg, Китай ограничивает зарубежные поездки ведущих AI-специалистов частных компаний и расширяет ограничения на их семьи. Супругам и детям ряда руководителей AI- и чиповых компаний, чья работа считается критически важной для госбезопасности, теперь нужно получать одобрение Пекина даже для коротких поездок за границу. Госорганы уже уведомили нескольких человек, а список планируется постепенно расширять. При этом неясно, распространяется ли требование на семьи всех, кто уже находится под ограничениями. Сами ограничения для специалистов из таких компаний, как Alibaba и DeepSeek, действуют с начала года. Отдельно с 15 сентября вступили в силу правила применения запретов на выезд, в том числе при возможных нарушениях промышленной и технологической безопасности. Подобный режим, включающий родственников, Пекин применял к университетским исследователям, физикам-ядерщикам и руководителям госкомпаний. Вообще, формально это не запрет на выезд, а выездные визы. Потому что коммунизм. https://www.bloomberg.com/news/articles/2026-09-28/china-broadens-travel-curbs-to-encompass-family-of-top-ai-talent
-
edited На данный момент миссия идёт не без неровностей, но успешно: — в середине набора высоты отключился один из двигателей (но это некритично, можно потерять несколько) — после разделения ступеней не работало уже 2 двигателя, но.. это всё еще не критично — ускоритель смог затормозить и мягко сесть на воду, по крайней мере так выглядело с камер, официального подтверждения нет — у корабля уже на большой высоте отказал один из двигателей... но снова не критичный! После 20-минутной проверки было принято решение, что всё в норме (этот двигатель так и так дальше не использовался, ибо он во внешнем контуре, а для подъёма орбиты и схода с неё используется внутренний, как и при посадке на воду), и можно выходить на орбиту — наконец, Starship занял орбиту и успешно выпустил 26 спутников Starlink v3; с первыми из них уже установлена связь (UPD: уже со всеми). Это уже полноценная коммерческая нагрузка, не муляжи. — Каждый из спутников существенно увеличивает пропускную способность всей сети (в 10 раз больше, чем v2, примерно 1 Tbps). — пока что ничего не мешает Starship направиться на посадку в океане и тем самым успешно закончить миссию; вопрос в том, сколько витков вокруг Земли его заставят пройти и в каком океане сесть (предусмотрено до 6 витков). И пока писал — увидел, что сегодня оказывается ровно 18 лет с первого успешного выхода на орбиту ракеты Falcon 1, произошедшего в рамках четвертого пуска. Именно он стал основной для будущих коммерческих контрактов компании и спас её от банкротства — изначально денег было вообще на 3! пуска, но Elon кое-как поскрёб по инвесторам и смог собрать. Часто говорят, что провались они тут — компания бы умерла. И вот спустя 18 лет огромнейший корабль смог вывести 46 тонн полезной нагрузки на орбиту! А дальше — больше (эта версия может выводить 100 тонн, следующая 200).
-


И ещё инфографика отсюда по готовности будущих кораблей и ускорителей. С одной стороны готово по сути всего 3 корабля и 3 ускорителя. С другой — так как их планируют начать ловить со следующего пуска и перезапускать, видимо, через 2-3 пуска — то может быть как раз этого и хватит надолго и на много запусков. Наверняка эти корабли и ускорители не будут летать сразу по 5-10 раз, но даже просто один повторный пуск — это уже обеспечивает план пусков на месяцы вперед.
-
repost 
План первой орбитальной миссии Starship Flight 14 — до старта 2 часа. Сегодня особенный день — SpaceX наконец-то пришли к первой миссии по эксплуатации своей сверхтяжёлой ракеты с выводом 26 спутников Starlink V3 где-то на 45 тонн. Этот запуск будет дальше, дольше и сразу на 6 витков вокруг Земли. Между стартом и завершением миссии пройдёт почти 10 часов, а корабль Starship впервые сядет в Тихом океане. Основные цели этой миссии: выполнить абсолютно все задачи, включая старт, выход на замкнутую орбиту, вывод нагрузки, длительное пребывание в космосе и симуляцию посадки для двух ступеней. И если все задачи будут выполнены, то следующие миссии уже будут с посадкой на башню. И да, по плану намного раньше и их двух штатов до конца этого года. Ключевые этапы Flight 14: ⚪️ Запуск 33 двигателей Raptor 3; ⚪️ Старт с Pad 2 и прохождение зоны Max Q; ⚪️ Горячее разделение Starship S41 и Super Heavy B21; ⚪️ Запуск 6 двигателей на S41 и перезапуск 28 двигателей (5 будут работать) B21 для первого тормозного манёвра; ⚪️ Вход Super Heavy B21 в атмосферу с прохождением зоны максимальных нагрузок; ⚪️ Перезапуск 13 двигателей на Super Heavy B21 для второго тормозного манёвра; ⚪️ Выход корабля Starship S41 на первичную незамкнутую орбиту; ⚪️ Симуляция посадки B21 на виртуальную башню на воду с последующей утилизацией; ⚪️ Разгонный импульс Starship S41 для выхода на круговую замкнутую орбиту 275км; ⚪️ Открытие шлюза грузового отсека; ⚪️ Выгрузка 26 спутников Starlink V3; ⚪️ Starship S41 находится на орбите почти 9 часов и 6 витков; ⚪️ Перезапуск 1 двигателя Raptor 3 на свода с орбиты; ⚪️ Вход Starship S41 в атмосферу, и прохождение зоны максимального нагрева и нагрузок; ⚪️ Теплозащита Starship S41 выдерживает вход в атмосферу, плавники и функциональный механизм посадки не расплавляются; ⚪️ Перезапуск 3 двигателей на S41 с мягкой посадкой в Тихом океане рядом с буями (симуляция посадки на башню). Время запуска Flight 14 на 28 сентября: - 07:15 по Техасу - 14:15 по CET - 15:15 по МСК Официальная трансляция в 4K начнётся за 35 минут до запуска и доступна тут — https://x.com/i/broadcasts/1qxvvenMPMQxB Всем заранее приятного просмотра, команде хладнокровия, и посетителям беречь уши. И помните, что успех не гарантирован, но точно будет весело 🚀
-
repost Лучшие дебаты про безопасность ИИ для нормисов В последнее время слушал много подкастов на тему AI safety в поисках того, который можно было бы смело рекомендовать обычным нормисам уровня погружения «ну я немного слышал о хайпе про “ИИ нас всех убьет”, с точки зрения здравого смысла звучит как полная ерунда, конечно…». Так вот, я его нашел – встречайте, идеальный выпуск для погружения в текущее состояние этого дискурса: The Diary Of A CEO – дебаты между Нейтом Соаресом, Романом Ямпольским, Эдом Зитроном и Эндрю МакАфи: https://www.youtube.com/watch?v=OhOmLqR5nN4 Я прямо горячо рекомендую вам посмотреть этот выпуск на 2,5 часа (там в настройках Ютуба можно включить русскую дорожку), причем чем дальше – тем он становится лучше. Происходящее на этом подкасте наглядно иллюстрирует одну особенность текущего AI safety-дискурса. Чуваки, которые варятся в этой среде последние 10+ лет (и которые серьезно относятся к ИИ-рискам для человечества), потратили уйму времени на размышления в этой области. Они уже сто раз видели и обсуждали самые сильные аргументы против того, что AI может представлять для человечества реальную угрозу. А самые громкие критики ИИ-рисков с другой стороны, которые отстаивают тезис «да это всё научно-фантастический хайп от фантазеров, никакие адекватные люди не будут это обсуждать всерьез», – выглядят на этом фоне, как бы это помягче сказать… Как будто они впервые задумались о проблеме примерно неделю назад, и тормознули там на уровне «мне сразу пришли чисто из здравого смысла три очевидных возражения, почему AI risk – это чушь, и я на этом остановился». Там есть прямо пара наглядных моментов, иллюстрирующих это. Примерно на сороковой минуте Эд Зитрон спрашивает Нейта Соареса (одного самых громких сторонников замедления AI-лабораторий в мире, который буквально управляет самой известной нон-профит компанией с такой целью): «Так а если уж ты так опасаешься этих рисков от ИИ, сфига ли ты не пытаешься остановить AI-лабы??» – то есть, он реально даже не очень понимает, с кем он дебатирует (к уровню аргументации это, конечно, не относится – но показывает степень погруженности в тему). И уже ближе к концу, когда они обсуждают детали взлома Hugging Face, Эндрю МакАфи в ответ на описание от Нейта Соареса говорит «ну, я доверюсь тебе, что ты правильно пересказал факты произошедшего…» – то есть, он даже сам не погружался в отчеты по самому знаковому инциденту AI misalignment, который обсуждается со всех сторон уже целый месяц, чтобы составить собственное мнение. Причем, это не потому, что ведущий подкаста специально пригласил в качестве оппонентов для AI-думеров эдаких «мальчиков для битья» послабее – просто весь дискурс сейчас реально выглядит примерно вот так. Там как бы не очень понятно, кого звать из «действительно сильных анти-думеров». Еще одной иллюстрацией этому, кстати, служит другое свежее интервью с Дженсеном Хуангом (CEO Nvidia, продающий лопаты в нынешней золотой лихорадке с очень некислой прибылью), который недавно вовремя упал на уши Дональду Трампу и убедил его публично выступить с позиции «ФЕЙКИ про риски ИИ распространяют ПРЕДАТЕЛИ АМЕРИКИ». Так вот, уровень аргументации Хуанга на этом подкасте такой, что самый часто встречающийся тип комментариев под ним звучит как «вообще-то я раньше не опасался рисков от ИИ, но как послушал аргументы Хуанга – мне что-то стало страшновато…» Возвращаясь к дебатам на DOAC, мне тут хочется еще похвалить Нейта Соареса: он на них выступил как настоящий слоняра. Если смотреть глазами «человека со стороны», то Роман Ямпольский может чисто по вайбам производить впечатление немножко «городского сумасшедшего» – со всеми его закатываниями глаз на реплики оппонентов, и т.д. А вот по Нейту прямо видно, что он потратил уйму времени на то, чтобы научиться говорить об этой сложной проблеме таким образом, чтобы не отпугивать нормисов – и он с этой коммуникационной задачей справляется на отлично. Завершаются дебаты примерно так: Эд Зитрон всю вторую половину вообще практически не участвует в разговоре (подозреваю, он где-то в середине понял, что конфронтационную дискуссию с Соаресом просто не вытянет). МакАфи честно старается дискутировать до конца – но там видно, что он на таком уровне глубоко про всё это просто никогда не пытался думать, поэтому откровенно барахтается. Его финальная позиция близка к «ну ладно, я согласен, что это всё выглядит опасно – но я уверен, что умные ребята в AI лабах КАК-НИБУДЬ придумают, как сделать сильный ИИ безопасным». Очень круто, братан, а что будем делать с тем фактом, что топовые сотрудники отделов AI safety этих самых лаб массово выступают с посылом «ребята, мы тут очень пытаемся, но мы просто НЕ ЗНАЕМ 100% надежных способов обеспечить полную безопасность фронтирных моделей»? Короче, повторюсь, отличные дебаты – рекомендую посмотреть.
-
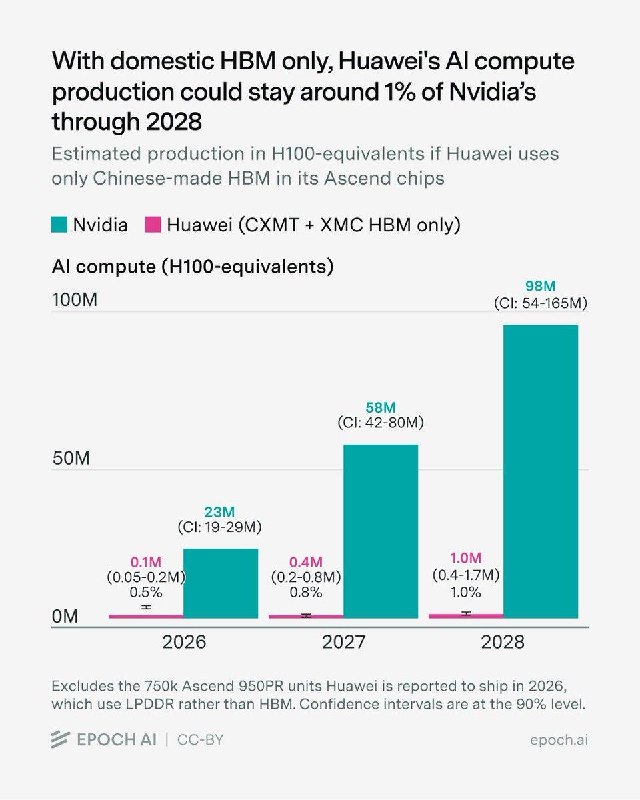

Экспортный контроль чипов действительно существенно влияет на китайские компании. Да, некоторые уже пытаются переходить на Huawei и другие — но их производство тоже сильно ограничено, и особо сильно упирается в память. Epoch.AI подсчитали, что если Китай будет использовать только HBM (память в GPU для LLM) собственного производства, то они смогут производить примерно... 1% от GPU Nvidia (первая картинка) в ближайшие годы — и эта доля падает (в 2026-м это примерно 4%). Насколько контрабанда HBM позволила бы сократить дефицит? Предположим, Huawei контрабандой ввезла бы в 2028 году в 10 раз больше HBM, чем на внутреннем рынке, — невероятно большой объем, обошедшийся как минимум в 40 миллиардов долларов. В этом случае ее производство в 2028 году выросло бы с 1 млн до примерно 11 млн H100-эквивалентов, что по-прежнему составило бы лишь 11% от производства Nvidia в том году. Поставки HBM в Китае и производство чипов Huawei будут быстро улучшаться, но, вероятно, недостаточно быстро. Даже 18-кратное увеличение мощностей HBM в Китае к 2030 году приведет к тому, что объем производства Huawei составит примерно 12-18% от объема производства Nvidia в 2028 году. На второй картинке — попытка Epoch.AI оценить контрабанду чипов в Китай через Малайзию в период после введения ограничений администрацией Байдена и до ужесточения регуляций на экспорт в самой Малайзии. Логика подсчёта проста: таможни всех стран записывают что приходит и что уходит, а затем общие данные отправляются в ООН. Цифры агрегированы по кодам пересылаемых объектов — и почти все чипы попадают в одну категорию. Разница, которую видно на картинке — это разница между тем, что отправлено из Малайзии (по заниженным ценам) в что записано к получению в Китае (по реальным ценам, они ж не могут уходить от оплаты пошлин и налогов у себя дома). Итого насчитали за ~год контрабанды на $3.8B, или примерно аналог ~150'000 видеокарт H100. === Вся информация выше лишний раз подчеркивает, насколько сильный рычаг воздействия остается у США и Nvidia. Если укрепить меры контроля за контрабандой и отслеживать карты прямо с производства на Тайване — Китаю придется несладко (как бы не пришлось возвращать остров под свой контроль 👨🦳).
-
edited Немного новостей из поднебесной от TheInformation: — DeepSeek достигли ARR в $1B (ARR = выручка за последний месяц, умноженная на 12, то есть сколько они заработают за год, если спрос не изменится). У OpenAI последние цифры были в районе $40B, у Anthropic $65B, но обе скорее всего выросли после успешных недавних релизов. — к концу октября DeepSeek планирует привлечь новый раунд инвестиций в размере $7.5B при оценке $75B. Это уже существенные цифры, хоть и всё равно на порядок меньше американских конкурентов. — Рост выручки DeepSeek частично обусловлен повышением цен в прошлом месяце, в результате которого стоимость моделей для клиентов увеличилась в 2.3–4.5 раз (но даже при этом они остаются очень дешевыми). В июле писали, что ARR был порядка $400M-$500M. — валовая маржа компании в начале года была 82.9% — то есть даже при очень дешевых моделях они всё ещё имели огромную наценку. — DeepSeek продолжает направлять большую часть своих ресурсов на разработку новых моделей. Компания выделяет более 70% своих вычислительных мощностей на обучение моделей, оставляя менее 30% для инференса под API и клиентов. Но без роста количества мощностей продолжать наращивать выручку будет сложно (без повышения цен на модели). — компания исследует возможность использования игровых видеокарт Nvidia вместо серверных для разворачивания моделей. Такие GPU сильно дешевле. — Ранее в этом месяце компания Z.ai (авторы моделей серии GLM) сообщили, что их ARR достиг $1,8B. Другой китайский конкурент, MiniMax, заявил, что ARR вырос до $800M в августе со 150 миллионов долларов в феврале. — Для DeepSeek одной из самых больших проблем на будущее является обеспечение достаточного количества вычислительных ресурсов для обучения новых моделей в условиях экспортных ограничений США на передовые чипы Nvidia. — The Information во вторник сообщили, что китайский интернет-регулятор расследует деятельность DeepSeek и Moonshot AI после того, как Anthropic заявила, что обе компании передавали конфиденциальные данные пользователей моделям Claude (💳)
-
edited Адам Елдаров, ex-CPO YouDo, написал два поста про экономику AI-подписок и развенчание мифа о том, что подписки — «субсидируемые» и что компании на них теряют огромные деньги. Я согласен наверное с 95% того что там написано. Форвардить два поста не хочется, поэтому зайдите и почитайте, если вам интересно: https://t.me/c3po_notes/589 и следующий за ним. Не знаю, планировал ли Адам писать про это дальше, но мне кажется логичным продолжением будет рассуждение о том, когда у компаний изменится баланс выручки и трат на RND / обучение моделей. Пока что растет и одно, и другое, поэтому легко ошибиться и сказать «так они всегда будут убыточными!», что, очевидно, не правда, потому что второй компонент можно контролировать: ты можешь выбрать не тратить больше денег на обучение или исследование. Сейчас такой выбор никто не делает, так как денег от пользователей и инвесторов хватает. И оба эти компонента +- одинаковые у двух ведущих компаний. Экономика их трат тоже примерно одна и та же: они платят примерно одинаково своим сотрудникам и примерно одинаково платят за видеокарты и датацентры. Если выручка перестанет расти или вообще наметится спад (одновременный для двух компаний в силу внешних причин) — обе компании будут принимать одинаковые решения по урезанию костов. Пока она продолжает расти — они пытаются дотянуться до как можно большего количества мощностей и ведущих специалистов, и оба компонента ограничены какими-то факторами сверху. Вполне возможно, что через 2-3 года расходы компаний на мощности перестанут расти вслед за выручкой — просто потому что больше чипов не будет, можно купить лишь столько, сколько производит маленький островок около Китая. По-моему Dylan из SemiAnalysis говорил, что где-то в 2028-м году две (три?) компании будут получать больше половины всех новых чипов — отсюда, очевидно, x2 сделать уже просто некуда. Для всех игроков в системе экономика одинаковая: сервер стоит столько-то, в будущие датацентры нужно инвестировать столько-то, чтобы получить столько-то выручки (выручка на мегаватт мощностей у всех разная, и тут OpenAI/Anthropic далеко впереди всех; остальные игроки будут пытаться спустить этот показатель с небес, но они не могут сделать это ниже своего уровня — а они в среднем менее эффективны — потому что иначе придётся платить из своего кармана, который не такой глубокий, как у фронтира).
-

Отдельный вопрос это «если модели дешевле, то будет ли у меня больше использования в Codex?». Ответ — да! (сравните Sol 6 и 5.6 — в полтора раза больше).
- Older posts