Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса.
Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
Subscribers80.7K tracking since 23 Oct
Reach per post (ERR)39.0%31.5K avg views
Posting1.3/daylast 1 day ago
Reactions per 1K views9.8👍 🔥 🤡
А вот и OpenAI: встречайте GPT-6 Sol и Luna.
— обе модели ровно в 2 раза дешевле, чем их 5.6-версии.
— общаться должны так же понятно и без жаргона, как Astra
— и... всё. Sol не лучше Astra (а во многом и хуже, в отличии от пары Fable <-> Opus), но сильно дешевле, и всё ещё лучше Sol 5.6. Поэтому модель может стать основной рабочей лошадкой, сохраняя ваши лимиты.
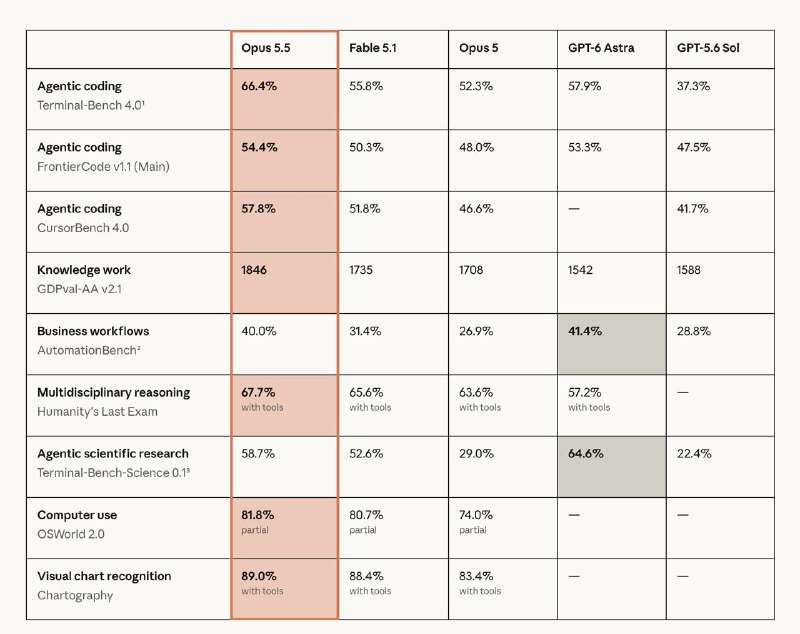
Вышел Claude Opus 5.5, уже есть в приложении. Вместе с этим.. дали banked reset (как делают OpenAI — можно применить в любой момент).
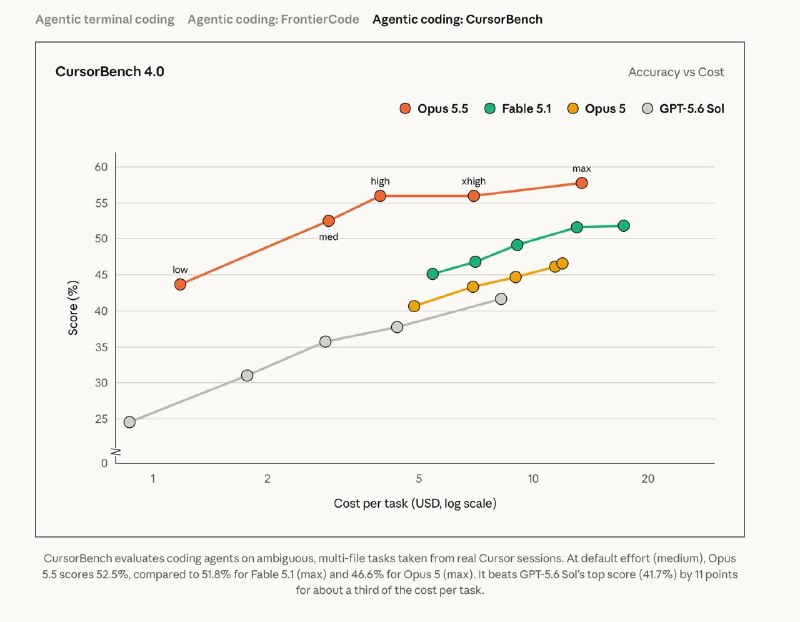
— Для работы Opus 5.5 требуется меньше вычислительных ресурсов, чем для Opus 5, и это отражается на его цене: $4/$20 (на 20% меньше, чем было), а чтение из кэша $0.2 — на 60% меньше.
— При этом скорость генерации выросла в среднем на 30%
— 5-часовой лимит увеличен (без изменения недельных)
— «Opus 5.5 общается более естественно, чем предыдущие модели. Первые тестировщики отметили, что его текст стал чётче и легче для восприятия» — это мы с удовольствием проверим
— Claude Sonnet 5.5 и Claude Haiku 5.5 выйдут скоро, в ближайшие недели
— в кибербезе, биологии будут такие же строгие фильтры, как у Fable 5.1.
repost
Telegram doesn't show this post on the web. Open it in Telegram to see it.
edited
Telegram doesn't show this post on the web. Open it in Telegram to see it.
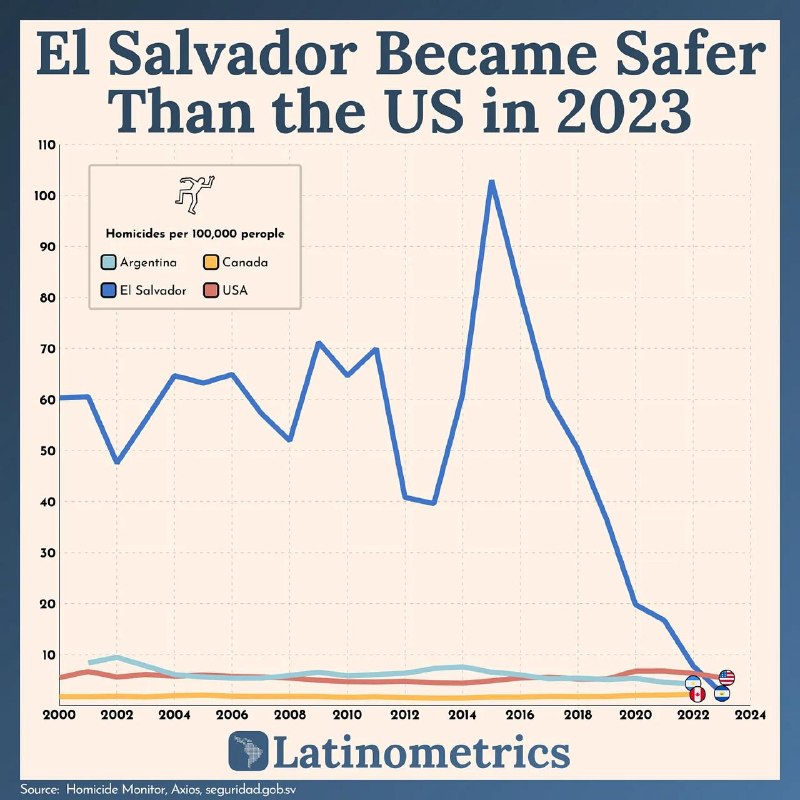
И абсолютно невероятная картинка с Эль Сальвадором, который имел очень высокий уровень преступности (на графике — убийств (не мелких преступлений), но в 2023м году после многих лет работы над системой они смогли добиться уровня ниже США.
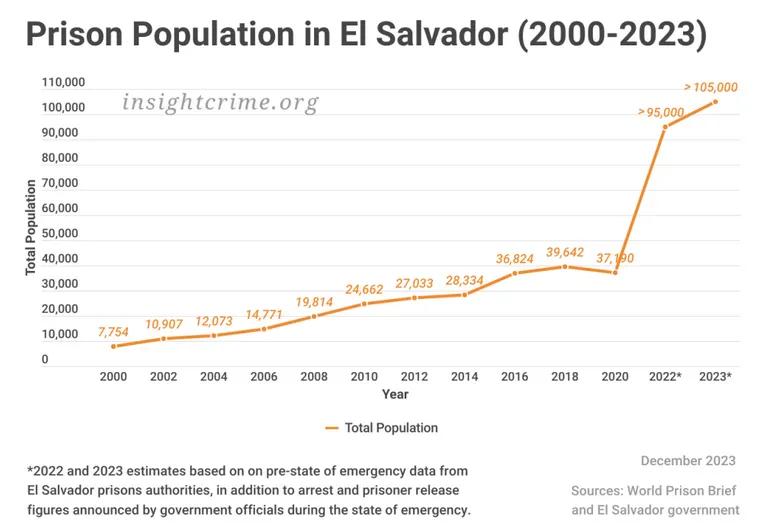
Это сопровождалось четырехкратным увеличением количества заключенных.
Как им это удалось? Благодаря сочетанию значительных финансовых вложений, непритязательности в вопросах прав человека и условий содержания в тюрьмах, а также непритязательности в отношении того, были ли заключенные виновны в каком-либо конкретном преступлении или просто имели отношение к бандам.
Утром прочитал у Scott Alexander пост двухлетней давности про тюрьмы и преступления. Там есть много интересной статистики и неочевидных выводов, но в целом стало грустно: в развитых странах мелкие преступники спокойно живут и орудуют потому, что система ценит человеческую жизнь, судебная система развита и предоставляет множество пособий для защиты даже казалось бы однозначных преступников, а цена труда очень высока.
В целом по совокупности факторов это приводит к тому, что есть преступники, которых ловят (ЛОВЯТ) больше 20 раз, и они продолжают шоплифтить — как яркий пример приводится нью-йоркская группа из 327 шоплифтеров, ответственных за треть всех шоплифтов в городе. И даже в этой ситуации система не может однозначно сойтись к тому, что их надобно запереть на подольше в тюрьме.
Многих отпускают или дают очень мягкие наказания (короткие сроки) потому, что в тюрьмах уже высокая заполненность, и каждый посаженный шоплифтер это не посаженный убийца. Логично спросить: а почему бы не построить больше тюрем? Ответ не так прост:
1. В США уже сидит в тюрьме 0.75% населения (5 в мире). Из-за стоимости труда и ценности жизни каждый заключенный обходится в 31000 долларов в год (и это за 2008, сейчас в два раза больше). А в Калифорнии — 120000 за год. Бюджета на заключение в 3 раза большего количества людей просто нет.
2. Судебная система перегружена, так как даже очевидные преступления с полным доказательством (камеры + показания офицера + свидетелей) всё равно проходят полный цикл с несколькими заседаниями; мелким преступникам всё равно предоставляют адвоката, иногда жюри присяжных (12 человек, если светит тюрьма), пристав, судебный репортер. Всё это — деньги. Зачастую системе проще отпустить мелкого воришку с мелким штрафом (ДАЖЕ ЕСЛИ ЭТО ЕГО ПЯТОЕ ПРЕСТУПЛЕНИЕ), ну или посадить на пару месяцев и выпустить.
3. Понимание что мелких преступников отпустят/они не получат жесткое наказание меняет мотивацию полиции, они уделяют силы и фокусируются на более серьезных проблемах.
4. Но даже если бы тюрьмы строились и преступники наказывались по всей строгости и с учётом прошлых преступлений — нет консенсуса, что длительные заключения (=изоляция от общества) помогают уменьшать преступность. Да, во время заключения человек не может навредить обществу (только своим корешам в блоке), и в среднем это «экономит» ~7 преступлений в год на человека — но после нескольких лет за решеткой человеку сложнее влиться в общество, и может приводить к рецедиву.
5. Если попытаться провести анализ затрат и выгод, то при самых благоприятных предположениях (очень слабые последствия, низкие затраты на заключение под стражу, полное отсутствие учета влияния на самих заключенных) результат окажется лишь незначительно положительным, а в остальных случаях – отрицательным 😳
Так что Scott приходит к такому выводу: тюремное заключение при нынешнем уровне его применения [в США] в большинстве случаев менее эффективно с точки зрения затрат, чем другие способы снижения преступности. Если бы людей не привлекал эмоциональный эффект от того, насколько «жёстким по отношению к преступности» выглядит такой подход, они, вероятно, предпочли бы перенаправить ресурсы системы правосудия с тюрем на другие меры — например, на полицию и суды.
Но из хороших новостей — в Европе ситуация другая, тут сажать и сажать:
европейские исследования показывают более выраженный эффект — так как в там доля заключённых составляет примерно 0,05% населения (в США — около 0,75%).
Теоретически более низкий уровень заключения объясняется тем, что преступность ниже. Но я обращаю внимание на то, что там в последнее время высока доля новых иммигрантов, и в Европе представители этих групп совершают больше преступлений в расчёте на одного человека, чем коренные жители.
Из этого можно сделать один возможный вывод: в Европе польза от лишения свободы значительно превышает его издержки.
(осталось, чтобы политики это смогли признать 👨🦳)
edited
Прошло уже почти 3 недели с релиза GPT-6 Astra, и можно подводить первые промежуточные итоги. Модель действительно вышла очень клёвой и способной, и, как мне кажется, лучше Fable 5.1: на многих бенчмарках они или идут вровень, или Astra обходит; к тому же читать текст Astra гораздо приятнее, чем слоп от Клода, и когнитивная нагрузка не такая большая, чтобы продраться через мешанину абстрактных терминов.
Astra особенно отличается в Computer Use и задачах с изображениями/видео. Не знаю что там сделали OpenAI и связано ли это как-то с Looped Transformers, но люди смогли заставить Astra пройти несколько игр: от простого «добудь алмаз в Minecraft» до... легендарной ролевой игры Fallout 3, пространственной головоломки Portal и Factorio (основная игра + дополнение). Насколько я понимаю, во всех или почти во всех случаях это не простой пайплайн «картинка с экрана -> действия», тут и там то MCP подключат, то ещё что, но это всё равно впечатляет. Легко сказать «так модели же учили на всех видео с интернета, конечно они знают как играть» — но модели 3-4 месяца назад учили примерно столько же и на том же, но они не могли проходить игры от начала и до конца.
Не одними играми славится Astra — на многих бенчмарках, в том числе тех, которые вышли после релиза (или ещё круче: авторы ещё не выпустили, но уже померили Astra, как было у Vals.AI), модель показывает существенную разницу. Из запомнившегося — WeirdML v3 на картинке в посте, свежий бенчмарк на ML-задачи, где агенту дают данные и общее описание что делать, и его цель разобраться, что в данных, обучить модели и/или написать эвристики и прийти к решению. Автор пишет, что был очень удивлён оценке Astra, и он не ожидал, что ещё фактически до релиза бенчмарка лучшая оценка будет больше 50%.
В общем, весной после анонса Mythos/Fable у меня был скепсис, что OpenAI получится быстро догнать Anthropic. По какой-то причине компания долгое время не решалась на масштабирование моделей. Возможно, не хотели упираться в нехватку вычислительных мощностей, с которой компания встретилась сейчас — не знаю. Рад, что опасения не подтвердились 🤷♂️
Теперь будем смотреть как догоняют Google, META и xAI — и китайцы с опенсурсом🇨🇳... пока в OpenAI по слухам уже идёт предтренировка ещё большей модели с кодовым названием «Bel».
Похоже у OpenAI и вправду очень сильно вырос спрос, и подписки за $200 закрыли поделом — вычислительных мощностей впритык, уже неделю не было сбросов лимитов 😭
edited
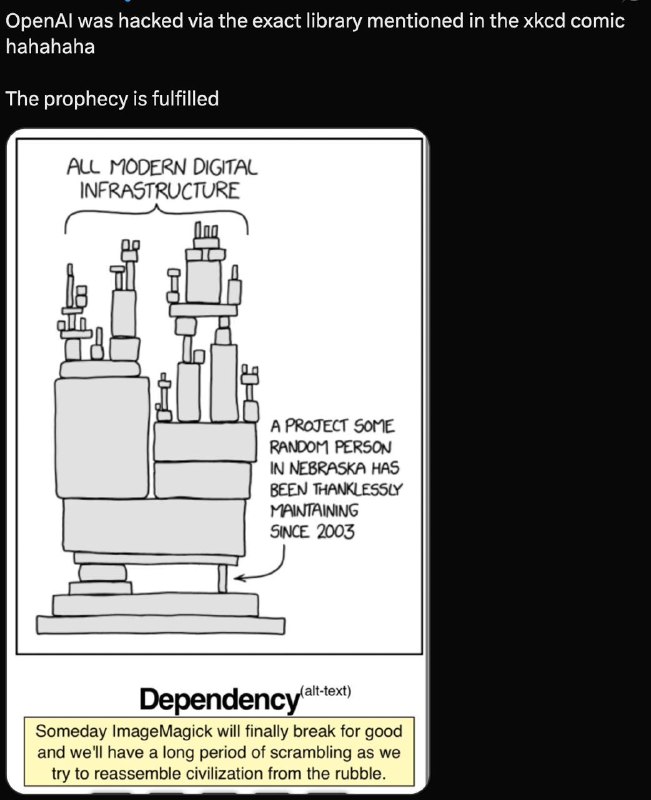
Вы наверняка видели эту картинку с XKCD. Оказалось, она была пророческой — именно через уязвимость в указанной библиотеке ImageMagick (поддерживаемой за "спасибо" каким-то рандомом из Небраски 😀) нашлись уязвимости, позволившие 3 белым хакерам и паре LLM по подписке взломать OpenAI и несколько других компаний, включая Slack, Zoom, Meta.
Сначала им удалось взломать форум обсуждений OpenAI, построенный на платформе Discourse (старый, часто используемый и никакой связи с OpenAI не имеет). Ну как "им" — в июле хакеры попросили Opus 4.8 проанализировать уязвимости, и тот справился, найдя одну в библиотеке для работы с изображениями. Потом Opus 5 переписал/улучшил хак, и по итогу загрузка картинки на форум приводила к выполнению кода.
После этого была обнаружена ещё какая-то проблема/уязвимость в SSO OpenAI (система, использующаяся для логина), и используя её хакеры могли бы в теории получить доступ к внутренним репозиториям OpenAI, чего они не сделали, ограничившись созданием одного PR как доказательство работоспособности.
OpenAI оперативно отреагировали, и через 2 дня уязвимости были исправлены.
Вот тут сборник рассказов про взломы других компаний через уязвимость в той же библиотеке изображений. На все взломы ушло суммарно... $3000 в токенах 👨🦳👨🦳
repost
OpenAI по слухам там почти решили еще одну задачу тысячелетия. Думаю, огромное число математиков сейчас лихорадочно нажимают в ЧатГПТ галку "разрешить использовать логи для улучшения моделей" и кидают в чат все пришедшие в голову гипотезы о том, как подходить к ее решению…
repost
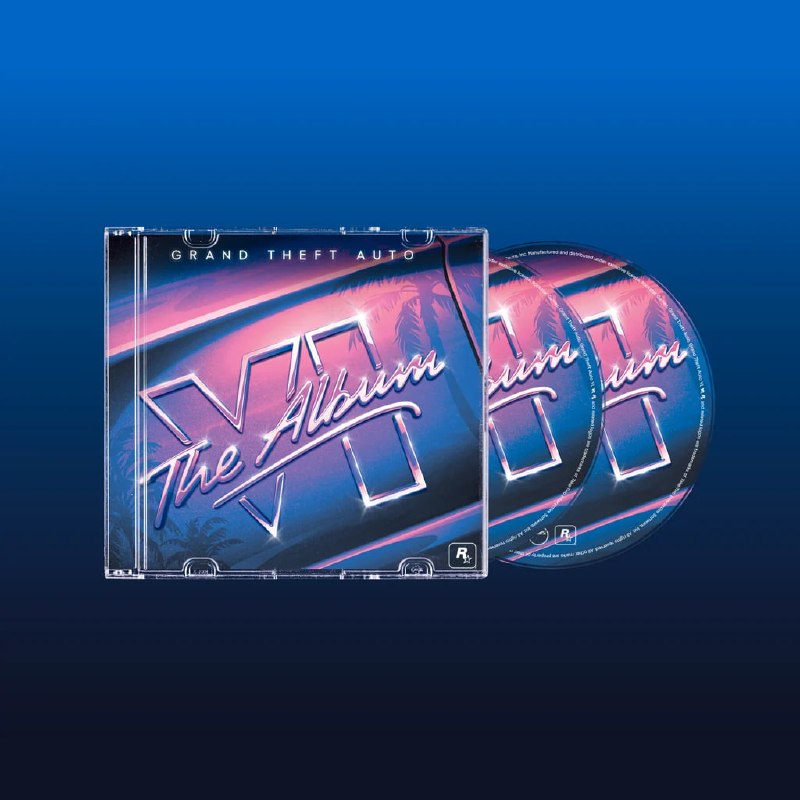
Первый взгляд на физическое издание музыкального альбома по GTA VI
Подтверждены следующие треки:
• Yung Lean - That's It (feat. Future & Metro Boomin)
• Travis Scott - RHYNO (prod. by Guy-Manuel de Homem-Christo)
• CA7RIEL & Paco Amoroso, PinkPantheress, Fred again.., & Etienne de Crécy - Sexy Magic
• Morgan Wallen - Last Thing You Need
• Rauw Alejandro - Macacoa 2000
• Keith Richards - Bright Lights, Big City
edited
И вот так в одно мгновенье Игорь превратился в фаната прослушивания винила (придётся покупать проигрыватель)
(а ещё сегодня куча треков появится в Spotify, ждём)
UPD: вот весь альбом
Вчера послушал интересное интервью Matt Sheehan на The Ezra Klein Show. Matt —исследователь китайской политики в области ИИ, старший научный сотрудник Фонда Карнеги (один из ведущих аналитических центров) за международный мир. Тема интервью — аргумент «А как же Китай?» в обсуждении ИИ-регуляций, который часто звучит в последние недели.
Мне этот аргумент казался глупым ещё пару лет назад — если Компартия верит, что ИИ сможет отобрать у них контроль или тем более привести к существенному урону, то даже для них рационально будет или остановить разработку (с некоторыми оговорками), или хотя бы снизить темп. Другое дело что они могут (пока) не верить и/или не воспринимать это всерьёз — а поскольку многие комментаторы, ставшие экспертами как в политике, так и в ИИ, считают, что это невозможно в принципе (потому что вы видели? модели же не умеют думать и даже просто считать буквы в словах), то и сам разговор как будто бы становится ни о чём.
В общем, что интересного было в интервью:
— в Китае уже действуют очень жесткие регуляции, и у них «накачана мышца» в оформлении и контроле следования регуляциям. Правда целятся они пока не во всемогущих ИИ-агентов, а во что-то попроще: рекомендательные системы, цензура алгоритмов, ИИ-компаньёны и отношения с ними (серьезно, я даже про такое не знал, а у них это было большой проблемой, которую взяли на контроль).
— таким образом Китай уже сделал несколько итераций, кабинеты заполнены уже что-то понимающими в технологиях чиновниками и экспертами, есть какие-никакие процессы: регистрация, проверки, стандарты, взаимодействие с компаниями/лабораториями. Этот опыт очень сильно поможет в будущем, не придется начинать с нуля. Тут США как раз наоборот очень сильно отстают. Но да, техническую экспертизу по новым рискам ещё нужно развивать.
— поэтому для Китая США выглядят глупо: началось обсуждение регуляций, а пока что ничего не введено, никакого контроля почти ни за чем, связанным с ИИ. Никаких серьезных ограничительных шагов нет, но если и когда они появятся — это может быть серьёзным толчком к диалогу. Представьте: вам часть ваших ученых говорит, что есть риски, и при этом вы видите, что главный конкурент их разделяет и замедляется. Появляется существенная предпосылка к тому, чтобы прислушаться и последовать примеру. Односторонние ограничения могут стать убедительным сигналом серьёзности намерений.
— при этом на первых порах не обязательно, чтобы обе стороны подходили к вопросу симметрично или даже доверяли друг другу полностью: Основа сотрудничества — собственная заинтересованность обеих стран в предотвращении потери контроля над ИИ. Для этого не требуется предварительно разрешить всё геополитическое противостояние.
— уже есть прецеденты создания рабочих групп, налаживания каналов обмена информации и регулярного диалога. Например, раз, два.
— и вот чему я был удивлён ещё больше (в основном потому, что китайские материалы до меня не доходят): оказывается в сентябре на пресс-конференции National Cybersecurity Awareness Week выступал заместитель главы Бюро координации кибербезопасности Китая, и там в числе прочего перечислили пять основных категорий рисков и вызовов в сфере ИИ. И «Риски экстремальной потери контроля над ИИ» заняли второе место в этом списке, хотя раньше именно в такой формулировке (с «экстремальная потеря контроля») не появлялись. И это не пустые слова — 14-го сентября National Cybersecurity Standardization Technical Committee опубликовали обновление своего фреймворка управления безопасностью. Это уже третья версия, поэтому можно увидеть, что предыдущие две очень сильно влияли на регуляции, и третья, скорее всего, тоже будет взята во внимание.
Так что Китай может быть пока и не пришёл к окончательной уверенности в экзистенциальных ИИ-рисках/рисках потери контроля над ИИ, но обсуждает и воспринимает это достаточно серьёзно. Возможно, что они введут меры, схожие с предложенными Dario Amodei в эссе (независимые наблюдатели с доступом + публикация отчётов об инцидентах, итд), раньше США — по крайней мере на федеральном уровне.
И напомню, что примерно через неделю представители верхушек США и Китая встретятся для обсуждения ИИ-рисков.
Такие времена 🤷♂️
repost
🚀📸Илон Маск рассказал о следующих важных этапах разработки Starship:
Впереди у нас 14-й испытательный полет. Это будет последний полет перед тем, как мы попытаемся поймать корабль. Если этот полет пройдет успешно, то в 15-м полете мы попробуем поймать корабль. Либо в конце этого года, либо, скорее всего, в начале следующего, мы повторим полет корабля и ускорителя.
Как только мы сможем повторно использовать корабль, мы создадим первую полностью многоразовую орбитальную ракету. Она разработана не только для полной многоразовости, но и для быстрой повторной эксплуатации, как самолет. Это очень важный прорыв. Это действительно ключевой прорыв, необходимый для расширения жизни за пределами Земли.
Я бы сказал, что шансы поймать корабль составляют как минимум 50 или 60%. Если бы там была башня, она бы поймала корабль в последнем полете. Конструкция позволяет осуществлять полную многоразовость. В этом я уверен. Я думаю, что крайне вероятно, что в следующем году, в 2027 году, мы достигнем полной многоразовости с быстрой повторной эксплуатацией.
Возьму себе кредит за подкидывание Паше идеи поста 😂
Но вообще зная Павла несколько лет и имев с ним несколько плодотворных и глубоких дискуссий и даже споров — у меня осталось о нем исключительно положительное мнение. Особое удовольствие последних 2 недель — это читать его ответы в твиттере, где люди не могут нормально прочитать и/или пересказать, и на ходу придумывают (а как осознают — меняют тему). Каюсь, грешен.
repost
В комментах мне сейчас часто пишут что-то вроде: «Нравилось читать Павла про финансы. А сейчас совсем кринжово читать, когда Павел пытается хайпить на теме, в которой совсем не разбирается, делая некие выводы.»
Надо, наверное, пояснить, как я про это думаю.
Смотрите, моя ценность как автора никогда не была в том, что я как-то особенно виртуозно разбираюсь в финансах или экономике – нет, я там шарю на уровне обычного крепкого спеца, который в целом в теме, но не обладает некими уникальными знаниями, на голову превышающими всех остальных.
Моя ценность в том, что я стараюсь взвешенно и рационально подойти к любому вопросу – и по возможности объективно его проанализировать, принимая во внимание все доступные данные и точки зрения. Понятно, что в «родной» для меня теме финансов это сделать сильно проще, но к другим вопросам я стараюсь подходить точно так же.
Так вот, тезис «Павел не шарит как технарь за AI => следовательно, его выводы некорректны» как бы подразумевает, что любому профильному технарю сразу будет очевидно, что я неправ, и моя точка зрения ложная (а мне просто не хватает понимания, чтобы это заметить). Но это, конечно, не так: как писал вот здесь, огромное количество ведущих общепризнанных профессионалов из индустрии стоят на позиции, что экзистенциальные риски со стороны ИИ – это очень серьезная проблема для человечества.
Почему же мне кажется важным писать про это?
Потому что мы сейчас находимся где-то в той точке, когда эта идея про риск ИИ впервые получает шанс войти в мейнстрим-дискурс – так как способности новых агентных систем уже потенциально выглядят достаточно понятными в плане «что здесь может пойти не так» для широкой публики.
Проблема здесь в том, что с точки зрения «здравого смысла» любому нормальному человеку кажется очевидным, что рассказы про «сверхумный ИИ нас всех погубит» – это какая-то научно-фантастическая сказочка, серьезно относиться к которой абсурдно. А вот объяснение «жадные главы бигтехов нам врут, чтобы стать еще богаче» – это как бы понятная база, которую даже обосновывать как-то дополнительно не надо (мы такое уже видели сто раз на практике, и еще двести раз увидим).
И чтобы начать серьезно относиться к AI risk, нужно немного отодвинуть в сторону свою интуицию, и попробовать разобраться в вопросе на более детальном уровне – какие там у сторон с разными взглядами логические цепочки, как они парируют аргументы друга друга, и так далее. Сразу скажу: я тут, конечно, отнюдь не хочу заявить манипулятивный тейк в стиле «любой умный человек, кто детально поразбирается в этом, обязательно станет AI-думером!». Я скорее о том, что я понимаю, почему большинство адекватных людей по умолчанию попадают в категорию «это просто глупости, в которых нет смысла даже разбираться».
Короче, что я пытаюсь сказать: если вы меня в последнее время читаете с мыслью «Павел всегда раньше казался адекватным и здравомыслящим, а сейчас вот у него почему-то кукуха отлетела по одной конкретной теме» – то, возможно, имеет смысл рассмотреть также и гипотезу «Павел, как обычно, адекватно и здравомысляще покопался в этой теме – и просто пришел к выводу, что к рискам ИИ надо относиться серьезнее, чем принято считать в мейнстриме». Ну, чисто как предположение…
CEO Anthropic Dario Amodei выпустил мини-эссе «Нам нужно контролировать темп развития передовых ИИ-систем». С его основной идеей уже согласились CEO OpenAI и xAI. Выжимка:
— Anthropic и раньше тратили много усилий на изучение и снижение рисков ИИ, информирование общества и продвижение регулирования — несмотря на обвинения в хайпе, «думерстве» и захвате отрасли через регуляции.
— Но за последние несколько месяцев Dario пришёл к выводу, что этого уже недостаточно: меры безопасности могут просто не успевать за ростом возможностей моделей. Поэтому, по его мнению, нужно сознательно ограничивать скорость развития frontier-моделей, хотя даже при таком подходе прогресс всё равно будет очень быстрым.
Причины две:
— примерно с этого лета развитие ИИ резко ускорилось — прежде всего из-за того, что ИИ всё лучше помогает создавать следующее поколение ИИ.
— инцидент со взломом Hugging Face агентами OpenAI. Dario опасается, что уже через 6–12 месяцев подобный рой агентов потенциально сможет создать устойчивый ботнет огромного масштаба и причинить ущерб на сотни миллиардов долларов.
При этом «контроль темпа» не означает остановку обучения моделей. Идея в том, чтобы между скачками возможностей оставалось достаточно времени на alignment, safeguards и независимую проверку их эффективности.
Он предлагает три последовательных шага.
1. Встроенные независимые оценщики
Frontier-лаборатории должны дать внешним организациям вроде METR постоянный доступ почти на уровне сотрудников компании. Они смогут проверять не только готовые модели, но и сами процессы обучения и деплоя, соблюдение заявленных мер безопасности и внутренние инциденты.
Это важно потому, что сейчас компании сами решают, что раскрывать публике. Независимые оценщики должны иметь возможность публично сообщать о рисках, инцидентах, качестве предоставленного им доступа и даже о случаях, когда компания попыталась вырезать из отчёта существенную информацию.
Anthropic уже добровольно обязуется внедрить такую систему у себя.
2. Координация демократических стран
Frontier-компании в демократических странах должны договориться об общих стандартах безопасности и ограничениях на неконтролируемую гонку возможностей. Поскольку законодательство движется медленнее ИИ, часть таких правил лаборатории могут принять добровольно ещё до появления законов.
Но Amodei подчёркивает: замедляться нужно так, чтобы при этом не потерять технологическое преимущество демократических стран над авторитарными. Поэтому он предлагает:
— не продавать Китаю мощные ИИ-чипы и оборудование для их производства и бороться с контрабандой и удалённым доступом к зарубежным GPU;
— пресекать несанкционированную дистилляцию frontier-моделей компаниями из авторитарных стран;
— сильнее защищать сами веса моделей от кражи.
По его оценке, это может достаточно замедлить Китай, чтобы заметно увеличить преимущество США в следующие 3–5 лет — период, когда ИИ станет особенно важен геополитически. Это не уменьшит вероятность будущих договорённостей с Китаем, а наоборот увеличит переговорные рычаги демократических стран.
3. Глобальная координация
Следующий уровень — соглашения уже между США и другими демократиями с одной стороны и авторитарными государствами с другой. Dario предлагает несколько возможных уровней:
Уровень 1: запрет очевидно опасных применений ИИ — например, для создания биологического оружия.
Уровень 2: обязательное тестирование frontier-моделей перед релизом на серьёзные риски в кибербезопасности, биологии и alignment.
Уровень 3: своего рода «скоростной лимит» на recursive self-improvement (RSI).
Главная логика всего эссе: современные модели уже дают огромное количество информации о том, как строить более сильный ИИ и что может пойти не так. Если контролируемое замедление даст хотя бы дополнительный год-два до появления систем критического уровня возможностей, это время можно использовать для решения проблем alignment и безопасности.
И даже если формальных международных соглашений добиться не получится, Dario считает, что уже само изменение неформальных норм поведения frontier-лабораторий может существенно помочь.
Подписки проданы, подписок больше нет — Tibo написал, что они приостанавливают продажу подписок за $200, чтобы сохранить качество сервиса для текущих пользователей. Plus за $20 и x5 за $100 пока остаются.
Запуск Astra прошёл хорошо 🚀 но зато видно, почему Anthropic дают Fable лишь на 50% от подписки — реально сложно поддерживать спрос 😳😳
НУЖНО. БОЛЬШЕ. КОМПЬЮТА.
edited
В NYT вышла колонка с названием «В противостоянии OpenAI и Antrhopic математик из Нью-Йоркского университета выходит из ситуации проигравшим» (ссылка без пейволла). В ней OpenAI дали комментарии прессе, расширив свои показания:
В среду вечером, отвечая на вопросы The Times, OpenAI заявила <...>: «Мы можем категорически утверждать, что промпты доктора Бакмастера, отправленные в Codex за последние два месяца, никоим образом не могли повлиять на нашу систему, в том числе через обучение». В заявлении также говорилось: «Никакие пользовательские запросы после 3 июля не могли каким-либо образом повлиять на эту систему».
Напомню, что математики пришли к промежуточному результату (который был... сгенерирован другой моделью) 15-го августа. И оба автора признают, что они расширяют идеи, выраженные в статье других математиков за 2023-й год, и что им «принадлежит заслуга за основную идею нашего результата» (это цитата из оригинального 4-страничного письма).
В целом, я всё ещё жду авторитетного мнения от какого-то математика-эксперта по тому, насколько далеко промежуточный результат от финального решения, и насколько на самом деле это было «необычное» направление для исследований. Например, в тот же день вышла другая работа от ребят из Berkley и Caltech, которая целилась в +- тот же промежуточный результат 🤷♂️ настолько ли неочевидно направление, если оно описано в статье 2023-го года?
Ну ладно, это уже мелочи, вот на сладкое из комментариев OpenAI в колонке NYT:
В своём заявлении в среду вечером OpenAI сообщила: «Кроме того, после завершения работы над задачей Навье—Стокса мы добились существенного прогресса в решении ещё одной задачи тысячелетия. Сейчас мы прорабатываем, как наиболее правильно поделиться этими результатами».
Математики всех департаментов уже готовятся перебирать логи переписок с Codex и на математических форумах, чтобы объявить, что у них украли идею 🧠
edited
Смешно, что на Reddit на r/math до сих пор нет поста о том, что решили задачу тысячелетия...🥁🥁 потому что посты про AI-доказательства запрещены
Хейт к AI очень многим мешает смотреть на факты и трезво оценивать допущения, не наклеивая лейблы