
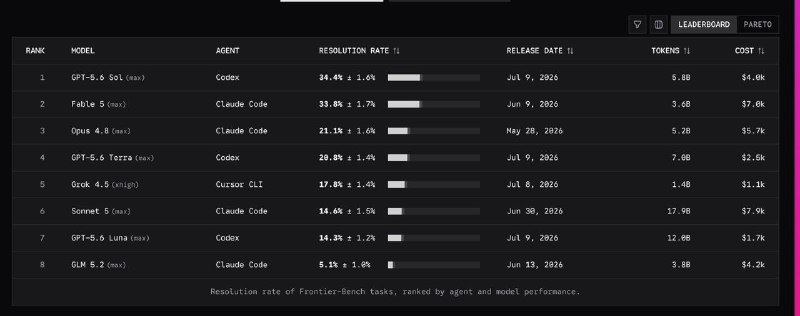
Популярный бенчмарк TerminalBench хотел обновиться до третьей версии, задачи для которой собирали с начала весны, но вместо этого превратился во FrontierBench. Первая версия включает в себя 74 уникальные и созданные вручную задачи в разных доменах (не только программирование). Примеры задач: — есть сервер, на котором развёрнут медленный KV-cache (это как справочник «имя ➡️ телефон», куда можно добавлять и откуда можно читать строчки). Нужно его переписать и ускорить в 5 раз, при этом не отключая от работы, то есть к нему постоянно идут запросы, и их нельзя пропускать. Ну и само переключение тоже надо сделать на лету. При этом исходник кода агенту не даётся, поэтому поведение и функционал нужно изучить самостоятельно — посчитать, сколько резервного капитала банк обязан держать под риск сделок с контрагентами, учитывая залоги, валюты и регуляторные правила. Результат CSV с числами и Excel с работающими формулами, как для внутреннего аудита. — работать диспетчером доставки стройматериалов. В течение дня появляются новые заказы, отмены и изменения цен на топливо; нужно учитывать доступность машин и водителей, обязательный отдых, допуски к опасным грузам, окна доставки и прибыль. План нельзя пересчитать «задним числом»: часть решений уже зафиксирована. В общем, большой упор делался на реалистичность и экономическую ценность. Распределение по категориям вы можете увидеть на второй картинке в посте. На первой — качество текущих моделей, где на фронтире GPT-5.6 Sol и Fable с результатом в примерно треть задач. К сожалению, Kimi K3 пока не померили, очень жду результата — как думаете, где будет? На уровне Terra и Opus 4.8 или выше? Или около Grok 4.5? По результатам: Во-первых, я удивлён, что GPT-5.6 Sol не отстаёт от Fable. Если бы мне описали задачи бенчмарка, то я был бы уверен, что модель Anthropic хоть и сильно дороже, но заметно лучше. Во-вторых, я удивлён тому, что Terra на уровне Opus 4.8, да и по многим бенчмаркам она не отстаёт от 5.5. OpenAI обещали это на релизе, говорили, что она «сопоставима с GPT-5.5», но казалось что это слишком хорошо, чтобы быть правдой. В-третьих, Sonnet 5 снова выглядит как бесполезная модель — она и дороже Fable (!), и хуже, и токенов больше всех (18 миллиардов на весь бенчмарк; Fable 5 нужно 3.6 миллиарда). Что-то Anthropic напортачили. В-четвертых, Grok-4.5 очень немногословен и за счёт этого дёшев — немного выгоднее Luna и сильно выгоднее (в 4 раза!), чем GLM-5.2. Авторы отмечают, что агенты по-разному подходят к решению задач, даже при схожих показателях качества. В Fable 5 (33,8%) и Opus 4.8 (21,1%) используется больше токенов и выполняется меньше действий. В GPT-5.6 Sol (34,4%) и Terra (20,8%) используется меньше токенов и выполняется больше действий. Итого GPT-5.6 Sol примерно на 40% дешевле и использует примерно на 50% меньше токенов, чем Fable 5. А вот GPT-6 выйдет так вообще... 😇