Fable 5 оставили в Claude Code до 12го июля Это я что, зря всю ночь его гонял тратя лимиты вместо сна 👤 Видимо релиз 5.6 Sol совсем скоро

Сиолошная
Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса. Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
Subscribers
80.7K
tracking since 23 Oct
Reach per post (ERR)
39.0%31.5K avg views
Posting
1.3/day
last 1 day ago
Reactions per 1K views
9.8
👍 🔥 🤡
-
repost -
edited Живём Если б знал - брал подписку за $200...
-
edited Reuters: Пекин рассматривает возможность ограничения доступа зарубежных стран к лучшим китайским ИИ-моделям. По словам трех источников, знакомых с ходом обсуждений, китайские власти в течение последнего месяца проводили встречи с ведущими технологическими компаниями по вопросу возможного ограничения доступа из-за рубежа к передовым китайским моделям, включая те, которые еще не выпущены. Встречи проводились министерством коммерции Китая, в разговорах участвовали как минимум Alibaba, Bytedanc и авторы GLM-5.2 Z.ai. Масштабы потенциальных ограничений все еще обсуждаются, и они могут применяться только к будущим моделям. Пока неясно, когда и вступят ли они в силу вообще. Также, согласно двум источникам, китайские власти крайне обеспокоены потенциальной возможностью использования обнаруженных моделью Claude Mythos уязвимостей программного обеспечения и тем, что Вашингтон может использовать эту модель против китайских интересов. Угроза воспринимается как реальная. === Я много раз тут и в других каналах выражал точку зрения, что считаю глупым топить за китайский опенсорс, и что не вижу большого будущего у открытых моделей. Почти все модели с большим экономическим потенциалом будут проприетарными, и никто не будет выкладывать модель, которая может принести, условно, 10-30 миллиардов долларов за счёт автоматизации экономически ценных задач. Даже если вдруг окажется что компании сами хотят их выпускать — им почти наверняка не дадут. Может быть это не произойдет в 2026. Может даже не в 2027, но чем дальше в гонке — тем больше ограничений. Выбор, по-сути, будет из двух: проприетарные модели США или проприетарные китайские модели — и это если выбор будет вообще, а то может быть не-гражданам или не членам коалиции и такого не дадут, что в целом вполне вероятно. Ещё останутся «слабые» локальные модели, но не факт, что они смогут шагнуть сильно дальше, чем те, что публично доступны на данный момент (условно Mythos-class).
-
Краткая сводка новостей: — GPT-5.6 ожидается на этой неделе. Многие считают, что релиз будет 7-8 числа, когда Anthropic перестанут раздавать Fable в подписках, и OpenAI сможет переманить пользователей к себе свежим релизом. Но традиционно компания запускает модели по четвергам, исключения редки. Tibo, руководитель Codex & ChatGPT, затвитил жабу, а это, как известно, намёк на среду. В общем, ждем, готовьтесь к сбросу лимитов. — Anthropic начали обсуждать разработку собственных чипов с Samsung. Разговоры пока на начальной стадии — тут они сильно отстают от OpenAI, которые уже показали прототип своих первых чипов и, насколько я понимаю, готовятся к производству и разворачиванию серверов уже в этом году. — Южная Корея недавно объявила о десятилетнем инвестиционном плане, возглавляемом Samsung и SK Group, в рамках которого обе компании инвестируют в общей сложности 518 миллиардов долларов в строительство четырех заводов по производству микросхем памяти в стране. Память — это узкое место для масштабирования производства GPU в будущем. В 2025-м году 69% всей супербыстрой памяти ушло Nvidia (и 90% — на AI чипы в целом), в то время как на них же пришлось порядка 9% чипов. То есть ужать производство, скажем, мобильных чипов и отдать мощности под Nvidia можно, а память банально неоткуда брать, и так почти всё производство расписано на годы вперёд. — Anthropic заявили, что в будущем будут разрабатывать лекарства с использованием собственных моделей. Глава подразделения биологических наук компании сказал, что компания сосредоточится на поиске методов лечения «забытых» болезней (без уточнения каких именно). Я думаю, что очень возможен такой сценарий: компания (да и OpenAI, и мб 1-2 других игрока) найдут несколько лекарств-кандидатов с большим потенциалом, вывалят их на испытания, а затем будут критиковать медленность программы сертификации FDA и просить её пересмотреть. В целом главы компаний уже давно озвучивают, что этим надо заняться, но как с Mythos пока молния не ударит — государство не почешется 👨🦳
-
«Любая достаточно развитая технология неотличима от магии»© Пользователь Твиттера поручил Claude Fable 5 превратить reMarkable в дневник Тома Риддла из «Гарри Поттера». То, что написано, стирается, а LLM пишет ответ. Представьте реакцию людей из поздних 1800-ых, которым бы это показали🤯 (код обещают выложить скоро)
-

-
edited 
Я писал про бенчмарк RLI — Remote Labor Index от Center for AI Safety (США). Это один из самых дорогих в создании бенчмарков, для которого выкупили приватные проекты сотен фрилансеров на онлайн-платформе UpWork. RLI — самое лучшее прокси для оценки качества агентов в автоматизации такой работы из всех, что у нас есть, но, как и любой бенчмарк, это прокси не идеально. Цитирую отсюда: Попросил GPT-5.2 Pro оценить, сколько потенциальной выручки может приносить каждый процент на этом бечмарке в среднем на основе рынка США. Вышло, что: — $13B (если брать только фрилансеров) — $30B (если просто брать зарплатный фонд удалёнщиков — $54B (если брать все задачи, которые могли бы делаться удалённо, но пока не делаются — тогда 100% это ~46% от всех зарплат в США) Когда бенчмарк вышел, то лучшие решения набирали 2.5% (все оценки делались вручную, результаты агента сравнивались с работой живых людей). CAIS наконец-то обновили результаты, добавив самые свежие модели. GPT-5.5 и Opus 4.8 уже подскочили до 6.3% / 8.3%, но Fable 5... взял 16%. Какие конкретно задачи научилась решать модель и что выдаёт можно глянуть в блоге CAIS, но TLDR: прокачали 3d & Cad, визуализации, редактирование видео. 16% и скачок с Fable — это потенциальная возможность сильно влиять на сектор удалённой работы с суммарными зарплатами в 100-800 миллиардов долларов в год с одних только США. Это не означает, что выручка Anthropic дотянется до такой суммы, но думаю, что эффект на экономику и работу будет заметен уже в следующем году. Плюс CAIS сказали, что попробуют улучшить оценки добавлением критика, который перед отправкой результата будет рассматривать, что сделала модель, давать обратную связь. В будущих исследованиях планируют более тщательно изучить влияние масштабирования количества вычислений и $ на выполнение задач. А пока что остановились на планке $50 на задачу для всех моделей и $150 на Fable. Это сколько часов работы фрилансера в США, 2? 3? 😇
-
repost 
Artificial Analysis померили стоимость Sonnet 5 на задачу (per task), и у них получилось, что он дороже Opus 4.8 на 15% и что это вообще одна из самых дорогих моделей, уступая только Fable 5. https://x.com/artificialanlys/status/2072062592923930666?s=46
-
edited 🚨 ЗАВТРА FABLE 5 ВЕРНУТ В ОБЩИЙ ДОСТУП — экспортные ограничения сняты. Пока не ясно, восстановят ли неделю доступа по подписке, или сразу же начнут брать оплату по API-ценам. Когда Fable 5 становится доступным для выбора в окне чата:
-


 +3
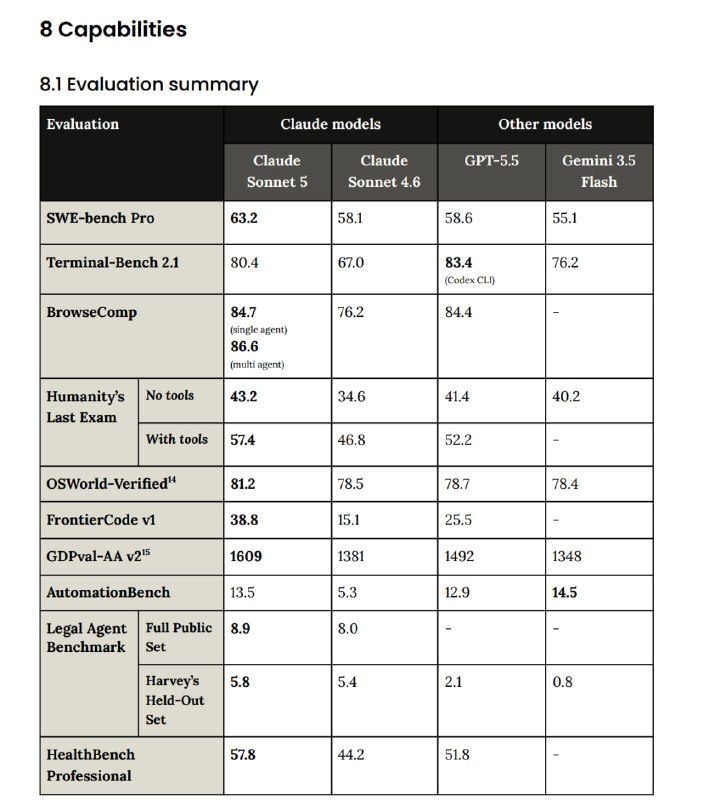
Вышел Sonnet 5 — новая модель по умолчанию для Free и Pro ($20), но доступна всем. По качеству близко к Opus 4.8, но сильно дешевле: до конца лета будет цена $2/$10, после чего поднимут до $3/$15. На некоторых бенчмарках, как видно по картинкам, модель и дороже Opus, и хуже 😭 Ну и... в честь релиза сбросили лимиты, так что бегите играться 🤗 UPD: лимиты не сбросили, я не то посмотрел 😳
-
repost 
За последние пять лет я разместил на Хабре более 300 статей, которые в совокупности получили свыше 7 млн прочтений и несколько десятков тысяч лайков. На мой взгляд, Хабр был лучшей UGC-площадкой в Рунете – поэтому основную версию всех своих материалов я размещал именно там, и ссылался со своего канала туда же. К сожалению, вчера администрация ресурса написала мне, что Хабр – это «только про айтишку и околоайти», а всякие темы про финансы и инвестиции там вообще ни к месту. И если я буду продолжать там писать про такое – то придется «расчехлять санкции» в мой адрес. Так что, уважаемые айтишники, я вынужден избавить вас от своего присутствия на Хабре. Надеюсь, вы наконец обретете счастье в этом прекрасном мире, где никто не говорит про процентные ставки, а бородатые программисты при словах «среднегодовая доходность» краснеют и в ужасе зажимают руками уши. Press F!
-
🤯
-
edited Я забыл добавить в пост, поэтому напишу отдельно 😳 что компания-разработчик Valve очень внимательно и основательно подходит к разработке, даже проработке деталей. Почти про каждую их игру можно найти сотни видео-эссе, в которых разобрано, какие именно инновации они смогли привнести в индустрию (помимо шапок 😨). Про музыку, визуальный стиль, архетипы героев, их интеракции голосом друг с другом (кто кому враг, кто друг, кто в одной школе учился пятьсот лет назад), монетизацию, да хоть что. Но отдельно хотел поделиться видео про озвучку и голоса героев: https://www.youtube.com/watch?v=PLiUty8q1rY (чтобы оценить видео нужно знать английский, а вот играть в игры или в эту конкретную игру — нет) Например, в большинстве игр персонажи из неанглоговорящих стран говорят с акцентом, но всё ещё на английском (или другом языке озвучки). Это выглядит странно — ну не будет француз при промахе говорить Crap! по-английски. В Deadlock есть японка Yamato, почти все фразы которой 🥁🥁🥁 на японском. И это вызывает конфузию у большинства героев, ведь они её не понимают. Иногда — иногда — она обращается к команде на ломаном английском, коверкая имена, чтобы сообщить что-либо. Ну так никто не делает!
-
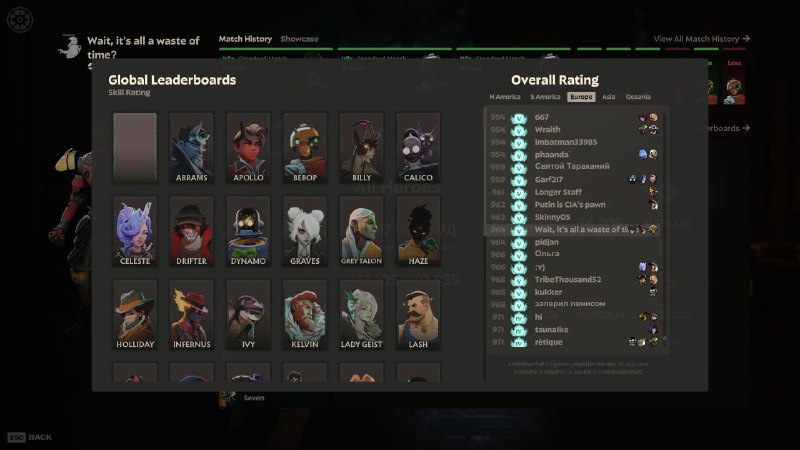
В канале я уже трижды писал про Deadlock (1, 2, 3) — новую игру Valve, по сути это Dota 3 (те же разработчики, те же механики, тот же главный дизайнер, но новый взгляд в 3D). Сегодня, после чуть менее чем 2 лет игры, я наконец-то попал в топ-1000 самого соревновательного региона, и теперь моё имя есть в официальном списке лидеров. Несмотря на то, что в Dota 2 я начал играть больше 10 лет назад и провёл в ней больше 6000 часов (а с просмотром стримов наверное и больше 8к), я никогда всерьёз не играл для поднятия рейтинга. Когда ещё давно я думал над этим, то было уже поздно, слишком большой отрыв от топов, слишком много игр нужно сыграть (= потратить время). В Deadlock я начал играть относительно рано, хоть к ранним тестировщикам меня и нельзя отнести. Я чувствовал себя активной частью раннего сообщества, когда игра сырая, патчи выходят часто, разработчики экспериментируют. И так как мне эта игра понравилась настолько, что я полностью ушёл из Dota 2, сыграв 3 игры за 2 года, и так как были ресурсы, то мне хотелось играть интересные игры с хорошими игроками и закрыть какой-то внутренний гештальт, чтобы в будущем рассказывать детям, вот, мол, стоял на заре легендарной — а я не сомневаюсь что Deadlock ей станет — игры. Несмотря на то, что всё ещё идёт «закрытый» тест по приглашениям (которые легко получить вот здесь), база игроков всё равно большая, после крупных обновлений игра входит в топ-10 стима. Есть «профессиональные» киберспортсмены, против которых иногда попадаюсь. У Валеры видел пост «95-й перцентиль это не так уж и хорошо», в котором автор, инженер из Twitter, рассказывал, достигнуть верхнего перцентиля в 95% это недостаточно хорошо, причем не просто быть 95% и выше в определенной деятельности среди всех людей в мире, а именно среди тех кто этим занимается. В нём автор, внезапно, тоже проводил аналогии с играми (Overwatch) и том, как можно улучшать свой скилл и обгонять популяцию. Мой ранг это примерно top ~1% сейчас, но с крупным обновлением и приходом/возвращением игроков будет скорее всего top-0.3-0.5%, что звучит круто и вроде как достижение. Существенной частью этого «успеха» является коммуникация: очень часто игроков в команде приходится успокаивать, просить сделать что-то для победы, подсказывать неочевидные вещи. Плюс очень малая доля игроков готова брать на себя ответственность и определять стратегию/говорить что делать, куда и когда идти всей команде. Прям как на вторую работу хожу 😀 поруководить кучкой разлаженных людей. 😂 меня даже несколько раз спрашивали, так же много ли я руковожу в жизни 🤣 Ну и напоследок к посту свежее видео из игры как реклама для тех, кто ещё не получил приглашение и не попробовал.
-
edited 
DeepSeek разослали письма о том, что в середине июля выпустят обновление DeepSeek v4 (та модель, что есть сейчас — это preview). Вместе с этим поднимут цены в пиковые часы в два раза, а вне двух окон (по 3 и 4 часа) она останется прежней. Надеюсь, что с обновлением наконец-то добавят полноценную мультимодальность.
-
edited 
Прошло 3 недели и никто не написал про Apple и WWDC, а мне было лень, но что поделать, надо браться. В начале июня компания проводила ежегодную конференцию для разработчиков и вместе с этим рассказала про обновления в AI. Очень сильно прокачали Siri, теперь она работает на относительно большой (по мобильным меркам) LLM, умеет вызывать инструменты и тесно связана с приложениями и экосистемой. Я видел пару демонстраций в твиттере, где запросы и сценарии показались мне не предусмотренными разработчиками (то есть модель на них не тренировали), и тем не менее Siri справилась отлично. Для тех, кто пользовался LLM, такая генерализация не является чем-то выдающимся, но для обычных пользователей может вызвать ВАУ-эффект. Ого, оно что И ТАК умеет??? Не только по пяти заложенным 15 лет назад сценариям работать? На девайсах может быть одна из двух моделей — AFM 3 Core (3 миллиарда параметров) и AFM 3 Core Advanced для девайсов помощнее, Phone 17 Pro и выше, iPad с чипом M4 и выше, MacBook с чипами M3 и выше. Такое ограничение потому, что модель действительно «Large» — 20 миллиардов параметров с микстурой экспертов (MoE). Но работает очень хитро — классический MoE работал бы плохо, так как у девайса ограничена пропускная способность между NAND (флеш-память для хранения ваших файлов и весов модели) и DRAM (где хранятся активные параметры для работы). В обычном MoE вы не знаете наперёд, какие именно эксперты вам нужны, поэтому загружаете всю модель, что а) долго б) занимает много памяти, а потом уже экономите на вычислениях, так как работает часть экспертов. Apple применили трюк, который я вижу впервые: для вашего промпта модель предварительно выбирает набор экспертов на всю модель, а затем загружает только их, и получается от 1 до 4 миллиарда активных параметров. Подход называется Instruction-Following Pruning for Large Language Models и описан в этой статье из начала 2025-го года. Также эта модель работает и для распознавания вашего голоса (поэтому и оно улучшилось), и для генерации нового голоса Siri (...тоже улучшилось). Вот тут внизу есть пара семплов было/стало, честно говоря старое мне нравится больше 🤷♂️ И вторая часть анонса — это удвоение ставки на Private Cloud Compute (PCC), который анонсировали два года назад. Идея в том, что для более сложных запросов, для которых локальной модели (особенно на смартфоне) не хватает, можно отправить промпт и контекст (например, файлы) на зашифрованный сервер, внутрь которого ни у кого нет доступа. Несмотря на то что система имеет открытый код и анализировалась лучшими специалистами по кибербезопасности, надеюсь, что Mythos тоже натравили 😀 Так вот, в PCC тоже обновилась модель, AFM 3 Cloud. Она запущена на серверах Apple и крутится на собственных чипах M-серии. И есть ещё AFM 3 Cloud Pro, которая ещё больше, ещё умнее, развернута на серверах Google на Nvidia GPU. Мне кажется это очень крутой паттерн, с которым мы будем жить: на смартфонах и умных девайсах в ближайшее время не будет настолько мощных чипов, как в серверных стойках, но хочется, чтобы умные модели были доступны. Все эти модели созданы компанией Apple, это НЕ модели Gemini. Говорят, что Apple усовершенствовала некоторые из этих моделей, дистиллируя Gemini, но все они являются совершенно новыми моделями, в которых используются собственные знания и технологии Apple. Самое крутое — и на смартфонах, и на макбуках у вас как у разработчика есть доступ к этим LLM. То есть вы можете написать приложение, не обучать свою модель (только сделать промпт) и вызывать её. Это бесплатно для локальной модели, а для облачных бесплатно (!) до какого-то порога, дальше придется платить. Вот тут и тут можно посмотреть на скорость генерации на разных девайсах — получается даже быстрее, чем я бы ожидал!
-
edited 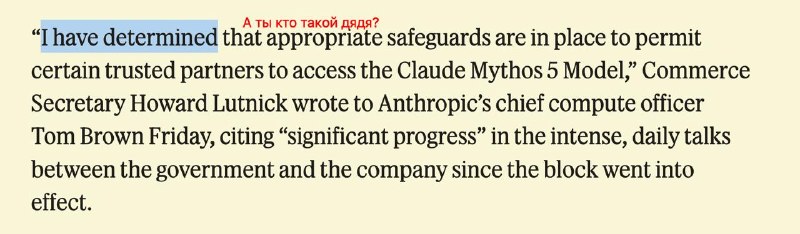
В пятницу правительство США сняло блокировку c Claude Mythos 5, разрешив предоставить ее более чем 100 американским учреждениям, включая крупные компании и правительственные агентства — Semafor Решение, изложенное в письме, направленном в компанию Anthropic в пятницу днем, представляет собой серьезную деэскалацию в конфронтации между администрацией Трампа и компанией Anthropic. В письме ничего не говорится о Fable 5. Источники, близкие к переговорам, заявили, что стороны также движутся в направлении выпуска Fable, хотя сроки этого пока неясны. В соответствии с новым соглашением, «лицензия больше не потребуется для экспорта, реэкспорта или передачи внутри страны модели Claude Mythos 5 организациям, указанным в Приложении А к настоящему письму, и их иностранным сотрудникам, а также иностранным сотрудникам компании Anthropic». Так что Andrej Karpathy снова может расчехлять авторисерч на Mythos.
-
edited Stripe, Anthropic и OpenAI запускают некоммерческую инициативу по борьбе с респираторными инфекциями Сто лет назад инфекции, передающиеся через воду, наносили ущерб, сопоставимый с тем, который сегодня вызывают респираторные вирусы, такие как простуда и грипп: они были эндемичными, периодически вызывали эпидемии и повсеместно воспринимались как неизбежная часть человеческой жизни. Но человечество централизованно смогло их побороть. Проблема заключается в том, что обычная простуда вызывается более чем 200 различными вирусами, и побороть все и сразу — задача не самая простая. Основатели Stripe собрали симпозиум с 40 исследователями почти год назад и предметно обсуждали технологическую возможность создания решения. В целом есть умеренный оптимизм, что всё получится. Ни одна технология в отдельности не способна обеспечить снижение уровня заражения всеми патогенами в масштабах популяции. Даже если бы существовала прививка или таблетка, обеспечивающая более 90% защиты от более чем 90% респираторных вирусов, при охвате населения на уровне около 60% (реалистичный предел, основанный на текущей статистике вакцинации) этого все равно было бы недостаточно для создания популяционного иммунитета, необходимого для радикального снижения устойчивой передачи инфекции. Поэтому новое НКО будет работать по двум направлениям: лекарства (вакцины/спреи/...) и технологии очистки воздуха, которые снижают концентрацию инфекций более чем на 75% и имеют перспективу экономичного внедрения (с большим охватом) в закрытых помещениях с высоким риском передачи инфекций. Про лекарства — одна из идей заключается в создании улавливающих вирусы белков: люди могли бы брызгать в нос в виде спрея, чтобы перехватывать вирусы до того, как они приведут к заражению. Но другие форматы тоже возможны. Про очистку воздуха — за последнее десятилетие накопилось всё больше данных о безопасности и эффективности антимикробных ламп. Фильтрация воздуха работает, но требует дополнительных испытаний и масштабирования для использования в местах с высоким риском распространения инфекций. Антимикробные парЫ до сих пор применялись в основном в чрезвычайных ситуациях, и необходимы дополнительные исследования, чтобы понять, можно ли эффективно использовать их на постоянной основе. Горизонт работы НКО — 4-7 лет до доведения технологий до последних этапов медицинского тестирования, после чего, если заработает, подтянется коммерческий сектор для масштабирования производства.
-


 +6
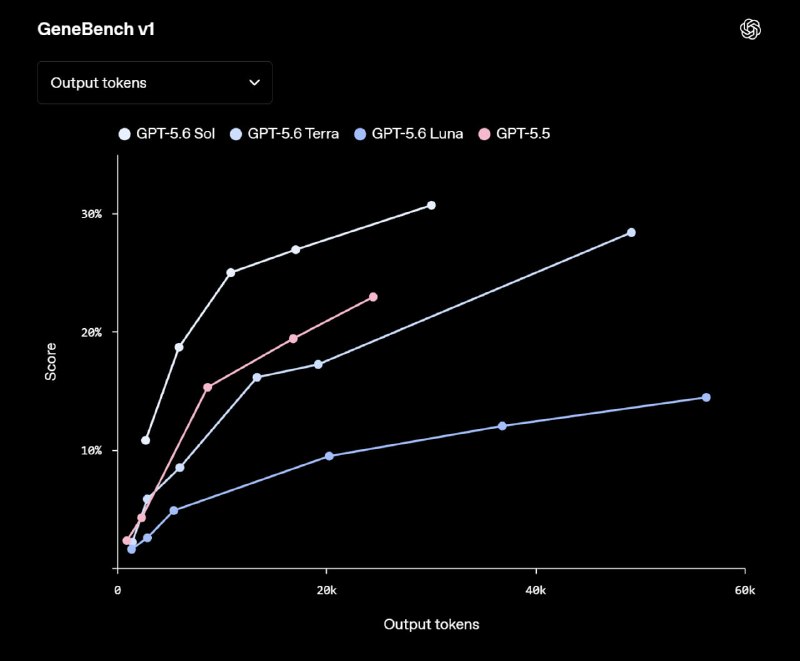
TLDR новости с анонсом GPT-5.6: — как понятно по картинке, будет 3 модели. Средняя, Terra, плюс-минус на уровне GPT-5.5, но стоит в 2 раза меньше. — OpenAI подтвердили то, о чем писали в новостях: по просьбе Администрации модель запускают постепенно, начиная с выбранных партнёров, чтобы те могли потестировать + применить модель для исправления критических уязвимостей. «Мы считаем, что подобный процесс доступа к информации со стороны правительства не должен стать долгосрочным стандартом». — у самой большой модели Sol появится новый самый длинный режим рассуждений max (+15), а также режим работы ultra, выходящий за рамки возможностей одного агента, так как позволяет использовать субагентов для сложных задач. Интересно, заменит ли это GPT Pro, и если нет, то как они будут сочетаться. — «GPT-5.6 Sol лучше помогает людям находить и устранять уязвимости, чем проводить атаки. По мере развития этих возможностей наш приоритет — обеспечить их доступность и пользу для специалистов по защите, которые смогут использовать эти инструменты для поиска слабых мест и разработки патчей» — много пишут про работу над обеспечением безопасности и несколькими слоями фильтров, чтобы противодействовать недоброжелателям. — GPT‑5.6 поднимает цену на создание кэша ваших промптов и ответов: теперь за них придётся платить на 25% больше (как у Anthropic), а чтение всё ещё со скидкой 90%. — и самое главное 😎: GPT-5.6 Sol будет доступна на чипах Cerebras с целевой скоростью генерации... 750 токенов в секунду 🤯 вот это жоска. Но сначала доступ будет только у ограниченного круга клиентов, а затем, с добавлением мощностей, станет доступно всем. Картинки бенчмаков прилагаю, но там ничего интересного — в кибербез задачах на уровне раннего Mythos и похуже финальной версии. Интересны мб последнеи 3-4 скриншота из системной карточки — можно посмотреть на то, как выглядит новый режим ultra и сколько $ он будет стоить 🌚 В новости ничего не сказали про то, новый это претрейн или нет. Аккуратно можно предположить, что нет (плюс цены те же, но это не гарантия) — и если это так, то эффективность неплохо так выросла. Главное чтобы не было как с 4o, где теперь этот претрейн будут доить полтора года 😳 и улучшать всеми способами. НАМ. НУЖНА. БОЛЬШАЯ. МОДЕЛЬ.
-
https://openai.com/index/previewing-gpt-5-6-sol 👀
- Older posts


