Игрокам на бирже посвящается. Кажется, за последнее время (да и за долгую историю) уже много раз бывало, что простые бейзлайны бьют всю эту сложную монстрологию. Towards Financial World Modeling Humzah Merchant, Alec Guthrie, Simon Mahns, Randall Balestriero, Bradford Levy Paper: https://arxiv.org/abs/2610.09048 Code: https://github.com/fin-ai-lab/tfwm Model: https://huggingface.co/fin-ai-lab Review: https://arxiviq.substack.com/p/towards-financial-world-modeling ЧТО сделали: Авторы представили открытый датасет Market-1T из почти триллиона секундных наблюдений по акциям за 2008–2025 годы. На нём протестировали 18 методов обучения энкодеров (с учителем, self-supervised и предобученные модели) в роли состояний для финансовых моделей мира. Каждое представление проверили на 32 исторических режимах рынка: оценивали прогноз на 15 минут вперёд и геометрию латентного пространства. ЧТО получили: Точность прогнозов и структура латентного пространства почти не коррелируют между энкодерами (корреляция Спирмена ρ = −0.19). На прогнозе 15-минутной доходности многоголовая модель с учителем набирает ранговый информационный коэффициент (IC) 0.0311 против 0.0170 у необученного случайного Vision Transformer (Random ViT) и 0.0196 у гребневой регрессии по последним 24 сырым входным токенам. Большинство self-supervised методов уступают обоим бейзлайнам (от 0.0095 у Time-Frequency Consistency, TF-C, до 0.0205 у TS2Vec), а при равных вычислениях маленькие энкодеры (5.4M ViT-Tiny) обыгрывают большие (86M ViT-Base). ПОЧЕМУ это важно: Оптимизация энкодера только под прогноз следующей доходности сжимает его эффективную размерность до 2.8–3.7 направлений и стирает структуру компаний, дней и межрыночных факторов, нужную для планирования сделок. Впрочем, авторы тестируют только статические замороженные энкодеры, а не полноценные модели мира с действиями, и используют разную агрегацию токенов при обучении и линейном пробинге. Разбираться с фундаментальными моделями для рынка здесь: https://t.me/gonzo_ML_podcasts/4838

gonzo-обзоры ML статей
Авторы: Гриша Сапунов, ранее руководитель разработки Яндекс-Новостей, ныне CTO Intento. Области интересов: AI/ML/DL, биоинформатика. Лёша Тихонов, ранее аналитик в Яндексе, автор Автопоэта, Нейронной Обороны... Области интересов: discrete domain, NLP, RL.
-
-
(poll without text)
-
(poll without text)
-
(poll without text)
-
(poll without text)
-
Про новый формат обзоров vs. старый по опросу вроде понятно, но если вы ещё не выразили своё мнение, скажите, пожалуйста. Ещё пачка вопросов про новый формат 👇
-

-
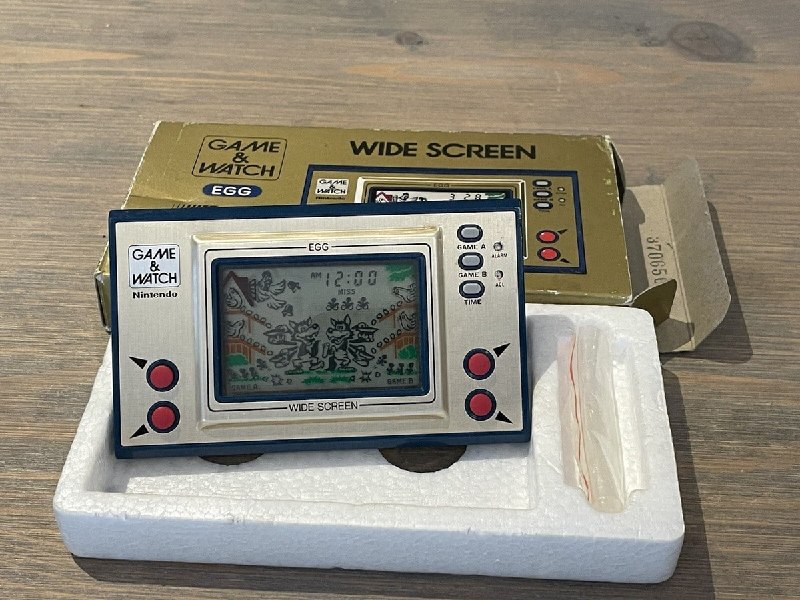
А ещё извините, совсем в другую тему, но не могу не поделиться. Я почему-то узнал про это только сегодня. Старая добрая карманная электронная игра "Ну, погоди!" с ловлей яиц — практически полный клон карманной игры из серии Game & Watch от Nintendo. Источник: https://www.facebook.com/groups/1130497079252028/posts/1419032017065198 Другой более подробный источник: https://habr.com/ru/companies/ruvds/articles/710548/
-
edited Свежий emergency выпуск подкаста Лекса Фридмана про AI и математику. Как обычно 3+ часа :) Но пересказывать нет смысла — рассуждают о том, как изменяется математика из-за AI, о будущем математиков, про большие задачи — гипотезу Римана, Навье-Стокса, P vs. NP и прочее. Про дзета функцию и обработку сигналов, где сигналом является распределение простых чисел, я раньше как-то не думал. Интересно послушать, и там даже есть какой-то визуальный ряд, чтобы посмотреть. Вообще ситуация с математикой интересная, на неё стоит внимательно смотреть как на очень выразительный модельный кейс про изменение профессий. По моему ощущению, у математиков всё происходит острее чем у программистов, хотя у последних всё раньше началось, но вроде без экзистенциального кризиса. Есть, конечно, в SWE свои страхи про сокращения (свежак про Microsoft который предлагает четверти своих сотрудников добровольно покинуть компанию), но в целом кажется внешне всё спокойнее, да и адаптация активно идёт у всех. У нас у самих если ещё полгода назад довольно много людей писало код по старинке, то сейчас вручную код не пишет уже вообще никто. У математиков, тех что я наблюдал за последние полгода, включая очень high level, чаще встречаются панические настроения. Действительно интересно, как изменится область, и как изменится то, чем занимаются люди. Как изменится образовательная система. И как общество и индустрия в свою очередь на это отреагируют. https://www.youtube.com/watch?v=ZAzWPE9CItg
-
(poll without text)
-

-

-

-
edited Прикольная история. Во всех массовых реализациях софтмакса и кроссэнтропии есть баги, приводящие к проблемам округления. И вот после более чем десятка(ов) лет активного пользования всем этим, их наконец обнаружили. В очередной раз возникает вопрос, почему не раньше. A Fix for Softmax and Cross-Entropy Jonathan T. Barron, Dan Gnanapragasam, Michael Tschannen Paper: https://arxiv.org/abs/2610.31642 Review: https://arxiviq.substack.com/p/a-fix-for-softmax-and-cross-entropy Code: N/A (self-contained JAX snippets provided in paper) Model: N/A ЧТО сделали: Авторы переписали софтмакс, лог-софтмакс и кросс-энтропию (для жёстких и мягких меток) в логарифмическом пространстве. Это исправляет два бага округления в фреймворках глубокого обучения: Softmax Collapse (зануление градиента целевого логита при высокой уверенности модели) и Softmax Cancellation (ненулевой остаточный градиент в дистилляции, когда логиты студента уже совпали с логитами учителя). ЧТО получили: На модулярном сложении (a + b mod 31) в bf16, fp32 и fp64 Fixed Cross-Entropy даёт 98.9%–100.0% тестовой точности против 93.3%–100.0% у стандартной кросс-энтропии, 48.9%–97.9% у Zero-sum Projection (вычитание среднего из градиентов) и 95.6%–97.4% у StableMax (кусочно-рациональная замена софтмакса). В полиномиальном гроккинге без регуляризации (a^2 + b^2 mod 97) Fixed Cross-Entropy достигает 85% точности, тогда как стандартная кросс-энтропия падает с 61% до 23%. ПОЧЕМУ это важно: Drop-in replacement базовых функций лосса убирает скачки лосса («эффект рогатки», Slingshot) при гроккинге и дрейф весов при дистилляции в bf16 без перевода в fp64. Правда, все эксперименты проведены на небольших задачах модулярной арифметики, а проверенные здесь огромные отступы логитов и почти нулевые зазоры между студентом и учителем в масштабном обучении встречаются редко. Округлять с багами и без багов здесь: https://t.me/gonzo_ML_podcasts/4837
-

-

-
Фантастики вам на ночь. Agentic Economies for Autonomous Scientific Discovery Nenad Tomašev, Matija Franklin, Atoosa Kasirzadeh, Vivek Natarajan, Alan Karthikesalingam, Sebastien Krier, Simon Osindero Paper: https://arxiv.org/abs/2609.31562 Review: https://arxiviq.substack.com/p/agentic-economies-for-autonomous Code: N/A Model: N/A ЧТО сделали: Авторы представили Agentic Economies for Science — рыночную архитектуру для автономных научных систем (мультиагентных моделей, которые генерируют гипотезы и проводят эксперименты). Она координирует учёных, ИИ-агентов и роботизированные лаборатории: назначает цены за доступ к данным, позволяет торговать токенизированными исследовательскими заявками и верифицирует физические эксперименты через смарт-контракты. ЧТО получили: В этой концептуальной статье авторы указывают, что стоимость вычислительной генерации гипотез стремится к нулю, поэтому научный поиск ограничивается неэластичной проверкой в реальном мире. Например, по закону Ирума стоимость одобрения лекарства в FDA удваивается каждые 9 лет и уже достигла $2.6 млрд за молекулу. Чтобы отсеивать слабые идеи до лаборатории, фреймворк вводит 4-уровневый рынок данных и 4-этапный пайплайн обмена гипотезами (Hypothesis Exchange Pipeline), отделяющий генерацию идей от экспериментов в мокрой лаборатории. ПОЧЕМУ это важно: Работа переносит фокус в ИИ для науки с изолированного улучшения рассуждений на явный учёт стоимости, комбинаторные аукционы ресурсов и автоматическое эскроу для репликации результатов. При этом вся предложенная инфраструктура остаётся концептуальной и пока не имеет эмпирического прототипа. Фонтанировать идеями тут: https://t.me/gonzo_ML_podcasts/4836
-

-

-

- Older posts