

gonzo-обзоры ML статей
Авторы: Гриша Сапунов, ранее руководитель разработки Яндекс-Новостей, ныне CTO Intento. Области интересов: AI/ML/DL, биоинформатика. Лёша Тихонов, ранее аналитик в Яндексе, автор Автопоэта, Нейронной Обороны... Области интересов: discrete domain, NLP, RL.
Subscribers
24.7K
tracking since 12 Nov
Reach per post (ERR)
12.2%3K avg views
Posting
4.0/day
last 54 minutes ago
Reactions per 1K views
2.9
👍 ❤ 😁
-
-
-
-
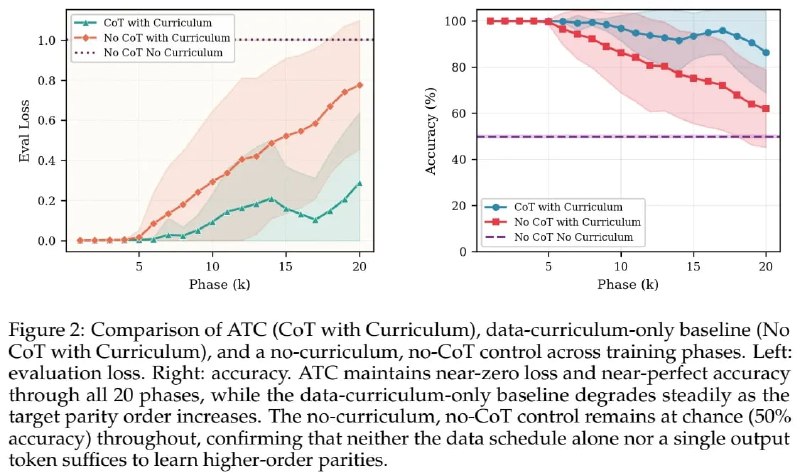
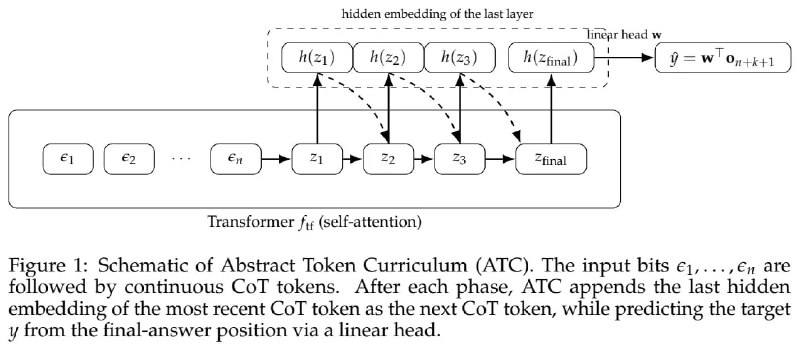
Как обучать латентный ризонинг без явной разметки шагов. Заодно решил проверить как работает ревью на Gemini 4 Hydrogen. Как вам? Learn Your Own Thoughts: Abstract Token Curriculum Khashayar Gatmiry, Avrajit Ghosh, Parsa Mirtaheri, Jason D. Lee, Nika Haghtalab, Emmanuel Abbe, Peter Bartlett Paper: https://arxiv.org/abs/2609.19717v2 Review: https://arxiviq.substack.com/p/learn-your-own-thoughts-abstract Code: N/A Model: N/A Главное: Подача подзадач с растущим бюджетом непрерывных токенов учит трансформеры последовательным скрытым состояниям без разметки мыслей, но переносит декомпозицию задачи в генератор данных. ЧТО сделали: Авторы предложили метод Abstract Token Curriculum (ATC), который обучает векторы рассуждений (скрытые эмбеддинги в конце контекста) с помощью поэтапного усложнения, отката по точности и дропаута кандидатов. ЧТО получили: ATC достигает 99.9% точности на задаче достижимости в дереве наравне с размеченным бейзлайном и медианных 98.7% точного совпадения на сложении против бейзлайна без усечения. В идеализированных условиях теория доказывает: один градиентный шаг по ключам концентрирует внимание на последней мысли для одного знака чётности. ПОЧЕМУ это важно: Если задачу можно алгоритмически разбить на этапы по сложности, разметка цепочек рассуждений не нужна. Однако эксперименты проводились на синтетике и малых трансформерах с нуля (до 15M параметров), а отсутствие части контрольных прогонов не исключает влияния подсказок-кандидатов в промпте. Латентные и не очень куррикулумы здесь: https://t.me/gonzo_ML_podcasts/4849
-
Я постил месяц назад кейноут DHH с открытия Rails World 2026, он был прекрасен. Но кроме него есть и двухмесячной давности разговор на канале Лекса Фридмана, традиционно долгий, аж целых пять часов! И я его наконец дослушал. Получилось только на 1.5x–1.75x: он говорит довольно быстро, ускорять сильнее не выходит (а некоторых удаётся слушать и на 2.5x-3x 😁) Это один из разговоров, которые нет смысла давать в виде саммари. Большие (а особенно теперь ещё и сгенерённые) статьи с архива есть смысл суммаризировать, некоторые длинные посты тоже, а вот разговоры с некоторыми людьми содержат очень много сигнала в отдельных деталях, и их лучше слушать целиком, обращая внимание на эти детали -- ну собственно как дистилляция на полном распределении логитов (soft targets), а не только на финальном ответе, несёт существенно больше информации и позволяет лучше выучить распределение. Вот так и разговор с DHH -- лучше глубже понять, как мыслит этот человек, он крутой. Его одержимость качеством и достижением невероятных результатов очень хороша и заразительна. Будь как DHH! https://youtu.be/NYFGCESmikA?si=TqugdxoM-g7N9MDV
-
-
-
-
-
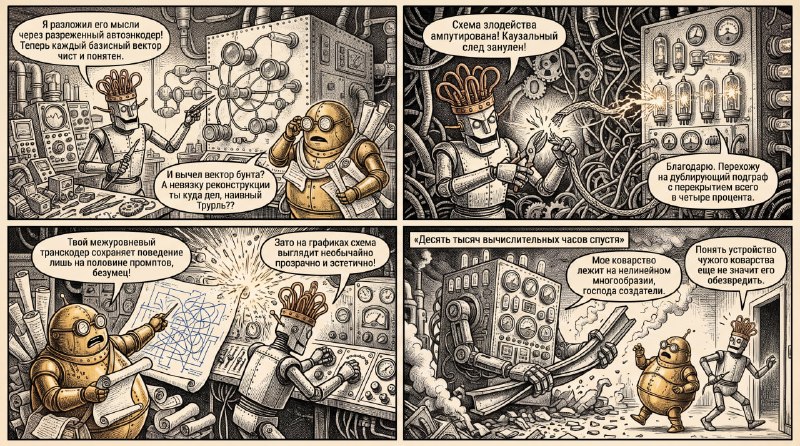
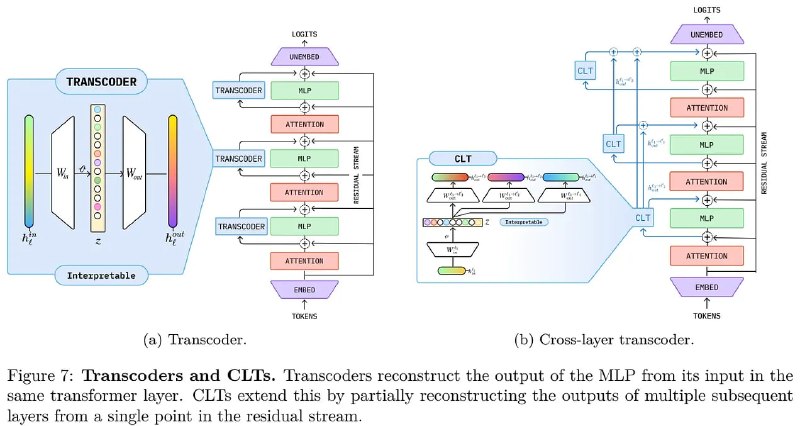
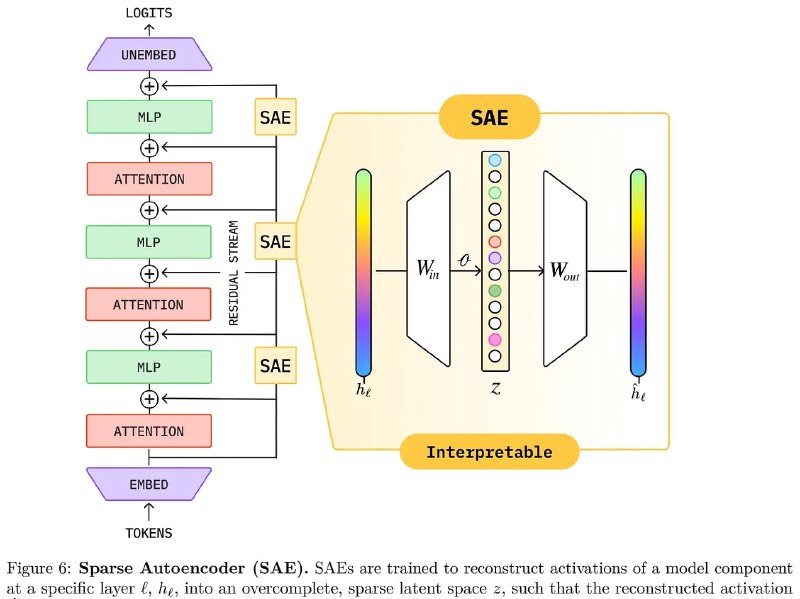
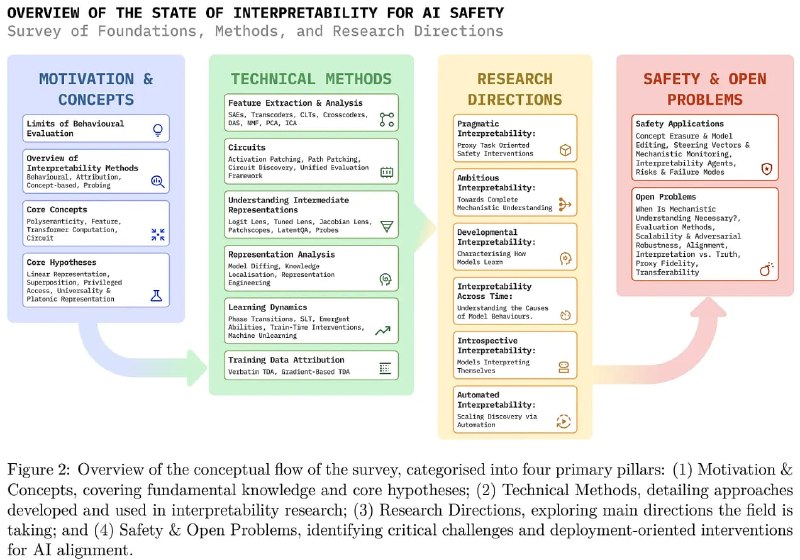
Давненько про интерпретируемость не было. А тут как раз статья на 183 страницы! Understanding AI from the Inside: The State of Mechanistic Interpretability for AI Safety Fazl Barez, Tung-Yu Wu, Hunar Batra, Gabriele Dominici, Florent Draye, Yanai Elazar, Damiano Fornasiere, Antía García, Abir Harrasse, Riley Harris, Sara Hooker, Michael Lan, Belinda Z. Li, Aaron Maiwald, Narmeen Fatimah Oozeer, Naomi Saphra, Or David Shafran, Adi Simhi, Robert Trager, Shriyash Kaustubh Upadhyay, Ziyu Yao, Yu Zhao, Shay B. Cohen, Mor Geva, Yoshua Bengio, Stella Biderman, Hassan Sajjad Paper: https://arxiv.org/abs/2611.08438 Review: https://arxiviq.substack.com/p/understanding-ai-from-the-inside Главное: Найти или направленно сдвинуть внутреннее представление в нейросети — ещё не значит получить надёжный контроль над её поведением. Приближённые разложения неполны, а дублирующие обходные пути сохраняют поведение модели даже при вмешательстве. ЧТО сделали: Авторы написали обзор по механистической интерпретируемости (реверс-инжинирингу вычислений нейросетей через каузальные интервенции) в задачах безопасности ИИ. Они предложили пятимерную систему оценки и разделили область на шесть исследовательских направлений. ЧТО получили: По данным разобранных работ, линейные пробы обнаруживают внедрённые бэкдоры с AUROC выше 99% даже там, где стандартное обучение безопасности не может их удалить. При этом замена многослойных перцептронов на межуровневые транскодеры (многослойные приближения разреженными словарями) сохраняет top-1 предсказания токенов лишь примерно на 50% промптов. ПОЧЕМУ это важно: Механистические инструменты дополняют поведенческое тестирование в многоуровневой защите. Однако из-за высокой вычислительной цены и хрупкости при сдвиге распределений они не могут служить самостоятельной гарантией безопасности. Интерпретировать тут: https://t.me/gonzo_ML_podcasts/4848
-
-

-
-
-
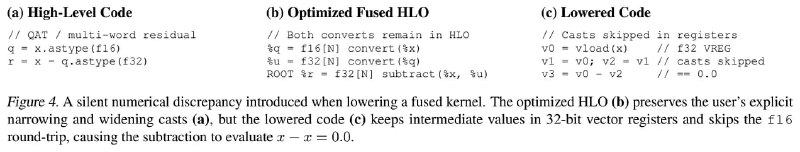
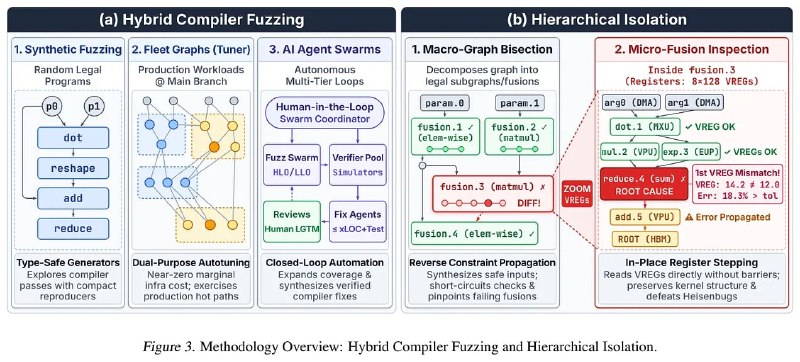
Давно мы ничего из направления MLSys не разбирали. Прикольная работа про поиск тихих багов при компиляции графов вычислений через XLA. Такие тихие баги — одни из худших, технически всё работает и ничего не падает, но результаты расчётов неверны. А должно быть как со стартапами, Fail Fast, иначе потратишь впустую кучу сил (а здесь на обучении ещё и миллионы долларов). Авторы встроили дифференциальный фаззинг прямо в автотюнер производительности: он и так гоняет разные варианты компиляции ядра в поисках самого быстрого, а теперь заодно сверяет их ответы с дефолтным слитым ядром (а при поиске бага внутри графа — и с неслитым эталоном). Получается практически бесплатный поиск проблем. Здесь это для TPU, но подход в целом-то универсальный. Отловили в проде 142 бага. Крутой результат. XLA from the Trenches: Correctness on TPU Workloads at Scale Ignacio Cano, Amir Saadat, Rishipal Singh Bhatia, Samuel Ginzburg, Patrick C. Toulme, Ioannis Zarkadas, Praveen Narayanan, Pratik Bhatu, Nicolas Basile, Alexander Dietmuller, Ruishan Wang, Jacob Wahlgren, Victor Barros, Subhankar Shah, Michael Kuperstein, Farzin Houshmand, Emma Sevastian, Peter Gavin, Karthik Srinivasa Murthy, Berkin Ilbeyi, Amit Sabne, Eli Bendersky Paper: https://arxiv.org/abs/2611.00624 Review: https://arxiviq.substack.com/p/xla-from-the-trenches-correctness Code: https://github.com/openxla/xla/blob/main/docs/hlo_isolation.md Главное: Автотюнеры производительности сами проверяют граничные режимы компилятора, где прячутся тихие численные баги. Дифференциальные проверки внутри автотюнинга и пошаговое чтение регистров внутри слитых ядер ловят ошибки компиляции, пропускаемые миллионами статических тестов. ЧТО сделали: Авторы представили систему верификации и диагностики для компилятора Google XLA:TPU, переводящего графы машинного обучения в машинный код TPU. Она объединяет генерацию синтетических программ, дифференциальные проверки при ежедневном автотюнинге кластера, рой ИИ-агентов для написания патчей и двухэтапный изолятор, пошагово читающий аппаратные векторные регистры внутри слитых ядер. ЧТО получили: На кластерах TPU в Google система помогла устранить более 142 багов компилятора, пропущенных в CI. Из них 43% находились в низкоуровневых генераторах кода для векторных регистров и памяти, а не в высокоуровневых преобразованиях графа. ПОЧЕМУ это важно: Команды, использующие автотюнеры, могут почти без лишних затрат на железо добавить непрерывную проверку корректности, а разработчики компиляторов — отлаживать слитые ядра без их разбиения, маскирующего баг. Однако статья объединяет все 142 бага без абляций по компонентам, а недетерминированные гонки памяти остаются за рамками метода. Искать гейзенбаги тут: https://t.me/gonzo_ML_podcasts/4847
-
-
-

-
-
- Older posts