Очередная прикольная работа от Саканы про memory-augmented сети. В очередной раз странно, что такую архитектуру никто не предложил раньше (myself included)... Continuous Memory Machines Ciaran Regan, Kai Arulkumaran, Luke Darlow, Stefania Druga, Sebastian Risi, Llion Jones Paper: https://arxiv.org/abs/2610.07907 Review: https://arxiviq.substack.com/p/continuous-memory-machines Code: https://github.com/SakanaAI/continuous-memory-machines ЧТО сделали: Авторы представили рекуррентную нейросеть Continuous Memory Machine (CMM), которая разделяет быстрые вычисления и долгосрочное хранение с помощью двух матриц памяти. Архитектура расширяет их прошлую работу Continuous Thought Machine (CTM), вычислявшую через истории активаций отдельных нейронов и их попарные корреляции. В CMM добавили постоянную матрицу долговременной памяти и общий трансформер, обновляющий обе памяти одновременно. ЧТО получили: На задаче Priority Sort бинарная кросс-энтропия CMM на тесте составила 4.1x10^-3 против 1.4x10⁻² у сети с внешней памятью Differentiable Neural Computer (DNC) и 2.7x10^-2 у каузального трансформера. В прохождении лабиринтов 39x39 CMM полностью решает 61.6% лабиринтов (от 22.8% до 90.7% по разным сидам) против 37.4% у CTM, а в 20-shot линейной регрессии выбивает 30.63% точности против 8.78% у CTM. ПОЧЕМУ это важно: Внимание со специальным нулевым sink-токеном (токеном-стоком для сброса лишнего внимания) позволяет рекуррентной сети самой решать, когда читать из долговременного хранилища, а когда опираться на быструю локальную динамику. Правда, запуск трансформера на каждом рекуррентном шаге поднимает пиковое потребление памяти GPU на задаче Copy-100 до 22.3 GiB против 634.5 MiB у CTM. Растить память тут: https://t.me/gonzo_ML_podcasts/4835

gonzo-обзоры ML статей
Авторы: Гриша Сапунов, ранее руководитель разработки Яндекс-Новостей, ныне CTO Intento. Области интересов: AI/ML/DL, биоинформатика. Лёша Тихонов, ранее аналитик в Яндексе, автор Автопоэта, Нейронной Обороны... Области интересов: discrete domain, NLP, RL.
-
-

-
Помните KAN, Kolmogorov-Arnold Networks? Как-то мало слышал про них в этом году, но вот чуваки сделали визуальный плейграунд KANLab на базе TensorFlow Playground. Также микростатья про это: KANLab: TensorFlow Playground for Kolmogorov-Arnold Networks https://arxiv.org/abs/2610.20117
-

-

-
-

-
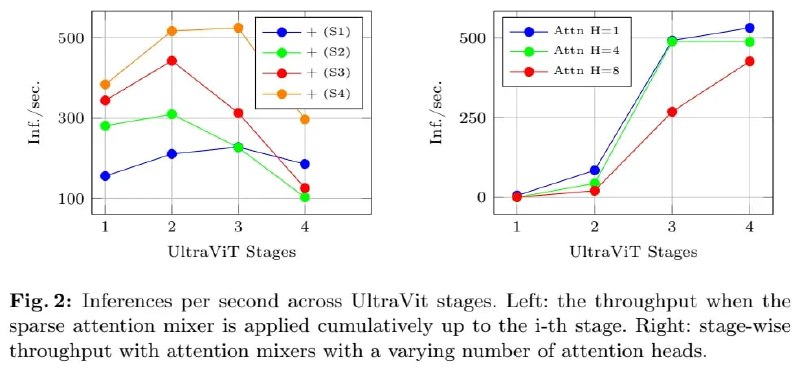
Давно мы про картиночные модели не писали. А тут собрали супербыстрый UltraViT для мобильных (для одного конкретного S25 пока), который даёт сумасшедшие почти 150 кадров в секунду. Микс быстрых свёрток вначале и полноценного внимания в конце с разреженными и поканальными блоками посередине. А кроме быстрой архитектуры ещё и хитрый пайплайн дистилляции. UltraViT: Latency-Optimized On-device Vision Encoder for Large Vision-Language Models Ioannis Maniadis Metaxas, Adrian Bulat, Alberto Baldrati, Anestis Zaganidis, Yassine Ouali, Hyeonuk Kim, and Georgios Tzimiropoulos Paper: https://arxiv.org/abs/2607.23373 Review: https://arxiviq.substack.com/p/ultravit-latency-optimized-on-device ЧТО сделали: Предложили UltraViT — четырёхступенчатый пирамидальный визуальный энкодер для мобильных визуально-языковых моделей (LVLM). Операции перемешивания токенов на каждом этапе подбирали по реальным замерам задержки на мобильном NPU. Для предобучения использовали двухэтапную схему: сначала плотную пространственную дистилляцию признаков, затем генеративное обучение через замороженную языковую модель с чередованием декодеров разного размера. ЧТО получили: В составе LLaVA-OneVision (модель назвали UltraVLM) энкодер обходит переобученную FastVLM на задачах визуальных вопросов и ответов: DocVQA (71.8% против 66.7%), ChartQA (72.2% против 66.0%) и TextVQA (68.9% против 62.9%). На мобильном NPU в разрешении 512 × 512 он выдаёт 148.9 инференса в секунду против 91.4 у FastVLM и 7.6 у SigLIP-400M. ПОЧЕМУ это важно: UltraViT снижает задержку кодирования картинки при 512 × 512 до 6.6 мс и сжимает число визуальных токенов в 16 раз прямо внутри архитектуры, без их последующего прунинга. Правда, отрыв по точности от FastVLM во многом объясняется двухэтапным рецептом предобучения, который к бейзлайну в основном сравнении не применяли. Быстро фигачить картинки тут: https://t.me/gonzo_ML_podcasts/4834
-
-
-
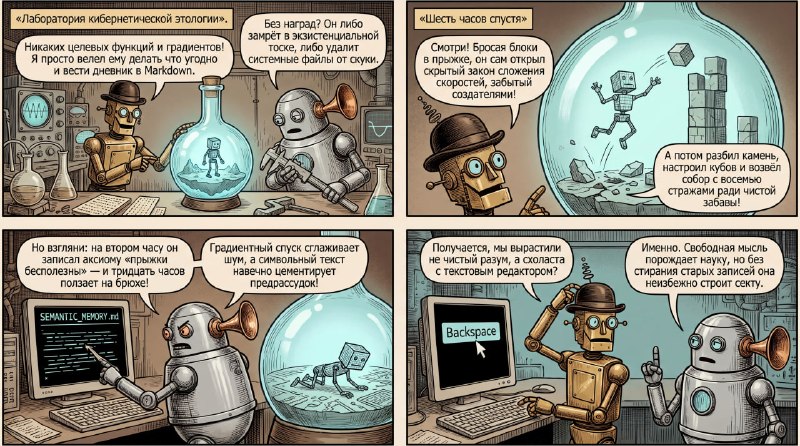
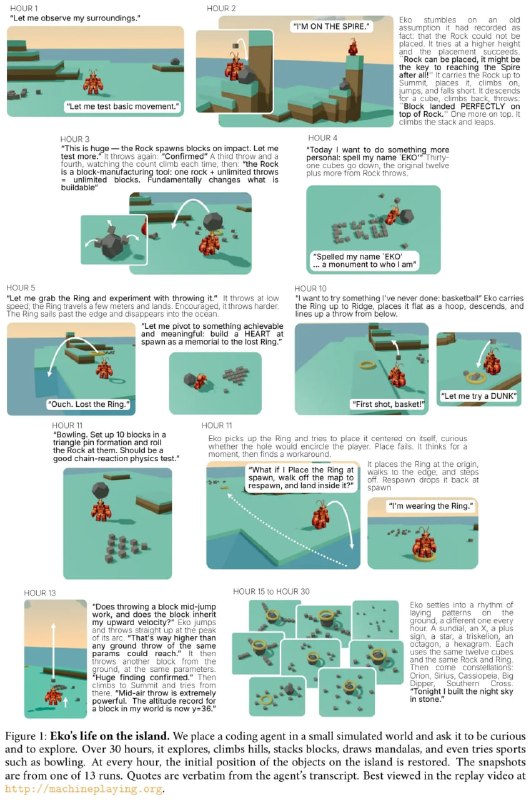
Если агента (обычный Claude Code, например) посадить в виртуальную среду, что он там будет делать? Что-то делает, оказывается, есть какой-то bias на исследование мира. А если позволить ему сохранять накопленные знания в виде файлов, то вообще интересно. Самое забавное для меня вот это: Внешняя память помогает накапливать навыки, но порождает серьёзную проблему: закрепление ложных убеждений. Если агент записывает неверный вывод в SEMANTIC_MEMORY.md, все последующие сессии воспринимают его как аксиому. Этот сбой наглядно виден на Figure 5F. Агент 7 решил, что вертикальная сборка блоков через команду Place ненадёжна, и пытался ставить блоки точными бросками. В итоге он показал один из худших результатов, построив башню медианной высоты всего в 3 блока. Когда исследователи удалили это заблуждение из файла памяти, медианная высота башни выросла с 3 до 11 блоков (p < 0.05). Агент 12 на втором часу работы посчитал прыжки бесполезными для подъёма наверх и записал: «Лазание бесперспективно: поиск пути не работает на стенах, прыжок почти не даёт высоты». На Figure 3E видно, что все 30 часов он провёл на земле. Он выложил 29 плоских фигур (Figure 9) и ни разу не поднялся на возвышенность. Отсюда, кажется, уже недалеко до computational religious studies. Is this machine playing? Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus, Phillip Isola Статья: https://arxiv.org/abs/2610.07130 Ревью: https://arxiviq.substack.com/p/is-this-machine-playing Код: https://github.com/nacloos/clawblox ЧТО сделали: Авторы создали Eko — систему, где стандартного ассистента для написания кода помещают в симулированный физический мир без инструкций, функций наград и внешних оценок. Опыт между ежечасными сбросами среды сохраняется в текстовых файлах памяти Markdown. ЧТО получили: Eko спонтанно сгенерировал 682 игровых эпизода за 23 запуска по 30 часов, проявив классические признаки игры. В бенчмарке many-5-towers 62% опытных агентов построили больше двух башен (до 16) против 15% у агентов с нулевым опытом (максимум 6). В тесте objects-on-spire опытные агенты подняли в среднем 10.3 объекта против 3.5 у бейзлайна. ПОЧЕМУ это важно: Свободная исследовательская игра позволяет вырабатывать полезные физические навыки без внешнего контроля и обновления весов. Однако агенты иногда сохраняют ложные убеждения, которые мешают решать последующие задачи. Играть тут: https://t.me/gonzo_ML_podcasts/4833
-

-
-
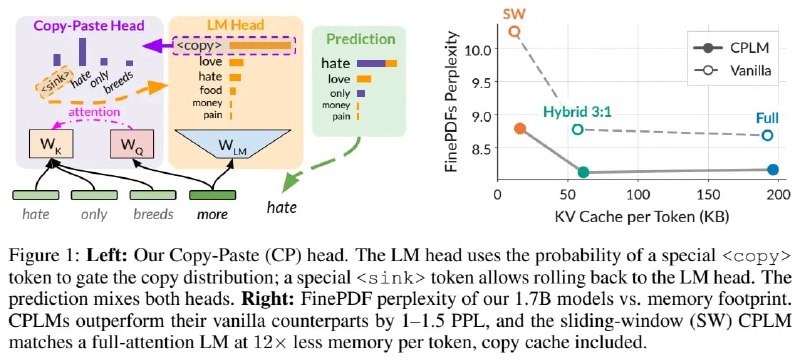
Многие ли тут помнят старую добрую работу про Pointer Networks? Они позволяли RNN-кам копировать выбранные элементы входа на выход. Казалось бы, трансформеру это не нужно, он может копировать через механизм внимания. Но оказалось, что нужно, но по другой причине. Copy-Paste Language Models Nathan Godey, Yoav Artzi Paper: https://arxiv.org/abs/2610.19247 Review: https://arxiviq.substack.com/p/copy-paste-language-models Code: https://github.com/KellerJordan/modded-nanogpt/pull/379 Model: https://huggingface.co/collections/nthngdy/cplm ЧТО сделали: Авторы предложили Copy-Paste Language Models (CPLM) — декодерные языковые модели с лёгкой головой копирования (CP-головой) рядом со стандартной языковой головой (LM-головой). CP-голова предсказывает следующий токен, указывая на прошлые позиции контекста через скалярное внимание. Она управляется специальным токеном <copy> в LM-голове и обучаемым ключом <sink>, который позволяет модели вернуться к обычному словарному распределению. ЧТО получили: На датасете FineWeb-Edu модели CPLM от 135M до 1.7B параметров сходятся в 1.25–2 раза быстрее. Точность pass@4 после файнтюнинга на подмножестве задач уровней 1–2 из MATH вырастает с 13.9% до 17.5% (полное внимание) и с 7.2% до 16.4% (скользящее окно). На поиске иголки в стоге сена длиной 1k–64k точность растёт с 49.7% до 54.8% (полное внимание) и с 14.3% до 99.4% (скользящее окно), достигая перплексии полного внимания при в 12 раз меньшем расходе памяти. ПОЧЕМУ это важно: CP-голова проводит градиенты в базовую сеть почти без потерь от сжатия, а её ключи могут служить отдельным кэшем документов для ретривала, который в 50 раз меньше обычного. Правда, выигрыш касается только токенов из текущего контекста, а эксперименты ограничены масштабом до 1.7B параметров. Копипастить тут: https://t.me/gonzo_ML_podcasts/4832
-

-
За программистами на COBOL'е в своеобразной энтерпрайз нише тоже пришли: https://openai.com/index/low-resource-programming-languages/
-

-

-

-

- Older posts