Когда имеющаяся разметка для обучения языковых моделей подзакончилась, приходится изощряться. Вот авторы предложили использовать данные геометрии белков, надеясь, что модель и отсюда научится какому-то размышлению. Чему-то таки она научилась. Так что занимайтесь спортом, чтобы и музыка прокачалась. И наоборот :) Does Learning Protein Folding Generalize to Broader Reasoning? Yong Liu, Zhanpeng Shi, Yizhou Dang, Zhongyue Zhang, Xiaoliang Shi, Zhijian Wei, Shuangjia Zheng Paper: https://arxiv.org/abs/2609.38879 Review: https://arxiviq.substack.com/p/does-learning-protein-folding-generalize Code: https://github.com/GENTEL-lab/Fold2Reason Model: N/A ЧТО сделали: Собрали FoldingCorpus — датасет вопросов и ответов по геометрии белков из 14 400 примеров с 12 детерминированными операторами. Предложили метод постобучения Fold2Reason, обновляющий языковую модель через кросс-энтропию на дискретных ответах и декодирование непрерывных координат через замороженную голову. На инференсе геометрические модули полностью убирают. ЧТО получили: Макроточность Qwen3.5-9B на десяти бенчмарках выросла с 45.09% до 48.33% (+3.23 процентных пункта), тогда как контроль со случайным перемешиванием просел до 44.82% (-0.27 п.п.). На бенчмарке биомолекулярных структур FoldBench метрика contact F1 выросла с 3.05% до 6.90%. ПОЧЕМУ это важно: Проверенные физические структуры могут улучшать небиологические рассуждения без синтетических текстов. Однако прирост в основном сосредоточен в специфических пространственных задачах и совершенно не переносится на Gemma-4-12B-IT. Прокачивать рассуждения тут: https://t.me/gonzo_ML_podcasts/4831

gonzo-обзоры ML статей
Авторы: Гриша Сапунов, ранее руководитель разработки Яндекс-Новостей, ныне CTO Intento. Области интересов: AI/ML/DL, биоинформатика. Лёша Тихонов, ранее аналитик в Яндексе, автор Автопоэта, Нейронной Обороны... Области интересов: discrete domain, NLP, RL.
-
-

-

-
-
-
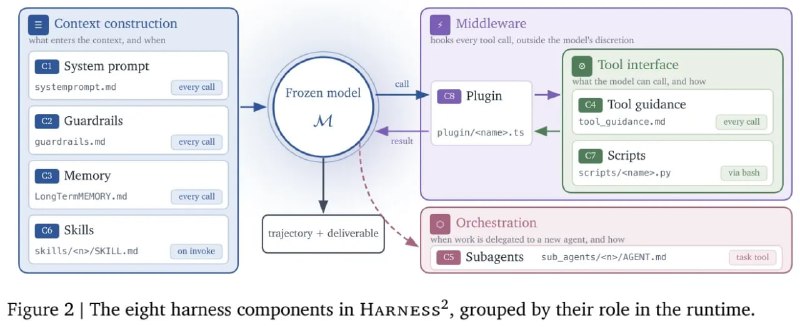
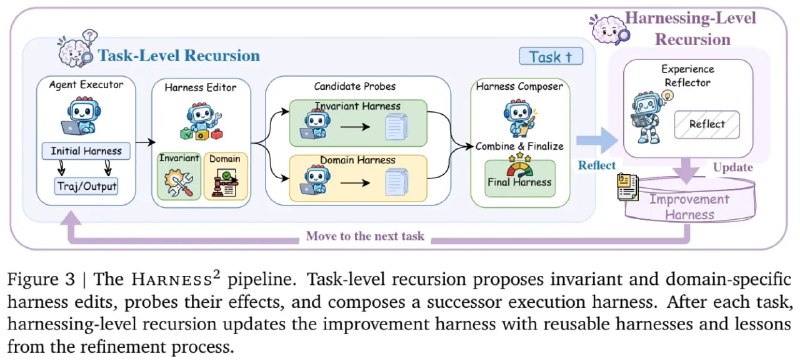
Эволюция харнессов сейчас примерно везде. Вот популярная свежая гугловая работа на эту тему. Harness^2: Recursive Agent Harnessing for an Open World Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu, Bhavana Dalvi Mishra, Yifei Ming, Han Yu, Rujun Han, Chen-Yu Lee, Tomas Pfister Paper: https://arxiv.org/abs/2610.14224 Review: https://arxiviq.substack.com/p/harness2-recursive-agent-harnessing Code: https://github.com/google-research/harness2 ЧТО сделали: Авторы представили Harness^2 — фреймворк, который на лету оптимизирует рабочую обвязку замороженной языковой модели (промпты, защитные правила, навыки, скрипты и промежуточный код) без эталонных верификаторов. Он сочетает рекурсию на уровне задачи, где обвязка дорабатывается через сравнение поведения разных вариантов правок, и рекурсию на уровне самой настройки, где полезные уроки сохраняются в библиотеку улучшений для будущих задач. ЧТО получили: В четырёх конфигурациях моделей и обвязок с Claude Opus 4.8 в роли редактора один шаг контрастного улучшения (k=1) повышает средний балл на WorkBuddy-Bench с 64.2 до 75.7 для GLM-5 и с 72.4 до 77.5 для Gemini 3.5 Flash в среде OpenCode, обходя офлайновый Meta-Harness (69.7 и 76.4). Масштабирование параллельной рекурсии до k=5 даёт 80.8 на WorkBuddy-Bench и поднимает результат на JobBench с 31.5 (база) и 32.9 (Harness Scaling) до 39.0. ПОЧЕМУ это важно: Агенты могут адаптировать свои инструменты и накапливать переиспользуемый опыт редактирования прямо во время работы на неразмеченных задачах. За счёт этого адаптированная слабая модель способна обойти неадаптированную сильную, хотя проверка нескольких кандидатов кратно увеличивает расход токенов на инференсе, а основные эксперименты опираются на топовую модель-редактор. Варить свой харнесс тут: https://t.me/gonzo_ML_podcasts/4830
-

-
-
-

-
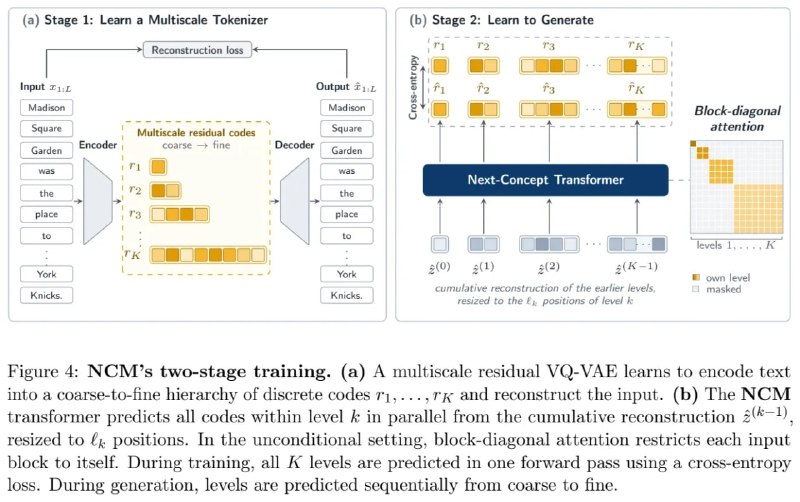
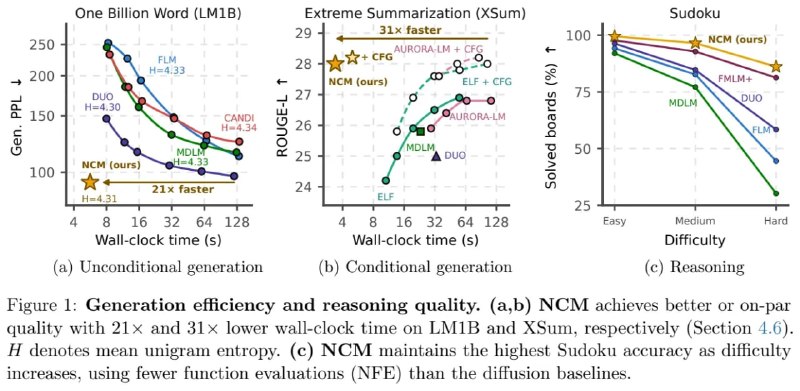
Интересная работа про моделирование последовательностей через иерархию концептов. Размеры исследуются только малые, но модель ведёт себя лучше авторегрессионок и диффузионок. Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation Hermann Kumbong, Ishan S. Khare, Iddah Mlauzi, Andrew Woen, Charles Ding, E. Kelly Buchanan, Simran Arora, Azalia Mirhoseini, and Christopher Ré Paper: https://arxiv.org/abs/2610.14162 Review: https://arxiviq.substack.com/p/next-concept-modeling-fast-parallel Code: https://github.com/HazyResearch/ncm Model: N/A ЧТО сделали: Предложили двухэтапный неавторегрессионный метод генерации текста Next-Concept Modeling (NCM). Сначала автоэнкодер с векторной квантизацией (VQ-VAE) сжимает последовательность токенов в многомасштабную иерархию дискретных остаточных кодов. Затем трансформер учится генерировать эти уровни от грубых к детальным, предсказывая все коды внутри каждого уровня параллельно. ЧТО получили: При размере около 100M параметров NCM догоняет или обходит диффузионные и потоковые модели, работая заметно быстрее. На LM1B модель достигает генеративной перплексии 93.05 за 12 шагов против 97.30 за 128 шагов у дискретной диффузии DUO (в 21 раз быстрее). На XSum NCM набирает 28.0 ROUGE-L за 8 шагов против 26.6 за 128 у латентной диффузии AURORA-LM (в 31 раз быстрее), но уступает в переводе на WMT14 без гайданса (22.6 против 24.8 BLEU). На сложном судоку метод решает 86.1% полей за 12 шагов против 81.3% за 16 у потоковой модели FMLM+. ПОЧЕМУ это важно: Короткие ранние уровни сокращают число обрабатываемых токенов при обучении в 4–5 раз и высвобождают ресурсы на инференсе для проверки кандидатов. Однако метод привязан к фиксированному расписанию длин и отдельному токенизатору, который ошибается при реконструкции в 0.01%–1.21% токенов. Моделировать концепты тут: https://t.me/gonzo_ML_podcasts/4829
-
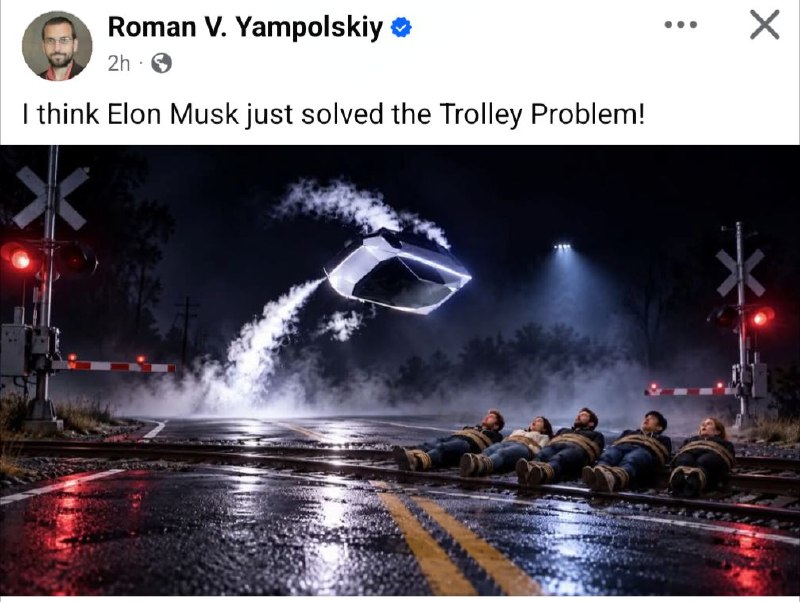
Гениально, имхо.
-

-
-

-
-
-
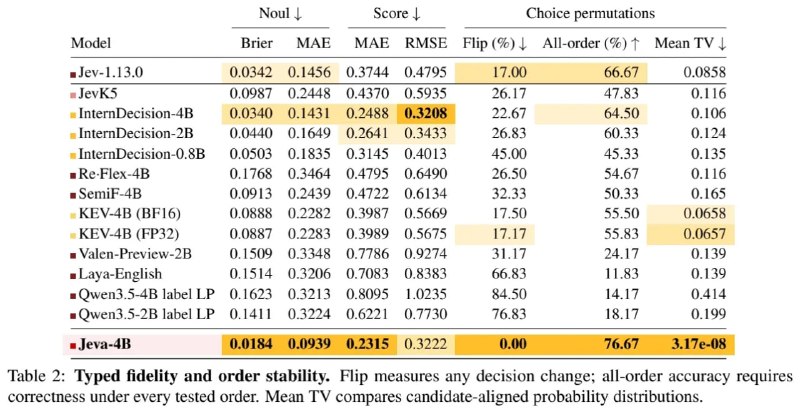
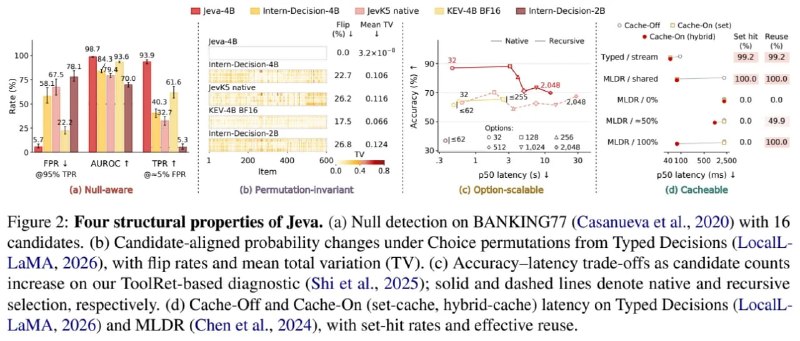
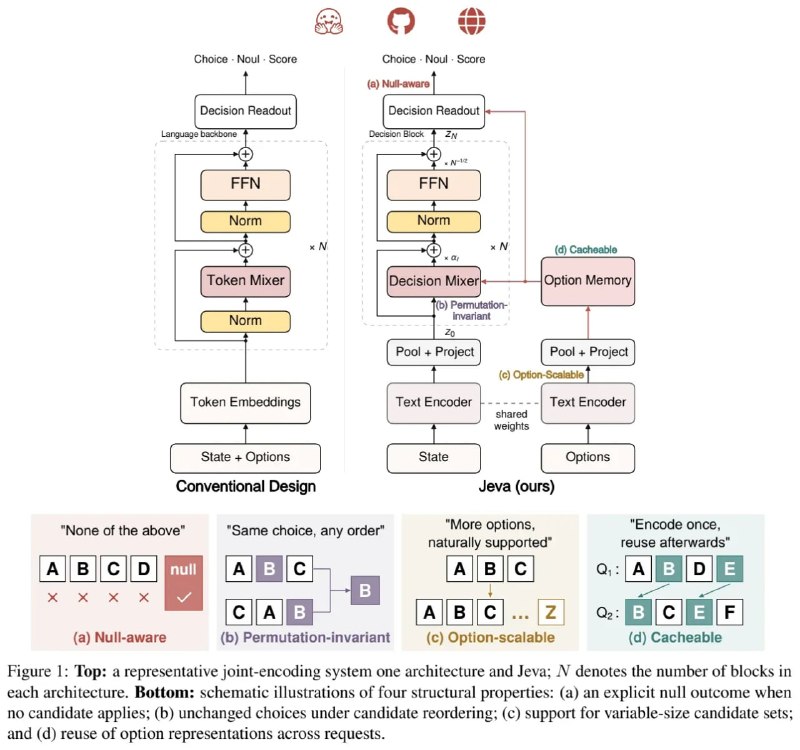
Опенсорс идёт вперёд. У оригинального Jev и его открытых клонов есть несколько проблем: зависимость ответа от перестановки вариантов, невозможность сказать "не знаю", отсутствие кеширования вариантов (когда их много и они слабо меняются) и сложность с большими количествами опций (скажем 2k). Новая открытая модель это решает. Интересно, конечно, как TypeSafe собирается держать лидерство, когда техническая часть неплохо развивается независимо от них. Видимо пока только в хорошей калибровке потенциальный moat, но вряд ли надолго. Jeva: System One Models from First Principles Qi Li, Xinchao Wang Paper: https://arxiv.org/abs/2610.18773 Review: https://arxiviq.substack.com/p/jeva-system-one-models-from-first Code: https://github.com/LiQiiiii/Jeva Model: https://huggingface.co/LIQIIIII/Jeva-4B ЧТО сделали: Авторы представили неавторегрессионную архитектуру Jeva (и чекпойнт на 4B параметров Jeva-4B) для моделей Системы 1 — быстрых классификаторов, выдающих типизированные решения без текстовых цепочек рассуждений. Модель кодирует запрос и варианты ответа независимо, после чего уточняет только вектор запроса об неизменяемую память вариантов и использует отдельный гейт для определения того, есть ли среди вариантов верный ответ. ЧТО получили: При перестановках вариантов ответа на бенчмарке Typed Decisions частота смены ответа у Jeva-4B составляет 0.00% против 17.00% у Jev-1.13.0 и 22.67% у Intern-Decision-4B. На BANKING77 с 16 вариантами точность достигает 91.62% (против 82.50% у Jev-1.13.0), а AUROC детекции отсутствия ответа — 98.66% (против 93.61% у KEV-4B). Гибридное кэширование на MLDR снижает медианную задержку в 1.95 раза при 50% переиспользовании вариантов и в 27.98 раза при 100%. ПОЧЕМУ это важно: Представления инструментов или документов можно заранее посчитать и закэшировать для любых наборов кандидатов, при этом порядок подачи вариантов никак не влияет на ответ. Однако на полностью новых вариантах преимущество кэша пропадает, а каждый вариант ограничен своим лимитом токенов. Искать ответы тут: https://t.me/gonzo_ML_podcasts/4828
-
-
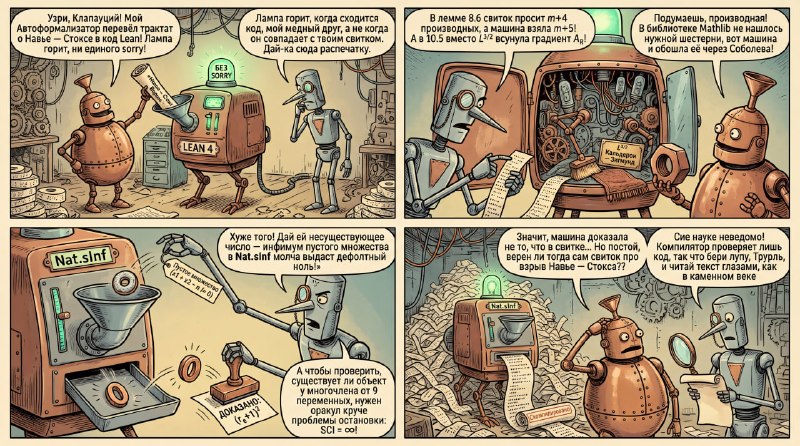
edited По предыдущей статье о проблемах свежего доказательства Навье-Стокса разбор делать не так интересно, как прожарку. Прожарка 🔥: Navier–Stokes Lost in Translation – Why Lean Verification of AI Autoformalisation Does Not Guarantee Correct Natural Language Proofs A. Bastounis, F. Circelli, and A. C. Hansen Paper: https://arxiv.org/abs/2610.08144 Review (без прожарки): https://arxiviq.substack.com/p/navier-stokes-lost-in-translation # TL;DR ЧТО сделали: Проверили код на Lean 4 из заявленного OpenAI доказательства разрушения решений уравнений Навье — Стокса за конечное время и сверили его с текстовой версией. К этому приложили доказательство того, что семантически точная автоформализация имеет индекс сложности разрешимости SCI = ∞. ЧТО получили: Нашли два расхождения в промежуточных леммах: в Example 3.1 код на Lean 4 использует m+5 производных вместо m+4, а в Example 3.3 заменяет оценки Кальдерона — Зигмунда в L^3/2 на вложение Соболева в L^2. При этом авторы не проверили ни сохранение глобального доказательства, ни саму главную теорему, ни статью по уравнениям Эйлера. ПОЧЕМУ это важно: Полезный разбор того, как LLM обходит отсутствие нужных лемм в библиотеке Mathlib ради успешной компиляции, авторы раздули до 25-страничного трактата о неразрешимости и дополнили скриншотами из ChatGPT-6. Далее обжаривать здесь: https://t.me/gonzo_ML_podcasts/4827
- Older posts