Продолжаем разгонять философию про нейронки, а так же следим за новейшими тенденциями в этой области. Лайк подписка комментарий 🙂 https://www.youtube.com/watch?v=_vapSvULevU
Глеб Кудрявцев — мастер AI
Пишу тулы для кодинга и упарываюсь по агентам. Лучший курс по AI кодингу ai.careerfactory.ru Статьи и переводы: vibeportal.ru Второй канал t.me/glebkudr Личка t.me/glebkudr1
Subscribers
15.2K
tracking since 24 Oct
Reach per post (ERR)
38.2%5.8K avg views
Posting
1.1/day
last 1 day ago
Reactions per 1K views
13.8
😁 👍 🔥
-
-

-
Шо пацаны, как вам реклама? Конечно же ни один живой спикер не пострадал 😊
-
edited 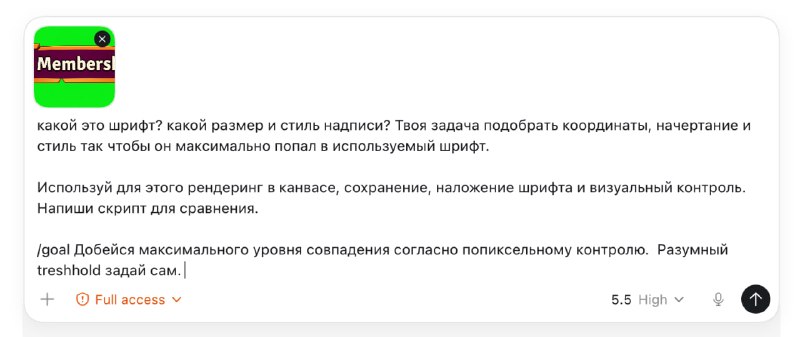
Как использовать /goal в работе? Самое главное — задать численную метрику для улучшения. Тогда агент реально будет шуршать часами. Вот простой пример, бывают и посложнее.
-


Открыл для себя новый интересный подход к верстке. Допустим у вас есть картинка или скриншот. В принципе можно просто сказать агенту - верстай, пока не добьешься полного попадания. Но это не очень эффективно, особенно если интерфейс богат на картинки и представляет собой нагромождение слоев. Как поступить иначе? А вот так — ставим себе локально sam3 и делаем скилл по классификации объектов сцены. Далее автоматически извлекаем bbox'ы этих объектов. Дальше с этим можно делать что угодно, например перетекстурировать на хромакей с помощью image-gen, сделать прозрачный задник и получить финальный набор ассетов для реконструирования страницы. Чем это лучше локации с помощью LLM? Тем, что LLM гораздо сильнее ошибается в выдаче итоговых координат. Как следствие, извлечение проходит криво и в много стадий/тратя ваши лимиты почем зря. А вот гибридный подход работает практически с первого раза.
-
edited У меня нет антропиков, как-то не сложилось, но вопрос конечно важный. Как вам фубля?
-
edited 
Настроил все, чтобы управлять гугловскими кампаниями из кодекса. Вы скажете — просто. Я скажу — конечно. Для того, кто в детстве собирал компы из хлама и переустанавливал пиратскую винду из репаков. Остальных ждет множество приятных открытий. А, да, все те, кто делает этот экспириенс, получают в гугле больше 30 тысяч долларов зарплаты ежемесячно.
-
edited 
Внезапно все растащили эту пасту от создателя клешнебота. Напоминание: хватит промптить кодинг-агентов напрямую. Нужно проектировать циклы, которые промптят агентов за вас. Спешу сообщить: — подход говно — это очевидно любому, кто пытался сделать что-то по-настоящему работающее. Нейронки (сейчас) не умеют в мета-программирование нейронок. И результат если и получается, то ниже среднего. Вот когда научатся — тогда и поговорим (но в этом случае они будут просто ваншотать пайплайны вместо этих кретинских ральф лупов)
-
edited 
Я правда развернул 5 моделей.
-
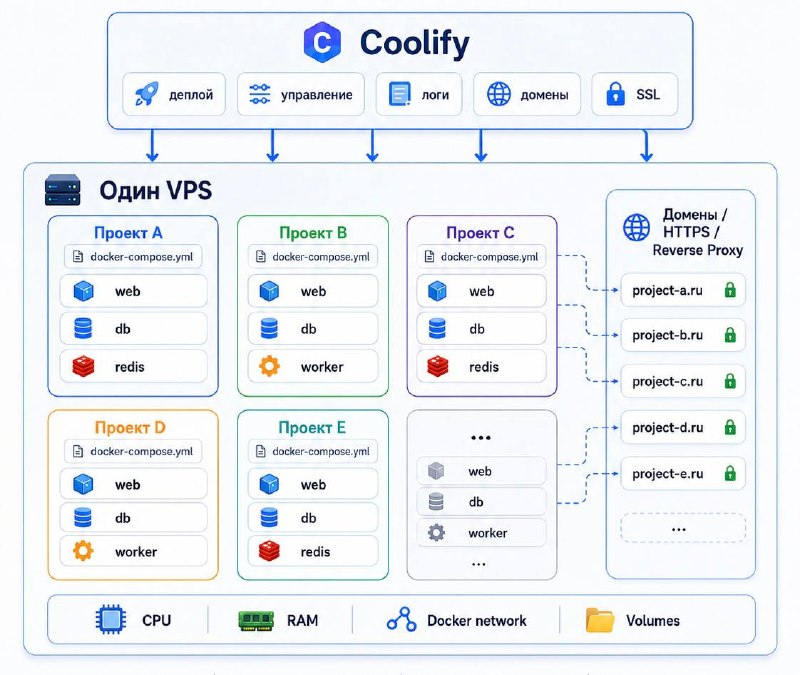
Может для кого открою Америку, но если у вас список проектов перестает помещаться на экране, но нагрузки на каждый из них три копейки, то используйте для выкладки Coolify Это бесплатная оупенсорсная софтина, которая позволяет вам без танцев с бубном завести на одном сервере не один, а десяток проектов, плюс удобно ими управлять в будущем. Я сначала извращался, писал какие-то деплой скрипты, настраивал реверс-прокси, а потом просто пересел на кулифай где все это есть из коробки, чего и вам желаю. PS сделал картинку-пояснение в нейронке. Напишите как вы к ним относитесь, мне вроде как с ними понятнее, хотя и видно что сгенеренные. Короче думаю делать такие картинки дальше или нет.
-
edited Есть такая тема из теории управления — обратные связи. Так вот, они нужны для устойчивости систем, и любые адекватные системы ими напичканы, чтобы не идти вразнос. И мне подумалось, а почему мы считаем, что единицей пайплайна является "агент"? У меня ни разу не получилось хорошего пайплайна на одном агенте, всегда что-то идет не так. Поэтому мысль: минимальной единицей работы должна быть пара агентов, или их четное количество. Простейший вариант — "Писатель"/"Критик" но может быть какая угодно. Главное, они должны работать в паре в противовес друг другу. Тогда система получается внутренне устойчивой и значительно чаще выдает адекватные результаты. Что скажете?
-
edited 
Ну штош, запустил Pro модельку на sotaocr.com Хорошо распознает рукописный ввод, сложные табличные формы и все такое. Стоит x2 кредитов. Отдельный бесплатный лимит на онбординге - 10 страниц. Доводить до идеала запарился, так что будут ситуации где она лажает, самое главное что может пойти не так — детектор поворота (иногда тупит на рукописных текстах). В апи его можно отключать. Самое важное — сравнение с фронтирными LLM (Opus, Gemini, GPT). В чем их отличие: + более универсальны в распознании текста и формул - очень плохи в определении координат блоков - очень плохи в построении топологии таблиц - сильнее пропускают блоки и ленятся на больших документах - недоступны он премиз. Весь мой сервис ставится он премиз при желании и чист по лицензиям. На текущий момент это лучшее что есть из OCR для рабочих задач. Пробуйте 👌
-

Вот это гениальная фича кодекса. Говоришь любой таймер, время, дату - он его ставит и возрождает тред когда тебе надо. Думаю, привяжу скиллом к списку дел - будет вообще бомба.
-
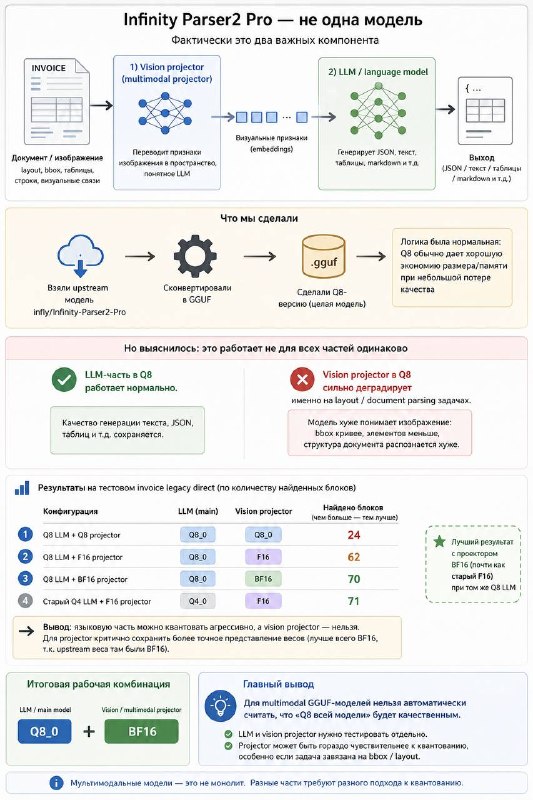

Все хочу запустить наконец про-режим в sotaocr. Целый день убил на отладку модели. Полноразмерная слишком жирная для карточки, а с квантом обнаружился прикол, с которым я и возился. Оказалось (внезапно!), что у этой модельки аж две составляющих. — визуальная — ллм-ная И прикол в том, что рабочие кванты у них разные. Если ллм часть можно запускать на q8 и аж даже на q4, то вот качество детектора координат bbox сильно деградирует при любом малейшем квантовании оригинала. И стандартный q8 ее напрочь ломает. Убил кучу времени, чтобы понять, что же не так и почему она дает кривое распознавание. Но в итоге смог сделать хороший пресет и даже выложил публично тут А на картинке попросил гопоту сделать нормальное объяснение механики того, что происходило, если вы хотите вникнуть в тематику поглубже.
-


 +1
Когда я написал про то, что делаю креативы для sotaocr со скиллом, ко мне пришел товарищ, который сказал, что написал целый контент-завод внутри кодекса/клода. И более того — все доступно оупенсорс, заходишь и скачиваешь. Креативы получаются очень хорошие, так что с удовольствием пиарю. Фейк отзывы и стата мне особенно понравились, так и просятся в твиттер 😁 качать и пробовать вот тут: https://github.com/alecs5am/ralphy https://www.alecs5am.com/library Написать автору: @orniki
-
Первый раз сегодня запускаю свою квантизацию, а не просто скачиваю модельку с HF, держите за меня пальчики посоны.
-
edited 
У меня для удобства давным давно написана парсилка статей из твиттера. Одной кнопкой выгружает весь контент вместе с картинками. Добавил расширение, которое выгружает целиком тред. Я терпеть не могу твиттерские треды, это какое-то чудовищное порождение ограничений платформы, поэтому возможность переделать это в формат статьи - подарок для человечества. Результат — полноценная статья о том, какие прорывы сейчас произошли в лечении сложных видов рака. Ради нее и захотелось написать этот функционал. https://vibeportal.ru/forum/topic/nastupaet-era-targetnoi-terapii-raka Как вам? Что бы вы улучшили в работе с тредами и превращении их в статьи?
-
Хозяйке на заметку Если решаете задачу анализа изображений, например чертежей, то можно сразу конечно запустить Sota модель со зрением. Например Opus. Только вот на больших картинках он — ленится — ошибается — не умеет в маски и так себе строит bbox В итоге реально я применяю отдельно детекцию сегментов (ковыряю сейчас sam3), которая дает хорошие маски. А затем отдельно же OCR по сегментам и на закуску уже - прохожусь по каждому из них взрослой моделькой чтобы извлечь итоговую семантику. Если вам нужно просто вырезать фотку собачки резвящейся на лугу, то это оверкилл. А вот если работаете со сложной документацией, то только так.
-
Подписчики сообщают, что вышла PaddleOcr следующей версии (1.6), обновил sotaocr Релиз не очень крупный, но метрики чутка подросли, особенно в распознании редких символов.
-
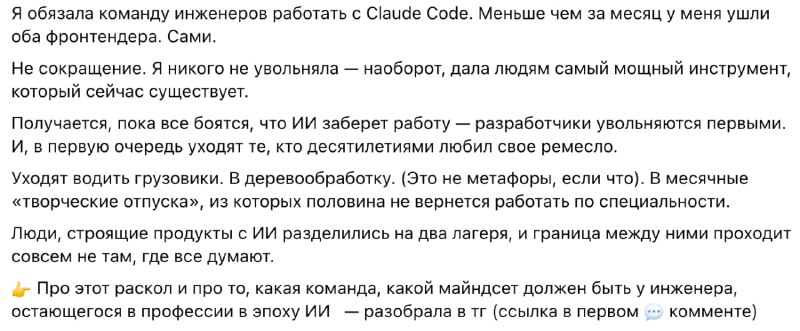
ИИ слоп в ФБ конечно мощно набирает. Людям походу такое нужно. Вот хер знает — вы все говорите, не любим читать ИИ тексты. А сами читаете с удовольствием и комментируете. Вот что с этим делать, га? 😉
- Older posts