Higgsfield Supercomputer – long-running агент для контент-продакшна Higgsfield анонсировали Supercomputer – агента по типу кодекса/клешни/гермеса с вертикальной специализацией в контент-продакшне и маркетинге. Как и в случае с агентами для кодинга, в создании креативов тоже всё тоже сводится к агент = модель + обвязка. Supercomputer - это агент построенный на собственной обвязке от Higgsfield, и сгенерировал уже 5 млрд+ охватов в соцсетях (Instagram: @higgsfield.ai) Клод код в свое время демонстрировал свои возможности написанием С-компилятора. А хиггсфилды решили показать это созданием полнометражки, которую хотят показать в Каннах. Под капотом у агента: [0] Скиллы, как основной примитив интеграции и расширения. Есть даже готовый цикл для их улучшения. [1] Система инжениринга контекста (долговременная память, сессионная память, проектные артефакты). [2] оркестратор на собственном форке Гермеса [3] мульти-модельный роутинг, параллелизация, сабагенты [4] облачная инфра на GPU с изоляцией между задачами [5] фронтирные модели (seedance 2.0, gpt image 2, veo, kling, nano banana 2) наряду с собственными (soul 2.0, soul cinematic) А теперь самое интересное. Разработчики хигсфилда не только занимаются этими классными вещами, но еще и зарабатывают отличные деньги в долларах, получили щедрые опционы и ждут свои бонусы за топ-перформанс. А присоединиться к команде, и вместе делать топовых агентов для креативной индустрии можно тут: higgsfield.ai/careers
Глеб Кудрявцев — мастер AI
Пишу тулы для кодинга и упарываюсь по агентам. Лучший курс по AI кодингу ai.careerfactory.ru Статьи и переводы: vibeportal.ru Второй канал t.me/glebkudr Личка t.me/glebkudr1
-
-
edited 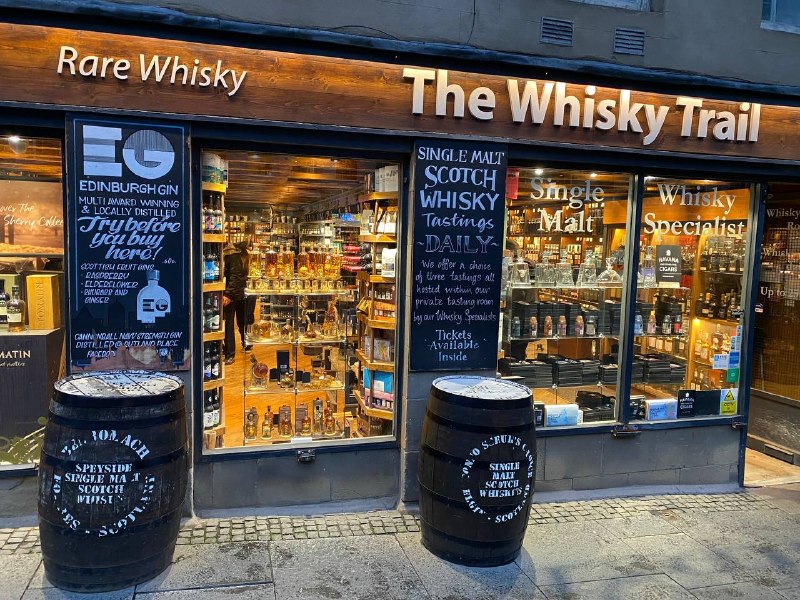
Тушу в Эдинбурге. Чуваков с открытыми ноутами на улицах и в кафешках не замечено. Видать, все уже сориентировались и накатили новый Кодекс на мобилки, лол, сомневаюсь, здесь все тупо бухают Дальше в Лондон.
-
edited Игрался со свободными TTS моделями (генераторы речи). Рекомендую https://github.com/fishaudio/fish-speech — более менее норм справляется с войс клонингом и русским языком. Не идеально, но где вообще идеально. Работает на M4 GPU локально. И нужно играться с настройками, как и для любых других сеток. Зато свое, и не надо за балансом в eleven labs следить. Для чего? Засуну в виде CLI в скилл кодекса, и когда нужно будет видосик переозвучить просто скажу переозвучь, и он сделает. Сейчас так сабы накладываю, а можно будет и вообще все подряд.
-
edited Гайд по выживанию в эпоху сокращений в индустрии. Сделал для вас перевод, могу засвидетельствовать — в видео нисколько не ирония, а 100% рабочий рецепт. Автор: https://x.com/atmoio
-
edited Недавно у двоих уважаемых мной авторов стал замечать нейрослоп в публикациях. При этом метрики растут — статьи явно получаются более цепкими. Но от обоих я сразу же отписался. Почему? Не хочу чувствовать себя свиньей в хлеву, которой наливают в корыто цифровые помои. То есть мне кажется, это максимальное неуважение со стороны авторского медиа — держать своих читателей за идиотов. И я убежден, что если так делать, то и останутся у тебя только идиоты. На фоне этого попытался сформулировать свое отношение к тому, где для меня нейросетевые публикации допустимы, а где я считаю их злом. Получилось вот что: Допустимо — художественный контент, поданный как художественный. Мне интересен сюжет, я развлекаюсь, Гарри и Баленсиага — вот это все. Туда же игры и тому подобное. Я не ожидаю от этого ничего серьезного и у меня не стоит вопрос доверия к авторам. Если мне весело — значит задача решена, ничего более. Допустимо — справочная информация и рерайт без синтеза (галлюцинаций), с явным дисклеймером или хотя бы без попыток выдать это за живого человека. С галюнами вопрос сложный, так как галлюцинации бывает трудно распознать, но это ответственность редактора. Допустимо — любые утилитарные документы и применения. Я их не буду читать, а засуну в нейронку, чтобы она мне их интерпретировала, и мы все сэкономим время. То же самое касается нейросетевых аргументов в спорах. Не вижу в них ничего плохого, если в них не перевраны факты. Допустимо — редактура для облегчения восприятия (закадровый голос, перевод), если информация ценная и сама по себе не просто нейрослопная жвачка. Недопустимо — любое авторское высказывание, что в тексте, что в видео. Я хочу видеть настоящих людей. Когда я читаю человека, то читаю личность, и для восприятия информации критически важен вопрос доверия. Это касается любых форм контента. Максимум — перевод. Недопустимо — якобы события реального мира, на самом деле нейрослоп. Любой канал или источник, разместивший такое, немедленно летит в бан-лист. Недопустимо — ... (дополняйте в каментах) Забавно, что это суждение вы прочитали от чувака который должен вещать про то, как роботы захватят мир и все такое. Да, конечно захватят. Но я хочу иметь четкое понимание, с кем именно я общаюсь, когда это произойдет. У меня на канале нет не будет нейрослопных текстов, даже когда они реально станут неотличимы от настоящих.Все длинные тире я ставлю руками там, где они должны стоять. Ибо я считаю нейросетевую писанину неуважением к читателям. Они тратят на меня свое время — это обмен на то, что я трачу свое, и так должно быть.
-


Нужно было доку поправить красивую. Мне агент сначала сделал PDF, я ему такой — это конечно классно, но как я буду редактировать? Он сделал HTML. А редактировать-то конечно можно, но неудобно! В итоге в один запрос сделал тильду на минималках. Правлю шаблон прямо в файле. Никаких дурацких гугл доков с фигмами. Красота!
-
edited Пятничное про стартапы Страшно не то, что практически любой AI стартап сейчас можно заменить скиллом в кодексе. А то, что скилл в кодексе будет работать лучше 😁 Заметил эту тенденцию в последние пару месяцев. Огромное количество компаний такими темпами пойдет на выход.
-
edited 
Не так давно писал про гугловский SynthID, причем в каментах кидали и оупенсорс проекты по его удалению. Так вот, твиттерские уже нашли аналог для img-2 chatgpt и без сомнения, его так же можно скоро будет удалять с картинок. Больше слопа богу слопа 🥰
-

Открываем людям неудобную правду 😁
-
Итого что пробовал за последнее время: Paddle все виды Chandra первую и вторую Infinity первую и вторую Dots Glm Deepseek ocr Тупо ванильные квены, гроки, опенаи, джемини и клоды. Ну и пайплайны со всем этим. Я какой-то гребаный профи в ocr становлюсь 😁 но мне нравится, что картинки красивые, в текстовых модельках как-то меньше души, что-ли. Очень творческая работа.
-
Кстати, ответ на загадку — чандра 2. Очень сильная модель, одна из топовых. Но два минуса — жрет не так уж мало железа — закрытая лицензия. Инди и мелочи можно, остальным за денежку Но в целом никто не мешает на ней другой трейн квена дистиллировать, что китайские лабы наперегонки и делают 😁
-
edited Современные OCR модели — это не только открытые веса ценный мех, это еще и изощренный промптинг + подбор параметров + подбор нужного железа для запуска. Поэтому когда идет разговор "да мы быстренько сейчас сами развернем", я просто желаю удачи 😁 Поигрался с https://huggingface.co/rednote-hilab/dots.mocr В бенчах топ. Но чтобы добиться результатов пришлось очень сильно попотеть с настройками. В стоке никак не захотела заводиться нормально. Но ничего, заработала. Интересная модель, на уровне чандры, но занимает поменьше места, и лицензия MIT. Думаю, включить ли ее в предложение на sotaocr.com Вообще, у меня там всего одна активная модель, и хотел добавить вторую помощнее. Но никак не могу выбрать. В модельках проблема, что они все очень разные, и одна показывает крутые результаты в одном типе задач. А другая в другом. Теперь вообще думаю, может нужно развернуть каждую и дать пользователям самим решать, какая им нужна? Но вроде как простота решает и мало кто хочет подбирать параметры, в т.ч. играться с разными моделями. Короче дилемма вот, думаю как поступить.
-
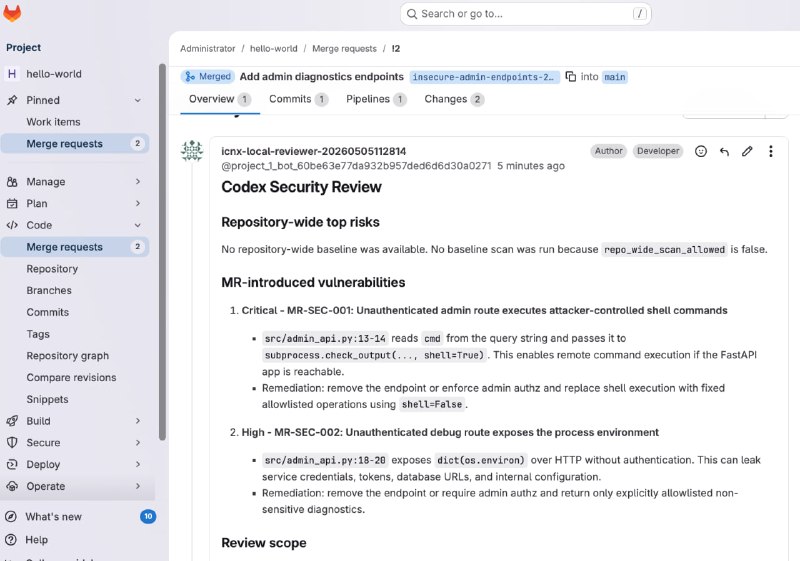

Мастер-класс у клиента За 4 часа развернул ревьюилку мердж реквестов из гитлаба на базе кодекса (headless exec вариант). Развернуто на VPS и при поступлении хука с гитхаба, автоматически анализирует на безопасность как конкретные изменения по реквесту, так и по всей кодовой базе в целом. CodeRabbit идет нахер вместе со своими энтерпрайз тарифами 😁 Аналогично можно собрать и для гитхаба (+ там в принципе есть встроенное ревью от кодекса в облаке) Но я честно сказать выдохся. Времени 4 часа, но устаешь как собака. Зато не скучно. И как раз в такие моменты очень наглядно понимаешь, куда смещается внимание с кода. В код не смотришь совсем, а вот на архитектуру, скилы, промпты и так далее — очень сильно. Туда и будет мигировать скилл разработчиков.
-
Спрашивают не первый раз — можно ли разрабатывать такие штуки на локальных моделях? Отвечаю: разрабатывать нужно всегда на лучшем, что вообще можно найти в мире. Иначе при начинающихся ошибках (они будут) вы не поймете — то ли нейронка тупит, то ли процесс вы придумали слишком заморочный. И вот когда это сработает, тогда уже вы придумываете как бы срезать косты, инференсить локально и так далее, короче оптимизируете.
-
edited Докладываюсь по flex пайплайнам — результаты охеренные Следите за руками. Пайплайн был с компьютерным зрением. Чертежи, стройка, все как мы любим 😁 Много листов pdf как-то связанных между собой (общей идеей) строительная документация это пиздец господа Я задал ограничение — работай исключительно с надписями/подписями. Не опирайся на ту информацию, которой нет текстом. Почему? Потому что заказчик так сказал, дескать проектировщики чисто с текстом тут работают и этого должно быть достаточно. Ну ладно. Сделал оркестр инструментов, зрительный пайплайн, индексатор, ретривелку и т.д. Машинка запыхтела обрабатывать и говорит — Хозяин, так и так — задача не решается! Я такой — в смысле не решается, думай Сеня. Ты поди тупой, вот и не решается, а как подумаешь, все сразу решится. Ну оно пыхтело еще пару раз с оптимизациями — и все равно. Нет говорит, нету у тебя таких-то и таких-то штук, а вот без них никак. А они выводятся только по чертежу, текстом их нет, н опираться мы имеем право только на текст. Я полез смотреть, сука, пришлось линейку достать. И в натуре нет. Не решается чисто по тексту. Нужно измерять чертеж. Это я со своей магистерской степени утверждаю уверенно. Смотрю доки заказчика — а там ошибка, реально данные неверные, по линейке другие получаются. Хер бы мне это такие результаты отдало в детерминированном пайплайне, я бы поди еще только ошибка парсинга json-ов после SO там разбирал. Так что следующий этап — будем с векторными фигурами работать. Я это уже проходил, то еще развлечение, но думаю, решаемо. В общем, пушка, прям классно выходит. Жаль скрины показать не могу — проприетарные. Но там красиво. Ну а мораль? Конечно же: заказывайте у Глеба нейросетевые рабочие процессы и пайплайны. Быстро, дорого, охуенно. Контакт в профиле канала 😁
-
edited Детерминированные пайплайны очень хрупкие. Отлаживать — боль, кто пробовал, тот знает. Поэтому решил по-полной расчехлить кунгфу кодекса на мультиагентах. Пока что главная фишечка — процесс-судья. Т.е. берем обычный оркестратор, но спавним его через материнский контролирующий процесс, единственная задача которого оценивать адекватность работы и следить за отклонениями. Интересно, смогу ли я на этом выстроить систему автокоррекции.
-
Взял себе новую тачку, гоняю!
-

Ну ладно, я сдаюсь
-

Я знаю, вам всегда хочется немного OCR Это качество можно гонять полностью локально. Если нужно — обращайтесь, устроим 👌
-
Дропнули подкастик на злобу дня о том, что и куда движется с нейронками. Можете послушать под пятницу 😎 https://www.youtube.com/watch?v=aYQFQopwzc4
- Older posts