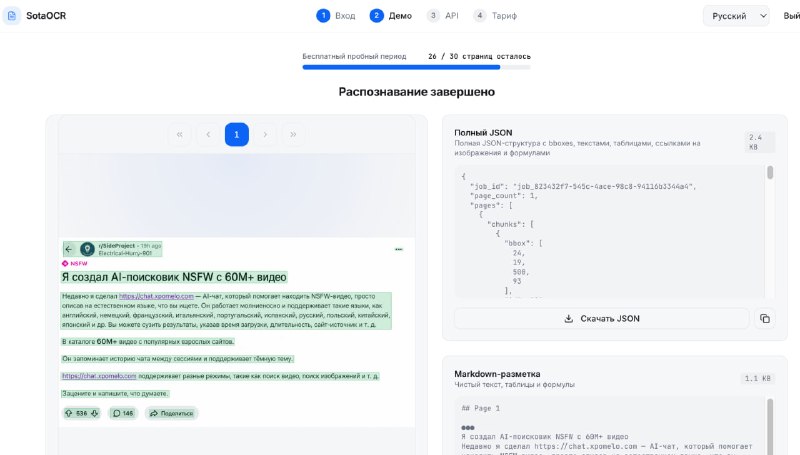
Обновил онбординг sotaocr.com Добавил генерацию 30 бесплатных страничек по апи. Расскажите, как вам?
Пишу тулы для кодинга и упарываюсь по агентам. Лучший курс по AI кодингу ai.careerfactory.ru Статьи и переводы: vibeportal.ru Второй канал t.me/glebkudr Личка t.me/glebkudr1
Обновил онбординг sotaocr.com Добавил генерацию 30 бесплатных страничек по апи. Расскажите, как вам?


Банана img-2 от чатгпт рисует как бог. Именно в практическом смысле. Хер с ней с фантазией, у нее очень круто получаются скучные макеты. Прям огромный лайк. Вот, попросил вкорячить энтерпрайз тариф. Результат на картинке. По-моему офигенно, я бы точно так не смог. Кстати, если вы еще не генерите сначала такие картинки, а уже по ним верстку — обязательно начните. Фигма не нужна, да и всякие клод-дизайны тоже.
Я настолько преисполнился TDD, что этап ревью встроил после написания тестов 😁 Итого, у меня сначала пишутся тесты, затем запускается агент-критик, который проверяет тесты на адекватность, а уже потом идет имплементация. Которая, как вы догадываетесь, завершается тестами. В целом — доволен, совсем перестали фичи в регресс уходить.
Помню, Валера говорил мне, что предпочитает кодить из-под терминала прямо на проде. Год назад это было. Я тогда думаю — фига гик, я вообще не из таких. И вот, кажется я познал этот дзен 😁 Из-под терминала нет, но кодекс у меня в прод/околопрод средах пасется значительно чаще чем в локалке. И понемногу начинаешь думать — так а нахрен я вообще с локалкой вожусь, реально же можно сразу на впс-ке орудовать. Завел себе стейдж и фигачь на нем что хочешь. Очень сильно этому способствуют эксперименты с GPU/локальными моделями, т.к. они типа локальные, но на десктопе-то карточек нифига нет, в итоге все запускаешь, тестируешь и т.д. удаленно. Забавно, как меняется мышление, когда в руках есть хороший молоток 🙂
Последнее время взял курс на оптимизацию подписок и каких-то левых затрат. Докладываюсь. 1) полный клон сайта из webflow и экспорт его пятым кулифай контейнером на дешманский vps -> 1 час работы, экономия 20 баксов в месяц. 2) переезд другого сайта вторым контейнером на другой дешманский vps -> экономия 60 баксов в месяц (он на жирном тарифе сидел про запас)😬 — 10 минут промпта, и дальше следить одним глазом. 3) ... пока не придумал, но явно огромное количество сервисов можно сейчас написать за 5 минут вместо того, чтобы покупать. Лишь бы помещались в дешевый хостинг, опять же, пятым/десятым контейнером. Короче, как на вайбкодинге зарабатывать это всегда вопрос открытый, а вот как экономить — дело абсолютно понятное и рабочее.
Искал тут, на чем развернуть работу с почтовыми адресами для стартапов. Докладываюсь — fastmail очень даже ок. За 5 баксов получаете до 100 ящиков на своих доменах + супер-понятный интерфейс, все просто работает. В Ру сегменте аналогов нет, яндекс почта это просто издевательство, там нужно получать магистерскую степень, чтобы хоть что-то настроить. Гугл туда же.

Запилил плэйграунд с историей сканов Теперь они не пропадают без вести, и всегда можно вернуться к прошлым. Место для хранения ограничил 100мб, но надо будет какую-то понятную сигнализацию сделать о механике работы и стандартном сроке хранения в 30 дней (а для кого-то и вовсе это убрать).
Сначала лэндинг, потом онбординг, потом пэйволл, и только потом можно делать продукт, товарищи. Так и только так 🙂 Это не значит, что в таком состоянии его нужно релизить или даже проверять (эпоха получения сигнала только лишь с лэнда кмк прошла). Это значит, что мыслить нужно воронкой продажи, и она вам сильно поможет понять, каким именно должен быть продукт.
Сделал для SotaOCR возможность развертывания на своем сервере — Никаких проблем с персоналкой, все у вас в контуре — Еще дешевле за объем, вплоть до 0.1р за страницу — удобный UX операторов + работа по АПИ внутри вашей сети — Помогу в запуске и развертывании нужных для вас моделей Модели кайф, я почти не встречаю того, с чем бы они не справились. Так и хочется все оцифровывать. Требования к железу: от 16 GB GPU Пишите в личку или sales@sotaocr.com, вышлю подробности, проведем пилот

Я знаю, я вас задолбал OCR-ами, но вы посмотрите, какая красота 🙂 Новая модель, какая — не скажу, секрет. Прекрасно справляется с рукописным вводом. Для этой модельки выцыганил у @evilfreelancer карточку 4090 на 48гб. Хотя я вам скажу, наверняка заведется и на 24, буду еще это выяснять. В проде пока нет, мб туда добавлю по x2 ставке кредитов, но это уже на сл. неделе.
Рассуждаю про прошку. Можете посмотреть вечером, хотя видосик очень короткий, так что можно и в любой момент. Энджой Смотреть на Youtube
Я когда-то делал челенджи и соревнования, так что поддерживаю репостом 👆 Если вы не только вайбкодер, но еще и любитель алгоритмов и математических баттлов, присмотритесь

🚀 Серия соревнований по МЛ и научный проект ! Денежный призовой фонд больше 150 000 р и будет расти ! Кому интересен МЛ/RL или математика или пазлы или роботы. Приглашаем Вас принять участие в серии челленджей и развитии научного опен-соурс проекта. Соревнование организуется совместно с учеными лаборатории интеллектуальных технологий робототехники МФТИ, (руководит проектом - Илья Осокин), которые поставили себе амбициозную цель создать робота, который побьет мировой рекорд по сборке Мегаминкса ! Узнать больше о робототехнической части проекта Вы можете в сообщении д.ф.-м.н. А. Арутюнова: https://t.me/forodirchNEWS/3165 , или хабре или чате @starkitmega. Проект CayleyPy предлагает Вам принять участие в решении алгоритмической части задачи - создании алгоритмов - которые смогут получать наиболее короткие (близкие к оптимальным ) решения. Методы решения важны в широком круге проблем от математики до квантовых компьютеров, МЛ/РЛ и теории струн. Для этого мы организовали соревнования на платформе Каггл. Первый Второй разыгрываемый приз - 10 000 рублей. Условия первого второго этапа очень простые. Есть три челленджа на Каггле Мегаминкс https://www.kaggle.com/competitions/cayley-py-megaminx/leaderboard Кубик Рубика 333 https://www.kaggle.com/competitions/cayleypy-ihes-cube Кубик Рубика 444 https://www.kaggle.com/competitions/cayley-py-444-cube Приз будет получен первым, кто достигнет ЛЮБУЮ из целей: 1 Или в конкурсе Мегаминкс - кто достигает скор 75 000 (вы получите 5 000 рублей, 70 000 ещё 5 000 рублей) и опубликует публичное решение. (Первая цель 80 000 уже достигнута. Приз уйдёт Владу Кузнецову, МФТИ). 2 Или обогнать Томаса Рокицкого в конкурсах по кубику 333 или 444 (любом из них) и тоже опубликовать публичное решение. (Томас Рокицкий - легендарный специалист по вычислительным аспектам головоломок - именно его команда нашла "число Бога" кубика Рубика в 2010 году - подведя итог более 30 годам усилий большого количества специалистов). Подробное описание соревнований -- по ссылкам выше. Кратко: даны 1000 состояний пазлов и Вам надо предъявить их решения -- чем короче решение тем лучше (то есть чем меньше шагов/"мувов"). Score на лидерборде = сумма длин решений по всем пазлам. Соревнования полностью аналогичны соревнованию Каггл Санта 2023 -- можно навайбкодить изменения лучших решений оттуда. Также стоит взять наш подход CayleyPy и изменить в нем образующие на мегаминкс. Это сделали те, кто сейчас в топе. Дополнительную информацию, обсуждение и советы - см. чаты - @starkitmega @sberlogacompete @sberlogasci. Вводные лекции: четверг 19.00, пятница 20.00 (время по Москве). Дополнительным призом будет возможное участие в научных публикациях. Наши цели амбициозны - мы уже добились исключительных результатов, которые имеют приложение в МЛ, математике, теории струн, квантовых вычислениях и т.д. Публикации отмечены NIPS spotlight. Узнать больше Вы можете в наших статьях. Если у Вас есть несколько свободных часов в неделю, знание Питона или математики и Вам интересно принять участие - пишите @alexander_v_c - мы рады всем - начинающим и профи. Планируется серия челленджей и призов. Первый приз уже разыгран, второй объявлен, скоро будут новые объявления -- оставайтесь с нами ! ================ А также мы ищем Cпоносоров. Вы можете поддержать нас переведя на карту Илье Осокину 2202208362030505 Или напишите @alexander_v_c (Александр Червов) И кидайте нам, пожалуйста, звезды на гитхаб, Вы нам очень поможите: https://github.com/cayleypy/cayleypy ================ Выражаем благодарность компании RYBE - толстовки для айтишников: https://rybe.store https://t.me/rybe_store ================ Выражаем благодарность агентству BLASTIM за поддержку: ❤️ Наши курсы: agency.blastim.ru 🥨 Свежие вакансии в биотехе: blastim.ru 🤝 https://t.me/blastim

Вы не можете этого отрицать Это я до пятерки и новой img-gen модельки добрался. Нравится и то и то.
Заддосили мне OCR 🙈 Сервис два часа плевался ошибками и ничего не распознавал. Разгадка оказалась проста. Когда я тестил, то у меня спокойно в карточку 24 гб влезало два экземпляра воркеров и vllm контейнеров для инференса нейронки. Короче, в параллель можно сразу две странички шатать. Так вот, оказалось, что там было очень на тоненького, и оставалось лишь 500мб места. И вот этого уже не хватило, когда туда стали одновременно слать большие картинки. А вообще, отлаживать что-то на ГПУ — то еще развлечение, скажу я вам. Особенно с китайскими моделями, у которых из работающей документации только какие-то манускрипты иероглифами, найденными в байдунете (я не прикалываюсь, ее без китайских доков вообще не запустить было). Это для тех, кто думает, что че там поднимать модельки, все просто же 🙂 Без кодекса, мне кажется, это было бы невозможно в принципе никогда. Так что нейронки тут конечно сильно повышают адопшн самих себя.
Я знаю, вы обожаете OCR модельки прямо как я 😁 А выходят они не реже, чем LLM, так-то. Фиг уследишь. Поэтому что? Правильно. Новая SOTA каждый день. На этот раз в рейтинге вылез Infinity Parser 2 Хорошо — полный оупенсорс, можно юзать для коммерции. Плохо — модель жирная, аж 35B, и чатик говорит, что жрет две видеокарты. Хз насколько правда, попробую может запустить на макбуке, но не особо верю в чудеса. В целом, из OCR топов почти все это VL модели, то есть архитектура LLM спецом приспособленная для зрения. Скорее всего они в итоге победят "аналитические" модели старой формации, а потом и вовсе сольются в едином экстазе со своими старшими ЛЛМ-комбайнами. Но важно: для OCR важна скорость, посему нужны мелкие дистилляты. Мой сервис сейчас имеет в ядре Paddle на 0.9B параметров, и это конечно совсем не то же самое что гонять жирные квены. Все баги вчерашнего дня, кстати, пофиксил. Работает четенько. Как попробую этот инфинити в деле— отпишусь.
Пожаловались, что ocr сервис не детектит ориентацию. 1. Включил. В апишке был метод. Легко. 2. Сломались превью. Они не были предназначены для повернутых объектов. Ожидаемо. Починил. 3. Сломались bbox (детект границ смысловых кусков страницы). Неожиданно. Крутил с агентом час, что не так. Оказалось, детект ориентации принудительно запускает нормализацию документа, которая включает в себя нелинейные преобразования (растягивание, сжатие), в итоге bbox отдаются уже в этих новых координатах преобразованной страницы. 4. Так как сжатия нелинейны, то нельзя отдать просто scale-фактор, а нужно переписывать апи, чтобы назад отдавалась нормализованная страничка целиком картинкой, и уже поверх нее рисовались валидные bbox. 5. Апи переписывается, а я решил написать пост в блог. -> вы находитесь здесь. Все это конечно наполовину на проде, где слава богу мало пока кто чего успел купить и активно использовать (но при этом конечно у кого-то отвалилось и он пришел законно предъявлять, что за нах) 😁 Люблю инди-разработку. UPD Если вы думали, что все, то нет. Детектор поворота еще и принудительно анварпит картинку. И какими же он их делает? Кривые документы — прямыми и прекрасными. А прямые документы — КОСЫМИ. СУКА. Продолжение следует.
Посмотрел по статистике — от идеи до релиза сервиса у меня проходит примерно 2 месяца. Прототип бывает готов за неделю-две, затем это доводится до ума, и последние две-три недели тратятся на публикацию/внедрение платежек и все такое. Сейчас фокус на том, чтобы не забрасывать на стадии релиза, а нормально поливать трафиком/внедрять, не бросаясь сразу делать новый продукт 🙂 И второе направление — решил больше функций внедрять в уже имеющиеся платформы, вместо орды микросервисов. Раз так долго занимает настройка и шлифовка обвязки, то неплохо бы ее переиспользовать максимально.
Ну наконец-то готов релизить OCR сервис sotaocr.com Что это? Это сервис распознавания документов. Грузите PDF, получаете распознанный json. По капотом лучшая OCR модель из имеющихся на рынке по цене-качеству. — Очень хороша в таблицах — Специально натренирована на математические формулы в LATEX формате. — Отдает честные границы объектов (LLM это делает как бог на душу положит). — Знает много языков Ограничения: — плохо работает с рукописным вводом. Для этого нужно усиливать модельку, знаю как — если нужно пишите, сделаю — я пока отключил распознавание картинок, работает только PDF. Планирую скоро включить. В общем, велкам пробовать. 30 страничек бесплатно, дальше можно закинуть денежку и пользоваться по мере необходимости. PS Если есть проблемы — сразу в личку пишите, поправлю. Не забудьте написать почту, под которой регались.