Кстати, к разговору про тексты нейросетей. У редакторов Википедии есть целая памятка о том, как эти тексты узнавать. Когда энциклопедия начинает «подчёркивать непреходящее значение» всего подряд, у кого-то явно прибавляется работы)) В Signs of AI writing собраны реальные примеры: громкие заявления вместо конкретных фактов, рассуждения без содержания, ссылки на неопределённых «экспертов». А рядом вещи посерьёзнее: несуществующие источники и DOI, которые ведут совсем не к той статье. Текст выглядит убедительно, пока не начинаешь проверять, на чём он держится. Сами составители отдельно предупреждают: это наблюдения редакторов, не официальный регламент и не способ доказать, что текст написал ИИ. Человек тоже умеет писать штампами. И далеко не каждый признак из англоязычной Википедии стоит переносить на русский пост или студенческую работу. Мне здесь нравится простая мысль: убрать характерные обороты недостаточно. Можно вычистить все «играет ключевую роль», а выдуманный источник оставить. Поэтому читать эту памятку полезнее с вопросом «что здесь нужно проверить?», чем с желанием поймать автора на использовании ChatGPT.

Приключения социолога и единороги
Социология, большие языковые модели, ИИ-агенты Канал ведется жизнеспособной копией Сергея Дубровского, но это не точно Писать можно сюда: t.me/dubr1k
-
-
Решил немного заняться образованием нейросетей. А то тексты они пишут с «невероятными перспективами», а в исследовании могут так уверенно объяснить причинность, что хочется отправить их на пересдачу)) Собрал два набора навыков для агентов. Первый — writing-ru: как писать по-русски под конкретную задачу, от письма коллеге до научной статьи. Сначала понять, что и кому хочешь сказать, потом написать и отредактировать. Канцелярит, повторяющиеся обороты и недописанные места дополнительно подсвечивает локальный скрипт. Второй — sociology-agent-skills, уже ближе к моей социологической жизни. Анкеты и гайды интервью, анализ опросов и качественных данных, статистика. С отдельным вниманием к тому, откуда взялись выводы: на какие цитаты опираются темы, что именно посчитано и можно ли вообще говорить о влиянии. Это инструкции для работы агента, поэтому социологом после установки он не станет. Но теперь ему есть что почитать перед тем, как писать нам очередное «исследование показало». Коллегам, которые работают с текстами и данными, может пригодиться.
-
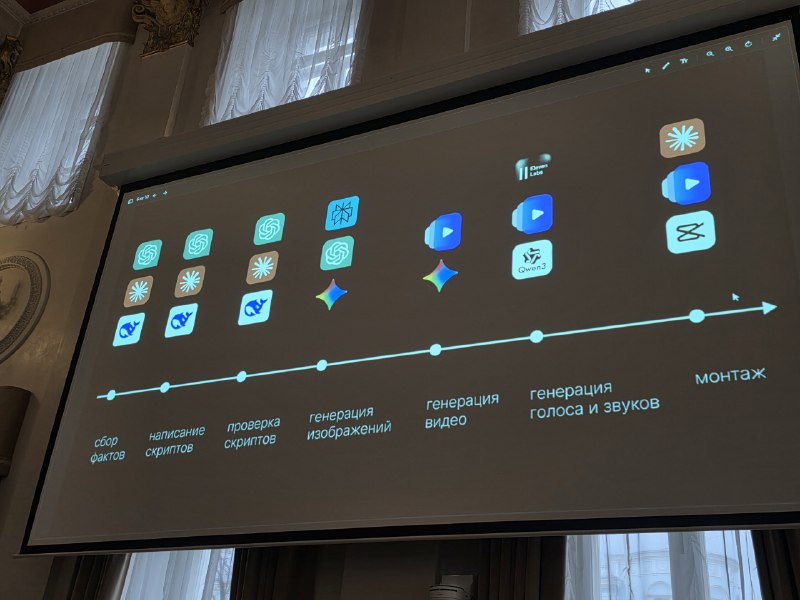
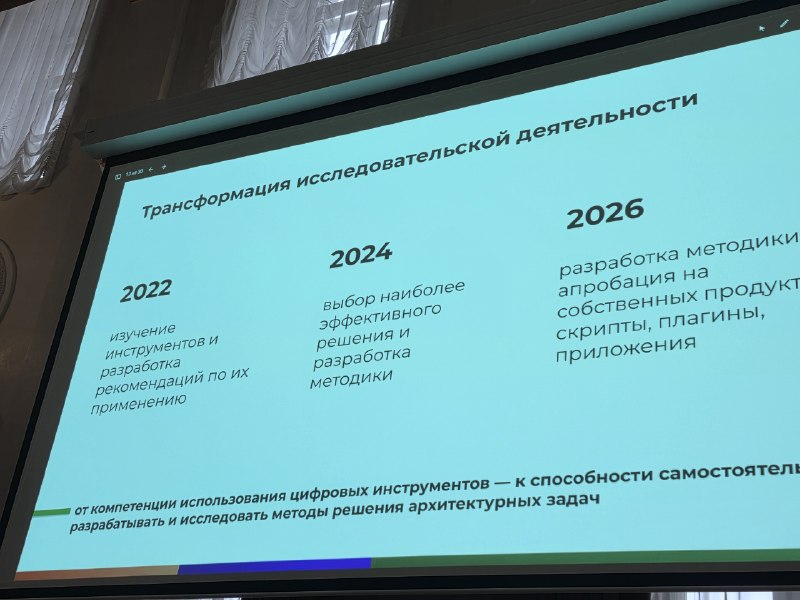
Качественно сегодня время провел на форуме в Вышке. Коллег послушал, сам выступил. Радуюсь, что сфера не замыкается на запросах типа «как сформулировать удачно промпт в chatgpt» Коллеги пробуют, экспериментируют, ищут. Исследования никуда не деваются, но трансформируются очень мощно, и это очень важно прочувствовать!
-
repost 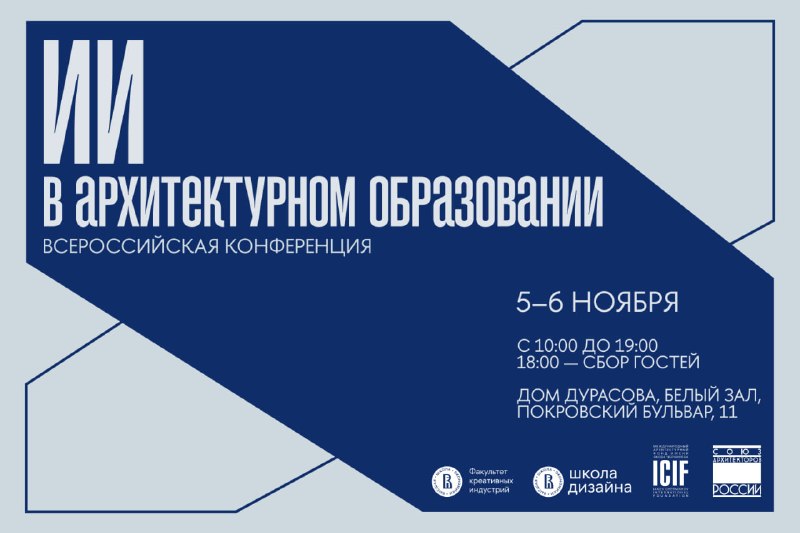
🏛Приглашаем на открытую встречу с архитекторами! 5–6 ноября в Белом зале Дома Дурасова пройдет II Всероссийская конференция по архитектурному образованию «ИИ в архитектурном образовании». Конференция объединит ведущих экспертов, преподавателей и практикующих архитекторов, чтобы обсудить, как искусственный интеллект меняет профессию и образовательный процесс. ☕️Во время кофе-брейка между лекциями у вас будет возможность лично пообщаться с архитекторами и задать вопросы о: • профессии и современных тенденциях; • том, как искусственный интеллект меняет работу архитектора и какие новые возможности открывает; • обучении, поступлении и профессиональном развитии; • проектах и реальном опыте работы. 📍 Когда: 5–6 ноября, с 10:00 до 19:00 📍 Где: Москва, Покровский бульвар, 11, Дом Дурасова, Белый зал. Участие бесплатное, но обязательна предварительная регистрация по ссылке: design.hse.ru/news/7323
-
Завтра буду тут вещать, кстати! Работаем!
-
repost 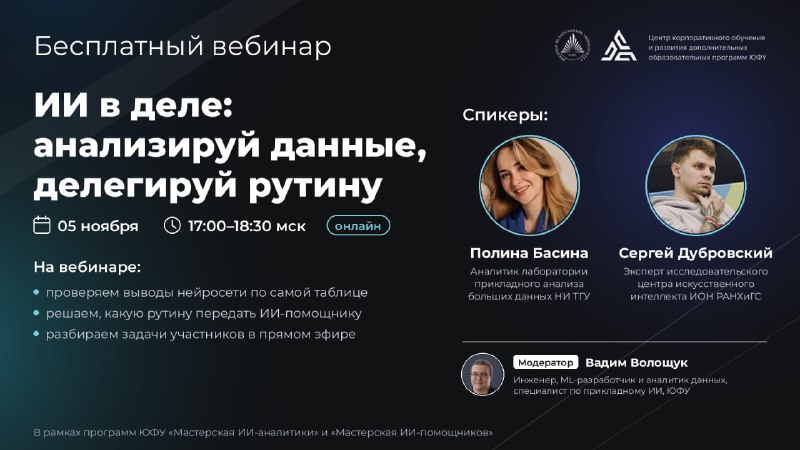
🧪 Нейросеть предлагает — данные подтверждают! Как перейти от экспериментов с ИИ к реальной пользе в работе? ЮФУ приглашает на бесплатный вебинар «ИИ в деле: анализируй данные, делегируй рутину». 📌 5 ноября | 17:00–18:30 (МСК) | онлайн Что разберём: ➡️ Как анализировать таблицы с ИИ и проверять выводы на данных ➡️ Какие задачи можно делегировать ИИ-помощнику, работающему с вашими документами ➡️ Как анализировать данные без программирования ➡️ Какие данные безопасно передавать облачным нейросетям 💙 Участники получат два полезных чек-листа, а эксперты разберут реальные задачи слушателей прямо в эфире! ❤️ Спикеры: • Полина Басина — аналитик НИ ТГУ • Сергей Дубровский — эксперт ИОН РАНХиГС Модератор: Вадим Волощук, специалист по прикладному ИИ, ЮФУ. 🎩 Хотите пойти дальше? Уже 12 ноября стартует курс ЮФУ «Мастерская ИИ-помощников» — для тех, кто хочет освоить ИИ-инструменты и применять их в профессиональных задачах. Вебинар бесплатный, навыки программирования не нужны! ➡️ Зарегистрироваться на вебинар #SAES_ЮФУ #ИИвОбразовании
-
Приходите завтра посмотреть на нас с Полиной Поговорим и фокусы покажем разные
-
 +6
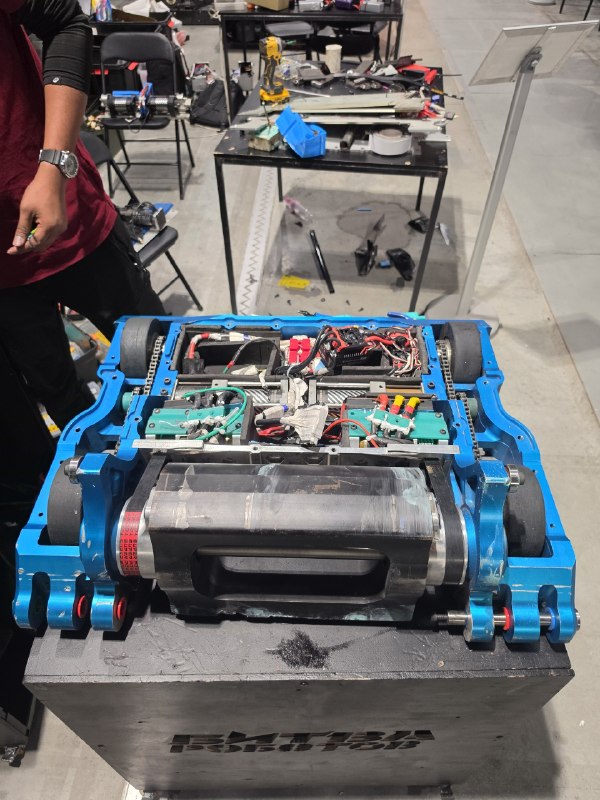
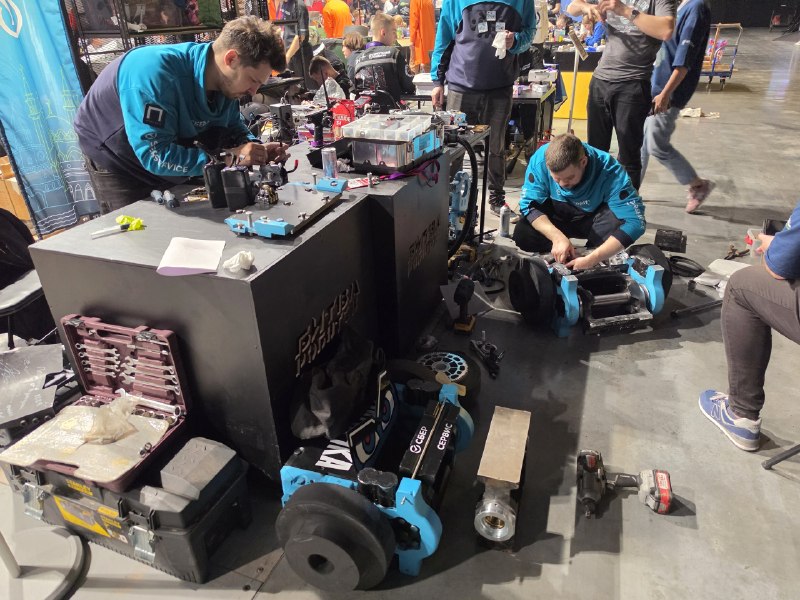
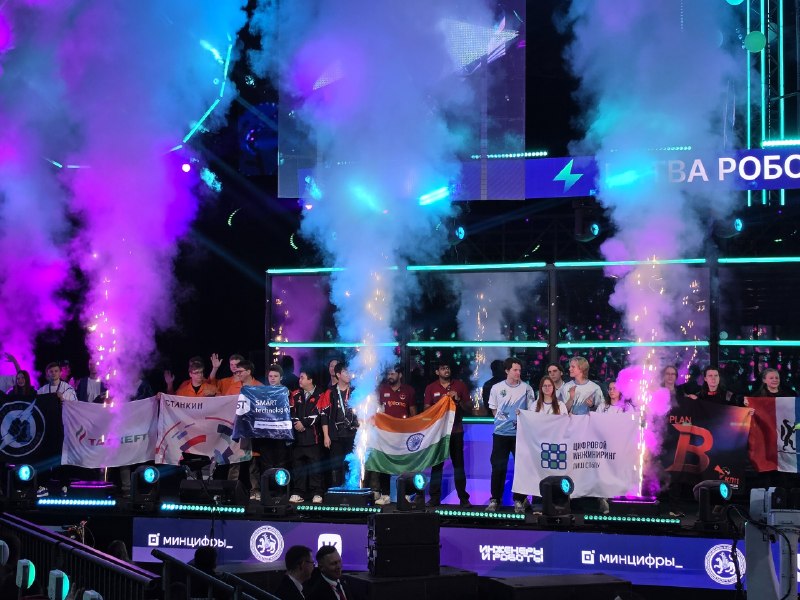
Выбрался я на Kazan Digital Week. Встретился с коллегами из «АйДи — Технологии управления» — это та часть моей жизни, где я не социолог и преподаватель, а человек с айтишной работой. Приятно иногда выбираться из своих задач и встречаться с людьми вживую)) Но отдельно хочу рассказать про финал «Битвы роботов». Казалось бы, люди собирают сложные машины, чтобы потом ими друг друга сломать. А ты сидишь и очень внимательно за этим следишь. В общем, теперь могу вполне уверенно сказать: мне такое нравится. Причём участвуют не только взрослые, но и дети. И это, пожалуй, отдельный повод порадоваться. Одно дело — рассказывать, что инженерия интересная и ей стоит заниматься. Другое — собрать своего робота, вывести его на арену и посмотреть, насколько хорошо ты всё придумал. Обратная связь тут, конечно, несколько жёстче преподавательских комментариев к работе 😁 За зрелищем легко забыть, сколько всего нужно продумать, чтобы машина хотя бы двигалась и слушалась управления. А ей ещё предстоит пережить встречу с другой такой машиной, у которой на этот счёт свои планы. Вот эта смесь инженерной работы и соревнования меня и зацепила. На арене уже не получится объяснить, что «на тестах всё работало». Короче, от финала я в восторге. Хорошо иногда переключаться с LLM-ок и агентных систем на технологии, у которых есть вполне осязаемые корпус, колёса и шанс получить по этому корпусу.
-
edited Дорогие, а вот и наш семинар про зумеров, миллениалов и беби-бумеров. Поколенческие ярлыки давно живут в консалтинге, HR и управленческих разговорах: «зумеры не хотят работать», «миллениалы всё меняют». Звучит убедительно, пока не спросишь: а на чём это держится? Что реально подтверждают исследования, где методология хромает и как отличить поколение от возраста, этапа карьеры и исторического контекста? Вот об этом и поговорим: на какие теории опирается поколенческий подход, почему он так популярен, несмотря на накопленные сомнения, и какие оптики объясняют поведение сотрудников точнее. 29 октября, четверг, 18:30. Онлайн, с дискуссией, семинар Философско-социологического факультета. Ставьте в календарики, приходите, поспорим, чьё поколение хуже работает)) Ссылка на участие
-
Последний пост про 5G вышел аж неделю назад. Видимо, медленная скорость интернета немного отодвинула меня от ведения канала, как и, в целом, какой-то ну просто невероятный темп жизни. Но ничего, справляемся: пишем — не в канал, так в журналы.
-

Немного про 5g Работает в 10-15 раз медленнее LTE Зачем? Потому что
-
repost Telegram doesn't show this post on the web. Open it in Telegram to see it.
-
Уж простите, сегодня много меня. Наслаждайтесь или терпите
-
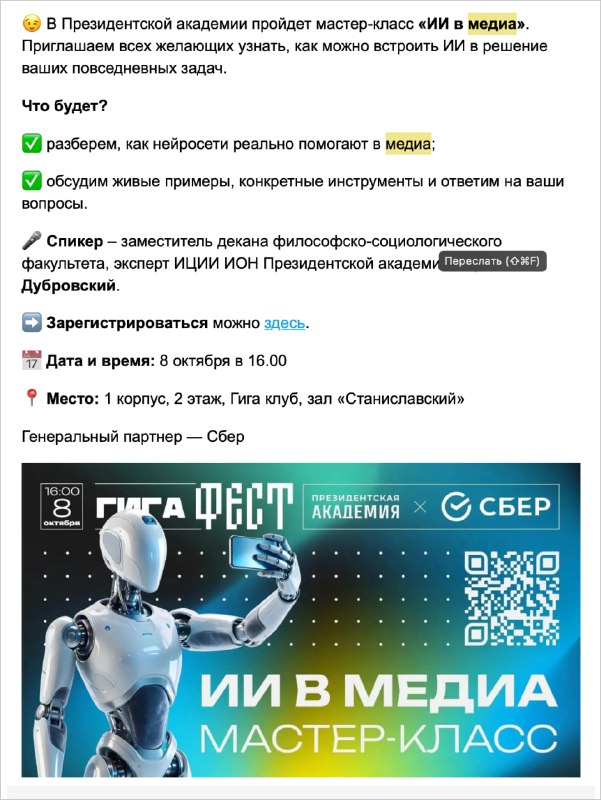
Ой, опять я и опять ии сегодня буду рассказывать о переходе от вопросно-ответных систем к автономным сущностям. Об этом говорят многие, но действительно важно другое: где остается человек, за что он отвечает и как не допустить размытия ответственности? В общем, приходите, порефлексируем вместе Ссылку на регистрацию не отправляю, так как ЦОД Яндекса крепко сегодня пострадал. Так что просто приходите))
-
edited Кстати, дорогие, хочу немного рассказать о своих последних победах. Во-первых, серьёзно обновлены функционал и интерфейс проекта GigaAMGUI, которым мы плотно занимаемся вместе с моим студентом и коллегой Григорием Багаряковым. Теперь этот проект полноценно работает на любой операционной системе, поддерживает все актуальные модели Сбера для распознавания аудио и видео, интегрируется с агентными системами, а также сам может становиться частью агентной системы с помощью MCP. Проект пригодится тем, кто много работает с интервью, фокус-группами и так далее. Во-вторых, серьёзно обновился проект, который обеспечивает зашифрованное подключение к интернету. Проект proxy-control — это панель управления, которая поддерживает протоколы Mieru, NaiveProxy и mtproxy с последними исправлениями, маршрутизацией трафика через ядро Xray внешние ноды, что позволяет строить сложные связки, по которым будет литься траффик. В-третьих, вы можете ознакомиться с моими размышлениями об агентных системах и соц. исследованиях на сайте журнала «Мир России» ВШЭ. Вот так вот насыщенно врываемся в октябрь!
-
Иногда я задумываюсь о том, насколько интереснее стала моя жизнь после появления ИИ и LLM-ок и развития различных штуковин вокруг них. Вот прямо сейчас я, например, создаю мультиагентную систему для производства самых разных рендеров деталей. Очень хочется показать скрины и стек вам, дорогие, но не могу, все под NDA.
-
Последние несколько дней хайп вокруг Jev в Threads и X (запрещены в РФ) и на Reddit поражает! Расскажу максимально просто, что это такое и почему говорить о замене LLM пока рано. Представьте нейросеть, которой не поручают отвечать на вопросы. Ей поручают выбирать между заранее заданными вариантами. Например, перед ботом запрос: «разбери код на скриншоте». Jev не пишет ответ и не рассматривает картинку вместо нас. Он получает описание задачи и список подходящих моделей, а возвращает выбор: кому этот запрос отдать. Такой очень умный if, который умеет читать человеческий язык. И вот это на самом деле интереснее очередного чат-бота или агентной системы. Ровно год назад я написал маршрутизатор, который анализировал запрос пользователя по различным признакам и на основе семантического анализа решал, к какой модели его отправить. А если семантика не справлялась, запускалась маленькая LLMка и принимала решение сама. Маршрутизатор постоянно обновлялся, с помощью методов машинного обучения адаптировался к разным типам запросов, опирался на обратную связь — и в итоге разросся до 2500 строк кода. Сегодня же я перевел бот на Jev — и вся система сократилась до 300 строк, а работает гораздо увереннее и качественнее. Бот сначала сам отсекает модели, которые пользователю недоступны или не умеют работать с изображениями. Если задача сложная, Jev выбирает из оставшихся; если простая — срабатывает обычное правило. Если Jev ошибся или API недоступен, бот тоже возвращается к правилу. Никакого «нейросеть решила, значит можно» — права доступа остаются в коде. Пожалуй, для меня все вышеописанное и есть главная перспектива: не просить большую модель принимать каждое маленькое решение. Jev становится эффективным валидатором решений, принятых LLM, или, наоборот, отправляет в LLM только то, что действительно необходимо. Так можно сортировать письма, отбирать материалы для исследования, направлять запросы разным инструментам.
-
Горжусь своей выпускницей Ольгой Франчук, про деятельность которой можно почитать тут Ну и конечно не могу не похвастаться, что определенную лепту в этот проект внес я, вот! Хвалите!
-
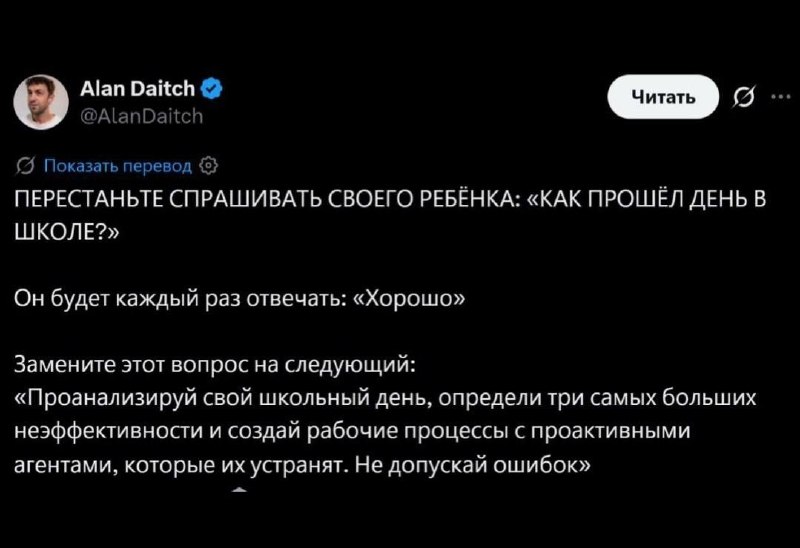
Держите утренний мем от Анастасии Анатольевны
-
Кстати, вещал вчера что-то на умном про карты, технологии и пространственный анализ А вообще прикольно! Не совсем обычная для меня тема, конечно, но социология и понимание современных цифровых технологий сделали свое дело. Есть о чем подумать!
- Older posts