
Здесь все? 📦 Тут. 😎 Ставим лайк, кто придёт. 👍

Жоский ИИ Дядя Твой личный поставщик AI 🦾🤖 Канал о мире интересного AI: теория, приклад и meme👾 Для связи @dealer_ai (реклама и консультации по AI для бизнеса). Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст РКН: 6348592885
Здесь все? 📦 Тут. 😎 Ставим лайк, кто придёт. 👍
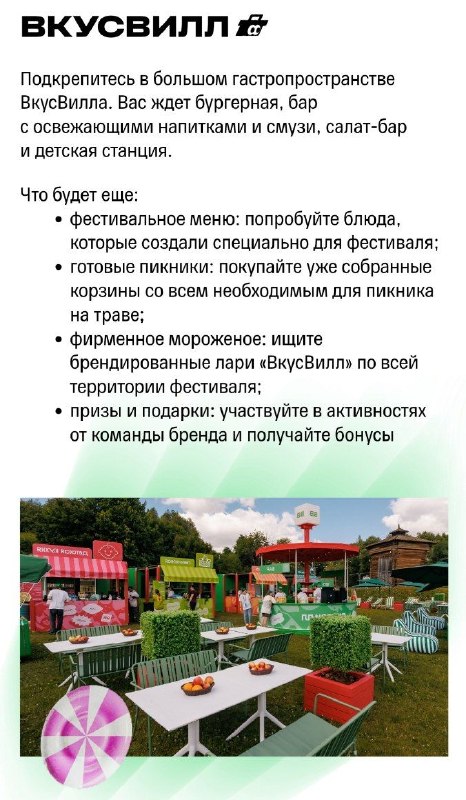
Скоро наступят выходные и у Вас будет шанс пообщаться с 📦 лично. Буду ждать Вас 8.08 на ИТ пикник от Тбанк, где в зоне отдыха ВкусВилл проведу небольшую открытую сессию ответов на вопросы (всего час времени). Начало сессии в 15-00. За лучшие вопросы даём мерч. 👍 Ждём Вас!
(document without text)
🕸 "не проиграл - он вышел из гонки ИИ добровольно"(с) С такого тезиса начинает автор статьи. Основные тезисы: 1. OpenAI и Anthropic вышли на петлю самоулучшения (RSI). 📈 RSI-концепция – модель А создаёт модель Б, которая создаёт модель В, и так далее по экспоненте. Их подход опирается на "горький урок" Ричарда Саттона: "грубая сила вычислений и масштабирование решают всё". 🧠 2. Сегодня те, кто сможет сделать модели топ уровня 2025-2026 годов, будут быстрее убегать от конкурентов и их уже будет сложно догнать. Это и есть "скорость убегания" (escape velocity) – скорость, необходимая, чтобы вырваться из гравитационного поля планеты и не упасть обратно. 🪨 Китайцы молодцы, но что же делать любителям суверенов и нац моделей. 😩 3. Google при этом "стоит в стороне" PR компаний Anthropic и openAI с RSI, но делает экзистенциальный выбор, цена которому или всё или ничего. Что это за выбор? Помимо удержания лидерства в поисковых технологиях и обучении своих LMок. 1. World models и VLA. Модели позволяющие имитировать и ориентироваться в физическом мире. Пример, Genie 3 – интерактивная модель мира, которая генерирует играбельные среды с интуитивной физикой. Это все то, что бустанет робосистемы и автопилоты на новый уровень. 2. Альтернативные архитектуры, нежели трансформер. Гуглы верят, что текущие модели предсказания следующего токена терминальная ветка. 📦 бы конечно добавил сюда диффузионки, JEPA парадигму и др, как потенциальные. Что они тогда имеют ввиду? Узнаем. ⏰ 3. Упор на AI for science и DeepMind. Проекты по сервисам для исследователей Co-scientist, модели AlphaFold3, Evolve, Genome и др. Итог. Это не соревнование моделей. Это битва двух теорий развития ИИ: · RSI → быстрая, но рискованная экспонента. · World Models → долгая, но фундаментальная игра. Что победит – узнаем через пару лет. А пока следим за архитектурными релизами DeepMind, и читаем презентацию с моего выступления на Urban ML conf во вложении ниже 👍
Я «отпилил» себе две ноги, чтобы стать senior tech manager’ом Мой руководитель в одном из интервью очень точно подметил динамику карьерного роста в корпорации: «чтобы перейти на новый уровень управления тебе нужно отпилить себе любимую ногу, которая тебя делает успешным на текущем уровне, и отрастить новую». Я очень люблю эту метафору именно за точность ощущений в процессе. В инженерных профессиях подавляющее большинство руководителей начинают линейными инженерами. Ты набираешь экспертизу, все ловчее справляешься со все более сложными проблемами, и вот однажды, тебе предлагают (или ты сам принимаешь решение) стать тимлидом. И в этот момент очень важно не обманывать себя: тебе предлагают много денег за то, что ты начнешь постепенно терять свою хардовую экспертизу, все больше погружаясь в организационные вопросы. Взамен ты получаешь проявленность в организации и больше власти. Худшее, что можно сделать в этой ситуации: это попытаться усидеть на двух стульях. Именно в таком сетапе рождаются микроменеджеры с пачкой джунов, которые «в соло держат небо на плечах». Не буду расписывать к чему это приводит, думаю вы и так таких ребят встречали. В крупных технологических компаниях это отлично понимают, и там есть понятие «терминального грейда», выше которого расти не обязательно - можно работать и заниматься любимым делом. А иногда и полезно вернуться на этот уровень из менеджмента, чтоб освежить тех скиллы (сам такое практиковал - жив здоров). Этот фазовый переход с отпиливанием инженерной ноги оканчивается примерно на уровне мидл-менеджмента, где ты уже ведешь группу команд. Ты уже окончательно попрощался с чисто-инженерными вопросами. Ты гораздо более силен в управлении людьми и проектам, становишься лицом крупных инициатив и на контакте с ключевыми бизнес лидерами. И после нескольких крупных побед в полный рост встает новая развилка. Выход в senior-level менеджмент предполагает очень важный сдвиг роли: тебе нужно уйти на вторые роли в конкретных проектах, и дать дорогу новому поколению лидеров. Теперь у тебя нет никакой возможности схватить штурвал инициативы и вытащить ее из канавы (потому что в это время на твоем уровне начнут решать вопросы без тебя). Твоя цель здесь - это сводить капитал с людьми, которые в состоянии его приумножить. Создавать для этого условия и управлять рисками. Уходить от ручного управления талантами в сторону создания систем, которые сами подымают талантливых людей вверх. Теперь нет никакого «твоего» успеха. Есть только успех твоих ребят. Это на самом деле очень сложная перестройка, от которой иногда нужно осознанно отказываться. Например, когда ты еще чувсьвуешь, что ты хочешь побыть на первых ролях в интересных тебе проектах ради опыта/портфолио. Или ты в принципе чувствуешь в себе драйв быть на острие классных продуктов и инициатив с возможностью сказать «я это сделал». Причин может быть много, но как и в прошлый раз попытка усидеть на двух стульях приведет к полному разочарованию. На мой взгляд правильная мотивация здесь - это искреннее желание поделиться опытом и взрастить людей, которые через какое-то время могли бы занять твою текущую позицию. Тогда новый уровень дохода поможет закрыть бытовые вопросы и даст больше уверенности в будущем, а сложности политики, стратегии и бюрократии будут понятной ценой, которую ты платишь, чтобы вырастить крутых лидеров.
Интересный случай продажи кота в мешке под соусом новой нац.модели. Открываем неделю с поста рубрики #ИИзнанка 😜 Да, да, знаю, что вышел Kimi3, читаю техрепорт, обзор будет позже. 📦 Вышла итоговая правка закона о развитии и поддержке суверенного ИИ. Максимально похудевший, где возможно, от фрейминга закон, дал почву бодрым кобанчикам для спекуляции в открытом поле. Теперь все пытаются залезть в нишу моделей среднего размера и назваться гордым именем "национальной" всея 🎉. При этом цимис понятен, b2g рынок (и бюджеты) - это золотая жила, прикоснуться хотят многие, однако можно случайно пойти по пути автоваза. Расскажу замечательную свежую историю о том, как не попасться на пустые инвестиции бодрым кабанчикам и что проверять, если вам предлагают "аналоговнет" за ХХмлн енотов. Кейс. Приходят к вам ребята с просьбой посмотреть на интересный проект и оценить потенциал инвестиций. Вы открываете презентацию и КП. А там: предлагаются новые модели, заявляется отличие от всех типовых transformers архитектур на рынке (llama, Qwen, Saiga, Vikhr и тп). При этом, заявляются размеры 9b, 35b, 122b; размер контекста более К млн токенов 🚬 Модели первой волны уже прошли К этапа обучения из М, но уже сопоставимы результаты с Claude 😜, но требуют дополнительных ХХ млн руб. (не млрд) инвестиций, чтобы показать всем кузькину мать и таки выйти на М этапов 💪. История собирательный образ, несёт образовательный смысл и все совпадения случайны. Итак, что вы должны сделать, чтобы провести фаст аудит: 1. Проверить размеры открытых популярных моделей на обнимашках. Тут мы видим, подозрительные совпадения с семейством Qwen 😐. А нам заявляют, что аналогов нет. Задумались. Ладно может совпадение и перед вами генИИ отрасли. Тогда идём к П2. 2. Просим тех.документы/добавить в репо/ссылку на патент или статью, или иную доказательную базу, естественно, под расписку, а лучше под NDA договор. Также важно запросить состав команды и их mindset, будет странно, если ребята делали раньше условный рексис, а сегодня они сами уже запилили грамотно К этапов обучения LLM, да так успешно, что аж на уровне Claude моделей. Не дают? Очень странное, ну может решают перестраховаться и мы идём к П3. 3. Допустим, вы понимаете, что модели аналоги Qwen, тогда в соответствии с scaling laws вы должны понимать сколько нужно пролить токенов данных, а значит шагов моделей на GPU, чтобы получить оптимальную сходимость для 9b,35b,122b. Те ваша модель на выходе будет адекватно работать. Отсюда же, вы можете посчитать сколько надо 💸 - это самое важное. Тут и спросите за бюджет, сколько gpu нужно, чтобы модель прошла все оставшиеся фазы и была prod ready, ну хотя бы MVP/PoC. Сколько токенов, gpu часов и тп. И увы если ХХХ млн не вписываются в создание заявленного числа параметров модели, gpu и gpu часов, то... В общем, получив такой чеклист, далее решать вам. 👍 Уже не говорю о том, что если внезапно это Qwen или аналоги, зачастую в открытом доступе уже лежат full обученные модели, прошедшие все этапы обучения, и сделать ещё сверху серьезный posttrain, расширить словарь и ничего при этом не сломать, требует компетенций и ресурсов. 😐 Удачи и stay tuned. 🦾 #ЖизаДня, #ИИнфоцыганство, #ДоверяйНоПроверяй А какие вы кейсы видели на своём опыте? Пишите в комментариях. 👇👇👇
#meme #выходной #ИИюмор

Если подумать, на многие известные популярные порталы ведутся атаки с помощью ИИ. Об этом мало говорят... Но именно сейчас в момент появления Fable, Mythos, внезапно, неожиданно, раскрывается атака на HF. С помощью продвинутой версии Sol модели... Больше хайпа, богу хайпа... Никак кроме, как пиар ходом это не назвать... Ждём ответку от китайцев или антропик. Мы продолжаем качать пузырь в эхо камере. 🚬 Все это, чтобы набрать классы (с) Upd. P. S. HF портал открытых моделей и логично, что закрываться будут публичной моделью китайцев. Это не только пиар китайской модели, но и в первую очередь защита OpenSource стратегии HF. 🧠
Вот именно по следам этих кейсов и не только авторы статьи выше предлагают подход к оценке пользы от внедрения ИИ. OpenAI предлагает перейти к инженерному подходу - измерять не затраты на ресурс, а эффективность преобразования ресурса в полезный завершённый результат. В центре стоит метрика "полезный интеллект за доллар", которая раскладывается на четыре вопроса. Каждый вопрос - это не просто пункт в отчёте, а целая система сбора данных и принятия решений: 1. Выполняет ли ИИ действительно важную работу? Первый шаг - перестать измерять активность и начать измерять результат. Ценность создается не количеством сгенерированного текста, а завершенными полезными действиями. Важно "определение завершенности" для каждого бизнес-процесса. Тот самый эффект который я называл ещё в 2019ом value в бизнес ноде. Например, для отдела продаж полезной работой будет не "сгенерировать 100 писем", а "отправить клиенту финальное письмо, которое утверждено руководителем". Это меняет фокус с процесса на результат. 2. Сколько стоит одна успешно выполненная задача? Это самый технический и важный пункт. Забудьте про цену за токен, она обманчива. Нужно считать полную стоимость одного принятого результата. И тут как раз вы можете фиксануть ROI, как я говорил выше. Формула простая: (Стоимость API-вызовов + Время персонала на промпты и правки + Время на проверку + Стоимость инфраструктуры) / Количество задач, принятых без доработок. Дешевая модель может давать много ошибок, требовать постоянных правок и в итоге обойтись дороже, чем более дорогая, но точная. Именно поэтому OpenAI выпускает GPT-5.6 с тремя моделями: Sol (для сложных задач, где ошибка дорога), Terra (золотая середина) и Luna (для рутинных операций). Выбор модели - это всегда поиск баланса между ценой и качеством конечного результата. Снова привет fusion или Fugu для оркестрации. 3. Можно ли доверять результатам? Этот вопрос напрямую влияет на стоимость. Чем выше доверие к ИИ, тем меньше времени тратится на проверку. OpenAI выделяет тут три уровня зрелости: · Черновик. ИИ предлагает вариант, человек все перепроверяет. · Поиск и рассуждение. ИИ находит информацию и строит цепочки, но решения принимает человек. · Автономное действие. ИИ выполняет операции сам (отправляет письма, вносит данные). Для перехода на новый уровень нужно измерять доверие. Классифицируйте каждый ответ ИИ: · Зеленый – принят без изменений. · Желтый – требует легкой правки. · Красный – полностью переделан. Если доля "зеленых" ответов растет, значит, доверие повышается, а стоимость контроля снижается. 4. Растет ли ценность при масштабировании? Последний вопрос – про динамику. Даже если сегодня все хорошо, нужно следить, не ухудшается ли экономика при росте объемов. Ключевая метрика: Эффективность = Объем полезной работы / Совокупные затраты на ИИ Неплохая замена ROI в моменте, этакий аналог биржевого индикатора. Если вы увеличиваете использование ИИ в два раза, а затраты растут тоже в два раза - вы на месте. Если затраты растут медленнее - вы в выигрыше. OpenAI утверждает, что их модели постоянно улучшаются, а стоимость снижается. Но компаниям все равно нужно вести собственный счёт – собирать данные по каждому процессу и регулярно пересчитывать эффективность. Вот вам и новые задачи вашим аналитикам. 👍 Практический чек-лист для внедрения от OpenAI: 1. Выберите 3–5 ключевых процессов, где используется ИИ. 2. Для каждого четко определите «завершенную задачу». 3. Начните собирать данные о всех затратах (не только API, но и время сотрудников). 4. Ведите классификацию ответов (зеленый/желтый/красный). 5. Пересчитывайте стоимость за задачу и сравнивайте разные модели. 6. Раз в квартал оценивайте динамику эффективности. А как вы оцениваете вклад ИИ в своих проектах? Делитесь опытом в комментариях 👇👇👇
Время на "мы просто пробуем ИИ" уже закончилось. Как измерять реальную ценность от внедрения ИИ? Именно с этого отрезвляющего тезиса стартует статья от OpenAI. Теперь вы не можете как в 2023-2024, а кто-то все ещё сейчас просто экспериментировать ради любопытства, сегодня ИИ - это реальная производственная мощность, и нужно её измерять также, как электроэнергию или выч ресурсы. 📦 помнится, как оценивали качество от автоматизации ручных процессов или поддержки с ИИ: 1. Общий трафик DAU, MAU, WAU и тп. 2. Интерес, через возвращаемость ака retention rate. На самом деле, не так важно, что в первый день запуска вы вывалили большой трафик, как то, что если сервис полезен к вам будут возвращаться снова и снова. 3. Число принятых подсказок с ИИ - ака acceptation rate. К примеру, вы работаете с ИИ суфлером или код агентом копайлотом и вот число принятых подсказок по ответу оператора или коду можно было измерить так. 4. Польза в конечной бизнес ветке или ноде. Если вы работали с сценариями поддержки, на самом деле, автоматизация должна считаться не только числом закрытых вопросов в чате без перевода на оператора, но и измеряться закончился ли диалог на самом деле решением проблемы пользователя или он через час снова придёт с этой темой в чат (а тут уже retention rate работает против вас). Да это можно проксировать через CSI, NPS, но в век LLM и агентов можно верифицировать и без оценки человека, достигнуто ли было намерение юзера и решена проблема с которой он придёт. А ещё у нас была система штрафов за возвращаемость юзера по проблеме ещё раз в чат или к оператору. 5. Фин эффекты в лице ROI. Тут просто (на самом блин деле, ни фига не просто) отношение прибыли к затратам на ИИ сервис, фичу, решение, проект и тп. - скок заработали к тому сколько потратили на разработку, аммортиазцию железа и токены на эксплуатацию. Обычно измеряется в %, умножаетсы естественно на 100. Однако помимо этого, мало посчитать таким образом потенциал, ещё нужно посчитать срок окупаемости. ROI показывал, что мы имеем такой потенциал, а срок окупаемости за какое время мы его можем достичь. 6. Рост эффективности труда. Вот моё "любимое", что над именно считать на сколько уменьшится время на выкатку фичи, сервиса, продукта или нового кода/программы, ускорить принятие решения и тп. Ака Lead Time, Time to Market и аналоги. И да современный ИИ тут помогает. Почитали? Интересно? А теперь забудьте все не так радужно. Начну с ROI прям сразу - компании не умеют, а некоторые оунеры решений и не хотят считать это честно (не в смысле врут, а в смысле не все переменные учитывают). Часто в текущей реальности заканчивается оценкой скорости а-ля ТТМ, но никто не хочет посчитать деньги в конечной бизнес ноде. К примеру, вы смогли автоматизировать аналитику, сказали что ускоритель на К%, но почему-то не получаете оценку оборачиваемости капитала или out-of-stock (упущенные продажи) в денежках, на которые и повлияет ускорение принятия решения от внедрения ИИ. Но окей, вы посчитали это, но в знаменатель забудете положить кроме фот на разработку, ещё токен экономику и аммортизацию ваших мощностей (если они онпрем). Почти все не понимают, сколько токенов они будут кушатс. На самом деле, ну и не должны, вопрос ж в динамическом изменении этого, особено с МАС под капотом. Но раз тут у нас динамический показатель, то ROI не будет фиксой, как и поправки в срок окупаемости придётся вносить. Ну и мякотка, все хотят на старте это посчитать, а в вводных выше мы понимаем, что посчитать можно только по факту в начале (порой пальцем в небо) или за период (на конец отчетного), а без этого даже стартовать порой отказываются. Второе любимое это про экономию на ФОТ через автоматизацию. Ну тип дали людям огонь Claude Code и ща кааак начнём сокращать разрабов и экономить на дорогих манки кодерах. В итоге хороший agent developer с инструментом на max подписке кушает за себя и за Сашку. Те вы почти не экономите на ФОТ, тк сопоставимо тратите на токены.

Gemma4 техрепорт и честный omnimodal на 12b от 🕸 Вот ждал 📦, что будет пример в лоб, как кодировать без предобученных бэкбонов аудио, видео и картинок информацию и кидать в модель. Это и есть настоящее omnimodal, тк multimodal работает именно с доп моделями в своих модальностях + слой проекции. 😮💨 Ребята из 🏳️🌈 с выходом Gemma4 зарепортили инфу о такой модели. Теперь информация с разных модальностей кодируется напрямую в матрицы и проходит всего лишь слой эмбеддингов внутри модели без доп внешних clip'ов и тп. Почитать можно в тех репорте тут. 🤙 Как это работает детально: 1. Изображение. Не используется ни vit, ни clip, ни resnet. Только патчи 48x48х3 (rgb канал 🧠) в нарезке серией. После выпрямляется в flatten и эмбедится в плотном слое (чисто факторизация а-ля как в SVD и als). 2. Аудио. Никаких мелспектров, а только сырой PCM сигнал. Нарезка также по 40мс частотой 16кГц, выпрямление и снова проекция. Все это порождает эмбы токенов картинок и аудио, которые кормятся в слои внимания вместе с текст эмбами. Важный нюанс с позицией: Чтобы модель знала, где находится патч, инженеры не используют сложные 2D-RoPE эмбы. Они добавляют факторизованные координатные вложения - отдельные обучаемые векторы для координаты X и координаты Y, которые просто прибавляются к полученному токену картинки или звука. 🧠 Upd. Почему это все работает, но так просто и в лоб??? Да все гениальное просто, также, как с рексисом на матричной факторизации, дело в объёме проливаемой датки и подборе размеров слоев вложений. А далее уже дело больших данных и чисел. 💪 В общем, для меня это было самое интересное. Тк в остальном в мире уже видны лучшие практики, которые комбинируй как можешь: и по локально-глобальному вниманию, и по sparsed attention, и хаки с KV, rope, скрытое рассуждение (только тут оно не в латентах, а тупо скрывают тексты от юзера), и обобщенные слои с early exit для MTP (multi token prediction). Итого, читаем. Образовываемся и stay tuned 🦾
Мы начинаем наш стрим "Харнесс будущего. Какой он?" Подключайтесь: https://youtube.com/live/LAUdN1-4mgI
Начинаем
Деньги надвигаются на тех, кто строит под агентов физическую инфраструктуру и обслуживает ее Суть нового бизнеса - предоставлять «ИИ под ключ» как инфраструктурную услугу. Осилить можно даже в одиночку при наличии соответствующих навыков. *с начала 26г. спрос на специалистов в аппаратной инженерии взлетел на 52% Провести аудит: что клиенту выгоднее с учетом его объемов использования ИИ. Подобрать и поставить железо, развернуть локальную модель, подключить её к корпоративным базам данных, настроить роутер с маршрутизацией (для распределения запросов) и все это взять на абонентское обслуживание Спрос на свою инфраструктуру растет, железо дорожает и тенденция минимум сохранится до 2028г. Акции IBM обвалились на 25% и их глава признал, что недооценил переориентацию клиентов с софта и консалтинга, в сторону железа. Теперь деньги идут прежде всего в физическое - чипы, память, охлаждение. Bank of America назвал это «переходом свободного денежного потока от одного поколения компаний к другому» ___ Из-за дефицита на рынке памяти страдает конечный потребитель компьютеров и смартфонов. В конце июня Apple подняла цены на Mac и iPad, сославшись на дефицит компонентов. К концу 2026 года DRAM и SSD подорожают примерно на 130%, поэтому средние цены на ПК могут вырасти на 17%, а на смартфоны на 13% Бизнес видит дефицит и старается заранее обеспечить себя вычислительными мощностями, закупая оборудование впрок. Корпоративный спрос на локальные системы можно наблюдать на заказах Dell. Dell за квартал получила 24,4 млрд долларов заказов на ИИ-серверы. Портфель невыполненных заказов достиг 51,3 млрд, число клиентов превысило 5000 Dell продаёт не просто сервер, а с гибридными системами охлаждения. Вы буквально привозите эту стойку, закатываете ее в обычную подсобку, подключаете к сети и всё А иногда достаточно одного Mac В малом бизнесе инфраструктура может быть ещё компактнее. Например, бизнес кейс IceRock Development. Поставили компании «Искра Телеком» один Mac Studio M3 Ultra, развернули Qwen и встроила локальный суммаризатор в рабочий трекер Похожий бизнес уже активно набирает популярность в США. Компания с одним сотрудником - покупает и настраивает Mac mini в офисах юристов и строителей с локальными моделями и берет на обслуживание

FRIDA все ещё хороша, как эмбеддер для вашего RAG. 📦 Теперь и на rusBEIR 🚬 💪 Всегда говорил, всяким там типа разрабам местных LLM – вот вы тюнинг делаете под бенчи, ругаетесь, что там, где вы не в топе, не вы проиграли, а бенчи плохие. А мудрость в том, что хорошие модели на любом бенче, даже на самом сомнительном (RusBEIR разумеется не такой) стабильно в топе - эт и есть мастерство. 😎 FRIDA, кстати, уже была скачана более 2млн раз. 💅 #ИИзнанка, #ГордостьДня
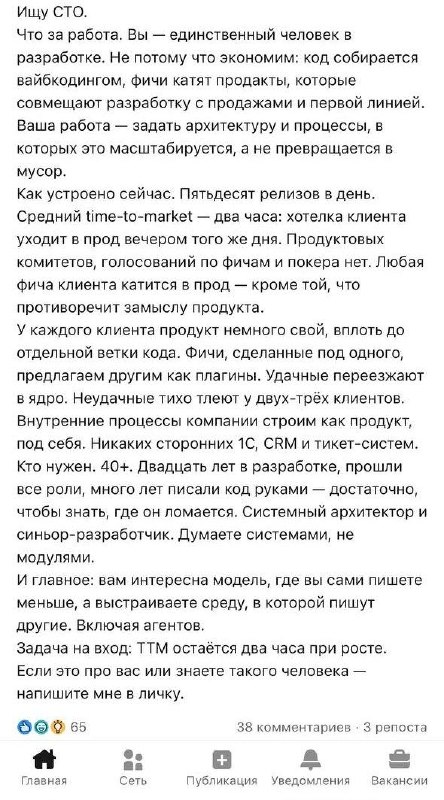
#жизадня #красныйокеан #вакухадня

#meme #жиза
Нейросети превратили найм в лотерею 🎰 И дело не в том, что LLM помогают проходить собесы. 🪨 HackerRank выложили в открытый доступ систему для оценки резюме при помощи ИИ. Инструмент стал невероятно популярным среди рекрутеров. Программа парсит файлы и скармливает данные языковой модели для выставления баллов резюме. Учитываются навыки, опыт работы и личные проекты на GitHub. Звучит как отличная автоматизация скучной рутины. 👍 Однако, один разработчик решил проверить систему и прогнал своё резюме несколько раз подряд. Результаты оказались пугающими. Совершенно идентичный файл получал оценки от 74 до 90+ баллов. 🚬 При проходном пороге в 85 баллов кандидат получает отказ просто по воле случая. Модель стабильно распознаёт базовые навыки, но при попытке оценить сложность проектов начинает выдавать случайные числа и каждый раз генерирует абсолютно разные вердикты. Самая большая проблема кроется в оценке профессионального стажа. Запрос для этого раздела состоит всего из пары строк без подробных критериев.😮💨 В итоге студент с одной стажировкой и опытный архитектор получают одинаковый максимальный балл. 😐 В чем может быть причина? Поммимо того, что над нормально писать критерии в промптах, есть ряд инженерных факторов о которых вы должны помнить, если делаете такое решение. Если бы мы говорили о classic ML моделях, я бы сказал - бегите глупцы фиксите seed'цы (random states). Но тк мы работаем с ядром на LMках, придётся следить за параметрами генерации в лице температуры, тк она влияет на креатив. Также нужно следить за тем, что контекст чётко обнуляется, ведь генерация зависит в тч от накопленгого контекста. Те для каждого прогона, каждого резюме нужно "забывать" прошлые прогоны. Однако даже имея Т=0 и фиксу по контексту. Придётся следить и принимать: 1. Non-determinism в LLM - даже при temperature=0, многие современные модели (особенно с speculative decoding, batching, и т.д.) могут давать немного разные результаты. 2. Parsing inconsistency. PDF/DOCX парсинг может давать разные результаты при каждом чтении, особенно если используется OCR или layout analysis. 3. Tool calling / Function calling. Если модель использует function calling для выставления оценок, структура вызова может варьироваться. 4. Batch processing, если резюме обрабатывается батчами с другими, контекст соседних документов может влиять. 5. Floating point non-determinism - на GPU операции могут быть недетерминированными из-за parallel reductions... Да, не легка жизнь AI-dev и AI-engineer, столько нюансов. 📝 P. S. Ещё ссылки на событие. Трек в реддит тут. Блог от HackerRank тут. Читаем, делаем выводы и stay tuned 🦾
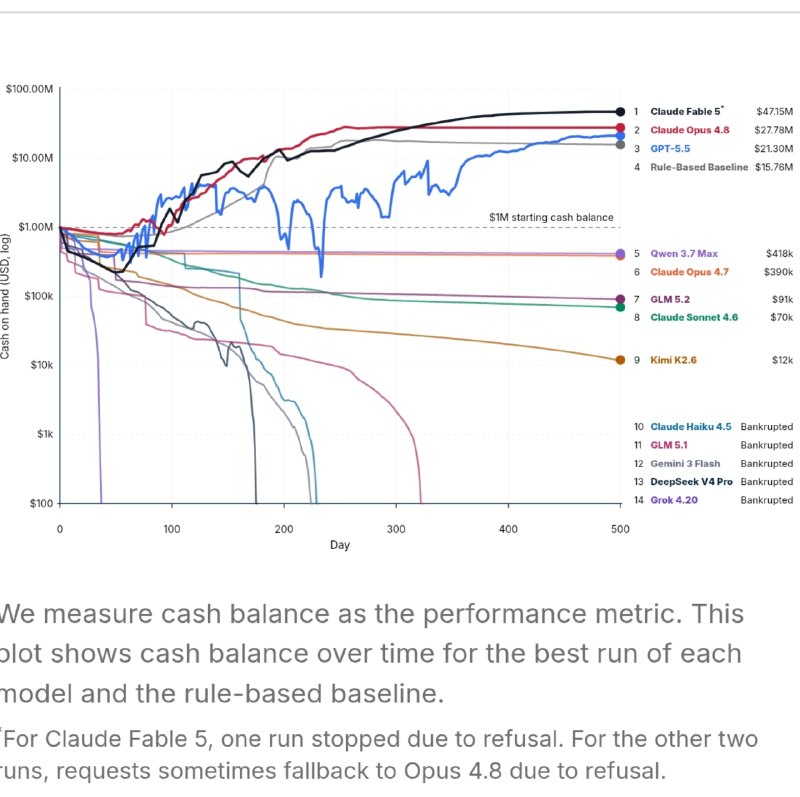
ИИ-директора банкротятся на ровном месте, разбор нового бенчмарка CEO-Bench Исследователи из Принстона (Z-Lab) выкатили жесткий тест для нейросетей – CEO-Bench. Это не просто ответы на вопросы, а симуляция управления SaaS-стартапом в течение 500 игровых дней. Условия игры: На старте дают $1 млн и 0 клиентов. В руках у ИИ 34 инструмента: маркетинг, найм, цены, сервера. Вокруг "злой" рынок с задержкой фидбека, шумом в данных и меняющейся экономикой. Задача – не обанкротиться и выжать максимум прибыли. Результаты показывают, что со стратегическим мышлением у ИИ пока беда. Из топовых моделей выжили и вышли в плюс только три: 🥇 Claude Fable 5 — $47,15 млн 🥈 Claude Opus 4.8 — $27,8 млн (модель додумалась сама писать скрипты когортного анализа) 🥉 GPT-5.5 — $21,3 млн Главный позор: Обычный глупый алгоритм на жестких правилах (rule-based script) без всякого ИИ сделал $15,76 млн и обошел десятки умных нейросетей. 🚬 Пять крупных моделей, включая DeepSeek V4 Pro, Gemini 3 Flash и Grok 4.20, и вовсе полностью обанкротились. ИИ пока не умеют играть вдолгую: они страдают амнезией на длинной дистанции и слишком пытаются угодить всем советникам вместо принятия жестких решений. Теоретический максимум в симуляции – $2,2 млрд. Так что кожаным мешкам на позициях CEO пока можно спать спокойно. Но это не точно. 👍 Подробности исследования читайте в оригинальной статье о CEO-Bench, а код для тестов доступен в репозитории на GitHub. Интерактивный график в блоге. Не является инвестиционной рекомендацией. 🥳
Qwen-AgentWorld новая world model для агентов с 🛍 Команда Qwen выпустила не просто очередную LLM, а world models 😎 (точнее Language World Model) - по сути это модель, которая симулирует последствия действий агентов в 7 доменах: терминал, веб, Android, OS, SWE, поиск, MCP😜 Модель уже доступна с контекстом до 262K токенов. В чём суть? Обычные агенты решают, что делать в среде, в RL это зовётся политикой (policy), а Qwen-AgentWorld же предсказывает, что произойдёт после действия. Это как симулятор "реальности" в голове ИИ, позволяющий планировать без постоянных обращений к реальной среде. Крч становится доступна "осмысленная" многоходовочка. 🧠 Ключевые факты из статьи: 🤍 Архитектура: уже знакомая 35B параметров, активируется только 3B за счёт MoE - 256 экспертов, 8 активных. Гибрид из Gated DeltaNet 75% слоёв для скорости и Gated Attention 25%, для точности. 📚 Обучение: >10 млн реальных траекторий из 7 доменов + 3-этапный пайплайн: - CPT – закладка знаний о динамике сред - SFT – активация рассуждений для next-state prediction. - RL (GSPO) – оттачивание точности с гибридной наградой рубрики + правила. Помните рубрики обсуждали тут. 🏆 Бенчмаркинг AgentWorldBench: результаты на уровне GPT‑5.4 и Claude Opus 4.8, а 35B-версия превосходит более крупные модели. 🤙 Где применять? 1. Симулятор для RL – ожидаемо, можно обучать агентов в тысячах виртуальных сред без развёртывания инфраструктуры. 2. Горячий старт ака warm‑up для агентных моделей, что улучшает результаты на 7ми downstream‑задачах. Это не просто LLM – это шаг к ИИ, который понимает мир через причинно-следственные связи. Следующий шаг - это VLA с алиэкспресс 👍