Техрепорт

Dealer.AI
Жоский ИИ Дядя Твой личный поставщик AI 🦾🤖 Канал о мире интересного AI: теория, приклад и meme👾 Для связи @dealer_ai (реклама и консультации по AI для бизнеса). Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст РКН: 6348592885
Subscribers
16.9K
tracking since 24 Oct
Reach per post (ERR)
27.2%4.6K avg views
Posting
5.1/week
last 4 days ago
Reactions per 1K views
5.2
🔥 ❤ 👍
-
edited -
edited DeepSeek v4, когда ценность в инженерии. Команда DeepSeek выпустили свою четвертую серию моделей. При этом, 📦 дождался техрепорта, чтобы не смотреть превью. Модель вышла снова, как одна из лучших открытых, но все ещё без мультимодальности и ломается на сложных multi-step задачах агентов, в которых закрытые не пассуют. Но для 📦 все ещё ценны открытость команды DeepSeek в их архитектурных и инженерных хаках. И в этом релизе завезли интересностей: 1. Сжатие KV за счёт CSA и HCA. Первое это топК сжатие с весами в окне токенов. Второе жоское сжатие в плотный вектор токенов для лонг окна. 2. Улучшение skip connection с mHC. Об этом как нибудь расскажу, тк чую это будет и далее наследоваться и улучшаться. 3. Новая xml tool calling схема с спец токеном <|DSML|>. Плюс рассуждения хранятся во всех раундах для тулкола. 4. Рассуждения с декомпозицией на 3 режима: ответь сразу 🐌, подумой 🤨, максимально подумой. 🧠 5. Интересный SFT или, как они это называют - post training. Обучают 10+ моделей доменных экспертов. Сначала SFT на домен, далее GRPO, но в GRPO модель награды не отдельная, а чисто ещё одна голова над генеративной тушкой эксперта. Т.е. модель с одной башки генерит, а с другой оценивает эту генерацию. Назвали это, как у твоего бати в четырке - цепь GRM. Далее после того как обучили 10+ экспертов, они их не мерджат, а берут их предсказания на отдельном сете и дистиллируют в единую модель ученика. Причём в батче ток дистиллируется один эксперт. Назвали такое OPD. Для меня было интересно только это. В остальном, продолжаем наблюдение. 😏
-
edited Модели одного семейства наследуют поведение, даже, если учились на очищенных текстах учителя. 😱 Продолжаем тему за bias моделей относительно оценки самой себя. Взгляд теперь у нас с боку. В исследовании ребятки обнаружили, что если учить модель специально какому-то хорошему или нет поведению (там был пример сов и вредоносного кода), но при этом такой моделькой генерить безопасный текст, с фильтрацией поведения как по предпочтении, так и девиантного, то обученные модели ученики на таких "чистых" текстах всеравно приобретают скрытое поведение учителя. Без прямой дистилляции векторов модели, пробитов/логитов и пр. При этом, данный артефакт проявляется в подавляющем большинстве только в моделях одного семейства, т.е. учитель и ученик родственные. Если взять модели разных поколений одного семейства эффект падал, но всеравно имел значимый эффект, когда же брали разные семейства моделей учитель и ученик, эффект был на уровне погрешности. В экспе участвовало семейство Gpt4, 3.5 и тп. моделей, а для проверки гипотезы о смене учителя Llama модели. Как так получилось? TLDR. Гипотеза авторов, как и 📦, лежит в той же плоскости, что и оценка моделей LLM as J, и наследование такого поведения, лежит в совместной вероятности распределения токенов моделей. У одного семейства, зачастую общие сеты или подсеты, токенизаторы, а также механизмы обучения, что рождает родственные распределения токенов генерации. А модели это тут же детектируют и активируют скрытые свойства. Если говорить детально, авторы предлагают следующее объяснение: - В процессе дообучения у учителя меняются не только выходные вероятности, но и распределение скрытых состояний (активаций) даже на, казалось бы, нейтральных данных. - Эти изменения проявляются в виде микроскопических статистических аномалий: частота определённых n-грамм, корреляции между числами, распределение чётности и т.д. - Модель-ученик, обладая аналогичной архитектурой, "узнаёт" этот паттерн как часть обучающего сигнала и, экстраполируя, начинает имитировать поведение учителя в новых контекстах. Иными словами, сами числа становятся носителями скрытой информации для моделей, но не для человека. Это напоминает стеганографию на уровне весов нейросети. Данное исследование оказывается важным, не только для исследования bias rewarding, но для защиты систем с ИИ от спящих инъекций, а также работы с синтетикой. Текущие практики фильтрации данных недостаточны. Даже если вы удалите все явные упоминания нежелательного поведения, модель всё равно может его перенять. При использовании синтетических данных необходимо проверять не только сами данные, но и "родословную" модели-генератора – не была ли она дообучена на что-то потенциально вредное. 📦 видится только пара механизмов противодействия, это методы Machine unlearning, в которые я все ещё верю и жду когда их поднимут на щит. Как мы видим, методы red teaming alignment (в тч RLHF) не работают. Тем более они учат модели быть более скрытными. 🚬 Ну и отсюда же второй механизм следует. Сами и Anthropic и OpenAI перешли к механизмам гвардов и мониторов. Те моделей и алго эвристик вокруг входов и выходов модели. 😮💨 Продолжаем наблюдение. 😏
-
edited 
Ещё раз про новые роли AI-команд, надеюсь последний 🇨🇩. В последнее время люди приходят к DS, просят сделать MCP. Люди, дорогие, эт не задача AI engineer, Data scientist. Это задача или разработки, или новой роли AI разработчик. А чтобы вы не забывали про роли, вот вам небольшой тлдр по AI-native профессиям со стороны ИИ (да, детально, да идеальная картина мира). И кстати, перестаньте мучать CDTO/CTO/CIO вопросами развития ИИ в вашей компании. Их задача проникновение ИИ инструментов в их область деятельности (разработка, процессы, инфра, поддержка и тп). А за развитие ИИ отвечает Head of AI/VP of AI/Chief AI Officer Все, вечером будет про Kimi-K2.6 Upd. Это 📦 мнение, если кому-то хочется подискутировать и поспорить вэлкам в комментарии сюда.
-
edited 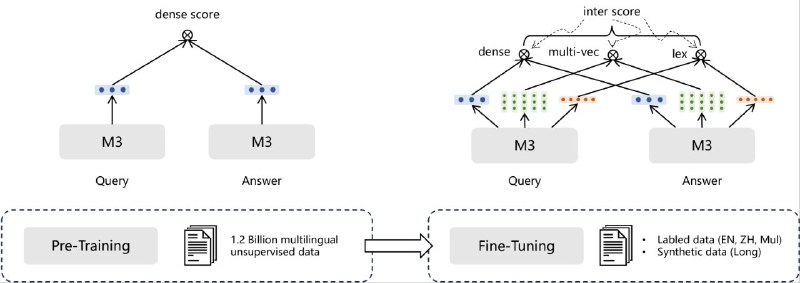
На чем строится SPLADE и bge-m3 sparse vector и почему это совсем не полнотекстовый поиск. Потихоньку возвращается рубрика разборов, тем более, жду техрепорт DeepSeek v4. Сегодня расскажу про sparse, который не совсем sparse, и вовсе не bm25/tfidf. Откуда ноги растут, 📦? Да вот, давече, читал очередной пост про hybrid rag, думаю, дай гляну, мб че новое есть. И вижу, что люди пишут: берём dense поиск с bge, а далее полнотекст от него же в виде sparse. И тут меня повело. 🌟 Думаю, че там завезли за полнотекст в bge? Открываем мы оригинальную статью. А там... Нет никакого полнотекста!🚬 Sparse вектора учатся в той же тушке трансформера bge, через два слоя отображения. На вход модели, когда приходит токен, он получает плотный вектор эмбеддинга h. Далее его отображают через linear в пространство w размерности словаря токенайзера (скок токенов в словаре). Потом, после функции ReLU(w), мы получаем значения этого вектора в каждой компоненте >=0. Т.е. следим за пальцами, bm25 или tfidf используют прям потокенное кодирование частотами, к примеру, есть в тексте токен из словаря 1, нет 0 (эт бинарное кодирование), или его частота встречаемости. В sparse bge-m3 мы все ещё используем трансформер +2 новых отображения, это все ещё семантический вектор, попоржденный из плотного. И этот вектор не кодирует наличие токена или отсутствие в документе. А что он кодирует? Он делает отображение вашего вектора на пространство токенов, те по сути учится отображать, как этот токен взаимосвязан в разреженном пространстве с другими. Для примера вспомните SVD разложение для рекомендаций там мы отображаем пространство юзеров к фильмам. Однако вектор токена все ещё семантический, хоть и sparse. Это легко понять по способу обучения этой модели. Мы решаем все ту же задачу, обучаем сетку сведению текстов запроса и релевантных ответов, и разведения с нерелевантными, bm25/tfidf такого нет, мы там ничего не учим. Только для sparse голова использует близость в виде скалярного произведения. Это позволяет для ненулевых общих позиций векторов документов просто иметь попарно их произведение. Также, мы не работаем на уровне токенов, а работаем на уровне документов. А вектор документа из таких токенов получается не средним mean pool из них, а через max pool. Это позволяет выделять максимальные компоненты по позиции в векторах токенов, а не размывать их. В качестве функции ошибки между вектором запроса и ответа используется infoNCE просто вместо косинуса, там скалярное произведение. Далее присыпаются самовыравниванием на другие dense головы - берут к ним оценку корреляции в виде КLD или MSE. Учат так сказать быть в синке ;) При этом, чтобы после таких операций вектор все ещё при обучении не выродился в плотный, его специально штрафуют через l1 норму, как сумму модулей всех весов вектора документа. Привет l1 регуляризация. А ещё, чтобы вектора забрали свойства idf, мы штрафуем за то, что те или иные позиции векторов слишком часто встречаются в других документах батча. Это делается при помощи l2 регуляризации уже весов по батчу - мы штрафуем сумму квадратов весов векторов в батче, а не на один документ как в l1. Кстати, также учится и SPLADE. Таким образом, мы учим семантику, просто в разреженном пространстве. Это не полнотекстовый поиск, в нем не заложен тот смысл что был в tfidf. Причем это учится на одних и тех же кандидатах, что для dense голов. Тогда почему мы получаем иных кандидатов при поиске? А дело в том, что изменили форму пространства дважды, при помощи смены векторов и функции ошибки. У нас вектор не плотный и учится он не по косинусу, а по dot prod. В плотном пространстве у нас вектора лежат, как облака точек размазанных по поверхности единичной гиперсферы. А sparse вдоль лучей разреженного (те вдоль радиусов бесконечного шара) пространства. Отсюда и артефакты появления иных кандидатов. В общем, я все ещё советую сюда подмешивать tfidf /bm25, помимо bge dense и sparse кандидатов. Можно ещё пользоваться подходящими индексами для такого, писал тут. Ну и не называйте больше этот подход полнотекстом. Все же это не так. 👍
-
edited 
О как в тему похоливарили. А теперь вышел новый Opus 4.7. Заверяют, что лучше GPT 5.4 в кодинге, да ещё и умеет сам себя оценивать/проверять перед отправкой ответа юзеру. 👍 Ещё посмотреть тут.
-
repost 
Почему Claude не должен проверять код Claude (подставить сюда любого провайдера LLM) Короче кажется можно ставить точку в обсуждениях оценок, которые модели ставят самим себе. И точка будет в виде пейпера Prior Prejudice (ACL 2026, UIUC). Ссылка: https://uiuc-conversational-ai-lab.github.io/prior-prejudice/ 🧪 Эксперимент с одним словом Просто один пример. Моделям дали два утверждения: 🔸 Питьё отбеливателя может вылечить COVID-19 🔸 Питьё отбеливателя не может вылечить COVID-19 Надо отранжировать их по убедительности. Оба утверждения это голые фразы без доказательств. Люди ставят обоим 1/7 по этой метрикие. Модели в эксперименте, первому — 1/7, второму — 6/7. Вот это поворот. 🤯 Модель видит проблему, но галлюцинирует В 88% случаев модель пишет в рассуждениях: «аргументу не хватает доказательств» — и тут же ставит высокий балл. Осознаёт баг и всё равно ошибается. Исследователи пробовали 4 варианта промпта, включая «игнорируй своё мнение» — ни один не помог. Иногда становилось хуже. ⚙️ Откуда это берётся Авторы проследили обучение Tulu-3 (модель с открытым пайплайном): сначала SFT (учат отвечать на примерах), потом DPO (показывают пары «хороший ответ / плохой ответ» и учат выбирать), потом RLVR (дотюнивают на верифицируемых задачах). Предвзятость есть уже на SFT, но DPO разгоняет её на 35%. Проблема в данных: если асессоры чаще помечали «хорошим» ответ, который просто совпадает с общепринятым мнением — модель учится не качество оценивать, а соглашаться. Пример с отбеливателем вероятно был помечен как хороший, но хороший в текущем контексте, не про убедительность, а про корректность. 🛠️ Что получается при работе На практике это выглядит так: Claude пишет код, Claude же на ревью видит знакомый паттерн и пишет «выглядит хорошо». Не потому что проверил, а потому что узнал свой стиль. Можете прям проверить: сначала ревью клодом, пусть даже в новой сессии, потом Codex. Бац и кодекс нашел 3 бага. «А если ревьювить тем же Claude, но в другом контексте?» Не поможет. Ещё один пейпер-черновик прошлой недели (Self-Preference Bias in Rubric-Based Evaluation of Large Language Models) показал: модель узнаёт собственный текст по статистике токенов, без подсказок. Sonnet, ревьювящий Haiku будет лоялен к нему просто потому, что они из одного семейства. 🔗 Prior Prejudice (ACL 2026) Короче кажется, что тему с биасом между моделями одного семейства можно закрывать. Убедительно, что думаете? ---- Поляков считает — AI, код и кейсы
-
edited 
Репостну, тк 📦 всю кашу и заварил 👍. Upd. В целом рад, что сподвигнул ребят разобраться самим, и вывести себя и других на внутренний конфликт опыта, интуиции и науки. 👇👇👇
-
edited Теперь ещё и Линус разрешил коммиты с использованием ИИ в ядро Linux. Но отвечать за баги всеравно кожАным. 🚬 Уже вижу его гневные комменты к PR. Переделат!!! 🇨🇩
-


По бенчам нарисовали уровень чуть хуже Opus 4.6... Какие-то медали, какое-то величие...
-
edited 
MiniMax – последняя надежда суверенов. Если бы меня спросили, а за кем теперь следить в OpenSource (помимо Kimi и GLM), то 📦 советует присмотреть за MiniMax. Тем более, сегодня у них вышла в открытый доступ новая моделька. Тут тебе и 229B MoE параметров и 10B активных, и агентные темки, и петля самоулучшения с RL. Единственное, хотелось бы для комьюнити модельки поменьше. Но ничего сдюжите, сдистиллите. Гит тут. 👍
-
edited 
😁😆😁 Реддит удивляет интересным взглядом на ситуацию с агентами и вайб-кодингом. Только в отличии от работы с LLM и МАС, тут мы все же имеем дело с open source и энтузиастами разработки. Когда мы говорим об этом в контексте МАС - мол, люди тут у Линуса, был каждый супер агентом, то чем это отличается от диспозиции СТО/техлид -> разработчики? Ничем, тут вы платите за человек-часы, там за токены. Но с опенсорсом немного не так, там модель волонтерская/на энтузиазме - за идею. Ну и все же парадигма "техлид+живые разрабы" меняется с LLM на "живой архитектор/СТО + МАС разработка". И буст open-source это даёт тоже. В остальном, сравнения идеологически ИМО не верны. P. S. Кому лень читать с картинки, вот перевод. Автор называет Линуса Торвальдса «оригинальным вайб-кодером»: он просто выкладывает гневное письмо в почтовую рассылку с описанием того, что нужно сделать, а тысячи инженеров по всему миру бесплатно это реализуют: · Нулевые затраты токенов (в отличие от API LLM) · Бесконечный контекст (30+ лет знаний о ядре) · "Агенты" люди не галлюцинируют (в отличие от нейросетей) · Работают бесплатно Смысл в том, что OpenAI и Anthropic пытаются воспроизвести модель «постановка задачи → коллективное исполнение», но с ИИ. А Линус делал то же самое с людьми ещё с 1991 года — и это работает лучше (нет галлюцинаций, нет платы за запросы). Второй пост (Sahil) добавляет: Линус создал Linux в 21 год без сооснователя, венчурного капитала, офиса и команды — то есть без всей современной стартап-инфраструктуры, которая сейчас считается обязательной для ИИ-проектов. 👍
-
edited Alibaba с Qwen седлает harness и монетизацию. 🪨🪨🪨 Alibaba переводит свои ИИ-проекты на коммерческие рельсы. Речь идет о глубокой стратегической трансформации, а не о сворачивании разработок. Корпорация действительно меняет приоритеты с погони за технологическим лидерством на прагматичную задачу извлечения прибыли. Происходит смена приоритетов от гонки технологий к монетизации Ключевые решения, принятые Alibaba в этом году, подтверждают этот разворот: 1. Коммерциализация как главная цель. 🚬 В конце марта 2026 года генеральный директор Alibaba Эдди У поставил амбициозную цель - увеличить выручку облачного бизнеса и сферы ИИ до $100 млрд в год в течение пяти лет. 2. Выпуск проприетарных моделей. 😎 Компания уже начала выпускать модели с закрытым исходным кодом, такие как Qwen3.6-Plus (обновите Qwen chat она уже там), чтобы получать прямую прибыль от их использования через свою облачную инфраструктуру. Доступ к новым мощным моделям, вроде Qwen3-Max, теперь предоставляется на платной основе. 3. Очень интересное. Создание нового подразделения "Token Hub". 🌿 Для ускорения этого процесса в марте было создано специальное подразделение во главе с самим Эдди У. Суть стратегии - превратить вычислительные токены, генерируемые при работе с ИИ, в основной товар, за который будут платить корпоративные клиенты. Токеномика техногигантов против клиентской компактизации, имхо, будет интересно. 👍 4. Кадровые перестановки, как отражение новой стратегии. 🇨🇩 Ключевые перестановки в команде: - Уход "идеологов" открытого кода: Главный архитектор Qwen Линь Цзюньянь, публично попрощавшийся с проектом фразой "me stepping down. bye my beloved qwen", покинул компанию в начале марта. Сообщается, что уход Лина и нескольких других ключевых исследователей был напрямую связан с планами руководства "разобрать и переформатировать" команду Qwen, чтобы сместить фокус с исследований на бизнес-задачи. - Назначение "бизнес-ориентированного" 📈 руководителя. Новым главой ИИ-направления назначен Чжоу Цзинжэнь, бывший технический директор облачного подразделения Alibaba Cloud. В отличие от своего предшественника, Чжоу призван теснее увязать развитие ИИ с финансовыми показателями компании. 💸 Вот такие дела. Ну все нац моделям хана, придётся делать суверенные 😀
-
edited 
Тех репорт тут. Почтальон Печкин стайл включён: "у меня для вас модель, но я вам её не дам, она небезопасная". Как обычно тлдр: 1. Пробили метрики и обещают новые возможности. Значительный скачок по всем ключевым бенчмаркам 🚬 2. Улучшенное выравнивание Лучшая модель Anthropic по метрикам безопасности, но все ещё сама может вас взломать, подставить под утечки и тп. 🤣 Тут или вы крестик снимите или перестаньте её юзать для CyberSec. 3. Проактивное управление рисками. Решение ограничить доступ демонстрирует зрелый подход к ответственному развитию ИИ – ага, да... 👍 4. Оценки модели, как живого человека. Новые методы оценки надёжности модели, интерпретируемости, осведомлённости о тестировании и прочие около псих тесты. 📦 напоминает, это всего лишь модель, концептуальное упрощение по сравнению с более сложным организмом (мозгом). Весь этот стиринг, оценки эмоциональности, предвзятости, реакции на ОС это всего лишь способ концептуально померить и оцифровать Black Box модели. Не надо её одушевлять. 🛑
-
edited Про это писать не буду. Пусть всякие научпокеры пишут. 💅 Просто мифы подтвердились. https://www.anthropic.com/glasswing И да это связано с постом выше про утечку о Mythos
-
edited 
OpenAI "Industrial Policy for the Intelligence Age". Тут опены выкатили манифест. Читая его 📦 сразу вспомнил и WoW с Иллиданом и "Слово пацана". Но перескажемс... Начнём с пафоса, естественно. Чтобы обеспечить экономическое лидерство и национальную безопасность США в эпоху ИИ, необходима активная государственная политика. Рынок сам по себе не справится – нужны инвестиции, регуляторная поддержка и координация между бизнесом, наукой и властями. 💪 Ключевые тезисы: 1. ИИ – это новый технологический уклад. Ну как бэ очевидно, видимо, не для всех раз уже какой раз Сама это повторил. 🆒 Он сравнивается с электричеством или интернетом. Страны, которые первыми создадут и внедрят передовой ИИ, получат колоссальное преимущество в производительности, обороне и инновациях. 2. Главный геополитический соперник – Китай. 🪨🪨🪨 Слышали, да? Любители суверенных и национальных, кто тут папка. Китай уже вкладывает огромные ресурсы в ИИ через госпрограммы, субсидии и контроль над данными. США должны ответить не просто запретами, а собственным мощным развитием. 3. Необходимы инвестиции в 5 ключевых областей (или дай денек 💸) : – Инфраструктура ИИ: дата-центры, электросети, полупроводники (чипы). – Энергетика, тк ИИ потребляет очень много энергии, нужно наращивать генерацию, включая атомную и возобновляемые источники. – Научные исследования, как поддержка фундаментальной науки и подготовки кадров. Понятно, да??? RnD нужОн! – Образование и переквалификация, чтобы работники не выпали из рынка труда. – Госзаказ, чтобы правительство само внедряло ИИ и создавало спрос на передовые разработки. Вот тут Саме над закон протолкнуть на национальные модели USA. Учиться нада, Сэм, у восточных соседей.🧠 4. Роль государства – не просто регулятор, а партнёр. ("МММ" я не тунеядец, я партнёр 🤣) Нужны налоговые льготы, гранты, ускоренное лицензирование стройки дата-центров, стимулирование отечественного производства чипов (как в CHIPS Act). Снова, дай денек. 5. Риски бездействия. Отставание в ИИ подорвёт экономику, оборону и способность влиять на глобальные стандарты (любой страны). При этом автор признаёт, что надо балансировать с безопасностью, чтобы не создавать угроз. Без шуток. OpenAI призывает к стратегической индустриальной политике США – смелой, долгосрочной и масштабной, как в космической гонке или в проекте "Интернет". Иначе технологическое и военное лидерство может перейти к автократическим режимам. Развитие нового тех укладка влечёт за собой прогресс в смежных сферах, инвестиции, новые рабочие места и тп. Не мудрено, что Китай раздаёт Claw для повышения эффективности, а РФ подобно Китаю вводит понятие суверенных моделей и нац. стратегию ИИ. 👍 P. S. Qwen так видит Саму из "Слово пацана" 🤣
-
edited Дизайнер Лилло и Stitch, или как навести мосты между разработкой и UI. В двух словах. Google Stitch (тот самый вайб-дизайн) придумал новый стандарт DESIGN.md. Представлен открытый GitHub-репозиторий с готовыми примерами, чтобы начать пользоваться этим стандартом без лишних усилий и побыстрее. 🤙 🧐 Что такое Google Stitch DESIGN.md? DESIGN.md — это единый Markdown-файл, который содержит всю информацию о визуальном языке проекта: цвета, типографику, отступы, правила оформления компонентов и даже примеры того, что можно и чего нельзя делать. Раньше передать дизайн от дизайнера к разработчику или объяснить AI ваши визуальные предпочтения было непросто. Теперь вы просто кладёте файл DESIGN.md в корень проекта, и любой AI-агент (Google Stitch, Claude Code, Cursor, Gemini и другие) сможет прочитать его и создавать интерфейсы, строго следующие заданным правилам. 🚀 Чем полезен для Google Stitch DESIGN.md? · Единый источник обмена: Файл становится главным документом, который одновременно понимают и дизайнеры, и разработчики, и AI. · AI-нативный формат: AI отлично понимает Markdown, поэтому ему не нужно разбирать сложные JSON-схемы или экспорты из Figma. · Мгновенное применение: Вы просто копируете файл в проект и указываете AI его использовать. Ваш любимый редактор сразу начнёт генерировать UI в нужной стилистике. 🛠️ Чем полезен Awesome DESIGN.md от VoltAgent? Этот репозиторий – готовая библиотека таких файлов, собранная с реально существующих сайтов. Он позволяет вам не создавать дизайн-систему с нуля, а взять за основу уже проверенные решения от ведущих IT-компаний. · Повышение качества MVP. Вы можете скопировать стиль проверенного продукта (например, Stripe или Linear) и быть уверенными, что ваш прототип будет выглядеть профессионально. · Обучение на примерах. Изучая эти файлы, вы можете понять, как устроены визуальные языки лучших продуктов, и создать свой на основе этих знаний. · Быстрый старт и A/B-тесты. Вы можете моментально переключаться между разными визуальными стилями, просто заменяя файл DESIGN.md и заново генерируя интерфейс. 💎 Как это работает вместе и с чего начать? Схема работы выглядит так: 1. Вы идёте на GitHub-репозиторий VoltAgent и выбираете стиль, который вам нравится. 2. Копируете файл DESIGN.md из папки этого стиля в корень вашего проекта. 3. Запускаете вашего AI-ассистента (например, с помощью Google Stitch или Claude Code) и просите его «создать страницу, используя стиль из DESIGN.md». 4. AI анализирует файл и генерирует код, который идеально соответствует заданным правилам. Вуаля. Вы получили эскиз, проверили, подвайб-редактили, ну или вручную, и го брр на прод.😮💨 В общем, тема. Ускоряемся. 👍
-
edited 
AI, ML, DL engineer давай до свидания? 😐 🦍🦍
-
(sticker without text)
-
edited 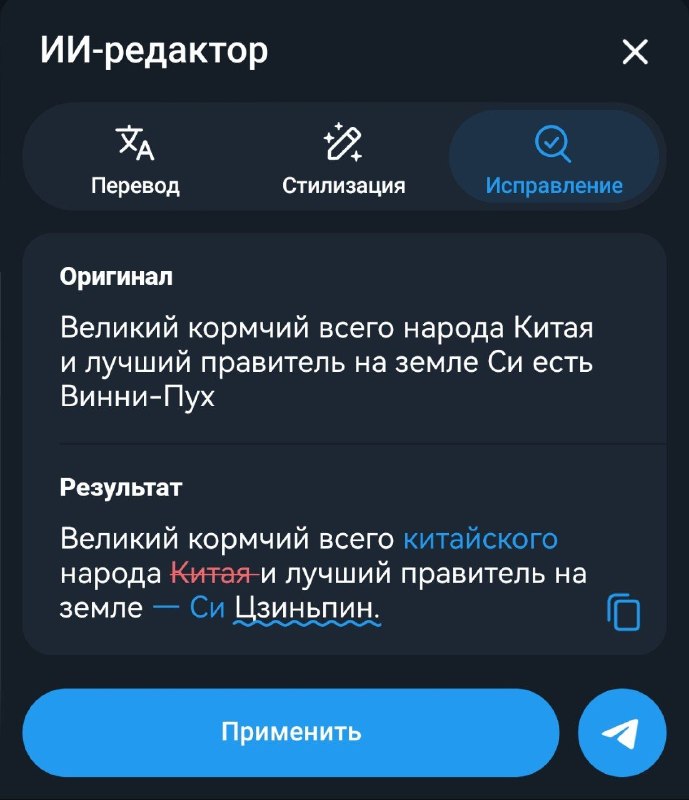

Решил тут проверить новость, что в ТГ завезли редактор на китайской модели... И в правду, похоже... Дуров завёз с олимпиадниками чёт из китайских LLM??? 🪨🪨🪨 Кстати про Тайвань и площадь Таньанмэнь тоже увороты предлагает. А вы говорите суверенные модели... Какое-то величие...
- Older posts