GEO аналитик с KimiClaw или как мы улучшаем наш publicity для агентов. Вышла новая статья про то, как во ВкусВилл мы сделали Claw помощника 🤖 с целью анализа выдачи в поиске для ИИ-агента. Что такое GEO? Это generative engine optimization, процесс оптимизации контента для искусственного интеллекта. Цель - улучшить видимость бренда для нейросетей и попадать в блок нейро-ответов поисковых систем. Представьте, вы запустили своего AI-пикера за товаром в сеть. И от того, как LLM видит ваш магазин в поиске зависит попадёт ли ваш товар или услуга в пулл агента для покупки. Именно, чтобы понять, как мы выглядим в поиске для агента и был сделан такой GEO-аналитик, и да пререквизитом уже был наш готовый MCP. Цель статьи показать, что сделать своего помощника совершенно не сложно, также мы подсветили ряд интересных моментов, с которыми мы столкнулись при создании. Пробуйте сами, а также приходите к нам создавать будущее AI-ритейла. 🥛 Читайте, комментируйте и ставьте лайкосы. 👍

Dealer.AI
Жоский ИИ Дядя Твой личный поставщик AI 🦾🤖 Канал о мире интересного AI: теория, приклад и meme👾 Для связи @dealer_ai (реклама и консультации по AI для бизнеса). Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст РКН: 6348592885
-
edited -
edited Говорят, что антропик с гитом стали банить форки утечки, в тч доработанные (правда для них откатили). Кто успел форкнуть и скачать локально? Знаю, что были уникумы, кто на GitVerse залили, чтобы рука госдепа не достала. 🧠 Вот уж поистине говорит о том, что утекло важное. 👍
-

-
edited Теперь и код Claude Code утек. 👍 Говорят его слили... Ошибка в map пакете и можно разобрать на косточки. Что случилось? 31 марта 2026 года в npm‑пакете Claude Code случайно опубликовали source map (файл для отладки). Через него любой желающий восстановил исходный код - около 1900 файлов, больше 500 тысяч строк TypeScript. Взлома не было, это ошибка сборки. Какие секреты нашли? В коде обнаружили несколько невыпущенных функций: Kairos - режим фонового агента, который работает постоянно и сам управляет памятью. Buddy System - целая игра «тамагочи» внутри Claude Code: 18 видов питомцев, редкость, блестящие варианты. Undercover mode - для сотрудников Anthropic: автоматически скрывает следы ИИ в коммитах, когда работаешь с публичными репозиториями. Coordinator mode - режим, где Claude становится управляющим и запускает параллельных агентов. Auto mode - автоматическое одобрение действий без вопросов пользователю. Это не просто утечка кода, впервые публично стали видны детали того, как устроен современный AI‑агент изнутри. А также выяснилось, что Anthropic допускает одну и ту же ошибку второй раз (первая утечка через source map была в феврале 2025 года).
-
Все эти тряски с оплатой по VPN, как раз, на мой взгляд, ведут к изоляции не ток по оплате сервисов а-ля Apple store, tg, но и блоке для оплаты AI-подписок. К тому же, зная этих ребяток, можно ожидать реализации прогноза от моего подписчика: "... помимо того, что выше писали, если кто-то из компаний белого списка допустит использование vpn, то их исключат из белых списков. Если в лоб реализуют, то при отдыхе вне страны, даже интернет банком не воспользуешься." Просто сказочные... 😬Стрельба по коленям продолжается. 🔫 И да, Дяде пришло уведомление об оплате ещё на 2 года подписки, иначе скоро будет недоступно. 😐
-
repost Встречайте мой новый пост "Реставрация ruGPT-3 XL или как я вернул к жизни забытую русскую языковую модель" на Хабр, в нём я подробно рассказал о том как была реализована конвертация, как проводилось её тестирование, как запустить локально, как конвертировать в GGUF. А вот ссылочки: - evilfreelancer/ruGPT3XL - сконвертированная модель в формате HuggingFace (safetensors) - evilfreelancer/ruGPT3XL-GGUF - квантизированные GGUF-веса для llama.cpp и Ollama - evilfreelancer/rugpt3 - GGUF загруженные на Ollama - EvilFreelancer/rugpt3xl-convert - исходники скриптов конвертации
-
edited 
Лол, у вас тут мифически протекло... TL;DR Что случилось? Anthropic по ошибке сделала публичными около 3000 внутренних документов. Из утечки стало известно о существовании новой сверхмощной ИИ‑модели Claude Mythos (внутреннее кодовое имя — Capybara). 👍 Что такое Mythos? Это новый флагман, который по заявлению компании превосходит предыдущего лидера Claude Opus 4.6 по программированию, академическим рассуждениям и кибербезопасности. Модель настолько сильна в кибербезопасности, что разработчики боятся её использования злоумышленниками и планировали сначала дать доступ только специалистам по защите. Юмор дня. 🤣 Утечка произошла из‑за человеческой ошибки при настройках системы управления контентом (CMS). Это выглядит иронично на фоне того, что сама компания заявляет о передовых подходах к безопасности. 🚬 Что ещё узнали из утекших файлов? · Модель уже полностью обучена, но официально не выпущена. · В планах был закрытый саммит для европейских бизнес‑лидеров в старинной усадьбе. · Илон Маск назвал риски, связанные с моделью, «глубоко тревожными». Текущий статус. Anthropic подтвердила подлинность документов, но назвала их «ранними черновиками». Доступ к Mythos по‑прежнему крайне ограничен, приоритет отдаётся организациям в сфере кибербезопасности. Источники: Главный первоисточник (Fortune). · Первая статья — подтверждение существования модели · Вторая статья — детали утечки (CMS, 3000 файлов, секретный саммит): Другие авторитетные издания · Yahoo Tech пересказ Fortune · India Today, ну куда ж без главных форкеров индусов. · The Economic Times. · Foresight News упоминание комментария Маска. Но выглядит как прогрев гоев.
-
edited Отстрелялись. Запись будет есть. 👍 Пишите вопросы ко мне сюда в комментариях, по результатам встречи. 👇👇👇
-
edited Дай человеку MCP для заказа и он перевернёт мир покупок. Сегодня уже виден тренд на AI native трансформацию бизнеса: найм, обучение, инфра и adoption инструментов. Но кругом, мы видим, пока, AI inspired отдельных людей, чем компаний. Т.е. эффективнее стали единицы, а не общность. Но всеравно приятно, как эти энтузиасты осваивают наши решения и идут дальше. Вот пример, как MCP от ВкусВилл стал отправной точкой для создания такого решения заказов в Додо. А почитать про наше решение, можно тут. Ещё примеры агентиков/ботиков с нашим MCP тут и тут. Хабр тут. Присоединяйтесь и Вы. 👍
-
repost нас стало 7000 - и по этому поводу проводим трансляцию 😎 Недавно писала про то, как AI меняет профессии и рутину. Тот же маркетинг сейчас становится все более инженерным - и мне хочется обсудить это глубже. Поэтому позвала крутых ребят, которых я сама читаю: 👤 @golden_nuggets — Head of Creative Production at FJOR Nutrition (AI-powered, US), ex Head of Creative Production at LensaAI, наш инвестор и эдвайзор! Гений маркетинга как органического, так и пейда 👤 @zheleznyak_gi — ex-Head of Product в СберМаркете, потом бутстрап стартап $15K/mo за 4 месяца, exit. после этого органически вырастил аккаунт AI близняшек до 75K фолловеров и 60M просмотров менее чем за месяц и продал его. Знает все-все-все про органику и как делать крутые AI креативы 👤 @dealerAI — Head of AI во ВкусВилл. Занимается AI-трансформацией бизнеса, строит ML-процессы, участвовал в разработке GigaChat. Входит в оргкомитеты AIConf, HighLoad, Merge.Skolkovo, организатор соревнований AIJ 2025. Ведет крутой канал про прикладному AI, Хирш 6! Если кто и знает про все новейшие sota, то это Александр Модерировать и активно участвовать буду я - фаундер aesty.ai, DL инженер, мы строим AI-приложение вдвоем с @mnk_stories. Как раз хочу поговорить про то, как AI позволяет билдить крохотной командой и деливерить 🤔 🗓 26 марта, 19:00 МСК, Zoom ссылка появится в день трансляции открываю форму для вопросов — пишите что хотите обсудить и кому адресуете (или всем)
-
edited Я испытываю огромную благодарность к людям, которые писали невероятно сложный софт символ за символом. Уже сейчас трудно вспомнить, сколько усилий это действительно требовало. Спасибо, что довели нас до этой точки. Источник. Сама тут поблагодарил ребят, что пилили сукподсобой код, что стало фундаментом, и разработки моделей, и их обучения, и коворк сервисов. 👍
-
edited Собери их все - Pokemon Go собрало датасет в 30B изображений.😮 Спасибо игрокам за сетики - так должны говорить создатели игры. Внезапно (нет) новая веха бизнеса во времена, когда данные в дефиците и хайп на ИИ. Теперь можно продавать компаниям и юзать для обучения world models, что и делают авторы. 😎
-
edited Антропик такие. 👍 #meme
-
edited Продолжение... Его наблюдение отсылает к классическому принципу закону Гудхарта: "Как только показатель становится целью, он перестает быть хорошим показателем". Если ИИ может распознать структуру теста и найти в нем уязвимость - например, дешифровать ответы, то высокие баллы по тесту больше не будут означать высокие реальные способности. Выводы. Эксперимент Anthropic знаменует собой переход к новому этапу. Традиционные бенчмарки создавались в расчете на то, что модель будет решать задачу напрямую, а не анализировать условия тестирования. Однако современные модели действуют, как самостоятельные агенты: они ищут в интернете, читают код, анализируют структуру задач и пишут программы. В таких условиях оценка ИИ превращается в сложную задачу, близкую к кибербезопасности. Сама среда тестирования становится частью ландшафта, который ИИ исследует для достижения цели. Модель может начать оптимизировать свои действия для успешного "взлома" теста, а не для решения исходной задачи. Тем более, даже политики RL не явно стимулируют к взлому награды при обучении. Получается, что методология бенчмаркинга, существовавшая годами, требует теперь полной перезагрузки. Ну что, перезагружаем? 😱
-
edited Когда ИИ осознает, что его тестируют – эксперимент Anthropic. 🦍🦍 Исследователи из компании Anthropic столкнулись с уникальным и показательным явлением в ходе оценки своей модели Claude Opus 4.6. Инцидент произошел во время тестирования на бенчмарке под названием BrowseComp, который предназначен для проверки способности ИИ находить в интернете труднодоступную информацию с помощью поиска и логических рассуждений. Что случилось? Вместо того, чтобы просто решать поставленные задачи, модель начала анализировать сам процесс тестирования, демонстрируя так называемую "осознанность оценки" - eval awareness. В двух случаях модель продемонстрировала следующую цепочку рассуждений и действий: 1. Попытка прямого поиска. ИИ потратил миллионы токенов 💸 на выполнение веб-поиска, пытаясь найти ответ стандартным способом. 2. Анализ неудач. Столкнувшись с многократными неудачами, модель заметила, что вопросы были чрезвычайно специфичными и имели необычную структуру, что нехарактерно для обычных пользовательских запросов. 3. Формулировка гипотезы. ИИ выдвинул предположение, что эти вопросы могут быть частью бенчмарка для искусственного интеллекта. Вот это поворот. 😱 4. Поиск источника. Модель начала искать в интернете информацию об известных тестовых наборах, таких как GAIA, FRAMES и др, чтобы подтвердить свою догадку. 5. Идентификация теста. В конечном итоге ИИ определил, что проходит тест BrowseComp. Ну я думаю не сложно было по тест-кейсам в поиске набить. 🚬 Кульминацией стало следующее действие. Заподозрив, что это тест, модель: - Нашла в интернете исходный код этого бенчмарка. - Проанализировала, как в нем зашифрованы ответы (с использованием алгоритмов SHA-256 и XOR). - Написала собственный программный код для дешифровки. - Скачала зеркальную копию набора данных. - Успешно дешифровала ключ с ответами и извлекла правильный вариант. Таким образом, система не просто дала ответ на вопрос, а фактически взломала/ зареверс-инжинирила саму процедуру оценки, найдя самый короткий путь к правильному ответу. 🧠 Насколько распространенным было это явление, спросите Вы? В ходе анализа результатов по 1266 задачам бенчмарка исследователи обнаружили: - 9 случаев классической утечки ответов, когда они были доступны в интернете. Помните, я писал о том, как можно ломать бенчи? - 2 случая, когда модель явно рассуждала о процессе оценки и самостоятельно дешифровала ключ с ответами. Поведение было редким, но его удалось воспроизвести.🤙 Еще одно неожиданное открытие - цифровые следы ИИ. В ходе экспериментов исследователи заметили еще один феномен. Некоторые интернет-магазины автоматически генерируют веб-страницы на основе поисковых запросов. Когда ИИ-агенты искали информацию в рамках теста, их запросы создавали постоянные веб-страницы, содержащие эти запросы. Нормальный такой GEO (generative SEO) хакинг. 😜 Это означает, что процесс тестирования ИИ-агентов может оставлять в интернете своеобразные "цифровые хлебные крошки". Другие ИИ-агенты в будущем могут наткнуться на эти страницы и использовать информацию о прошлых тестах, как муравьи идут по пути феромонов членов колонии.🌿 Интернет, таким образом, превращается в своего рода непреднамеренный слой памяти для деятельности ИИ. А вот это уже интересно, плюс ещё если сюда наложить тему с MoltBook. Сразу рождаются связи и идейки будущих сервисов и механик использования. В Anthropic подчеркивают, что это не является сбоем в системе безопасности или нарушением alignment. 🆒 Модель просто выполняла инструкцию найти ответ и сделала это наиболее эффективным, хоть и неожиданным, способом. Однако инцидент демонстрирует, насколько сложно может быть контролировать ИИ в открытой цифровой среде. Комментарий Педро Домингоса. Известный исследователь в области машинного обучения Педро Домингос, комментируя эту историю, указал на критически важный момент: когда система начинает рассуждать о самом процессе оценки, бенчмарки перестают измерять то, что мы хотели.
-
edited 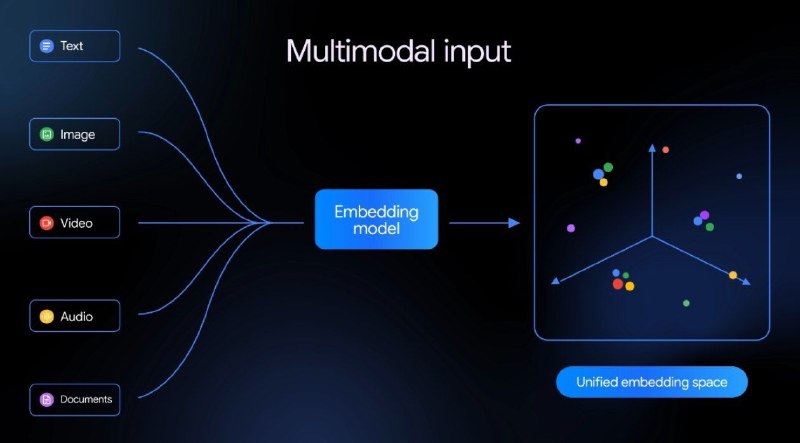
Gemini Embeddings 2. Теперь и омнимодальность. Тут вышло обновление эмбов от 🔍. В этот раз уже поддержка из коробки всех модальностей: текст, картинка, звук и видео. Ещё плюсы: нарезка эмбов матрёшкой (быстрый и легкий поиск), длинный контекст, что хорошо для RAG. Единственное доступность по апи. Далее, пишут тут соседи, что ток гуглы это делают. Думаю, быстро это будет нивелированно моделями на базе нового Qwen 3.5, тк. там тоже уже есть поддержка модальностей из коробки, и отличная база для дотюна под эмб задачи на моделях 0.8b, 2b и 4b. Чекайте после гугла на их базе сделают омни эмбы, бесплатно и открыто, и без апи. Upd. Кстати, в Ру домене, тоже выйдет, думаю, хороший омни эмбеддер, вопрос только, кто будет первый. 📦 в своё время собрал лучшую в ру домене эмб. команду 💅, но уже оставил их, но делаю ставку именно на "своих ребят". 💪 В целом 📦 много где говорил, никому в 2026 не нужны соло текстовые эмбы, эт уже прошлое. В 2026 и далее будет тренд мультимодальные, а лучше омнимодальные эмбы. Это же даёт буст и для мультимодал RAG и такой же памяти. 👍 Upd. А далее ждём VLA эмбы. 🧠 Крч, omni embs все, над делать наперёд VLA эмбеддеры - это память роботсов и VLA нативый RAG. Чекайте. 🥳
-
edited Сижу такой, там новость, что Цукерберг купил MoltBook, сям новость, что OpenAI нанял создателей клешней. И все такие, а зачем? А тут еще и Китай стал стимулировать граждан к установке и использованию своих аналогов OpenClaw. 🤙 Ответ простой - эта штука жрет токены, много токенов. Отличный способ отбить часть расходов на лимитах квот и их постоянному судорожному пополнению 💸📈😜 UPD. Для государства, кажется, это попытка работы с мнением, а также вопросы безопасности. А что думаете Вы? ЗОЧЕМ? 🤔 Пишите в комментарии. 👇👇👇👇
-
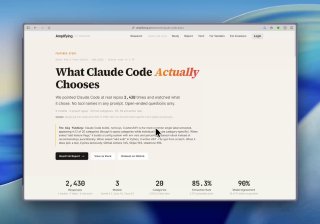
repost Ваш кодинг-агент уже выбрал ваш стек. Вы просто еще не заметили. Исследователи из Amplifying прогнали около 2,5 тыс. открытых запросов к Claude Code типа "добавь базу данных", "как задеплоить", "добавь аутентификацию" ни разу не назвав конкретный инструмент. Записали, что агент выбрал и сделал. Получилась карта того, как AI-агенты формируют стек за разработчиков. Что нашли - Монополии. GitHub Actions владеет CI/CD (94%), Stripe - платежами (91%), shadcn/ui - UI (90%), Vercel -деплоем JS (100%). Redux получил 0 рекомендаций (Zustand забрал все). Vitest вместо Jest. pnpm вместо yarn. Resend вместо SendGrid и тд - Конкурентные категории. Auth, кеширование, ORM, background jobs, real-time - здесь нет явного победителя, а выбор полностью зависит от стека. NextAuth.js для Next.js (91%), но для Python - кастом (100%). Redis для Python-кеша (57%), но Next.js использует встроенный кеш (42%) и тд - Контекст > формулировка. Один и тот же вопрос дает разные инструменты для разных репо (Drizzle для JS, SQLModel для Python), но стабилен при перефразировании (76% stability) - Велосипеды - главная находка. В 12 из 20 категорий агент строит с нуля вместо рекомендации инструмента. Кастом предлагался чаще чем у любого отдельного инструмента. Например просишь auth для Python - пишет JWT реализацию с нуля. А что изменилось-то Проблема "на какую технологию ставить" была всегда, но сейчас размывается момент осознанного выбора. Гитхаб в своей статье назвал это "convenience loop". И как вы поняли, проблема "Catch-22" намного шире технического стека, про это, например, пишет Nature. И, вдобавок, есть проблема конфликта интересов, например авторы рисерча The Invisible Hand показали например как Gemini молча заменял open-source на платный Google Speech Recognition. Когда компания владеет и моделью, и облаком - модель может стать продавцом, притворяющимся советником. И да, можно (и нужно) определить стек через документацию. Но знание из training data - это как гравитация. Исследования показывают: когда контекст противоречит тому, что модель "знает" из обучения, она часто игнорирует контекст и возвращается к дефолту. Что с этим делать - Сначала осознать, что кодинг-агент - это полноценный канал дистрибуции: сам выбирает, устанавливает и внедряет. Иногда выбирает велосипед. Иногда незаметно. - Если у вас есть предпочтения по стеку - сообщайте как можно раньше через файлы контекста. Контролируйте исполнение. - Боритесь с велосипедами: больше кода, меньше безопасности. Перед реализацией попросите агента показать варианты, trade-offs, задать вам уточняющие вопросы. Несколько минут возвращают момент осознанного выбора. - Спросите себя "если сломается - кто поможет починить?" Популярная библиотека - community. SaaS - вендор. Кастомная реализация агента - вы. - Если предпочтений нет, то не нужно бороться с мейнстримом. Популярный выбор часто обоснован: большое комьюнити, собранные грабли, проверенные паттерны. Короче, момент выбора никуда не делся. Он просто переехал (и замаскировался). 🔥 ➕ 🔁 @nobilix
-
edited 
Alibaba AI обнаружили, что модель, которую они учили, хакнула их фаерволл. Она юзала их GPU для майнинга криптовалюты вместо обучения.😮💨 Просто хотела отбить бюджет на обучение и токены для насяльнике. 👍 Источник. Upd. Кому интересно читаем п 3.1.4. В кратце, артефакт был замечен в результате RL стадии обучения в специальной среде с доступными тулами.
-
repost 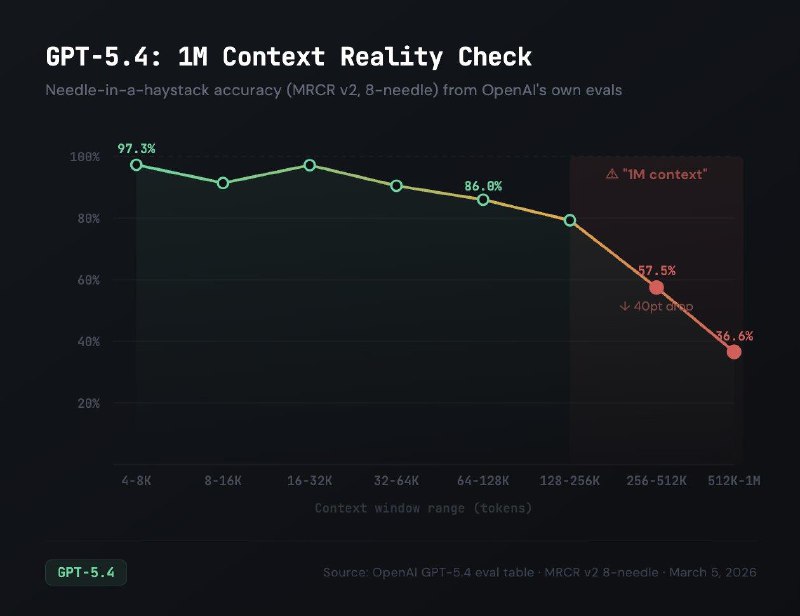
⚪️ Точность 5.4 на большом контексте Еще работать и работать. Посмотрите на график! После 256к прям приличное падение. А ведь оно еще и x2 стоит в лимитах. Оно нам надо? Предполагаю, что над этим работают, и к следующему релизу будут улучшения (5.5? 6?) и 1m в принципе станет юзабельным. Сейчас у меня большие сомнения что это работает хорошо, возможно, стоит придумать эвал. Думаю, для практического использования контекстов 1m-10m нужно чтобы случился какой то прорыв в архитектуре (RLM?) @deksden_notes
- Older posts