
Возможный полный сахар оптимизаций SSD с прекомпьютом и early exit.

Жоский ИИ Дядя Твой личный поставщик AI 🦾🤖 Канал о мире интересного AI: теория, приклад и meme👾 Для связи @dealer_ai (реклама и консультации по AI для бизнеса). Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст РКН: 6348592885
Возможный полный сахар оптимизаций SSD с прекомпьютом и early exit.

Схема на примере RAG с KV-cache для SSD
Speculative Speculative Decoding – асинхронизируй это. Вышел просто мёд для глаз моих в сфере оптимизации инференса.😜 Звать будем сокращённо SSD. Чуваки из TriaDao выпустили асинхронную версию speculative decoding. Это важно прочитать до того как пойти дальше. Напомню, что стандартное спекулятивное декодирование ускоряет инференс LLM, используя быструю малую модель для предсказания токенов, которые затем проверяются большой моделью. Как это делается? Пусть вероятность токенов из модели черновика q(x), вероятность этих же токенов для модели верификатора p(x), тогда: 1. Если q(x) <= p(x) мы принимаем драфт. 2. Иначе реджект с вероятностью p(x)/q(x). 3. Если отклонён, остаток добирается из распределнния разницы norm(max(0, p(x) - q(x)). Логично, что для каких-то токенов там будет 0, далее остальные из хвоста топК будут давать положительную разницу. Её отнормируем и примем за вероятности и уже оттуда выберем. Ну и типа это сродни x~p(x) с сходимостью по вероятности. Однако SD само по себе имеет последовательное ограничение: черновая модель должна ждать завершения верификации перед началом следующей спекуляции. SSD устраняет эту зависимость, запуская черновую модель на отдельном устройстве асинхронно – во время верификации она предсказывает вероятные исходы проверки и готовит спекуляции для них заранее. Если "хороший" исход оказывается в подготовленном наборе, спекуляция возвращается мгновенно, полностью устраняя задержку от малой модели. Также вводится понятие saguaro sampling 💃- это новая схема сэмплирования, которая изменяет форму остаточного распределнния (такое вот а-ля температура) на наиболее вероятных токенах черновика, уменьшая их вероятность при сэмплировании. Кажется, что тут есть противоречия, верно? Фраза прям витиеватая. Ща поясню на пальцах. Тут над вспомнить как в начале я писал про стратегию SD. Вернитесь перечитайте. Итого, проблема, которую решаем. Нужно угадать, какой токен выберет большая модель после проверки. Решение: 1. Берём топ-5 самых вероятных токенов по мнению маленькой модели. 2. Искусственно занижаем их вероятности при генерации черновика. 3. Это заставляет "остаточное распределение", куда большая модель смотрит, концентрироваться на этих же топ-5 токенах, без отбрасывания самых топовых, как я писал выше. Почему это работает: Большая модель смотрит: "А что если вычесть то, что уже предложил черновик?" Если черновик "скромничает" и занижает вероятности топовых токенов → разница становится больше → большая модель с большей вероятностью выберет именно их. Ещё случаются в таком семплинге промахи из-за кандидатов на асинхронных gpu, чем больше батч. Причём размер батча отсечки, когда какая стратегия, тоже приводят. Отсюда и fallback стратегии. Выкладки по стратегии fallback и оптимизации kv-cache, кому интересно, читайте статью. Формулы там повеселее, но приведу ещё один пример на пальцах. Аналогия с рестораном. Представь, что ты работаешь в ресторане и готовишь заказы наперёд. Твоя стратегия как в SSD: Пока клиент ест - верификация идёт, ты готовишь топ5 возможных следующих блюд на выбор. Кладёшь их на полку - kv кэш спекуляции. Попадание в кэш. Клиент заказывает "пасту карбонара". У тебя есть на полке! → Мгновенно отдаёшь. Промах кэша. Клиент заказывает "ризотто с грибами". На полке нет! → Приходится готовить с нуля, что медленно, но уже условно не N, а log(N) сложность. Тут предлагают выдать случайный токен или работать с вероятными n-gramms. В плане рестика, конечно, не самый вариант дать челу рандомное блюдо, но тут и не ресторан 👍 В результате получаем до 2X быстрее, чем оптимизированное спекулятивное декодирование. До 5Х быстрее авторегрессионного декодирования. 😎 Всё. 📦
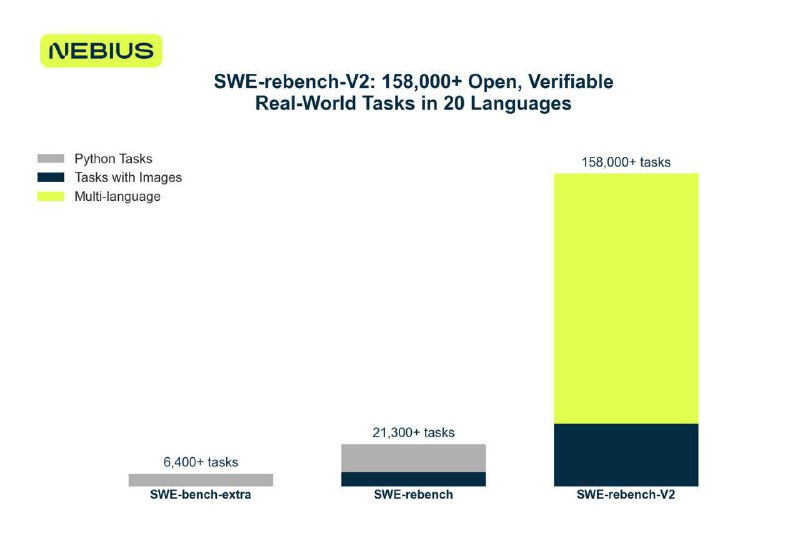
Последние пару месяцев я плотно работал над этим релизом, и наконец-то мы выкатываем его в опенсорс! 📟 Встречайте SWE-rebench-V2: самый большой открытый, мультиязычный датасет для обучения кодовых агентов! Вместе с командой Nebius AI R&D мы построили пайплайн для масштабного сбора задач из реальных GitHub репозиториев и теперь делимся всем с комьюнити. На текущий момент это самый большой и разнообразный открытый датасет подобных задач в мире. Что внутри: > 32 000+ задач — на базе реальных issue + готовый Docker-образ. > 20 языков программирования. Некоторые языки (например, Lua или Clojure) вообще никогда раньше не были покрыты! > 120 000+ дополнительных задач, собранных на базе реальных PR. > Качество — задачи отфильтрованы и размечены с помощью ансамбля LLM. Также мы обогатили их метаданными и добавили интерфейсы, которые проверяются в тестах. Вместе с датасетом мы дропаем техрепорт со всеми деталями нашего пайплайна и прогонами моделей. 📄 Статья и датасет 👾 Наш Discord (мы там онлайн, залетайте с фидбеком и вопросами). ✉️ Пост в X Если есть любые мысли, идеи, предложения - приходите! 🔁 Буду благодарен за репост и пересылку!
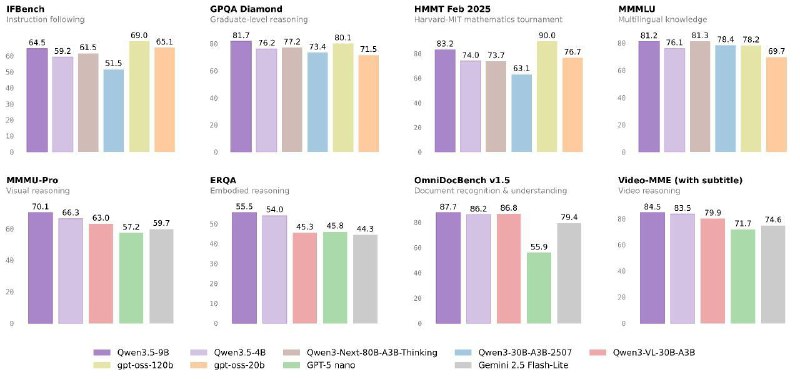
Тут кстати выдался скорый повод для рубрики #ИИзнанка про метрики LLM на примере легких моделей Qwen 3.5. Модели, кстати, таки вышли в открытый доступ и можно найти их в HF. Ребята в соседних чатах интересуются, как так 9b лучше по тестам 80B из семейства Qwen3? Для ответа на этот вопрос, я бы дождался техрепорта, которого в репо ещё нет – там, пока, paper не залинкован. Может, дело в развитии их гибридного внимания о котором я писал тут? Или же нативная мультимодальность – нет больше отдельных VL версий? А ещё, может, виновато расширение языковых возможностей до 201 языка? Посмотрим. 🤷♂ Но как обычно работают с метриками всякие злодеи - кратенько расскажу. Тут вариантов не так уж и много. Самый наглый способ дотянуться до открытых тестовых сетов бенчей. Просто тупо их скачав в свой претрен или тюн. 😐 Далее, кто похитрее, аугментирует доступные публичные тестовые примеры 🧠 и уже аугментации кладёт в обучение. Можно конечно и с дистилляцией извращаться, пылесося знания сильных моделей, которые тоже, как бэ, могли вобрать в себя публичные бенчи. Ну и конечно путь сильных, действительно сделать что-то интересное с тюном честно, поэтому ждём репорт. А там посмотрим. 🆒

Coming soon😜 Upd. 2-4b на агентов и тулколл с MemAgent, 0.8b-4b на эмбы 💪
Первый пост из рубрики #ИИзнанка будет в виде старого курьёзного случая. Он также будет #безкомментариев. История: На производстве в рамках конвейрной сборки, обычно, все под счёт и деталей должно хватить ровно на изготовление изделия. Некоторое производство холодильников. У конвейра стоит Петрович и собирает очередную партию. Собирает холодильник, а осталась одна деталь. Петрович, понимая, что-то не так, разбирает изделие и снова собирает. Остаётся две детали и целый холодильник, полностью рабочий. Так он делал до тех пор, пока не собрал два холодильника. 😱 Оказалось, что коллеги заводчане решили его так подколоть, подкладывая в цех по одной детали на круг. 😌 Мораль сей истории в рамках AI сегодня такова: Как бы ты не разбирал open-source код решений из модных открытых архитектур LLM, взять и собрать из этого на своих данных, даже с достаточным числом gpu, то же самое просто так – не получится. Да оно работает, вполне исправно, но качество... Всегда остаётся какая-то деталь или детали, отделяющие тебя от оригинала. И порой не в лучшую сторону. Особенно, когда рядом кто-то мешает... P.S. Все совпадения случайны.
Три протокола агентной коммерции: кто кого контролирует За полгода появились три протокола, позволяющие ИИ покупать товары от имени человека: ACP от OpenAI и Stripe (сентябрь 2025), UCP от Google и Shopify (январь 2026), и вчера — YCP от Яндекса. Плюс десятки MCP-серверов для отдельных магазинов (вроде ВкусВилл). Когда я вижу новый протокол, я не читаю пресс-релиз. Я смотрю на роли: кто покупатель, кто продавец, а главное — кто между ними и сколько власти у каждого. 🎭 Роли в агентной коммерции В обычном e-commerce всё просто: покупатель и продавец (иногда мёрчант и платежная система). В агентном — между ними появляются посредники: 🔸 AI-провайдер — чей ИИ общается с покупателем (ChatGPT, Gemini, Алиса) 🔸 Платёжный провайдер — кто проводит деньги (Stripe, Yandex Pay, Visa) 🔸 Платформа — где живёт магазин (Shopify, KIT, 1С-Битрикс) 🔸 Владелец протокола — кто написал правила игры 🔸 Разработчик агента — кто-то кто создал своего агента поверх протокола И вот тут начинается самое интересное. 🔍 Кто совмещает роли В ACP роли формально разнесены: OpenAI делает ИИ, Stripe — платежи, Shopify — платформу. Спека открыта (Apache 2.0). Но нюанс: Instant Checkout в ChatGPT — только для одобренных партнёров, платёжный токен пока только через Stripe, а механизма discovery для внешних агентов ещё не существует. Спека открытая, канал — «по приглашениям». В UCP Google разделил роли сильнее: 4 транспорта (REST, MCP, A2A, крипто-мандаты), 20+ партнёров включая Visa и Mastercard. Мерчант публикует манифест на /.well-known/ucp — это как robots.txt, только для ИИ-покупателей (пример https://store.moma.org/.well-known/ucp). Архитектурно — самый открытый. Но в продакшне пока тоже только Google AI Mode. В YCP Яндекс — одновременно AI-провайдер (Алиса), платёжка (Yandex Pay), платформа (KIT) И владелец протокола. Четыре роли в одном. Спека закрыта, MCP не поддерживается, внешних агентов нет даже в теории. 💡 Все три протокола — lock-in, вопрос лишь в жёсткости замка. YCP — железный засов (только Алиса). ACP — дверь открыта, но на защелке. UCP — ближе всех к реальной открытости, но пока тоже один работающий канал. ⚡ Три вопроса, которые всё решают 1️⃣ Могу ли я подключить своего бота? ACP — спека открыта, но в продакшне работает только ChatGPT, и мерчанты сертифицированы под него. UCP — архитектурно да (четыре транспорта, Agent-to-Agent), но в дикой природе тоже пока один канал. YCP — нет, только Алиса. По факту ни один протокол сегодня не даёт тебе взять спеку и запустить своего shopping-агента «из коробки». 2️⃣ Могу ли я влиять на то, как ИИ выбирает мой товар? ACP вообще не покрывает discovery — только чекаут. UCP даёт мерчанту манифест возможностей. А в YCP Алиса сама решает: у неё агент «Найти дешевле», индикаторы цен и персональные скидки. Продавец не контролирует ранжирование. 3️⃣ А если я — не продавец, а покупатель-гик? Допустим, я хочу агента для себя. Который покупает продукты по моим правилам, а не по правилам рекомендательной системы. ACP и UCP теоретически это позволяют — спеки открыты, бери и пиши. На практике — discovery нет, оплата только через определенную платежную систему, работающих примеров ноль. YCP — даже теоретически не подключить. А ведь еще предстоит решить вопрос возврата заказов (доступен только в UCP), работы с отзывами, ограничением возможностей скрапинга контента. 🎯 Вот главный гэп: все три протокола заточены под связку «продавец → ИИ → покупатель». Но никто не строит протокол от лица покупателя — чтобы мой агент ходил по магазинам с моими требованиями и договаривался на моих условиях. Пока ближе всех к этому UCP с его Agent-to-Agent транспортом, но реализаций я пока не видел. А вы ждёте агентную коммерцию? И что важнее — чтобы подключение было гарантированно простым, или чтобы можно было гибко настроить под себя? ---- Поляков считает — AI, код и кейсы
Саша нас очень поддерживает в прикладе на реальный кейс MCP от ВкусВилл, и снова раздал базы. Все-таки, он профи в SEO, а мы наблюдаем переход от SEO к GEO. 🍿 ЗЫ. пользуйтесь функцией тлдр в тг если много читать. 👇👇👇👇
Дядя ж говорил, что так будет. 💅 А теперь и у яндекс, хотя 📦 им тоже говорил, что надо. Это ожидаемо вслед за Google UCP сделать свой канал агентных продаж и брать % за фиды. Да ещё, и собирать инфу с поставщиков товаров и услуг, растя и товарную базу и диктуя ценовую политику, весь CJ будет у таких платформ. Осталось посмотреть, как это будет работать и кто в это пойдёт. Крупные игроки, приготовиться, готовы ли вы отдаться таким площадкам и где-то потерять независимость, оставшись лишь с вопросом логистики и дистрибуции? https://merchants.yandex.ru/ycp Кто-то уже пробует? Знаю тут есть техногики, жду ваших отзывов в комментариях 👍 👇👇👇👇
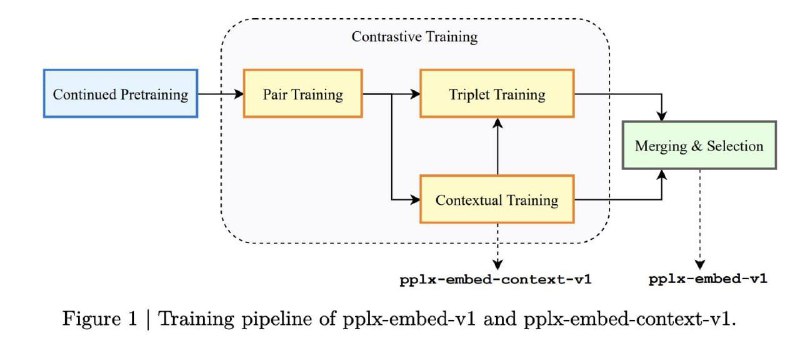
Схема обучения
Perplexity выпустил свои топовые эмбеддеры на базе Qwen3. Ребята из известного поискового решения с LLM выдали комьюнити новенькие чекпы эмбеддеров на 0.6B и 4B параметров. Возможно, именно это пригодится вам для решения соревки по RAG выше. Что сделали интересного? Помимо стандартного подхода к контрастивному обучению в несколько стадий, самое интересное это выравнивание внимания. Поясню, что это такое. Для начала вспомним, что Qwen у нас декодер, а значит маска внимания казуальная - всегда смотрит назад, от текущего токена, к первому. И относительно этого стейта и вектора предсказывает токен дальше или даёт эмбеддинг фразы. Так вот, тут была куча постов, про то, что все-таки, для задач поиска лучше двустороннее внимание, как у BERT. Проблема там и в размытыии контекста на всю фразу и в том, что в принципе казуальное внимание обслуживает задачу генерации, а не реконструкции/поиска. И вот за слово реконструкция мы зацепимся. Ведь у нас какой вариант получить biencoder внимание? Поменять маску и дотюнить контрастивно. Это уже все использовали. Ребята пошли дальше и взяли задачу реконструкции пространства вложений для токенов из Text Diffusion. И вместо MLM или контрастивного претрена на двусторонней маске, модель училась восстанавливать замаскированные токены, используя контекст с обеих сторон и операции зашумления/реконструкции. Это позволило получить биэнкодер, способный создавать более насыщенные семантические представления, чем MLM подход от BERT или контрастив претрен. Училось это все в 4 этапа: 1. Обучение на 250B токенах делать реконструкцию, 2. Далее уже шёл тюн контрастивно на парах запрос-документ, это мы называли ранее контрастив претрен. 3. Чекп с п.2 идёт на обучение с триплетами запрос-документ, где есть зазор, и параллельно учится на чанках документов с функциями ошибок in-batch* и in-sequence*. *in_batch – это поиск верного чанка из целевого документа против остальных чанков чужих документов, in_sequence – это чанки внутри целевого документа против друг-друга. 4. Далее чекпы с п.3 используют SLERP merging. Это нужно для того, чтобы сохранить свойства как поиска документов, так и поиска чанков внутри документа. Итого мы получаем модель, заточенную под RAG задачи. При этом выровненную с помощью Text Diffusion подхода. Очень интересная статья. Кстати, вот вам к соревнованию ещё один опус "RAG умер, да здравствует RAG 2026". Upd. Для ленивых эмбы тут.
МАС нейрослоп, как синта для LLM. Как-то говорил, что агентные системы будут одним из источников данных в эру, когда датка появляется медленнее, чем ее поглощает обучение моделек. И вот челики выложили способ получить датасет с логами диалогов код-агентов. Зачем? С одной стороны, дословно, они про демократизацию ИИ: DataClaw This is a performance art project. Anthropic built their models on the world's freely shared information, then introduced increasingly dystopian data policies to stop anyone else from doing the same with their data — pulling up the ladder behind them. DataClaw lets you throw the ladder back down. The dataset it produces is yours to share. Turn your Claude Code, Codex, and Gemini CLI conversation history into structured data and publish it to Hugging Face with a single command. DataClaw parses session logs, redacts secrets and PII, and uploads the result as a ready-to-use dataset.(с) С другой стороны, это позволяет вам использовать такие данные (тут полный набор в HF текущих сетов) для анализа и обучения LMок. Конечно, чтобы не словить слопа, нужно предварительно это дело почистить и привести в нужный для sft вид. Дерзайте и делитесь, код тут. 👍
Кроха Айя, или новая small-LM от cohere для МАС. Когере радует не только своими поисковыми моделями (embs) и RAG сервисами, но и выпустило маленькую модельку (даже целое семейство) под агентные нужды. Размером всего 3B параметров, поддержкой более 70 языков, причём утверждают, что выровненных и "равноправных". Для этого модели были обучены на 5 языковых кластерах, и выложены также в рамках семейства с языковой специализацией. Самое интересное - это как учились модельки. Вспоминая phi серию от майкров, и их "вау" метрики, на ум приходит с одной стороны дистилляция, а с другой обучение на заугментированном тесте открытых бенчей. Иначе откуда от такой малыхи high метрики. Что же у Aya? Fusion-of-N дистилляция ответов из К лучших моделей, в качестве учителей. Для отбора и агрегации самых качественных компонентов ответа, используется судья Fusor. Т.е. не только китайцы абьюзят модельки конкурентов, вы понимаете?) Второй подход, тоже уже ставший стандартом, это merging моделей на разных этапах обучения. Ребята назвали это sim-merging. Делалось это для предотвращения катастрофического забывания от региональных спец. моделек. Рег. чекпы объединялись с глобальной моделью, а выбор операторов слияния основывался на сигналах схожести. Обучение проводилось на 64-ех картах класса H100. Использование для edge устройств. Такой размер моделек и мультияз сразу намекает на фаст инференс и возможности применения на носимых устройствах или вашем утюге. При использовании квантизации в 4bit (Q4_K_M) можно добиться 2.15гб размера Aya, при потере качества в 1.4 пункта. На замерах скорости генераций с iPhone 13 получили 10 токенов/с, на 17 pro уже 32 токена/с. Применение и ограничения: При этом очень важно понимать,что может модель. Она справляется с генеративными задачами на ведение диалога, в CoT слабее, требует хорошего промптинга, а для RAG надёжных внешних источников, тк из весов знания могут быстро устаревать.
(sticker without text)

Тут Китайчат обвинили в knowledge distillation. 💳 Мол топ3 модели абьюзят антропик по апи и юзают их генерации для дотюна моделей. По этому поводу у нас #meme. 👍 Пару слов от 📦. Работает ли? Да работает. Вспомним старый добрый alpaca в 2023 году, как способ отдистиллить small LM-кой Llama модели. Можно брать их методологию и репо для воспроизведения на up to date моделях. Далее, конечно, по пользовательскому соглашению это запрещено. Читайте офферту 🚬. Но помните, что это юзают для SFT, те для тюна моделей. А это накладывает требования на базовую модель, те претрен должен быть сильным и хорошим фундаментом. Починить его даже sft не поможет, даже с дистиллятом поведения GPT. Поэтому снимаем шляпу перед Китаем за базу. А если у вас плохая база, вам как с домом, придётся разобрать до фундамента модель, чтобы её починить, поэтому не все так просто. 🥴 И китайцы всеравно молодцы. 😎 https://x.com/anthropicai/status/2025997928242811253?s=46
Эссе из блога Working Theorys про настроения в tech прямо сейчас. Еще недавно на вопрос «чем занимаешься?» престижно было ответить «запускаю стартап» или «закрыли seed раунд». Сегодня - «я в OpenAI» или «строю продукт в Stripe». Раньше хвастались риском. Теперь хвастаются тем, что не могут проиграть, но все еще могут выиграть по-крупному. Стабильность стала статусом. Корень сдвига: мы сами стали активами, и эти активы переоцениваются. Навыки, которые строились годами, резко подешевели. Компании делают больше меньшим числом людей. Если ты по-настоящему лучший - тебя по-прежнему хотят все. Если просто хороший - этого может не хватить. Что цепляет в статье: - AI-лабы строят новый FAANG. Для сильных исследователей - драфт в высшую лигу. Для остальных - rest and vest с хорошей компенсацией. Настоящая причина идти в Anthropic или OpenAI - близость к информации, деньгам и решениям. Когда никто не понимает, что происходит, узнавать первым - уже преимущество. При этом компании параллельно строят то, что заменит собственных сотрудников, и откладывают бюджеты на выходные пакеты. Дарио Амодеи уже пишет эссе про программы поддержки людей, которых сделают ненужными те самые модели, которые эти люди помогали строить. Но быть внутри того, что тебя заменит, все равно приятнее, чем быть снаружи. - Венчурный путь снова в цене. Не потому что «строю единорога», а потому что дает 5-10 лет запаса, пока у остальных горизонты сжимаются. Стабильность в дефиците, а дефицит и есть статус. Самый горячий ход момента - построить что-то на фронтире, собрать внимание и продаться крупной лабе до того, как она тебя раздавит. Реакция на покупку OpenClaw командой OpenAI была в духе «поздравляю, зафиксировал результат». - Середина вымывается. Средние стартапы, средний уровень навыков, средние креативные карьеры - все под ударом. Выживают два типа: маленькие и прибыльные, или те, кто берется за тяжелое - deep tech, biotech, атомы вместо битов. Если рисковать всем - рискуй на чем-то тяжелом. - Собрать продукт - теперь простая часть. Один человек с Claude Code делает работу команды. Разница между победителями и остальными - вкус (good taste). Фильтр - способность поддерживать продукт. Устойчивое преимущество - удовольствие от процесса. Начать можно одному, остаться одному нельзя. - Обслуживать передний край стало привлекательнее, чем владеть им. Фриланс, консалтинг, подкасты, кино. Те, кто умеет захватывать внимание - новые инженеры, а инженеры стали квалифицированными ремесленниками. Строить умеют многие, но мало кто умеет заставить почувствовать. - Когда обычные пути начинают ощущаться как лотерея, настоящая лотерея выглядит рационально. Крипто, мемкоины, ставки - это не безрассудство, а другой ответ на ту же нестабильность. Раньше играли, чтобы сбежать из стабильного класса. Теперь играют, чтобы в него попасть. - Из tech нельзя уйти. Технологии проникли в медиа, здоровье, спорт, производство. Можно пойти в юридическую школу или медицину - но и там все конвергирует вокруг технологий. Отдельно про разворот к «традиционным ценностям» - дом, семья, тело, здоровье. Автор считает, что это не политический тренд, а поиск стабильности за пределами карьерной лестницы. Разворот к тому, что накапливается даже когда системы рушатся. Вижу то же самое у друзей в штатах. Те, кто 2-3 года назад горел идеей запустить AI-стартап, сейчас спокойно идут в крупные лабы или поднимают большие раунды не ради масштаба, а ради запаса прочности. Никто больше не стесняется сказать «мне нужна подушка». Раньше это считалось слабостью. Сейчас - здравый смысл. Главная мысль статьи: настоящую стабильность не найти в компании или должности. Она только в ремесле, в людях рядом и в себе самом. Минимально жизнеспособная стабильность - это портфель: работа, здоровье, отношения, идентичность. Мы понемногу понимаем, что к этому портфелю не готовы.

#meme выходного дня. Завирусилось.
Чтобы не писать одно и тоже, положу сюда, как продолжение серии: https://openai.com/index/harness-engineering/ Ребята из OpenAI приводят пример как сделали проект, без собственного (человеком) написания кода с Codex.
Это был прогрев Самы к их бенчам от OpenAI 😏 🚬 🫥 https://fixupx.com/openai/status/2024193883748651102?s=46 За этим все, всем доброй ночи, а за новость спасибо Тимуру