
Наша FRIDA набрала 100 лайков на hf (давайте еще накинем) и достигла среднемесячного числа скачиваний в ~200к. А в этом месяце все 300к+. Также FRIDA активно используется в финтехе, бигтехе и на соревнованиях. Присоединяйтесь к числу пользователей.

Жоский ИИ Дядя Твой личный поставщик AI 🦾🤖 Канал о мире интересного AI: теория, приклад и meme👾 Для связи @dealer_ai (реклама и консультации по AI для бизнеса). Head of AI, ГенИИ конструктор, AI-евангелист, AI-энтузиаст РКН: 6348592885
Наша FRIDA набрала 100 лайков на hf (давайте еще накинем) и достигла среднемесячного числа скачиваний в ~200к. А в этом месяце все 300к+. Также FRIDA активно используется в финтехе, бигтехе и на соревнованиях. Присоединяйтесь к числу пользователей.

Вайб Цех Первый раз в жизни собираю митап! Когда мы прогоняли сегодня с ребятами материал для конфы я понял, мы собрали реально очень полезную инфу для вас! И от 0 и до 100 по сложности есть! Значит будет интересно! Ссылка на онлайн стрим https://red-mad-robot.timepad.ru/event/3605115/ 25.10.2025 Дядя вещает вещи: https://t.me/dealerAI
Буду в СПБ в Субботу 👇👇👇

Писал уже, что рано или поздно оно будет, ну и вот. Upd. Даже в посте про Regen об этом говорил. Теперь жду интерактивные рекомендашки. Интерактивный поиск с чат окном уже есть. Ток оно не работает ни на чем кроме mac...челы на Интел маках тоже со...вершенно не у дел пока. https://openai.com/index/introducing-chatgpt-atlas/ Experiences for Windows, iOS, and Android are coming soon Upd. А я одинь заметил тонкий троллинг Google? Atlas это одна из их статей про long context и память) А еще вот такое!!!
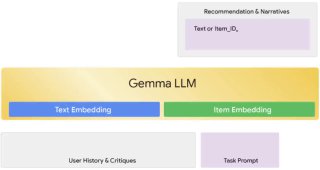
Архитектура LUMEN
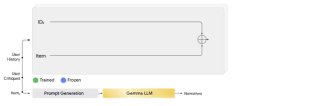
Архитектура FLARE
REGEN – новый подход к рекомендациям на основе диалогового взаимодействия. Традиционные рекомендательные системы сосредоточены на предсказании следующего товара, который может понравиться пользователю, но не способны вести естественный диалог, понимать отзывы на естественном языке или объяснять причины рекомендаций. Существующие архитектуры и наборы данных не позволяли изучать эти новые возможности, теперь же есть REGEN от Google (Reviews Enhanced with GEnerative Narratives). Работа поделена на два важных аспекта: 1. Датасет для измерения качества подобных взаимодействий юзера, рекомендательной системы и диалогового интерфейса. 2. Предложены и протестированны две архитектуры рекомендаций: FLARE - на базе коллаборативной фильтрации; и LUMEN - на базе LM (Gemma LLM), учитывающей, как интеракции user-item, так и текстовые взаимодействия. Люмен заявили впервые именно в статье REGEN. Начнём с данных. Созданный набор данных REGEN был собран не совсем с нуля – исследователи дополнили общедоступный Amazon Product Reviews dataset, синтезировав с помощью LLM Gemini 1.5 Flash два ключевых элемента: 1. Критика: Примеры того, как пользователь может выразить предпочтение или критику в диалоге (например, "Я бы предпочел черную ручку, а вы предлагаете мне красную"). 2. Нарративы: Разнообразные текстовые пояснения, такие как причины для покупки, отзывы о продуктух или предпочтения пользователя. Архитектуры моделей. Как уже упоминалось, были предложены и протестированы два подхода: 1. Гибридная система FLARE. Классическая модель аля SASRec предсказывает следующий товар, а легковесная языковая модель Gemma 2B генерирует нарратив на основе этого предсказания. 2. Единая модель LUMEN. Одна большая языковая модель обучается для совместного выполнения задач: обработки критики, генерации рекомендации и создания нарратива в рамках единого процесса. Модель учится e2e "решать", когда выдать ID товара, а когда продолжить генерировать текст. Дизайн эксперимента и метрики. Эксперименты были построены вокруг предложенной авторами статьи задачи – совместной генеративной рекомендации товаров. Модели получали историю покупок и, опционально, текстовую критику, после чего должны были порекомендовать следующий товар и сгенерировать о нем контекстуальный нарратив. Для оценки использовались два типа метрик: - Метрики точности рекомендаций. Основной метрикой был Recall@10 – насколько часто желаемый товар оказывается в топ-10 предсказаний. - Метрики качества текста. Для оценки сгенерированных нарративов использовались BLEU, ROUGE и семантическое сходство cosine similarly (используют Gecko эмбы). В итоге, включение пользовательской обратной связи в модели улучшало Recall@10 для обеих архитектур. Разумеется, для модели на базе e2e подхода LUMEN качество согласованности было лучше, ввиду исполнения LM как базы архитектуры. Однако и последовательное использование FLARE, как next item prediction+LM также улучшало метрики. Для подробного изучения показателей бенчей советую заглянуть в статью. В целом, основная идея авторов создать новый подход на основе не только исторических интеракций юзера с товарами, но и посредством воздействия естественного языка в виде обратной связи (отзывов, критики и пр.). Это же позволяет перевести рекомендации и поиск в "живой формат" диалогового взаимодействия, возможностью уточнения и обратной связи. Представьте, вам не понравились рекомендации, вы просто пишите: "неплохо, но я бы хотел видеть тут <целевой объект>". А система тут же реагирует на это в виде обновления пула. В целом, мы уже видим на примере Perplexity и OpenAI переход в диалоговое взаимодействие с их решениями, как наиболее нативное и удобное. Теперь очередь рекомендательных систем.
Вспомнить все: трек памяти для LLM на AIJ contest 2025. Приоткрыли завесу тайны, что за соревнование, дали пару советов и кое-что пошерили для вас. Лайк на Хабре, участие в соревке и ваши мысли, приветствуются ;) Пост: https://habr.com/ru/companies/sberbank/articles/957292/ P.S. И как вовремя qwen.chat.ai выпустили свой вариант ассистента с памятью. Хороший обзор у коллеги по цеху.