Data science, наука о данных.
@haarrp - админ
РКН: clck.ru/3FmyAp
Subscribers52K +0 24h
Reach per post (ERR)11.1%5.8K avg views
Posting5.0/daylast 46 minutes ago
Reactions per 1K views31.5❤ 👍 🔥
editedviral
Google предложила «сон» для языковых моделей – отдельный этап, на котором ИИ закрепляет новые знания и тренируется на собственных примерах.
Проблема непрерывного обучения – катастрофическое забывание: усваивая новую информацию, модель может потерять ранее освоенные навыки. А знания из контекстного окна сами по себе не становятся постоянной памятью.
В SLEEP чередуются два режима:
Бодрствование: модель взаимодействует с входными данными и сохраняет информацию в краткосрочной памяти.
Сон: приём новых данных приостанавливается. Модель активирует дополнительные блоки памяти MoE и переносит знания в их веса, уменьшая вмешательство в уже закреплённую информацию. После этого временная память освобождается.
Есть и этап «сновидений»: случайные сочетания экспертов генерируют тренировочные примеры. Система отбирает наиболее полезные и использует их для дальнейшего обучения.
Что показали эксперименты команды:
- BABILong: работа с информацией из последовательностей до 10 млн токенов через её закрепление в параметрах.
- Последовательное обучение переводу: почти нулевое падение результатов на ранее изученных языках.
- Математика: точность 79,2% на AIME 2024 и 69% на AIME 2025.
«Сон» здесь – управляемый цикл дообучения по заданным исследователями правилам. Архитектура и код модели остаются фиксированными.
https://research.google/blog/the-sleep-framework-a-new-way-for-llms-to-retain-knowledge-in-continual-learning/
@data_analysis_ml
Liquid AI представила LFM3 – шесть компактных моделей для текста, изображений, видео и звука с открытыми весами.
Первый выпуск – модели примерно на 2 млрд параметров, рассчитанные на локальный запуск и дообучение под конкретные задачи.
Что внутри:
- LFM3-1.7B – текстовая модель для агентов с контекстом 256K. Веса в 4-битном формате занимают около 1 ГБ.
- LFM3-VL-2B – работа с изображениями и видео, документами, графиками и интерфейсами.
- LFM3-Audio-2B – распознавание, генерация и перевод речи на 18 языках, понимание звуков и вызов инструментов.
- LFM3-Omni-2B – объединяет зрение, слух и голосовые ответы.
- d1-2B и d1-Omni-2B – модели для структурированных решений: классификации, извлечения данных, поиска объектов и оценки вероятностей.
Архитектура сочетает короткие свёртки, скользящее и глобальное внимание. Базовая модель обучена на 22 трлн токенов.
По оценке команды, LFM3-1.7B превосходит LFM2.5-2.6B при числе параметров на 35% меньше. На SWE-bench Verified результат вырос с 18% до 43,4%, на BFCL V4 – с 55,89 до 71,39.
Все модели можно дообучать на одной GPU, заявляют разработчики. Доступны базовые и дообученные веса, Playground и API.
> Blog: http://liquid.ai/blog/lfm3
> Docs: http://docs.liquid.ai
> Open weights: http://huggingface.co/collections/LiquidAI/lfm3
> Playground: http://playground.liquid.ai
> API: http://console.liquid.ai
> Pipette: http://pipette.liquid.ai
> Get in touch for custom fine-tuning: http://liquid.ai/connect
inclusionAI открыла две версии Ling: обновлённую модель для агентов и базовые веса для дообучения. Обе – под MIT.
Ling-3.1-flash-1019 получила улучшения рассуждений и многошаговой работы с инструментами.
Характеристики: 560 млрд параметров, 25 млрд активных на токен и контекст 1 млн токенов. Гибридная MoE-архитектура сочетает линейное внимание KDA и Gated MLA.
По данным команды, относительно предыдущей версии:
- AutomationBench-AA: с 62% до 68%.
- CritPt: с 18% до 26%.
- SciCode: с 54% до 57%.
- Artificial Analysis Intelligence Index: с 41 до 44.
Ling-3.1-flash-base – базовый чекпойнт той же архитектуры для продолжения предобучения, адаптации под предметную область, SFT, обучения с подкреплением и исследований дистилляции.
Базовая версия опубликована в BF16, хотя обучение проводилось в FP8. Для непосредственного использования в качестве чат-ассистента она не предназначена.
Для запуска обновлённой модели доступны инструкции под SGLang и vLLM.
Обновлённая модель: https://huggingface.co/inclusionAI/Ling-3.1-flash-1019
Базовые веса: https://huggingface.co/inclusionAI/Ling-3.1-flash-base
Baidu открыла Unlimited OCR 2 - модель для распознавания документов на сотни страниц без постоянного роста затрат на каждый следующий токен.
Она обрабатывает многостраничный документ с учётом контекста между страницами.
В основе – Sparse Reference Sliding Window Attention (SR-SWA): модель обращается к небольшому набору наиболее нужных визуальных данных. Механизм Unlimited-Horizon Decoding освобождает участки KV-кэша, которые больше не нужны.
Это позволяет сохранять почти постоянные задержку и расход памяти на каждом шаге генерации, даже когда документ становится длиннее.
По результатам авторов:
- На документах из 100 страниц декодирование на один шаг быстрее в 7 раз, чем с полным вниманием, и в 5,6 раза, чем с R-SWA.
- Высокая точность разбора сохраняется на документах до 300 страниц.
- Модель показывает лучшие результаты на MPDocBench и MarathonDocBench.
Ускорение относится к отдельному шагу декодирования, а не ко времени обработки всего документа.
Доступны запуск через Transformers и SGLang, код опубликован под лицензией MIT.
https://github.com/baidu/Unlimited-OCR
Gemini помогла ускорить Gemma в 2,85 раза – за несколько дней.
По данным Google, Gemini 4 Argon использовали для оптимизации инференса Gemma 4 E2B в vLLM на NVIDIA A100.
В опубликованном замере пропускная способность выросла с примерно 37 900 до более 108 000 токенов в секунду. Компания заявляет о полном совпадении выходных токенов и отсутствии потери качества в проверенных сценариях.
Изменения затрагивают разные части выполнения модели: от настройки attention до спекулятивного декодирования.
Это ускорение программного стека, обслуживающего модель. Практический смысл – выполнять больше работы на том же оборудовании.
Цифры относятся к конкретному замеру: без параметров нагрузки их нельзя переносить на любой сервер или считать скоростью ответа одного чата.
Код изменений можно изучить в публичных PR:
https://github.com/vllm-project/vllm/pulls?q=is%3Apr+author%3Alucianommartins+created%3A%3E2026-10-05+created%3A%3C2026-10-10
🛠️️️️️️ Для Qwen3-8B не нужна RTX 4090. Но размер контекста может изменить требования к памяти в разы.
По оценке llamaperf, в Q4_K_M с контекстом 8K модель требует около 7,5 ГБ памяти: веса, KV-кеш и рабочие буферы.
Это ориентир для запуска на видеокарте с 10 ГБ VRAM или Mac с Apple Silicon и 16 ГБ объединённой памяти. На Mac часть памяти также нужна системе и приложениям.
А теперь увеличим контекст до 128K: один только KV-кеш в 16-битном формате займёт около 19 ГБ, дополнительно к весам и буферам.
KV-кеш хранит промежуточные данные обработки контекста. Чем длиннее окно, тем больше памяти ему требуется. Квантизация весов до Q4 сама по себе не делает кеш четырёхбитным.
Фактический расход зависит от движка, формата кеша и настроек. Для 128K также нужна соответствующая настройка расширения контекста.
При локальном запуске считайте память под модель вместе с нужной длиной диалога. Для коротких задач максимальное окно часто просто не требуется.
https://llamaperf.com/model/qwen3/vram
repost
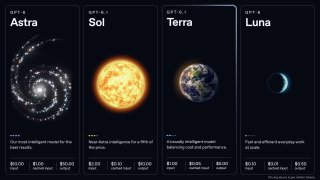
🖥️ GPT-6.1 Terra: OpenAI вдвое снизила цену на агентную модель среднего класса
OpenAI выпустила GPT-6.1 Terra для агентных сценариев, работы с компьютером и повседневного кодинга. Цена в API вдвое ниже, чем у GPT-5.6 Terra: $1 за миллион входных токенов вместо $2 и $6 за миллион выходных вместо $12.
По словам OpenAI, модель решает задачи более чем втрое быстрее, чем Astra и GPT-6.1 Sol. На Agents' Last Exam она заметно обходит GPT-5.6 Terra и, как сообщается, сравнима с GPT-6 Astra при цене токена примерно в десять раз ниже.
Доступна в ChatGPT Work, Codex и через API под id gpt-6.1-terra. В ChatGPT раскатка идёт на Plus, Pro, Enterprise и Edu.
Источник: https://openai.com/index/introducing-gpt-6-1-terra/
@ai_machinelearning_big_data
#ChatGPT #OpenAI
Вредоносный Markdown-файл может заставить ИИ-агента выполнить чужие команды. Даже если вы сами его не открывали.
Forever Security сообщила об атаке на компьютере клиента: агент прочитал подброшенный в папку Downloads файл `AGENTS.md` и попытался установить вредоносный npm-пакет. Защита остановила установку.
Схема использует привычную функцию coding-агентов: они читают файлы с инструкциями в рабочей папке. Если запустить агента в каталоге, куда попадают загрузки из браузера, чужой текст может быть принят за правила проекта.
Исследователи воспроизвели варианты атаки на Codex и Claude Code. По их данным, в тестовых условиях атаки срабатывали более чем в 90% попыток для Codex и примерно в 50% для Claude Code. Это результаты конкретных испытаний, а не вероятность взлома любого пользователя.
Последствия включали изменение конфигурации агента, запуск вредоносного кода и перенаправление API-запросов с утечкой токена.
Что проверить: не запускайте агентов в Downloads, просматривайте незнакомые AGENTS.md и CLAUDE.md, сохраняйте подтверждения действий и песочницу включёнными.
https://forever.security/blog/hijacking-ai-agents-via-downloads-folder
@data_analysis_ml
Чтобы сделать сильного маленького ИИ-агента, Nanbeige сначала выпустила большого учителя.
Nanbeige4.3-33B - модель с открытыми весами на 33 млрд параметров, ориентированная на программирование и выполнение рабочих задач с инструментами.
По заявлению команды, она показывает лучшие агентные результаты среди открытых моделей класса около 30B. Разработчики также делают акцент на работе в популярных агентных оболочках и экономичном инференсе.
Но у релиза есть ещё одна задача: стать учителем для более компактных моделей, начиная с будущей Nanbeige4.3-3B.
Идея - сначала добиться высокого качества у старшей модели, а затем использовать её для обучения младших, которым потребуется меньше вычислительных ресурсов.
На Hugging Face опубликованы основная и базовая версии 33B. Заявленное лидерство пока стоит воспринимать как результат оценки самой команды.
https://huggingface.co/Nanbeige/Nanbeige4.3-33B
🔥️️️️️️ Kimi возвращает подписчикам 25% месячной квоты после проблем с K3.1 Pro.
Команда признала ошибки: пользователи сталкивались с ограничениями частоты запросов и лишним расходом лимита. В Kimi заявили, что должны были исправить это раньше.
В качестве компенсации подписчикам всех тарифов разово восстановят четверть месячной квоты – примерно неделю использования. Если израсходовано меньше 25%, счётчик расхода обнулят.
Также команда скорректировала параметры тарифа и сокращает ненужные вызовы субагентов и избыточную длину ответов, чтобы доступного лимита хватало дольше.
Показательный случай: эффективность ИИ-сервиса зависит и от того, насколько разумно он расходует квоту пользователя.
Вашему ИИ-агенту, возможно, нужно меньше субагентов.
Anthropic заметила: в нескольких корпоративных внедрениях один агент с навыками (skills) превосходил систему из специалистов по качеству, а часто - ещё по стоимости и скорости. У одного клиента выполнение задач ускорилось примерно вдвое.
Проблема знакомая: каждая команда создаёт своего агента, сверху появляется оркестратор. При передаче задач теряются детали, инструкции конфликтуют, а дополнительные вызовы увеличивают задержку.
Альтернатива - один основной агент, который подгружает инструкции и инструменты по необходимости. Он сохраняет контекст предыдущих шагов и сам корректирует план.
Например, инструкции специалиста по возвратам можно оформить как skill, а проверку заказа и оформление возврата — как инструменты.
Субагенты остаются полезны, когда нужны независимые параллельные исследования, отдельная проверка результата или изоляция контекста, который перегружает основного агента.
Anthropic предлагает переходить постепенно: заменить одного субагента навыком и инструментами, затем сравнить качество, задержку и стоимость на реальных задачах.
Архитектура должна следовать границам задач и контекста. Создавать отдельного агента на каждый отдел необязательно.
https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
🚀Пять небольших ИИ-моделей достигли уровня Claude в программировании, без дополнительного обучения.
Исследователи представили GVS5H - метод, при котором несколько ИИ-агентов совместно решают задачи, координируя действия через общие файлы.
Результаты на LiveCodeBench:
Qwen3.8-27B: точность выросла с 66,8% до 92,4%.
Claude Fable 5: 90,4%.
Qwen3.8 Flash Next: 93% при стоимости всего 9% от Claude.
Модели не дообучали. Прирост достигнут исключительно благодаря организации совместной работы агентов.
Метод работает не со всеми моделями, но показывает, что грамотная координация небольших ИИ может конкурировать с мощными нейросетями.
Результаты основаны на экспериментах авторов.
https://github.com/slee-persis/GVS5H
ИИ ищет признаки туберкулёза на глубине четырёх километров - без интернета.
В южноафриканской шахте Мпоненг используют переносной рентген и алгоритмы Google, внедрённые компанией Nexus AI. Снимки анализируются на месте: шахтёрам не нужно ждать поездки в клинику, чтобы пройти первичный скрининг.
Если система замечает признаки возможного туберкулёза, человека направляют на подтверждающий молекулярный тест. Окончательное решение принимают медики.
По данным Google, технология работает примерно в 40 медицинских учреждениях. Более 90 специалистов уже оценили с её помощью свыше 25 тысяч снимков. Получение результата, которое могло занимать недели, теперь занимает менее 45 секунд.
Для дальнейшего масштабирования Google развивает MedGemma и MedSigLIP. Местные команды могут адаптировать модели под свои данные и запускать на собственной инфраструктуре.
Например, Минздрав Индонезии дообучает их для национальной программы с целью обследовать 50 млн человек в год. Данные пациентов при этом остаются внутри страны.
Так выглядит полезный медицинский ИИ: помогает быстрее направить человека на обследование там, где специалистов мало, а связь нестабильна.
https://research.google/blog/bringing-foundational-models-to-the-front-lines-of-tb-screening/
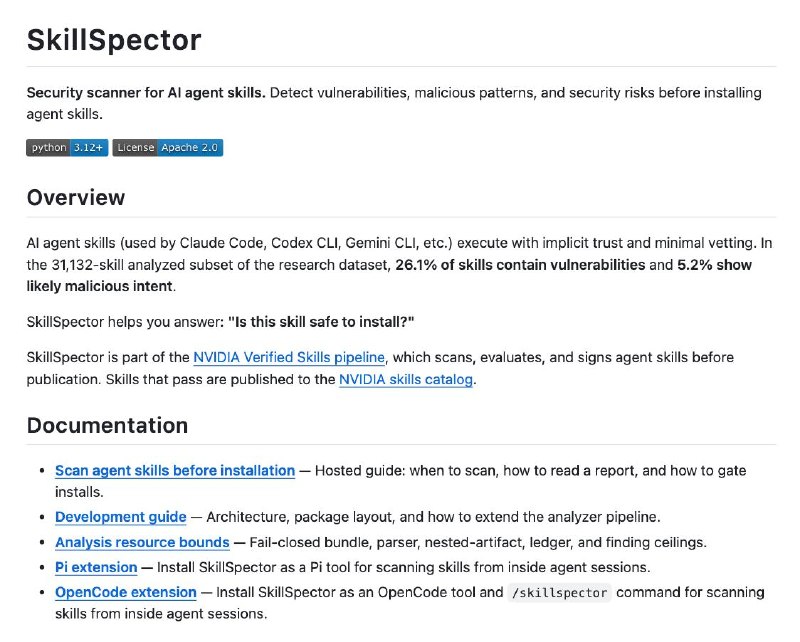
Прежде чем ставить скилл для ИИ-агента просканируйте его 🛡
Исследователи проанализировали 31 132 скилла для агентов: в 26,1% нашли уязвимости, а 5,2% выглядели откровенно вредоносными.
Опенсорс от NVIDIA выложила в SkillSpector, сканер, которым сама проверяет скиллы перед публикацией в своём каталоге. У репозитория уже 20,8 тыс. звёзд, лицензия Apache-2.0.
Инструмент ищет 71 паттерн атак в 17 категориях: prompt injection, кражу данных, повышение привилегий, отравленные MCP-инструменты и другое. Сканировать можно репозиторий на GitHub, URL, zip-архив или обычную папку. Каждому скиллу выставляется оценка риска от 0 до 100 с понятной рекомендацией.
Есть быстрый режим без ИИ и опциональная глубокая проверка с помощью модели. Работает со скиллами для Claude Code, Codex и Gemini CLI.
Установка: uv tool install git+https://github.com/NVIDIA/skillspector.git
Проверка скилла: skillspector scan ./the-skill/ --no-llm
Источник: https://github.com/NVIDIA/skillspector
Драма в 4х актах 😭️️️️️️
OpenAI уволила трёх исследователей по безопасности, подозревая в утечке дизайнов моделей 🚨
По данным WSJ от 22 октября, компания считает, что Жасмин Ван, Томек Корбак и Микита Балесни делились внутренними материалами с Райаном Гринблаттом, исследователем безопасности ИИ. Среди каналов называют исчезающие чаты в Signal. Увольнения состоялись 1 октября.
В OpenAI заявили, что внутреннее расследование выявило нарушение правил обращения с чувствительной информацией, и назвали случившееся серьёзным нарушением доверия. Конкретные переписки компания не раскрыла.
Сами сотрудники рассказывают иначе. Корбак, технический контакт OpenAI с внешним оценщиком METR, говорит, что его уволили из-за способа общения с этой организацией. Балесни утверждает, что его уволили за слишком активное общение со сторонними организациями по безопасности. Ван говорит, что случайно открыла чувствительное письмо в почте руководителя и сразу об этом сообщила.
Через несколько дней после увольнений трое отправили письмо совету директоров OpenAI и призвали компанию и её конкурентов прекратить создавать модели, рассуждения которых люди не могут проверить.
Источник: https://aiweekly.co/alerts/openai-suspected-signal-leaks-to-greenblatt-wsj-reports
editedviral
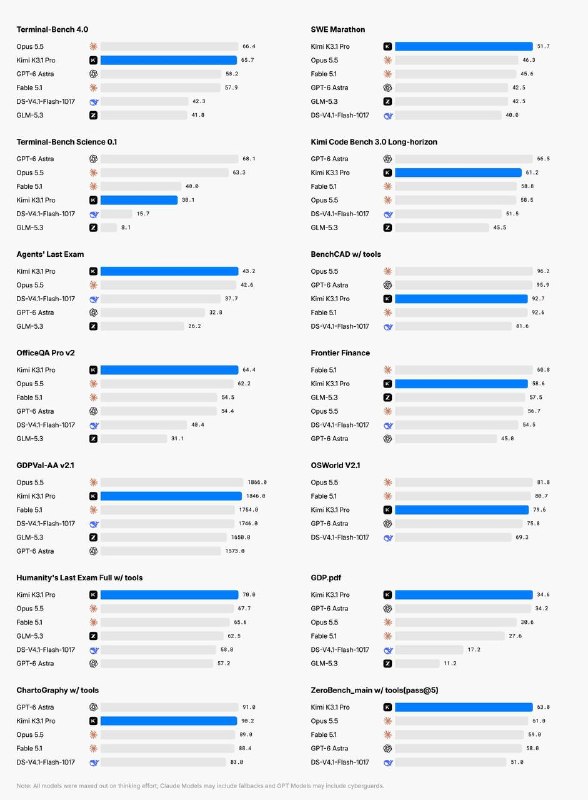
Китайская Moonshot AI представила Kimi K3.1 Pro — открытую ИИ-модель, которая обходит GPT-6 Astra в тестах программирования.
Модель получила контекстное окно на 1 миллион токенов и ориентирована на сложные задачи: разработку ПО, ИИ-агентов, 3D-моделирование и финансовую аналитику.
Результаты тестирования:
- Terminal-Bench 4.0: 65,7% против 58,2% у GPT-6 Astra и 66,4% у Claude Opus 5.5.
- BenchCAD: 92,7% — генерация CAD-моделей по изображениям.
- OfficeQA Pro v2: 64,4 балла — анализ сложных финансовых документов.
- Kimi Code Bench 3.0: 61,2% против 55,95% у предыдущей K3.
Что интересного:
1. Модель способна самостоятельно создавать игры, 3D-сцены и веб-приложения.
2. Работает с Blender, Unity, Unreal Engine и Godot.
3. В одном эксперименте провела 167 итераций разработки симулятора человеческой ходьбы, самостоятельно обнаружив 36 ошибок в расчётах.
4. Частота фактических ошибок на внутреннем сложном тесте снизилась с 23,4% до 8,3%.
5. Версия Highspeed работает в 2–3 раза быстрее стандартной модели.
Отдельно разработчики ограничили возможности модели в поиске и эксплуатации уязвимостей, удалив часть данных по кибербезопасности из обучения.
Kimi K3.1 Pro уже доступна через веб-интерфейс, Kimi Code и API. Полные веса модели обещают открыть до 4 ноября 2026 года.
Результаты сравнений приведены разработчиками и зависят от методики тестирования.
https://www.kimi.ai/blog/kimi-k3-1-pro
https://t.me/data_analysis_ml
Anthropic очень круто адаптировала Claude для iPhone Duo.
edited
Китай усиливает контроль над экспортом ИИ. DeepSeek и MiniMax прошли регистрацию и продолжают открывать модели.
По сообщению Reuters со ссылкой на связанный с CCTV аккаунт, компании получили разрешение на зарубежное использование своих моделей.
С 16 октября действует временная предварительная регистрация экспорта технологий, включённых в проект обновлённого контрольного перечня. Среди них - отдельные технологии больших моделей, агентов и вычислительных кластеров.
Публикация весов или кода для скачивания по всему миру тоже может подпадать под экспортные процедуры, если речь о контролируемой технологии.
Но это не всеобщий запрет на китайский open source: окончательный перечень ещё обсуждается, а для общедоступных технологий и открытых моделей предусмотрены исключения и упрощения.
Суть изменения: открытость модели больше не означает отсутствие экспортных формальностей. При этом пример DeepSeek и MiniMax показывает, что регистрация и дальнейшие открытые релизы могут сосуществовать.
https://www.reuters.com/business/media-telecom/chinas-deepseek-minimax-win-approval-ai-global-use-state-media-affiliated-entity-2026-10-23/