FDE: кто отвечает за то, чтобы AI заработал у клиента (Рубрика #Management) 14 октября в прямом эфире Code of Leadership поговорим про Forward Deployed Engineering — работу инженеров, которые погружаются в задачи заказчика и доводят решение до работающего результата. В гостях — Павел Голубев, Principal AI FDE Manager в Microsoft, автор Telegram-канала Corporate AI (https://t.me/corporateAI). За его плечами — промышленный консалтинг, оптимизация цепочек поставок, Data Science в Beat и EPAM, проекты для клиентов Azure в Европе, на Ближнем Востоке и в Африке. Павел работал и руководителем, и инженером на Principal IC-треке, поэтому обсудим обе стороны: как самому внедрять AI и как руководить людьми, которые этим занимаются. В прошлом выпуске с Павлом мы уже добрались до темы FDE и договорились вернуться к разговору. Теперь хочется разобраться, что за это время изменилось в самой работе и ответственности инженера. У FDE интересная задача: отвечать за результат, когда данные, процессы, доступы и значительная часть решений находятся у других людей. Причём заказчик тоже не один человек: у руководителя, пользователя и службы безопасности могут быть совершенно разные представления об успешном внедрении. Написать код в такой ситуации — только часть работы. Обсудим: — Чем FDE отличается от консультанта, solution architect и инженера продуктовой команды? — Как выглядит путь от «хотим внедрить AI» до системы, которой действительно пользуются? — Как договориться о критериях успеха и удержать границы проекта, когда запросы продолжают расти? — Что AI меняет в стоимости внедрения и где по-прежнему приходится долго разбираться с людьми и процессами? — Как FDE Manager распределяет инженеров между проектами, проверяет качество и помогает в сложных ситуациях? — Кому подходит эта роль, какие навыки нужны для входа и когда компании вообще не нужен FDE? Попробуем пройти одно внедрение по шагам: от исходного запроса до запуска и дальнейшей поддержки. Поговорим о решениях, компромиссах и о том, кто отвечает за систему после ухода команды. Приходите, если внедряете AI, руководите инженерной командой или присматриваетесь к FDE как к следующему шагу в карьере. И приносите вопросы — оставим на них время в эфире! P.S. Этот выпуск продолжит тему книжки про FDE, о которой я писал вчера. #AI4SDLC #Agents #Evals #Engineering #SystemDesign #Software

Книжный куб
Канал Александра Поломодова (@apolomodov), cto & technical fellow. https://polomodov.tech - сайт со всеми материалами youtube.com/@tellmeabouttech - канал со всеми видео
-
-
Проектирование обвязки для кодинговых агентов: что даёт обвязка (Рубрика #AI4SDLC) С большим интересом прочитал сентябрьскую статью этого года "An Empirical Study of Harness Design for Coding Agents", в которой авторы пытались ответить на вопрос, а какая часть обвязки и насколько помогает: план, инструменты или управление контекстом (авторы остановились на этих трех фактора). Вообще, авторы по классике определяют harness как среду, которая даёт модели инструменты, поддерживает ход работы и определяет, какую историю она видит. Для этой статьи авторы из UMass Amherst, Emory, UNC Charlotte и Zoom собрали свою модульную обвязку и меняли компоненты при фиксированном цикле исполнения. Сама статья пока представлена в виде препринта на arxiv, есть обсуждение на Hacker News, но на крупную конфу ее еще не подавали. Но методология статьи вполне серьёзная: 1) Четыре модели: Nemotron-3 на 30B, 120B и 550B плюс Mistral Medium 3.5; 176 конфигураций, окна 32k–128k 2) Для измерения успеха и стоимости задач выбраны два бенча: SWE-Bench Verified (500 задач из Python-репозиториев) и Terminal-Bench 2.1 (89 терминальных задач) 3) Сравнения парные, на одних и тех же задачах: тест Мак-Немара учитывает, кому достались несовпадающие успехи и провалы. Benjamini–Hochberg ограничивает ожидаемую долю ложных находок при множестве сравнений Основные результаты авторы примерно такие 1️⃣ Управление контекстом прежде всего позволяет агенту продолжить работу На SWE-Bench средний выигрыш управляемых стратегий над T0 (без управления) сокращается с 35,7 процентного пункта при 32k до 2,7 при 128k. Переполнения у T0 падают с 78,7% до 8,7%. По траекториям агент действует примерно так же, но успевает дойти до исправления и проверки. Улучшение самого рассуждения этим не установлено. 2️⃣ Дешёвая очистка истории перед суммаризацией даёт хороший баланс T4 сначала убирает объёмные старые выводы, затем при необходимости суммирует историю: дорогие вызовы суммаризации нужны реже. При усреднении по четырём окнам у неё близкая успешность и минимальная средняя стоимость среди управляемых стратегий в семи из восьми пар «модель — бенчмарк». Но по успешности она выигрывает не каждую конфигурацию. 3️⃣ Сохранённая память почти не востребована Добавление возврата старых сообщений, T2 против T1, устойчивого прироста не даёт: средняя разница −0,36 процентного пункта. В 36 из 64 конфигураций T2/T4 инструмент recall_event вообще не вызывался. Его описание само предлагает заново прочитать файл или повторить команду. Это результат о конкретном механизме возврата; бесполезность внешней памяти вообще он не доказывает. 4️⃣ План помогает слабой модели продолжать, а сильной — вовремя закончить Для Nemotron-3 30B успешность SWE-Bench растёт с 13,6% до 25,2%, стоимость тоже растёт. Без плана 68,6% запусков заканчиваются без правки, с планом — 27,8%. У 550B и Mistral, по анализу траекторий, сокращается повторная проверка: расчётная стоимость падает примерно на 30% и 32%, успешность — на 2 и 0,4 пункта. Один компонент помогает справляться с разными проблемами. 5️⃣ Shell может сделать действия крупнее и дешевле, но результат зависит от задачи Для 550B переход к bash-only на SWE-Bench повышает успешность с 65,8% до 69,4%, снижая стоимость с $2,33 до $1,11. Правки крупнее, взаимодействий меньше. У Mistral там же успешность падает с 68,6% до 45,4%, а на Terminal-Bench растёт с 37,08% до 43,82% — вместе со стоимостью. Размер модели сам по себе не определяет подходящий интерфейс. Красным отметил ограничения: по одному запуску на задачу; план и инструменты проверены только при 128k с одной стратегией контекста; вместе с инструментами меняются инструкции и автоматические проверки. И два семейства моделей — пока узкая база для универсальных рецептов. Отдельно стоит отметить, что авторы хорошо анализировали траектории работы агентов, чтобы интерпретировать результаты (это стоит забрать себе для проведения экспериментов). Во вторник, 13 октября, разберём этот whitepaper в эфире Research Insights Made Simple #AI4SDLC #Agents #Evals #Engineering #SystemDesign #Software
-
edited AI и платформа данных / Как подключить AI ко всей совокупности данных организации (Рубрика #Data) 12 октября в Research Insights Made Simple снова встречаемся с Колей Головым и в прямом эфире продолжаем разговор про платформы данных. В этот раз разберём, как объединить операционные базы, аналитику и AI-агентов и можно ли при этом избавиться от привычного зоопарка интеграций. Николай Голов — директор по продукту одной из датаплатформ, доступных на российском рынке. Раньше он руководил дата-платформами в Avito и ManyChat, преподаёт базы данных и системы хранения в Harbour.Space. Так что обсудим и устройство технологий, и практику построения платформ, которые потом кому-то поддерживать. На картинке всё выглядит заманчиво: оставляем PostgreSQL для транзакций, изменения из остальных систем отправляем через CDC в объектное хранилище, сверху ставим Lakehouse и подключаем агентов через MCP. Данные собраны, инструменты доступны, можно задавать вопросы. Правда, между «сложили всё в S3» и «агент правильно понял бизнес» ещё помещается довольно много инженерной работы :) Посмотрим, как к этой задаче подходят Databricks, Snowflake, ClickHouse, Microsoft Fabric, Google, AWS и Oracle. У кого-то объединение происходит на уровне хранения, у кого-то через репликацию и общие запросы, а кто-то собирает всё внутри одной СУБД. За похожими словами про единую платформу скрываются разные архитектуры и разные ограничения. Поговорим о том: - Где проходят границы между OLTP, аналитикой и агентным бэкендом; - Что на практике означают «одна копия данных» и zero-ETL; - Когда CDC и Lakehouse упрощают жизнь, а когда добавляют ещё одну систему, за которой надо следить; - Какую роль могут играть PostgreSQL, DuckLake и S3 в собственной платформе; - Что нужно агенту помимо доступа к таблицам: определения показателей, права, контекст и возможность проверить результат. Хочется понять, какую сложность эти подходы действительно убирают и какая просто переезжает в другое место. Выпуск будет полезен архитекторам, инженерам данных и руководителям, которые выбирают платформу или подключают AI к существующим данным. Приходите 12 октября и приносите свои вопросы и грабли. #Architecture #DistributedSystems #AI #AI4SDLC #Management #Leadership #Engineering
-
edited The Forward Deployed Engineer — Paden Gayle (Рубрика #Books) Paden Gayle начал писать книгу "The Forward Deployed Engineer" и на сайте O’Reilly сейчас доступны две главы: книга ещё пишется и выходит в формате Early Release. Но по этим главам у меня уже ощущение, что получится хорошая книга. Особенно понравились части про ответственность и согласование позиций разных стейкхолдеров. FDE (Forward Deployed Engineer) — инженер, которого поставщик технологии встраивает в работу компании-заказчика. Он выясняет, какую проблему нужно решить, договаривается об объёме работ, строит систему и доводит её до production. Автор сравнивает эту роль с основателем внутри чужой компании. Масштаб ответственности похожий, а вот данные, инфраструктура, правила безопасности и люди принадлежат заказчику. Мне понравилась точность этого противоречия: отвечать за результат приходится в среде, которой ты не управляешь. Если для запуска нужен доступ, согласование или решение другого человека, твоя работа — найти этого человека и довести вопрос до решения. Лично выполнять всё при этом совершенно необязательно. А дальше начинается интересное: у «заказчика» оказывается несколько несовпадающих представлений об успехе. - Тому, кто выделил бюджет, нужен экономический эффект. - Руководителю процесса — понятные изменения и работающая команда. - IT и безопасности — контролируемые доступы, данные и последствия ошибок. - Пользователям — чтобы исчезла конкретная ручная возня. - Внутреннему инициатору проекта — результат, за который он уже поручился перед коллегами. В книге есть хороший приём: описать одно и то же решение на языке каждого из них, причём все описания должны быть правдой. Если одному обещаем работу без участия человека, а другому — обязательное подтверждение каждого шага, проблема уже в устройстве решения. Усреднить пожелания или выполнить просьбу самого громкого человека тут недостаточно. И ответственность вполне совместима с границами. Автор подробно разбирает, как фиксировать объём работ, исключения, обязанности заказчика и проверяемые критерии готовности. Например, в книге есть такой критерий: пятничная выгрузка, занимавшая четыре часа вручную, автоматически появляется в общей папке к девяти. Сразу понятно, что принимать и кто может это проверить. Отдельно интересна экономика этой позиции. Почему на неё есть спрос? Заказчику нужен работающий процесс в его системах, с его данными и ограничениями. По мысли автора, AI удешевляет написание кода, а выбор правильной задачи, согласования и ответственность остаются сложными. Когда реализация ускоряется, эти вопросы становятся ещё заметнее. Вдобавок теперь дешевле быстро построить и совершенно ненужную штуку :) Откуда предложение? Для поставщика AI такой инженер помогает превратить возможности продукта в результат, ради которого клиент продолжит платить. По логике книги, с кодинг-агентами один инженер может брать работу, раньше требовавшую небольшой команды: индивидуальное внедрение становится экономически доступнее. Это уже оформляется в отдельные направления бизнеса: AWS объявила о вложении $1 млрд в FDE. Со стороны инженера я вижу привлекательность в самостоятельности, прямой обратной связи от пользователей и возможности влиять на весь путь от задачи до результата. Цена такой самостоятельности — переговоры, неопределённость и чужие ограничения. Совместить сильную инженерию с умением держать этот контекст непросто. Пока это рекомендация первых двух глав. Но уже сейчас книга выглядит полезной и для техлидов, и для инженеров, которым приходится договариваться о том, что вообще стоит строить. За продолжением хочется следить. #Books #AI #Engineering #Management #Product
-
YC Paper Club: что дальше после LLM + GPU? (Рубрика #AI) Интересное видео для тех, кто хочет узнать, а что там дальше после LLM + GPU :) В YC Paper Club собрали разговор про вычисления на свете, нейроморфные чипы и живые нейроны. У четырёх участников складывается общая рамка: следующий скачок эффективности ИИ может потребовать одновременно другого железа, другой архитектуры моделей и другого способа обучения. 1️⃣ François Chaubard, ведущий из Focal Systems, начинает с того, что GPU, backpropagation и современные модели развивались вместе. Поэтому алгоритм, который плохо выглядит на GPU, может оказаться интересным при другой стоимости операций. Он исследует обучение без обратного прохода: немного меняем веса в случайном направлении, сравниваем результаты и решаем, куда двигаться. Для больших моделей таких проб нужно слишком много. Его подход SOMA — разбить модель на небольших экспертов, чтобы уменьшить шум оценки. А дальше возникает ставка: если прямые проходы станут очень дешёвыми, например в оптике, экономика такого обучения изменится. Прогноз Chaubard об отказе от backpropagation через десять лет стоит воспринимать именно как исследовательскую ставку. 2️⃣ Ilker Oguz, исследователь оптических вычислений из EPFL, теперь постдок в Stanford, показывает, где эта идея встречается с физикой. Свет проходит через оптические элементы и выполняет нужное преобразование. Но вокруг него остаются память, калибровка, нелинейные операции и преобразования электрических сигналов в оптические и обратно. На них выигрыш может закончиться. В его эксперименте с диффузионной генерацией изображений алгоритм подстроили под оптику: одни и те же веса многократно используются на последовательных шагах. Так ограничение устройства становится принципом построения алгоритма. Пока демонстрация ограничена MNIST и Fashion-MNIST, а расчёт экономии энергии предполагает пассивные фиксированные элементы; прототип использует программируемый модулятор. 3️⃣ Alok Vasudev, инженер по образованию и партнёр венчурной фирмы Standard, добавляет полезный скепсис к попыткам скопировать мозг. Его устройство и способы обработки информации эволюционировали вместе. Перенос отдельного механизма на кремний ещё не переносит его эффективность. По его оценке, ближе к практике решения, которые сближают память и вычисления, сокращая перемещение данных. А более буквальное воспроизведение работы мозга остаётся исследовательским направлением. Здесь хороший вопрос к любому нейроморфному проекту: какое конкретное ограничение помогает снять сходство с биологией? 4️⃣ Sean Cole, автор алгоритмов эксперимента с Cortical Labs, доводит эту историю до живых клеток, управляющих Doom. Цифровой кодировщик превращает состояние игры в электрическую стимуляцию, клетки отвечают импульсами, декодер переводит их в действия. И тут самая интересная деталь. По словам Cole, ранний декодер получился настолько мощным, что мог играть даже при обнулённых сигналах от клеток. Команда уменьшила его до простого линейного считывания и провела проверки, чтобы убедиться, что сигналы нейронов действительно нужны для результата. Иначе можно получить впечатляющую демонстрацию, в которой всю полезную работу выполняет обычный компьютер. Итого: это интересное видео про исследования, что не относятся к текущему мейнстриму, но у которых интересные перспективы. #AI #Hardware #Research #Engineering
-

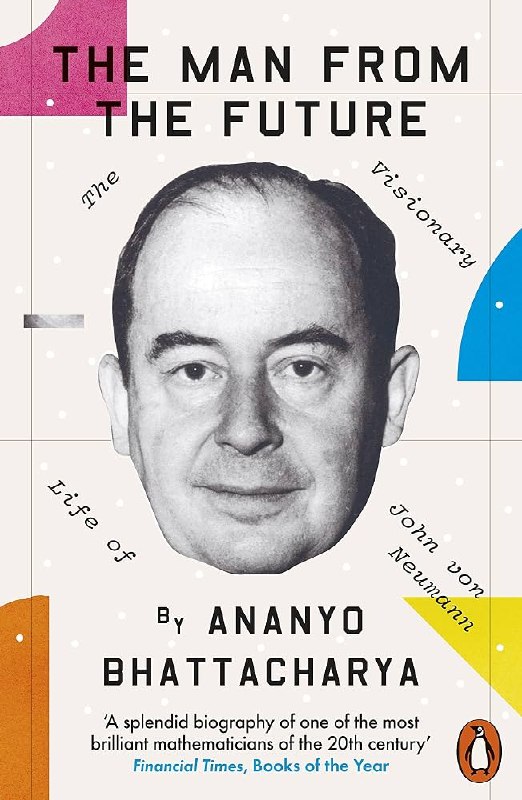
The Man from the Future: The Visionary Life of John von Neumann (Человек из будущего. Жизнь Джона фон Неймана, создавшего наш мир) (Рубрика #Books) Я уже упоминал книгу «Человека из будущего» Ананьо Бхаттачарьи, когда начинал ее читать, а теперь я ее дочитал — и книга мне очень понравилась. Больше всего впечатляет, сколько всего успел сделать её герой, Джон фон Нейман, в совершенно разных областях. В computer science его имя знакомо по фон-неймановской архитектуре: программа и данные хранятся в памяти компьютера. Он был одним из ключевых участников становления вычислительной техники. Уже этого хватило бы для большой научной биографии. Но дальше идут математические основы квантовой механики, доказательство минимаксной теоремы и книга «Теория игр и экономическое поведение», написанная вместе с Оскаром Моргенштерном в 1944 году и ставшая основополагающей для теории игр. Затем — работа в Манхэттенском проекте: расчёты сжатия ядерного заряда взрывом и действия ударных волн. Математика здесь вполне буквально меняла устройство мира, причём далеко не только в мирных целях. А ещё фон Нейман был одним из основоположников теории клеточных автоматов и разрабатывал теорию самовоспроизводящихся машин. Это была математическая модель: клетки меняют своё состояние по заданным правилам, а построенная из них структура может воспроизвести себя. То есть человек, занятый ранними компьютерами, уже ставил вопрос о том, как машина могла бы создавать собственную копию. И параллельно исследовал, что общего у вычислительных машин и человеческого мозга. Кстати, про клеточные автоматы вам может быть известно по работам Джона Конвея с его игрой "Жизнь" и Стивена Вольфрама с его элементарными клеточными автоматами. В общем, beautiful mind, который мог очень многое. Рекомендую эту книгу тем, кому интересны история науки и люди, чьих идей хватило сразу на несколько дисциплин. И всё же у этой истории печальный финал. Фон Нейман умер от рака 8 февраля 1957 года, в 53 года. Он успел увидеть ранние результаты своей работы, но до мира, в котором компьютеры стали повседневностью, не дожил. Человек, который так много сделал для будущего, сам провёл в нём удивительно мало времени. P.S. Я раньше уже упоминал книгу Джона Фон Неймана "Вычислительная машина и мозг" ("The Computer and the Brain"), которую опубликовали посмертно и которая должна изначально быть представлена в качестве Силлимановских лекций в Йеле. Написано очень просто и понятно и показывает насколько Джон был визионером, опередившим свое время. #Books #History #Math #Engineering #Architecture #AI
-
Материалы Research Insights #34: долгоживущие агенты и передача работы (Рубрика #AI4SDLC) Доступны материалы сольного выпуска Research Insights Made Simple от 7 октября 2026 года — «Долгоживущие агенты: передача работы». Разобрал инженерный пост Anthropic "Effective harnesses for long-running agents" от 26 ноября 2025 года о работе агента на протяжении нескольких сессий. Код остался на диске, а контекст закончился. Следующей сессии достаются файлы и обнадёживающее «почти готово», но ещё нужно выяснить, что действительно работает, какие проверки прошли и с чего продолжать. На примере клона claude.ai авторы показывают, как устроить такую передачу работы. В выпуске разобрал: 🔸 Что подготовить в первой сессии Список функций, журнал прогресса, скрипт запуска init.sh и начальный коммит. Требования, объяснение сделанного, запуск среды и история кода отвечают на разные вопросы. Одним пересказом беседы их трудно заменить. 🔸 Как определить готовность «Сделать чат» превращается в пользовательский сценарий: создать разговор, увидеть приветствие и новый пункт в боковой панели. Статус меняется после проверки. При этом запрет переписывать требования в исходном решении задан промптом — отдельная внешняя проверка их неизменности не показана. 🔸 Как начинать и заканчивать рабочий шаг Прочитать состояние, запустить приложение, проверить основу, выбрать одну функцию, реализовать и проверить её, сохранить коммит и запись в журнале. Это одна функция за шаг; за сессию таких шагов может быть несколько. 🔸 Что агент не видит в браузере В описанном опыте Puppeteer MCP не давал видеть нативные диалоги alert, и связанные с ними функции оставались более ошибочными. Зелёные тесты и подключённый браузер ещё не гарантируют, что пользовательский путь пройден. 🔸 Как проверить саму обвязку Предложил сравнивать варианты на одинаковых задачах, модели и бюджете, принудительно сбрасывая контекст и меняя по одному механизму. Это предложение для эксперимента; у Anthropic в исходном посте — качественные наблюдения без измеренного вклада каждого компонента. В финале посмотрел и на продолжение истории: с более сильными моделями состав обвязки меняется. Вчерашние ограничения тоже нужно перепроверять. Материалы выпуска: 📌 Страница выпуска с таймкодами 📊 Слайды 📖 Лонгрид об эволюции агентных оболочек 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект Что чаще теряется у вашего агента после смены сессии: понимание задачи, результаты проверок или следующий шаг? Расскажите, чем помогли продолжить работу. #AI4SDLC #Agents #DevTools #Evals #ResearchInsights #Engineering
-
Заходите на прямой эфир Research Insights - сегодня серия с обсуждением мартовской статьи Anthropic про проектирование обвязки под long running app development
-
По традиции я раз в год участвую в благотворительной акции с механикой аукциона, где можно сделать ставку и выиграть встречу со мной. На этот раз этот аукцион проходит на платформе Толк. Если вы давно хотели со мной позавтракать, то у вас есть шанс. А заодно это поможет фонду "Нить добра", который помогает детям и подросткам с онкологическими и другими тяжелыми заболеваниями, а также их семьям.
-
Материалы Code of Leadership №84: разработчик становится менеджером в эпоху AI? (Рубрика #Management) Готовы запись и конспект Code of Leadership S2E26 от 6 октября 2026 года. Вместе с Андреем Дмитриевым, сооснователем JUG Ru Group, обсуждали, как меняется работа инженера, когда часть исполнения можно поручить агентам: кто выбирает задачу, организует работу и отвечает за результат? Агент может исправно готовить отчёт, который никто не читает. Работа идёт, ресурсы расходуются, а проверить, кому всё это ещё нужно, забыли. В разговоре возвращались к этому вопросу: прежде чем что-то ускорять, хорошо бы разобраться, стоит ли продолжать это делать. Обсудили: 🔸 Продуктового инженера и границы специализации Андрей выделяет знание предметной области и умение выяснять потребности пользователя. Опыт работы с языком программирования помогает, но готовых требований к незнакомому продукту может уже никто не принести. 🔸 Как проверить пользу до автоматизации Андрей рассказал о руководителе, который временно прекращал рассылку части отчётов: некоторые получатели этого даже не замечали. Хороший повод найти реального потребителя результата, прежде чем заводить для него ещё одного агента. 🔸 Жизненный цикл агента Подключить, обучить работе, контролировать и вовремя отключить. Андрей предлагает эту управленческую аналогию; мы обсуждаем доступы, критерии результата и поддержку инженера. Выданная подписка сама по себе процесс не создаёт. 🔸 Знания, которые нельзя потерять при делегировании Я описал подход, в котором код можно пересобрать из намерений, архитектурных правил, проверяемого поведения и причин решений. Андрей напомнил о противоречиях в документации. Проверять приходится и функции, и безопасность, и соблюдение архитектуры. 🔸 Софт под одну задачу и интерфейсы для агентов Рассказал про личный сайт для выбора района в Лондоне; Андрей — про бота, который уточняет требования и создаёт сайт. Обсудили и ограничения: актуальность данных, доступность источников, трудность объяснения собственных предпочтений. Прогнозы о будущем профессий в этом разговоре остаются нашими оценками. А вопрос к руководителю уже вполне практический: какую пользу он добавляет, когда часть координации тоже можно автоматизировать? Материалы выпуска: 📌 Страница выпуска с таймкодами 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект #CodeOfLeadership #Management #Leadership #AI4SDLC #Agents #Engineering
-
edited Проектирование обвязки для длительной (автономной) разработки приложений (Рубрика #AI4SDLC) В 33 выпуске Research Insights Made Simple мы разбирали SWE-agent: как интерфейс, инструменты и обратная связь меняют результат той же модели. В 34 выпуске — как передавать работу между сессиями, сохраняя список функций, прогресс и проверенное состояние проекта. В 35 выпуске мы говорили про подход OpenAI к созданию harness, а в этой статье "Harness design for long-running application development" Притви Раджасекарана идет речь про подход к снаряду ребят из Anthropic. По-факту, тут переход от рабочего места и памяти агента к организации автономной one-shot разработки целого приложения. У LLM с самооценкой легко получается «кукушка хвалит петуха»: написала что-то, сама проверила и решила, что всё отлично. Автор разделяет создание и оценку результата. В полной версии harness появляются три роли: 1) Planner разворачивает короткий запрос в продуктовую спецификацию. 2) Generator реализует приложение. 3) Evaluator проверяет работающую систему через браузер, API и состояние базы. По-моему, это уже очень похоже на команду с product manager, разработчиком и QA. Особенно интересен контракт спринта: до написания кода агенты согласуют, что должно получиться и как проверить готовность. Спецификация остаётся достаточно общей, а критерии приёмки связывают её с реализацией. При этом отдельный критик тоже требует настройки. Автор разбирал его логи и учил строже относиться к найденным проблемам. Для дизайна — задавал критерии цельности, оригинальности, качества исполнения и удобства, затем калибровал оценки на примерах. Здесь меня интересует граница: насколько можно формализовать вкус? Оценщик способен всё увереннее попадать в заданные предпочтения, но рост баллов ещё не гарантирует, что следующая версия понравится человеку больше предыдущей. Цена такого процесса тоже заметная. В примере редактора игр одиночный запуск стоил $9 и занял 20 минут, полный harness — $200 и шесть часов. По описанию автора, во втором случае заработал игровой режим. Но одновременно выросли бюджет, время и объём задания, поэтому вклад самого разделения ролей этим сравнением не изолирован. А дальше начинается самая полезная для инженеров часть: harness упрощают по мере усиления модели. На Opus 4.5 автор смог убрать явные сбросы контекста; на 4.6 — спринты, оставив проверку после сборки и циклы исправлений. Уже знакомый поворот из истории SWE-agent: части обвязки могут перестать быть нужными. Каждый такой элемент фиксирует предположение о слабости модели. Поэтому после её обновления стоит снова проверять, зачем нам эта передача работы, эта роль, этот промежуточный этап. Удалять их по одному и смотреть, что происходит с качеством, временем и стоимостью. И тут у меня следующий вопрос: сможет ли агент сам улучшать собственный harness — менять процесс, проверять результат и убирать лишнее? Звучит как естественное продолжение, но тогда особенно важно понять, кто будет оценивать самого оценщика. 9 октября в 9:00 по Москве разберём эту статью в прямом эфире Research Insights Made Simple. Обсудим устройство процесса, пользу отдельной приёмки и то, что останется от обвязки с усилением моделей. Приходите! #AI4SDLC #Agents #Engineering #Research #Evals
-
Материалы выпуска Research Insights #33: SWE-agent (Рубрика #AI4SDLC) Собрал материалы сольного выпуска Research Insights Made Simple от 5 октября 2026 года — «SWE-agent: интерфейс меняет результат». Разобрал, как одна и та же языковая модель решает задачи по-разному, когда меняются её инструменты и ответы среды. Инженеру помогают редактор, поиск и номера строк. У агента тоже есть рабочее место, только оно складывается из команд и текстовых ответов. Если после правки непонятно, что изменилось, следующий ход уходит на выяснение состояния файла. В [статье SWE-agent](https://arxiv.org/abs/2405.15793) с NeurIPS 2024 авторы исследуют, как такие детали влияют на способность довести исправление до работающего патча. В выпуске разобрал: 🔸 Как агент ориентируется в чужом проекте Поиск файла, поиск совпадений и просмотр кода с номерами строк — и почему удобный человеку перебор результатов может загнать модель в бесполезный обход. 🔸 Что возвращать после правки Команда edit сразу показывает обновлённый фрагмент. Если проверка отклоняет изменение, агент получает ошибку и оба варианта кода. Но у ограничения есть цена: оно может мешать нужному промежуточному состоянию. 🔸 Что оставлять в контексте Размер окна просмотра и старые ответы инструментов: после нескольких правок история уже хранит версии файла, которых больше нет. 🔸 Как читать результаты экспериментов Полный SWE-bench и Lite, запуски с демонстрацией и без неё, вклад отдельных компонентов. Несколько независимых попыток и продолжение застрявшего диалога — разные эксперименты. 🔸 Почему конструкцию агента приходится пересматривать В финале — SWE-smith, mini-SWE-agent с возвращением к bash и изменения SWE-bench Verified. Проценты и настройки из статьи относятся к экспериментам 2024 года. Для современных моделей заново проверять нужно и пользу специальной команды, и цену её ограничений. Материалы выпуска: 📌 Страница выпуска с таймкодами 📊 Слайды 📖 Лонгрид об эволюции агентных оболочек 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект #AI4SDLC #Agents #DevTools #Evals #ResearchInsights #Engineering
-
edited Justin Reock: код менять легче, деплоить страшнее (Рубрика #AI4SDLC) Новый доклад Justin Reock из DX продолжает его старую линию из предыдущего доклада, где речь шла о том, как процессы и инструменты вокруг инженера влияют на результат внедрения AI. А в новом докладе "The State of AI in Software Development: Data from 400+ Orgs" заместитель CTO компании DX возвращается к этой теме. Его тезис: ускорение генерации кода ограничено тем, как устроена остальная разработка. В данных, которые приводит Reock, есть интересное расхождение: - Оценка поддерживаемости кода разработчиками выросла почти на 4%; - Уверенность в изменениях снизилась на 6%; - Средний размер PR вырос примерно с 44 до 72 строк. Это наблюдения DX, а первые два показателя — оценки самих инженеров. Они не доказывают, что AI стал причиной всех изменений. Главный тезис доклада "Код стало проще менять, но деплоить его спокойнее не стало" и для меня здесь интересен разрыв между локальным пониманием и уверенностью в поведении всей системы. Агент может объяснить функцию и помочь ее переписать. Дальше остаются вопросы: какие контракты мы затронули, что действительно проверяют тесты, какие зависимости вообще не попали в контекст? Красивое объяснение diff само по себе на них не отвечает. Reock приводит пример: AI мгновенно генерирует функции, а сборка по-прежнему занимает 45–60 минут. Возникает соблазн собрать изменения в один большой PR. Это гипотеза о механизме, а не установленная причина роста PR во всей выборке. Я бы здесь проверял, сколько работы мы перекладываем на следующего человека. Автор быстрее закончил свою часть, а ревьюеру теперь нужно восстановить логику нескольких изменений одновременно. Если проверка обнаружит проблему, сколько времени займет переделка? И останется ли выигрыш после нее? Без этих вопросов легко принять локальную экономию времени за улучшение всего процесса. Кстати, это хороший повод вернуться к фреймворку DX Core 4, который я уже разбирал. Там продуктивность рассматривается через speed, effectiveness, quality и impact. Для такого кейса я бы смотрел рядом на время прохождения PR, его размер, возвраты на доработку и сбои после выпуска. Опрос про уверенность тоже нужен: он помогает найти места, где команда боится менять код, даже если счетчик поставленных изменений растет. А техническая сторона уже была в разборе Max Kanat-Alexander про DevEx для агентов: быстрые предсказуемые тесты, понятные ошибки, документация с контекстом и управляемая нагрузка на ревью. Если агент часто запускает тесты, каждая лишняя минута ожидания повторяется вместе с этим циклом. Получается вполне предметный повод наконец заняться медленным CI:) При этом размер PR я бы не превращал в самостоятельный KPI. Можно нарезать одно связное изменение на десяток неудобных кусков и получить красивый график. Важно, может ли проверяющий понять замысел, проверить последствия и при необходимости откатить изменение. Поэтому после внедрения AI я бы задавал команде такой вопрос: мы стали быстрее доводить изменения до состояния, за которое готовы отвечать, или пока только быстрее наполняем очередь на проверку? P.S. На обложку конечно вынесен более провокационный вопрос:) #AI4SDLC #Engineering #DevEx #Productivity #Metrics #Management
-
Зачем руководитель возвращается к коду — материалы выпуска (Рубрика #Leadership) Вышел 82-й выпуск Code of Leadership: 1 октября поговорили с Никитой Белокопытовым, который руководил инженерными командами в AutoScout24 и Playrix, а сейчас занимается прикладным ИИ в Bluefish. Зачем снова садиться за разработку, когда уже умеешь управлять людьми? Никита объясняет свой выбор вполне практично: как руководить командой, если её новые инструменты и даже проблемы тебе незнакомы? Обсудили: 🔸 Как техническая правота мешает стать руководителем Никита рассказал, как однажды заявил менеджеру, что хочет занять его место, и получил предложение спросить коллег, хотят ли они такого начальника. После честной обратной связи пришлось менять привычки общения. В календаре появилось ежедневное напоминание BeKind. 🔸 Почему сильнейшие программисты не первыми переходят на Cursor По наблюдению Никиты в Playrix, ускорение написания кода мало меняло работу тех, кто и так пишет быстро, а основное время тратит на обдумывание задачи. Более полезным оказался разбор багов с агентами — когда для них задали граф состояний, инструменты и изолированную среду. 🔸 Что остаётся от менеджерского опыта без подчинённых Найти владельца системы, договориться об изменении, снять препятствие, взять ответственность — всё это пригодилось Никите в инженерной роли. Он допускает, что небольшим автономным командам понадобится меньше управленческих слоёв; это его прогноз, а не готовое правило для любой компании. 🔸 Где заканчивается автономность агента В Bluefish агент берёт небольшую задачу из Jira и доводит её до PR. Но необходимость задачи определяет человек, а за изменение основной системы отвечает инженер. В другом эксперименте Никита упёрся в собственный предел проверки — пять-шесть PR в день; отдельные циклы исправлений между агентами доходили до 60 итераций. Отсюда ограничения по деньгам, времени и числу повторов. 🔸 Как погружаться в код без микроменеджмента Разобраться в системе самому полезно, но дальше нужно уметь разговаривать с командой. Иначе новые технические знания легко превращаются в новые поводы вмешиваться в чужую работу. Материалы выпуска: 📌 Страница выпуска с таймкодами 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект разговора Если вы после нескольких лет управления снова вернулись к разработке, расскажите: что пришлось учить заново, а какой менеджерский навык неожиданно пригодился? #CodeOfLeadership #AI4SDLC #Management #Leadership #Engineering #Product
-
Harness engineering: как экспериментальная команда внутри OpenAI перестраивала разработку вокруг агентов для одного из внутренних продуктов(Рубрика #AI4SDLC) Готовясь к 35-му выпуску Research Insights, изучал статью OpenAI про harness engineering. Вышла она 11 февраля 2026 года, и для того момента здесь очень много интересных и прорывных мыслей о работе инженера. Особенно если читать её через вопрос: что нужно сохранить о системе, когда сам код становится всё дешевле? Команда Райана Лопополо строила внутренний продукт, сознательно запретив себе писать код руками. По их данным, за пять месяцев получилось около миллиона строк, включая документацию и инфраструктуру, и примерно 1500 принятых PR. Инженеры занимались средой, в которой Codex мог выполнять работу. Из статьи я бы выделил четыре вещи: 1️⃣ Знание должно быть доступно агенту. Короткий AGENTS.md служит картой документации. Требования и причины решений живут в репозитории. 2️⃣ Архитектуру нужно проверять. Допустимые зависимости и границы слоёв закреплены линтерами и структурными тестами. 3️⃣ Агенту нужны глаза. Доступ к интерфейсу, логам и метрикам позволяет ему воспроизводить ошибки и проверять исправления. 4️⃣ Сложность требует регулярной работы над ее снижением. Фоновые задачи ищут отклонения и предлагают небольшие рефакторинги. Ошибки становятся поводом улучшать правила и инструменты. Мне здесь нравится перенос инженерного суждения в среду: сформулированное требование можно многократно применять и проверять. Очень рифмуется с темой моего keynote на DotNext — знание о системе должно переживать её реализацию. А у этой истории оказалось занятное продолжение. В апрельском интервью Лопополо рассказал, что работал в Frontier Product Exploration, команде корпоративных агентных продуктов. И первые полтора месяца такой разработки, по его оценке, были примерно в десять раз медленнее ручной работы. Пришлось вложиться в инструменты и контекст, прежде чем эксперимент начал окупаться. Следующим узким местом стало переключение между сессиями агентов (мы про эту проблему говорили в выпуске Research Insights #34). Так появился Symphony: он забирает задачи из Linear, запускает агентов в отдельных рабочих пространствах и доводит работу до приёмки. Человек задаёт работу и оценивает результат. Интересно, что в репозитории Symphony есть спецификация SPEC.md и экспериментальная реализация на Elixir. Можно попросить агента построить свою версию по этой спецификации. Получается вполне предметный шаг к восстановлению реализации из сохранённого знания. К сентябрю Лопополо уже работал в Google Cloud и в новом разговоре советовал вкладываться прежде всего в инструменты и контекст: переносить исправления из разовых подсказок в документацию, линтеры и тесты. При этом исходный эксперимент начинался с пустого репозитория. В апреле автор уточнял, что перед выпуском приложения оставался человеческий smoke-тест. Переносить такой процесс в зрелую систему нужно с пониманием её рисков. Приходите на 35-й выпуск Research Insights в эту пятницу: про статью поговорим подробнее — где здесь воспроизводимая инженерная практика и что нужно уметь проверять, прежде чем отдавать агентам больше работы. P.S. Не смог приложить PDF, так как просто Ctrl + P на сайте OpenAI приводит к сохранению PDF, в котором теряется часть текста - пришлось читать статью по старинке, из браузера:) #AI4SDLC #AI #Agents #Engineering #Architecture #PlatformEngineering
-
Заходите на прямой эфир Research Insights #34, где я расскажу про прошлогоднюю статью, в которой ребята из Anthropic делились своим опытом передачи работы между разными сессиями одного и того же агента. Этот выпуск продолжает историю про SWE-agent, что мы разбирали в выпуске #33
-
Warp: поправили агента. Чему научилась система? (Рубрика #AI4SDLC) Интересная история от создателя Warp, которая продолжает разбор Factory, где мы обсуждали, как организовать исполнение и проверку агентных задач, а также разбор Conductor, где мы говорили о том, а как человеку управлять несколькими исполнителями. Но после обоих остаётся вопрос: если сегодня пришлось поправить агента, что изменится в его работе завтра? Zach Lloyd, основатель и CEO Warp, предлагает сделать такие исправления материалом для улучшения всего процесса. Его доклад «Software Engineering Is Becoming Factory Engineering» прошёл на AI Engineer World's Fair 30 июня 2026 года, а отдельная запись появилась 27 сентября. По мысли Lloyd, инженер будет всё больше заниматься системой, которая производит изменения в продукте. Warp продаёт инфраструктуру для такого процесса, поэтому интерес компании понятен. Сам процесс узнаваемый: разобрать задачу, подготовить спецификацию, написать код, проверить, выпустить и наблюдать за результатом. Люди у Lloyd продолжают проверять спецификации, код и поведение продукта. Мне здесь интереснее второй цикл — работа над самим процессом. Агент делает ревью, опытный инженер исправляет его замечание. Агент-наблюдатель разбирает эту обратную связь и предлагает обновить skill — инструкцию для следующих ревью. Так исправление может пережить текущий PR и помочь другим участникам команды. Это хорошо продолжает историю Vercel d0: там повторяющиеся запросы превращались в навыки, а я задавался вопросом, кто дальше проверяет и обновляет накопленное. Warp предлагает использовать для этого в том числе замечания людей. Причём после доклада идея стала конкретнее. В июльском руководстве Warp агент уже открывает PR с изменением навыка ревью. А в документации, обновлённой 24 сентября, предлагаемые исправления связаны с неудачными запусками и требуют человеческой проверки. Здесь «самоулучшение» означает изменение инструкций и процесса; обучение весов модели из этого не следует. Со способом оценивать успех я бы поспорил. В обращении к команде Lloyd предлагает считать работу с агентом в ручном интерактивном режиме неудачей, из которой нужно извлечь урок. Цель — увеличивать долю автоматических изменений. Повторные объяснения уже известного правила хочется убрать. А совместный поиск решения для новой задачи может быть полезной работой, даже если снижает долю автоматических изменений. Здесь снова вспоминается Dex Horthy из HumanLayer с его вниманием к проектированию и пониманию системы. Я бы оценивал, какие вмешательства удалось убрать и что стало с качеством результата. Процент автономных задач сам по себе этого не покажет. Правда надо отметить, что и человеческое замечание тоже может быть ошибочным. Если сразу превратить его в общую инструкцию, завтра агент начнёт старательно повторять уже нашу ошибку. Из этого я бы забрал три практических шага: 1️⃣ Найти одну повторяющуюся правку Посмотреть последние ревью, сформулировать правило и сохранить пример ошибки. Начать с небольшого навыка, пользу которого можно проверить. 2️⃣ Проверить новую инструкцию на других задачах Сравнить старую и новую версии, включая случаи, где раньше всё работало. Принимать изменение после проверки и сохранять возможность отката. 3️⃣ Посчитать полную стоимость результата Включить время на постановку, ревью и переделки, расходы на модели и обслуживание автоматизации. Затем проверить, стало ли меньше повторных исправлений при сопоставимом качестве. #AI4SDLC #AI #Agents #PlatformEngineering #Evals
-
Обвязка агента по Anthropic: как передавать работу между кодинговыми сессиями (Рубрика #AI4SDLC) Для Research Insights Made Sijmple #34 разбираю "Effective harnesses for long-running agents" — инженерный пост Джастина Янга из Anthropic почти годовалой давности (26 ноября 2025 года). Меня зацепил вопрос: что останется от работы агента, когда закончится его контекст и следующей сессии придется продолжать проект? В этой статье Anthropic описывает опыт сборки клона claude.ai. Агент пытался сделать слишком много за один заход, оставлял недоделанную функцию без понятного описания, а следующий экземпляр тратил время на восстановление. Или видел уже написанный код и радостно объявлял весь проект готовым. Сжатие истории разговора само по себе эти проблемы не устраняло. Получается разработка со сменами: каждый новый инженер приходит без памяти о предыдущем. Оставить ему «я тут поработал, все почти готово» — так себе передача дел :) Авторы собирают протокол вокруг нескольких вещей: — Инициализатор готовит среду, скрипт запуска и список функций с критериями проверки. Изначально все функции помечены как неготовые. — Следующие сессии берут по одной функции, проверяют результат, сохраняют изменения в Git и обновляют журнал прогресса. — В начале новой сессии агент читает журнал и историю коммитов, проверяет, что приложение работает, и выбирает следующую задачу. — Для веб-приложения проверка включает сценарии в браузере. Код может выглядеть убедительно, пока пользователь не нажмет кнопку. Кстати, «два агента» здесь — две фазы с разными стартовыми промптами. В сноске авторы уточняют, что системный промпт, инструменты и обвязка одинаковы. Доказательств пользы роя из этого не получается. Еще любопытная деталь: по наблюдению авторов, агент реже нежелательно переписывал список требований в JSON, чем в Markdown. Чисел и условий сравнения нет, так что я бы считал это гипотезой для проверки. Тем более JSON сам по себе ничего не запрещает: если важно сохранить требования, нужно отдельно проверять изменения. Просьба «не меняй тесты» технического ограничения не создает. Меня здесь интересует разница между сохраненным рассказом о работе и проверенным состоянием проекта. Журнал помогает понять намерение, Git — увидеть изменения, список функций — вспомнить обязательства, а тесты — проверить результат. У каждого артефакта своя роль. Галочка passes: true, которую агент поставил себе сам, без надежной проверки остается его мнением. Называть этот пост научным прорывом я бы не стал: это опыт команды производителя на веб-разработке, без контрольной группы и количественных сравнений. Зато он хорошо показывает, сколько обычной инженерной дисциплины требуется, чтобы агент мог продолжать большую задачу. И рецепт меняется вместе с моделью. В продолжении от марта 2026 года Anthropic описала отдельного оценщика и отказ от принудительных сбросов контекста при переходе с Sonnet 4.5 на Opus 4.5. Полезно разбирать, какую конкретную слабость компенсирует каждый элемент обвязки и нужен ли он в следующей конфигурации. Завтра, 7 октября, в прямом эфире Research Insights #34 подробнее поговорим про эту статью: как передавать работу между сессиями, чему доверять в отчете агента и когда разделение ролей действительно помогает. Приходите, будет что обсудить. #AI4SDLC #AI #Agents #Engineering #Research
-
Забегаайте на прямой эфир с Андреем Димтриевым из JUG.RU, где мы обсудим, что сейчас разработчик становится менеджером, хочет он этого или нет
-
Conductor: как управлять оркестром агентов (Рубрика #AI4SDLC) В разборе «Несведущего маэстро» я уже писал, что меня давно интересует, как дирижёры управляют коллективами и что из этого можно перенести в разработку ПО. Теперь к людям в оркестре предлагают добавить агентов. Именно такую метафору использует Charlie Holtz, сооснователь и CEO Conductor, в докладе «Orchestras, Not Factories». Он выступал на AI Engineer World’s Fair 30 июня 2026 года, а отдельная запись вышла 27 сентября. Conductor — приложение, в котором можно управлять несколькими кодинг-агентами и работать над задачами вместе с коллегами. Holtz хочет, чтобы человек мог задавать направление, погружаться в детали и получать удовольствие от создания продукта. Агенты при этом берут на себя всё больше исполнения. И за красивой метафорой у него есть несколько вполне прикладных правил. 🔸 Пробовать новое, но не застревать в настройке По его мнению, свой рабочий процесс стоит дорабатывать там, где есть особенности продукта или команды. Универсальные улучшения крупные разработчики инструментов со временем встроят сами. Хороший повод проверить, сколько времени уходит на очередную настройку и сколько она реально экономит. 🔸 Выделять области с обязательной человеческой проверкой В Conductor их называют slop-free zones. Например, изменения миграций должен проверить человек. Документацию, инструкции для агентов и skills команда тоже готовит особенно тщательно. Мне здесь нравится сама избирательность: заранее определить места, где цена ошибки выше. Плохая инструкция, например, может повлиять сразу на множество следующих задач. 🔸 Делать знания команды доступными агентам Их внутренний Conductor Internal Agent собирает сообщения Slack, обращения из Discord и записи встреч в PostgreSQL. Агенты могут искать там информацию через SQL. Это полезная идея, но я бы отдельно подумал, как отличать обсуждение от принятого решения, находить устаревшие сведения и учитывать права доступа. Человеческое сообщение тоже может оказаться ошибочным. Дальше Holtz показывает совместную работу в облаке. Тут уже есть продолжение за пределами доклада: Conductor Cloud вышел 30 июля. Агенты работают в отдельных окружениях и продолжают задачу после закрытия ноутбука; коллеги могут подключаться к общему рабочему пространству. А 2 октября вышло приложение для iOS. Если сопоставить это с другими подходами, я бы расставил акценты так. Tereza Tížková из Factory подробнее показывает организацию исполнения и проверки. Dex Horthy из HumanLayer — участие инженера в проектировании и сохранение понимания кода. Holtz — то, как человек и команда управляют несколькими исполнителями. Эти подходы вполне можно совмещать. При этом Conductor продаёт именно такую рабочую среду, так что продуктовый интерес понятен. Сравнительных измерений скорости в докладе нет: это наблюдения основателя и демонстрация его продукта. И здесь возвращается тема разбора Zack Proser про человеческое внимание. Оркестром тоже можно утомиться управлять. Если весь день переключаешься между агентами, объясняешь одно и то же и разбираешь недоделки, новая метафора мало что меняет. Мне интереснее, какие повторяющиеся вмешательства этот процесс позволяет убрать. Отсюда три практических шага: 1️⃣ Инженеру Выбрать несколько областей, где проверка человеком обязательна, и перечитать инструкции, которые агент получает при каждом запуске. 2️⃣ Платформенной команде Проверить, может ли агент найти актуальное решение, поднять окружение и продолжить задачу без постоянных ручных подсказок. 3️⃣ Руководителю Сравнить пилот с обычным процессом: сколько времени людей уходит на постановку, переключения, проверки и переделки. При сопоставимом качестве это поможет оценить, сколько внимания освобождает работа с несколькими агентами. #AI4SDLC #AI #Agents #Engineering #Management
- Older posts